PyTorch Redes Neuronales Recurrentes (RNN)
Las Redes Neuronales Recurrentes (Recurrent Neural Networks, RNN) son una clase de arquitecturas de redes neuronales diseñadas específicamente para procesar datos secuenciales, capaces de capturar la información dinámica de series temporales o datos ordenados, y pueden manejar datos secuenciales como texto, series temporales o audio.
Las RNN tienen amplias aplicaciones en tareas como el procesamiento del lenguaje natural (NLP), el reconocimiento de voz y la predicción de series temporales.
La característica clave de las RNN es su capacidad para mantener un estado oculto (hidden state), lo que permite a la red recordar información de pasos de tiempo anteriores, algo crucial para procesar datos secuenciales.
Estructura básica de la RNN
En una red neuronal de avance tradicional (Feedforward Neural Network), los datos fluyen desde la capa de entrada hacia la capa de salida, mientras que en una RNN, los datos no solo fluyen a través de las capas de la red, sino que también se propagan al estado oculto actual en cada paso de tiempo, transmitiendo así la información anterior al siguiente paso de tiempo.
Estado oculto (Hidden State):La RNN recuerda la información de la secuencia mediante el estado oculto.
El estado oculto se calcula a partir del estado oculto del paso de tiempo anterior y la entrada actual.
La estructura de la unidad recurrente es la siguiente:
- Entrada (\(x_t\)): vector de entrada en el paso de tiempo \(t\).
- Estado oculto (\(h_t\)): vector de estado oculto en el paso de tiempo \(t\), utilizado para almacenar información de pasos de tiempo anteriores.
- Salida (\(y_t\)): vector de salida en el paso de tiempo \(t\) (opcional, depende de la tarea específica).
Fórmula:
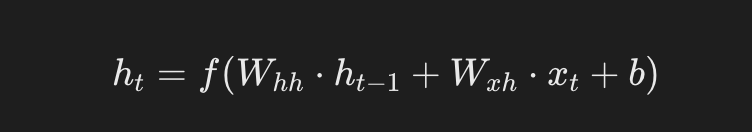
\[ h_t = f(W_{hh}h_{t-1} + W_{xh}x_t + b_h) \]
- ht: estado oculto en el momento actual.
- ht-1: estado oculto en el momento anterior.
- Xt: entrada en el momento actual.
- Whh、Wxh: matriz de pesos.
- b: término de sesgo (bias).
- f: función de activación (como Tanh o ReLU).
Salida (Output):La salida de la RNN no solo depende de la entrada actual, sino también de la información histórica del estado oculto.
Fórmula:
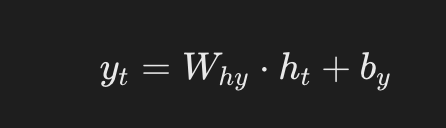
\[ y_t = W_{hy}h_t + b_y \]
- yt: vector de salida en el paso de tiempo t (opcional, depende de la tarea específica).
- Why: es la matriz de pesos desde el estado oculto hasta la salida.
Cómo maneja la RNN los datos secuenciales
La vista desplegada (unfold) de la red neuronal recurrente (RNN) al procesar datos secuenciales es la siguiente:
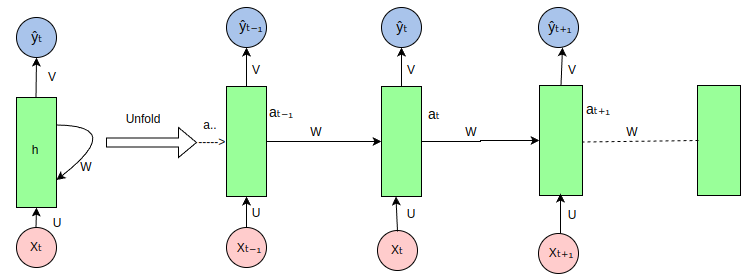
La RNN es una red neuronal que procesa datos secuenciales mediante conexiones recurrentes para procesar cada elemento de la secuencia y transmitir información en cada paso de tiempo. A continuación se explica cada parte de la figura:
-
Secuencia de entrada (Xt, Xt-1, Xt+1, ...): los círculos rosados en la figura representan los elementos de la secuencia de entrada; por ejemplo, Xt representa la entrada en el paso de tiempo actual, Xt-1 representa la entrada del paso de tiempo anterior, y así sucesivamente.
Estado oculto (ht, ht-1, ht+1, ...): los rectángulos verdes representan el estado oculto de la RNN, que almacena información sobre la secuencia en cada paso de tiempo. ht es el estado oculto del paso de tiempo actual, ht-1 es el estado oculto del paso de tiempo anterior.
Matrices de pesos (U, W, V):
U: matriz de pesos desde la entrada hasta el estado oculto, utilizada para transformar la entradaXten parte del estado oculto.W: matriz de pesos desde el estado oculto hasta el estado oculto, utilizada para transformar el estado oculto del paso de tiempo anteriorht-1en parte del estado oculto del paso de tiempo actual.V: matriz de pesos desde el estado oculto hasta la salida, utilizada para transformar el estado ocultohten la salida.Yt。
Secuencia de salida (Yt, Yt-1, Yt+1, ...): los círculos azules representan la salida de la RNN en cada paso de tiempo; por ejemplo, Yt es la salida del paso de tiempo actual.
Conexión recurrente: la característica de la RNN es la conexión recurrente del estado oculto, lo que permite a la red tener en cuenta la información de pasos de tiempo anteriores al procesar la entrada del paso de tiempo actual.
-
Despliegue (Unfold): la figura muestra el proceso de despliegue de la RNN a lo largo de la secuencia, lo que ayuda a entender cómo la RNN procesa los datos secuenciales en el tiempo. En la implementación real de la RNN, estos pasos se procesan en paralelo, pero conceptualmente podemos desplegarlos para entender cómo fluye la información.
Flujo de información: la información fluye desde la secuencia de entrada hasta el estado oculto a través de la matriz de pesos U, luego se transmite entre pasos de tiempo a través de la matriz de pesos W y, finalmente, desde el estado oculto hasta la secuencia de salida a través de la matriz de pesos V.
Fundamentos de RNN en PyTorch
En PyTorch, las RNN se pueden utilizar para construir modelos secuenciales complejos.
PyTorch proporciona varios módulos de RNN, que incluyen:
torch.nn.RNN: unidad RNN básica.torch.nn.LSTM: unidad de memoria a largo plazo (LSTM), capaz de aprender dependencias a largo plazo.torch.nn.GRU: unidad recurrente cerrada (GRU), una versión simplificada de LSTM, pero generalmente más fácil de entrenar.
Al usar la clase RNN, debe especificar la dimensión de entrada, la dimensión de la capa oculta y otros hiperparámetros.
PyTorch implementa un ejemplo simple de RNN
A continuación se muestra un ejemplo simple de implementación en PyTorch que utiliza un modelo RNN para procesar datos secuenciales y realizar clasificación.
1. Importar las bibliotecas necesarias
Ejemplo
import torch.nn as nn
import torch.optim as optim
from torch.utils.data import DataLoader, TensorDataset
import numpy as np
2. Definir el modelo RNN
Ejemplo
def __init__(self, input_size, hidden_size, output_size):
super(SimpleRNN, self).__init__()
# Definir la capa RNN
self.rnn = nn.RNN(input_size, hidden_size, batch_first=True)
# Definir la capa completamente conectada
self.fc = nn.Linear(hidden_size, output_size)
def forward(self, x):
# x: (batch_size, seq_len, input_size)
out, _ = self.rnn(x) # out: (batch_size, seq_len, hidden_size)
# Tomar la salida del último paso de tiempo de la secuencia como salida del modelo
out = out[:, -1, :] # (batch_size, hidden_size)
out = self.fc(out) # Capa completamente conectada
return out
3. Crear datos de entrenamiento
Para entrenar la RNN, generamos algunos datos de secuencia aleatorios. Aquí el objetivo es utilizar el último valor de cada secuencia como objetivo de clasificación.
Ejemplo
num_samples = 1000
seq_len = 10
input_size = 5
output_size = 2 # Supongamos un problema de clasificación binaria
# Generar datos de entrada aleatorios (batch_size, seq_len, input_size)
X = torch.randn(num_samples, seq_len, input_size)
# Generar etiquetas objetivo aleatorias (batch_size, output_size)
Y = torch.randint(0, output_size, (num_samples,))
# Crear un cargador de datos
dataset = TensorDataset(X, Y)
train_loader = DataLoader(dataset, batch_size=32, shuffle=True)
4. Definir la función de pérdida y el optimizador
Ejemplo
model = SimpleRNN(input_size=input_size, hidden_size=64, output_size=output_size)
# Definir la función de pérdida y el optimizador
criterion = nn.CrossEntropyLoss() # Pérdida de entropía cruzada para clasificación multiclase
optimizer = optim.Adam(model.parameters(), lr=0.001)
5. Entrenar el modelo
Ejemplo
for epoch in range(num_epochs):
model.train() # Establecer el modelo en modo de entrenamiento
total_loss = 0
correct = 0
total = 0
for inputs, labels in train_loader:
# Propagación hacia adelante
outputs = model(inputs)
loss = criterion(outputs, labels)
# Propagación hacia atrás y optimización
optimizer.zero_grad()
loss.backward()
optimizer.step()
total_loss += loss.item()
# Calcular la precisión
_, predicted = torch.max(outputs, 1)
total += labels.size(0)
correct += (predicted == labels).sum().item()
accuracy = 100 * correct / total
print(f"Epoch [{epoch+1}/{num_epochs}], Loss: {total_loss / len(train_loader):.4f}, Accuracy: {accuracy:.2f}%")
6. Probar el modelo
Después del entrenamiento, podemos evaluar el rendimiento del modelo en el conjunto de prueba.
Ejemplo
model.eval() # Establecer el modelo en modo de evaluación
with torch.no_grad():
total = 0
correct = 0
for inputs, labels in train_loader:
outputs = model(inputs)
_, predicted = torch.max(outputs, 1)
total += labels.size(0)
correct += (predicted == labels).sum().item()
accuracy = 100 * correct / total
print(f"Test Accuracy: {accuracy:.2f}%")
7. El código completo es el siguiente:
Ejemplo
import torch.nn as nn
import torch.optim as optim
import matplotlib.pyplot as plt
import numpy as np
# Conjunto de datos: predicción de secuencia de caracteres (Hello -> Elloh)
char_set = list("hello")
char_to_idx = {c: i for i, c in enumerate(char_set)}
idx_to_char = {i: c for i, c in enumerate(char_set)}
# Preparación de datos
input_str = "hello"
target_str = "elloh"
input_data = [char_to_idx[c] for c in input_str]
target_data = [char_to_idx[c] for c in target_str]
# Convertir a codificación one-hot
input_one_hot = np.eye(len(char_set))[input_data]
# Convertir a Tensor de PyTorch
inputs = torch.tensor(input_one_hot, dtype=torch.float32)
targets = torch.tensor(target_data, dtype=torch.long)
# Hiperparámetros del modelo
input_size = len(char_set)
hidden_size = 8
output_size = len(char_set)
num_epochs = 200
learning_rate = 0.1
# Definir el modelo RNN
class RNNModel(nn.Module):
def __init__(self, input_size, hidden_size, output_size):
super(RNNModel, self).__init__()
self.rnn = nn.RNN(input_size, hidden_size, batch_first=True)
self.fc = nn.Linear(hidden_size, output_size)
def forward(self, x, hidden):
out, hidden = self.rnn(x, hidden)
out = self.fc(out) # Aplicar la capa completamente conectada
return out, hidden
model = RNNModel(input_size, hidden_size, output_size)
# Definir la función de pérdida y el optimizador
criterion = nn.CrossEntropyLoss()
optimizer = optim.Adam(model.parameters(), lr=learning_rate)
# Entrenar la RNN
losses = []
hidden = None # El estado oculto inicial es None
for epoch in range(num_epochs):
optimizer.zero_grad()
# Propagación hacia adelante
outputs, hidden = model(inputs.unsqueeze(0), hidden)
hidden = hidden.detach() # Prevenir la explosión del gradiente
# Calcular la pérdida
loss = criterion(outputs.view(-1, output_size), targets)
loss.backward()
optimizer.step()
losses.append(loss.item())
if (epoch + 1) % 20 == 0:
print(f"Epoch [{epoch + 1}/{num_epochs}], Loss: {loss.item():.4f}")
# Probar la RNN
with torch.no_grad():
test_hidden = None
test_output, _ = model(inputs.unsqueeze(0), test_hidden)
predicted = torch.argmax(test_output, dim=2).squeeze().numpy()
print("Input sequence: ", ''.join([idx_to_char[i] for i in input_data]))
print("Predicted sequence: ", ''.join([idx_to_char[i] for i in predicted]))
Análisis del código:
Preparación de datos:
- Utiliza la secuencia de caracteres
helloy la convierte en codificación one-hot. - La secuencia objetivo es
elloh, es decir, rotar un carácter hacia la derecha.
- Utiliza la secuencia de caracteres
Construcción del modelo:
- Utiliza
torch.nn.RNNpara crear la red neuronal recurrente. - Añade una capa completamente conectada
torch.nn.Linearpara mapear el estado oculto a la salida.
- Utiliza
Parte de entrenamiento:
- En cada ronda se calcula la pérdida y se realiza la propagación hacia atrás.
- El estado oculto se
hidden.detach()previene la explosión del gradiente.
Parte de prueba:
- El modelo genera la predicción del carácter.
Visualización:
- Utiliza Matplotlib para dibujar la tendencia de cambio de la pérdida de entrenamiento.
Suponiendo que tu modelo se ha entrenado correctamente, la salida podría ser la siguiente:
Epoch [20/200], Loss: 0.0013
Epoch [40/200], Loss: 0.0003
Epoch [60/200], Loss: 0.0002
Epoch [80/200], Loss: 0.0001
Epoch [100/200], Loss: 0.0001
Epoch [120/200], Loss: 0.0001
Epoch [140/200], Loss: 0.0001
Epoch [160/200], Loss: 0.0001
Epoch [180/200], Loss: 0.0001
Epoch [200/200], Loss: 0.0001
Input sequence:  hello
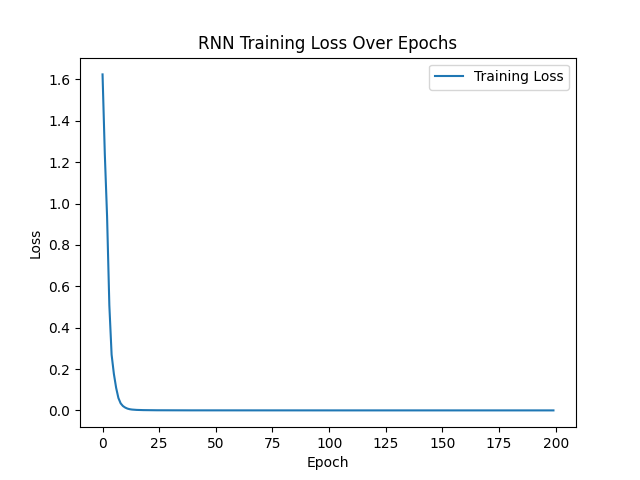
Según los resultados, la imagen muestra que la pérdida disminuye gradualmente, lo que indica que el entrenamiento del modelo es efectivo.
8. Código de visualización:Ejemplo
import torch.nn as nn
import torch.optim as optim
import matplotlib.pyplot as plt
import numpy as np
# Dataset: predicción de secuencia de caracteres (Hello -> Elloh)
char_set = list("hello")
char_to_idx = {c: i for i, c in enumerate(char_set)}
idx_to_char = {i: c for i, c in enumerate(char_set)}
# Preparación de datos
input_str = "hello"
target_str = "elloh"
input_data = [char_to_idx[c] for c in input_str]
target_data = [char_to_idx[c] for c in target_str]
# Convertir a codificación one-hot
input_one_hot = np.eye(len(char_set))[input_data]
# Convertir a Tensor de PyTorch
inputs = torch.tensor(input_one_hot, dtype=torch.float32)
targets = torch.tensor(target_data, dtype=torch.long)
# Hiperparámetros del modelo
input_size = len(char_set)
hidden_size = 8
output_size = len(char_set)
num_epochs = 200
learning_rate = 0.1
# Definir el modelo RNN
class RNNModel(nn.Module):
def __init__(self, input_size, hidden_size, output_size):
super(RNNModel, self).__init__()
self.rnn = nn.RNN(input_size, hidden_size, batch_first=True)
self.fc = nn.Linear(hidden_size, output_size)
def forward(self, x, hidden):
out, hidden = self.rnn(x, hidden)
out = self.fc(out) # Aplicar capa totalmente conectada
return out, hidden
model = RNNModel(input_size, hidden_size, output_size)
# Definir función de pérdida y optimizador
criterion = nn.CrossEntropyLoss()
optimizer = optim.Adam(model.parameters(), lr=learning_rate)
# Entrenar RNN
losses = []
hidden = None # Estado oculto inicial como None
for epoch in range(num_epochs):
optimizer.zero_grad()
# Propagación hacia adelante
outputs, hidden = model(inputs.unsqueeze(0), hidden)
hidden = hidden.detach() # Prevenir explosión de gradiente
# Calcular pérdida
loss = criterion(outputs.view(-1, output_size), targets)
loss.backward()
optimizer.step()
losses.append(loss.item())
if (epoch + 1) % 20 == 0:
print(f"Epoch [{epoch + 1}/{num_epochs}], Loss: {loss.item():.4f}")
# Probar RNN
with torch.no_grad():
test_hidden = None
test_output, _ = model(inputs.unsqueeze(0), test_hidden)
predicted = torch.argmax(test_output, dim=2).squeeze().numpy()
print("Input sequence: ", ''.join([idx_to_char[i] for i in input_data]))
print("Predicted sequence: ", ''.join([idx_to_char[i] for i in predicted]))
# Visualizar pérdida
plt.plot(losses, label="Training Loss")
plt.xlabel("Epoch")
plt.ylabel("Loss")
plt.title("RNN Training Loss Over Epochs")
plt.legend()
plt.show()
Después de la ejecución, se muestra la imagen como se indica a continuación: