PyTorch Рекуррентная нейронная сеть (RNN)
Рекуррентные нейронные сети (RNN) — это класс архитектур нейронных сетей, специально предназначенных для обработки данных последовательностей. Они могут улавливать динамическую информацию из временных рядов или упорядоченных данных и могут обрабатывать данные последовательностей, такие как текст, временные ряды или аудио.
RNN находит широкое применение в таких задачах, как обработка естественного языка (NLP), распознавание речи и прогнозирование временных рядов.
Ключевая особенность RNN — способность поддерживать скрытое состояние, позволяя сети запоминать информацию с предыдущих временных шагов, что необходимо для обработки данных последовательностей.
Базовая структура RNN
В традиционной нейронной сети прямого распространения данные проходят от входного слоя к выходному слою. В RNN же данные не только проходят через слои сети, но и передаются в текущее состояние скрытого слоя на каждом временном шаге, тем самым передавая предыдущую информацию на следующий временной шаг.
Скрытое состояние:RNN использует скрытое состояние для запоминания информации в последовательности.
Скрытое состояние вычисляется из скрытого состояния предыдущего временного шага и текущего входа.
Структура рекуррентного блока выглядит следующим образом:
- Вход (\(x_t\)): входной вектор на временном шаге \(t\).
- Скрытое состояние (\(h_t\)): вектор скрытого состояния на временном шаге \(t\), используемый для хранения информации с предыдущих временных шагов.
- Выход (\(y_t\)): выходной вектор на временном шаге \(t\) (необязательно, в зависимости от конкретной задачи).
Формула:
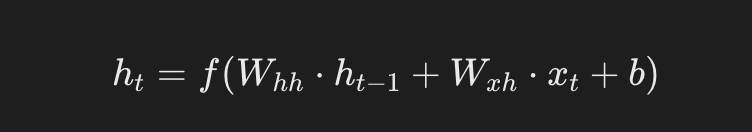
\[ h_t = f(W_{hh}h_{t-1} + W_{xh}x_t + b_h) \]
- ht: скрытое состояние на текущем временном шаге.
- ht-1: скрытое состояние на предыдущем временном шаге.
- Xt: вход на текущем временном шаге.
- Whh、Wxh: матрица весов.
- b: член смещения.
- f: функция активации (например, Tanh или ReLU).
Выход:Выход RNN зависит не только от текущего входа, но и от исторической информации скрытого состояния.
Формула:
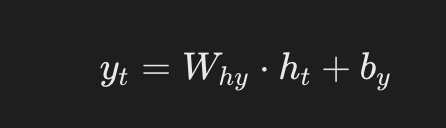
\[ y_t = W_{hy}h_t + b_y \]
- yt: выходной вектор на временном шаге t (необязательно, в зависимости от конкретной задачи).
- Why: матрица весов из скрытого состояния в выход.
Как RNN обрабатывает последовательные данные
Развернутое представление рекуррентной нейронной сети (RNN) при обработке последовательных данных выглядит следующим образом:
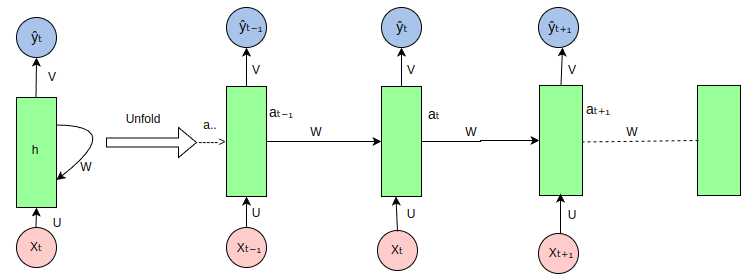
RNN — это нейронная сеть для обработки последовательных данных. Она обрабатывает каждый элемент последовательности через рекуррентные связи и передает информацию на каждом временном шаге. Ниже приведено объяснение каждой части на рисунке:
-
Входная последовательность (Xt, Xt-1, Xt+1, ...): Розовые круги на рисунке представляют элементы входной последовательности. Например, Xt — это вход на текущем временном шаге, Xt-1 — вход на предыдущем временном шаге, и так далее.
Скрытое состояние (ht, ht-1, ht+1, ...): Зеленые прямоугольники представляют скрытое состояние RNN, которое хранит информацию о последовательности на каждом временном шаге. ht — это скрытое состояние на текущем временном шаге, ht-1 — скрытое состояние на предыдущем временном шаге.
Матрицы весов (U, W, V):
U: Матрица весов из входа в скрытое состояние, используемая для преобразования входаXtв часть скрытого состояния.W: Матрица весов из скрытого состояния в скрытое состояние, используемая для преобразования скрытого состояния предыдущего временного шагаht-1в часть скрытого состояния текущего временного шага.V: Весовая матрица от скрытого состояния к выходу, используемая для преобразования скрытого состоянияhtв выход.Yt。
Выходная последовательность (Yt, Yt-1, Yt+1, ...): Синие кружки представляют выход RNN на каждом временном шаге. Например, Yt — это выход на текущем временном шаге.
Рекуррентная связь: Характерной особенностью RNN является рекуррентная связь скрытого состояния, которая позволяет сети учитывать информацию с предыдущих временных шагов при обработке входа на текущем временном шаге.
-
Развёртка: На рисунке показан процесс развёртки RNN по последовательности, что помогает понять, как RNN обрабатывает данные последовательности во времени. В реальных реализациях RNN эти шаги обрабатываются параллельно, но концептуально мы можем развернуть её, чтобы понять, как течёт информация.
Поток информации: Информация течёт от входной последовательности к скрытому состоянию через весовую матрицу U, затем между временными шагами через весовую матрицу W и, наконец, от скрытого состояния к выходной последовательности через весовую матрицу V.
Основы RNN в PyTorch
В PyTorch RNN можно использовать для построения сложных моделей последовательностей.
PyTorch предоставляет несколько модулей RNN, включая:
torch.nn.RNN: Базовая ячейка RNN.torch.nn.LSTM: Ячейка Long Short-Term Memory (LSTM), способная изучать долгосрочные зависимости.torch.nn.GRU: Управляемый рекуррентный блок, упрощённая версия LSTM, но обычно проще в обучении.
При использовании класса RNN необходимо указать размерность входа, размерность скрытого слоя и некоторые другие гиперпараметры.
Пример реализации простой RNN на PyTorch
Ниже приведён простой пример реализации на PyTorch, в котором модель RNN используется для обработки данных последовательности и выполнения классификации.
1. Импорт необходимых библиотек
Пример
import torch.nn as nn
import torch.optim as optim
from torch.utils.data import DataLoader, TensorDataset
import numpy as np
2. Определение модели RNN
Пример
def __init__(self, input_size, hidden_size, output_size):
super(SimpleRNN, self).__init__()
# Определение слоя RNN
self.rnn = nn.RNN(input_size, hidden_size, batch_first=True)
# Определение полносвязного слоя
self.fc = nn.Linear(hidden_size, output_size)
def forward(self, x):
# x: (batch_size, seq_len, input_size)
out, _ = self.rnn(x) # out: (batch_size, seq_len, hidden_size)
# Использовать выход последнего временного шага последовательности как выход модели
out = out[:, -1, :] # (batch_size, hidden_size)
out = self.fc(out) # Полносвязный слой
return out
3. Создание обучающих данных
Чтобы обучить RNN, мы генерируем случайные данные последовательностей. Здесь цель — использовать последнее значение каждой последовательности в качестве целевой метки для классификации.
Пример
num_samples = 1000
seq_len = 10
input_size = 5
output_size = 2 # Предполагаем задачу бинарной классификации
# Случайно сгенерировать входные данные (batch_size, seq_len, input_size)
X = torch.randn(num_samples, seq_len, input_size)
# Случайно сгенерировать целевые метки (batch_size, output_size)
Y = torch.randint(0, output_size, (num_samples,))
# Создать загрузчик данных
dataset = TensorDataset(X, Y)
train_loader = DataLoader(dataset, batch_size=32, shuffle=True)
4. Определите функцию потерь и оптимизатор
Пример
model = SimpleRNN(input_size=input_size, hidden_size=64, output_size=output_size)
# Определяем функцию потерь и оптимизатор
criterion = nn.CrossEntropyLoss() # Многоклассовая кросс-энтропийная потеря
optimizer = optim.Adam(model.parameters(), lr=0.001)
5. Обучите модель
Пример
for epoch in range(num_epochs):
model.train() # Установить модель в режим обучения
total_loss = 0
correct = 0
total = 0
for inputs, labels in train_loader:
# Прямой проход
outputs = model(inputs)
loss = criterion(outputs, labels)
# Обратное распространение и оптимизация
optimizer.zero_grad()
loss.backward()
optimizer.step()
total_loss += loss.item()
# Вычислите точность
_, predicted = torch.max(outputs, 1)
total += labels.size(0)
correct += (predicted == labels).sum().item()
accuracy = 100 * correct / total
print(f"Эпоха [{epoch+1}/{num_epochs}], Потери: {total_loss / len(train_loader):.4f}, Точность: {accuracy:.2f}%")
6. Протестируйте модель
После обучения мы можем оценить производительность модели на тестовом наборе.
Пример
model.eval() # Перевести модель в режим оценки
with torch.no_grad():
total = 0
correct = 0
for inputs, labels in train_loader:
outputs = model(inputs)
_, predicted = torch.max(outputs, 1)
total += labels.size(0)
correct += (predicted == labels).sum().item()
accuracy = 100 * correct / total
print(f"Точность на тесте: {accuracy:.2f}%")
7. Полный код выглядит следующим образом:
Пример
import torch.nn as nn
import torch.optim as optim
import matplotlib.pyplot as plt
import numpy as np
# Набор данных: предсказание последовательности символов (Hello -> Elloh)
char_set = list("hello")
char_to_idx = {c: i for i, c in enumerate(char_set)}
idx_to_char = {i: c for i, c in enumerate(char_set)}
# Подготовка данных
input_str = "hello"
target_str = "elloh"
input_data = [char_to_idx[c] for c in input_str]
target_data = [char_to_idx[c] for c in target_str]
# Преобразование в one-hot encoding
input_one_hot = np.eye(len(char_set))[input_data]
# Преобразовать в тензор PyTorch
inputs = torch.tensor(input_one_hot, dtype=torch.float32)
targets = torch.tensor(target_data, dtype=torch.long)
# Гиперпараметры модели
input_size = len(char_set)
hidden_size = 8
output_size = len(char_set)
num_epochs = 200
learning_rate = 0.1
# Определить модель RNN
class RNNModel(nn.Module):
def __init__(self, input_size, hidden_size, output_size):
super(RNNModel, self).__init__()
self.rnn = nn.RNN(input_size, hidden_size, batch_first=True)
self.fc = nn.Linear(hidden_size, output_size)
def forward(self, x, hidden):
out, hidden = self.rnn(x, hidden)
out = self.fc(out) # Применить полносвязный слой
return out, hidden
model = RNNModel(input_size, hidden_size, output_size)
# Определяем функцию потерь и оптимизатор
criterion = nn.CrossEntropyLoss()
optimizer = optim.Adam(model.parameters(), lr=learning_rate)
# Обучение RNN
losses = []
hidden = None # Начальное скрытое состояние — None
for epoch in range(num_epochs):
optimizer.zero_grad()
# Прямой проход
outputs, hidden = model(inputs.unsqueeze(0), hidden)
hidden = hidden.detach() # Предотвращение взрыва градиентов
# Вычислите потери
loss = criterion(outputs.view(-1, output_size), targets)
loss.backward()
optimizer.step()
losses.append(loss.item())
if (epoch + 1) % 20 == 0:
print(f"Эпоха [{epoch + 1}/{num_epochs}], Потери: {loss.item():.4f}")
# Тестирование RNN
with torch.no_grad():
test_hidden = None
test_output, _ = model(inputs.unsqueeze(0), test_hidden)
predicted = torch.argmax(test_output, dim=2).squeeze().numpy()
print("Входная последовательность: ", ''.join([idx_to_char[i] for i in input_data]))
print("Предсказанная последовательность: ", ''.join([idx_to_char[i] for i in predicted]))
Пояснение к коду:
Подготовка данных:
- Используйте последовательность символов
hello, и преобразуйте её в one-hot кодирование. - Целевая последовательность —
elloh, то есть сдвиньте один символ вправо.
- Используйте последовательность символов
Построение модели:
- Используйте
torch.nn.RNNСоздайте рекуррентную нейронную сеть. - Добавить полносвязный слой
torch.nn.LinearИспользуется для преобразования скрытого состояния в выход.
- Используйте
Этап обучения:
- На каждой эпохе вычисляется потеря и выполняется обратное распространение.
- Скрытое состояние пропускается через
hidden.detach()чтобы предотвратить взрыв градиентов.
Этап тестирования:
- Модель выводит предсказанные результаты символов.
Визуализация:
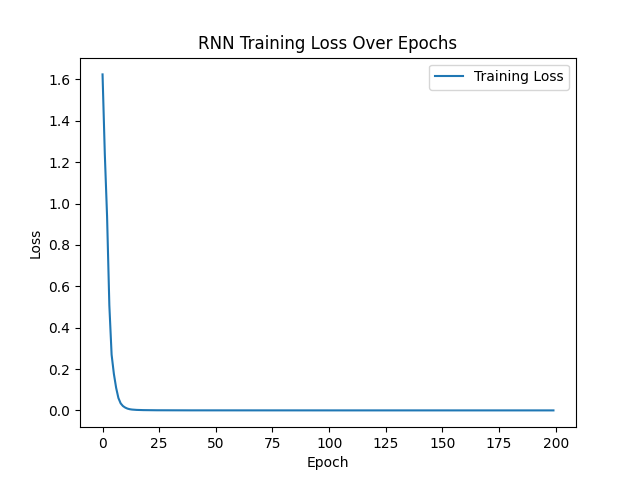
- Используйте Matplotlib для построения графика динамики потерь при обучении.
Предполагая, что ваша модель хорошо обучена, вывод может быть следующим:
Epoch [20/200], Loss: 0.0013
Epoch [40/200], Loss: 0.0003
Epoch [60/200], Loss: 0.0002
Epoch [80/200], Loss: 0.0001
Epoch [100/200], Loss: 0.0001
Epoch [120/200], Loss: 0.0001
Epoch [140/200], Loss: 0.0001
Epoch [160/200], Loss: 0.0001
Epoch [180/200], Loss: 0.0001
Epoch [200/200], Loss: 0.0001
Input sequence:  hello
Судя по результатам, на графике наблюдается постепенное снижение потерь, что указывает на эффективность обучения модели.
8. Код визуализации:Пример
import torch.nn as nn
import torch.optim as optim
import matplotlib.pyplot as plt
import numpy as np
# Набор данных: предсказание последовательности символов (Hello -> Elloh)
char_set = list("hello")
char_to_idx = {c: i for i, c in enumerate(char_set)}
idx_to_char = {i: c for i, c in enumerate(char_set)}
# Подготовка данных
input_str = "hello"
target_str = "elloh"
input_data = [char_to_idx[c] for c in input_str]
target_data = [char_to_idx[c] for c in target_str]
# Преобразование в one-hot encoding
input_one_hot = np.eye(len(char_set))[input_data]
# Преобразовать в тензор PyTorch
inputs = torch.tensor(input_one_hot, dtype=torch.float32)
targets = torch.tensor(target_data, dtype=torch.long)
# Гиперпараметры модели
input_size = len(char_set)
hidden_size = 8
output_size = len(char_set)
num_epochs = 200
learning_rate = 0.1
# Определить модель RNN
class RNNModel(nn.Module):
def __init__(self, input_size, hidden_size, output_size):
super(RNNModel, self).__init__()
self.rnn = nn.RNN(input_size, hidden_size, batch_first=True)
self.fc = nn.Linear(hidden_size, output_size)
def forward(self, x, hidden):
out, hidden = self.rnn(x, hidden)
out = self.fc(out) # Применить полносвязный слой
return out, hidden
model = RNNModel(input_size, hidden_size, output_size)
# Определяем функцию потерь и оптимизатор
criterion = nn.CrossEntropyLoss()
optimizer = optim.Adam(model.parameters(), lr=learning_rate)
# Обучить RNN
losses = []
hidden = None # Начальное скрытое состояние — None
for epoch in range(num_epochs):
optimizer.zero_grad()
# Прямое распространение
outputs, hidden = model(inputs.unsqueeze(0), hidden)
hidden = hidden.detach() # Предотвращение взрыва градиентов
# Вычислить потери
loss = criterion(outputs.view(-1, output_size), targets)
loss.backward()
optimizer.step()
losses.append(loss.item())
if (epoch + 1) % 20 == 0:
print(f"Эпоха [{epoch + 1}/{num_epochs}], Потери: {loss.item():.4f}")
# Тестировать RNN
with torch.no_grad():
test_hidden = None
test_output, _ = model(inputs.unsqueeze(0), test_hidden)
predicted = torch.argmax(test_output, dim=2).squeeze().numpy()
print("Входная последовательность: ", ''.join([idx_to_char[i] for i in input_data]))
print("Предсказанная последовательность: ", ''.join([idx_to_char[i] for i in predicted]))
# Визуализировать потери
plt.plot(losses, label="Потери при обучении")
plt.xlabel("Эпоха")
plt.ylabel("Потери")
plt.title("Потери при обучении RNN по эпохам")
plt.legend()
plt.show()
После выполнения отображается следующее изображение: