Réseau neuronal récurrent PyTorch (RNN)
Les réseaux de neurones récurrents (RNN) sont une classe d'architectures de réseaux de neurones spécialement conçues pour traiter des données séquentielles. Ils peuvent capturer des informations dynamiques à partir de séries temporelles ou de données ordonnées et peuvent traiter des données séquentielles telles que du texte, des séries temporelles ou de l'audio.
Les RNN ont un large éventail d'applications dans des tâches telles que le traitement du langage naturel (NLP), la reconnaissance vocale et la prédiction de séries temporelles.
Une caractéristique clé des RNN est leur capacité à maintenir un état caché, ce qui permet au réseau de se souvenir des informations des pas de temps précédents, ce qui est essentiel pour le traitement des données séquentielles.
Structure de base des RNN
Dans un réseau de neurones feedforward traditionnel, les données circulent de la couche d'entrée vers la couche de sortie. Dans un RNN, cependant, les données ne circulent pas seulement à travers les couches du réseau, mais se propagent aussi vers l'état actuel de la couche cachée à chaque pas de temps, transmettant ainsi les informations précédentes au pas de temps suivant.
État caché:Le RNN utilise l'état caché pour mémoriser les informations de la séquence.
L'état caché est calculé à partir de l'état caché du pas de temps précédent et de l'entrée actuelle.
La structure de l'unité récurrente est la suivante :
- Entrée (\(x_t\)) : le vecteur d'entrée au pas de temps \(t\).
- État caché (\(h_t\)) : le vecteur d'état caché au pas de temps \(t\), utilisé pour stocker les informations des pas de temps précédents.
- Sortie (\(y_t\)) : le vecteur de sortie au pas de temps \(t\) (facultatif, selon la tâche spécifique).
Formule :
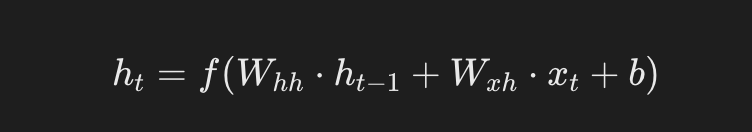
\[ h_t = f(W_{hh}h_{t-1} + W_{xh}x_t + b_h) \]
- ht: l'état caché au pas de temps actuel.
- ht-1: l'état caché au pas de temps précédent.
- Xt: l'entrée au pas de temps actuel.
- Whh、Wxh: matrice de poids.
- b: terme de biais.
- f: fonction d'activation (telle que Tanh ou ReLU).
Sortie :La sortie d'un RNN dépend non seulement de l'entrée actuelle, mais aussi des informations historiques de l'état caché.
Formule :
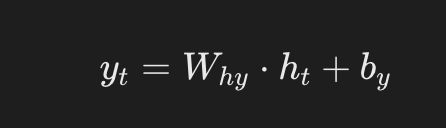
\[ y_t = W_{hy}h_t + b_y \]
- yt: le vecteur de sortie au pas de temps t (facultatif, selon la tâche spécifique).
- Why: la matrice de poids de l'état caché vers la sortie.
Comment le RNN traite les données séquentielles
La vue dépliée d'un réseau de neurones récurrent (RNN) lors du traitement de données séquentielles est la suivante :
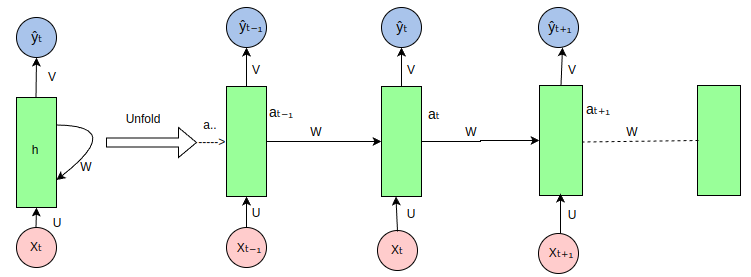
Un RNN est un réseau de neurones pour le traitement de données séquentielles. Il traite chaque élément de la séquence par l'intermédiaire de connexions récurrentes et transmet des informations à chaque pas de temps. Voici une explication de chaque partie de la figure :
-
Séquence d'entrée (Xt, Xt-1, Xt+1, ...): Les cercles roses sur la figure représentent les éléments de la séquence d'entrée. Par exemple, Xt est l'entrée au pas de temps actuel, Xt-1 est l'entrée au pas de temps précédent, et ainsi de suite.
État caché (ht, ht-1, ht+1, ...): Les rectangles verts représentent l'état caché du RNN, qui stocke des informations sur la séquence à chaque pas de temps. ht est l'état caché au pas de temps actuel, ht-1 est l'état caché au pas de temps précédent.
Matrices de poids (U, W, V):
U: La matrice de poids de l'entrée vers l'état caché, utilisée pour transformer l'entréeXten une partie de l'état caché.W: La matrice de poids de l'état caché vers l'état caché, utilisée pour transformer l'état caché du pas de temps précédentht-1en une partie de l'état caché du pas de temps actuel.V: La matrice de poids de l'état caché vers la sortie, utilisée pour transformer l'état cachéhtvers la sortie.Yt。
Séquence de sortie (Yt, Yt-1, Yt+1, ...): Les cercles bleus représentent la sortie du RNN à chaque pas de temps. Par exemple, Yt est la sortie au pas de temps actuel.
Connexion récurrente: Une caractéristique des RNN est la connexion récurrente de l'état caché, qui permet au réseau de prendre en compte les informations des pas de temps précédents lors du traitement de l'entrée au pas de temps actuel.
-
Déroulement: La figure montre le processus de déroulement du RNN sur une séquence, ce qui aide à comprendre comment le RNN traite les données de séquence au fil du temps. Dans les implémentations réelles de RNN, ces étapes sont traitées en parallèle, mais conceptuellement, nous pouvons le dérouler pour comprendre comment les informations circulent.
Flux d'informations: L'information circule de la séquence d'entrée vers l'état caché via la matrice de poids U, puis entre les pas de temps via la matrice de poids W, et enfin de l'état caché vers la séquence de sortie via la matrice de poids V.
Notions de base des RNN dans PyTorch
Dans PyTorch, les RNN peuvent être utilisés pour construire des modèles de séquence complexes.
PyTorch fournit plusieurs modules RNN, notamment :
torch.nn.RNN: Cellule RNN de base.torch.nn.LSTM: Cellule Long Short-Term Memory (LSTM), capable d'apprendre des dépendances à long terme.torch.nn.GRU: Unité récurrente à portes, une version simplifiée de LSTM, mais généralement plus facile à entraîner.
Lors de l'utilisation de la classe RNN, vous devez spécifier la dimension d'entrée, la dimension de la couche cachée et certains autres hyperparamètres.
Implémentation d'un exemple simple de RNN avec PyTorch
Voici un exemple d'implémentation simple avec PyTorch qui utilise un modèle RNN pour traiter des données de séquence et effectuer une classification.
1. Importer les bibliothèques nécessaires
Exemple
import torch.nn as nn
import torch.optim as optim
from torch.utils.data import DataLoader, TensorDataset
import numpy as np
2. Définir le modèle RNN
Exemple
def __init__(self, input_size, hidden_size, output_size):
super(SimpleRNN, self).__init__()
# Définir la couche RNN
self.rnn = nn.RNN(input_size, hidden_size, batch_first=True)
# Définir la couche entièrement connectée
self.fc = nn.Linear(hidden_size, output_size)
def forward(self, x):
# x: (batch_size, seq_len, input_size)
out, _ = self.rnn(x) # out: (batch_size, seq_len, hidden_size)
# Prendre la sortie du dernier pas de temps de la séquence comme sortie du modèle
out = out[:, -1, :] # (batch_size, hidden_size)
out = self.fc(out) # Couche entièrement connectée
return out
3. Créer les données d'entraînement
Pour entraîner le RNN, nous générons des données de séquence aléatoires. Ici, l'objectif est d'utiliser la dernière valeur de chaque séquence comme cible de classification.
Exemple
num_samples = 1000
seq_len = 10
input_size = 5
output_size = 2 # Supposons un problème de classification binaire
# Générer aléatoirement les données d'entrée (batch_size, seq_len, input_size)
X = torch.randn(num_samples, seq_len, input_size)
# Générer aléatoirement les étiquettes cibles (batch_size, output_size)
Y = torch.randint(0, output_size, (num_samples,))
# Créer le chargeur de données
dataset = TensorDataset(X, Y)
train_loader = DataLoader(dataset, batch_size=32, shuffle=True)
4. Définir la fonction de perte et l'optimiseur
Exemple
model = SimpleRNN(input_size=input_size, hidden_size=64, output_size=output_size)
# Définir la fonction de perte et l'optimiseur
criterion = nn.CrossEntropyLoss() # Perte d'entropie croisée multiclasse
optimizer = optim.Adam(model.parameters(), lr=0.001)
5. Entraîner le modèle
Exemple
for epoch in range(num_epochs):
model.train() # Mettre le modèle en mode entraînement
total_loss = 0
correct = 0
total = 0
for inputs, labels in train_loader:
# Passe avant
outputs = model(inputs)
loss = criterion(outputs, labels)
# Rétropropagation et optimisation
optimizer.zero_grad()
loss.backward()
optimizer.step()
total_loss += loss.item()
# Calculer la précision
_, predicted = torch.max(outputs, 1)
total += labels.size(0)
correct += (predicted == labels).sum().item()
accuracy = 100 * correct / total
print(f"Époque [{epoch+1}/{num_epochs}], Perte: {total_loss / len(train_loader):.4f}, Précision: {accuracy:.2f}%")
6. Tester le modèle
Après l'entraînement, nous pouvons évaluer les performances du modèle sur l'ensemble de test.
Exemple
model.eval() # Mettre le modèle en mode évaluation
with torch.no_grad():
total = 0
correct = 0
for inputs, labels in train_loader:
outputs = model(inputs)
_, predicted = torch.max(outputs, 1)
total += labels.size(0)
correct += (predicted == labels).sum().item()
accuracy = 100 * correct / total
print(f"Précision du test : {accuracy:.2f}%")
7. Le code complet est le suivant :
Exemple
import torch.nn as nn
import torch.optim as optim
import matplotlib.pyplot as plt
import numpy as np
# Jeu de données : prédiction de séquence de caractères (Hello -> Elloh)
char_set = list("hello")
char_to_idx = {c: i for i, c in enumerate(char_set)}
idx_to_char = {i: c for i, c in enumerate(char_set)}
# Préparation des données
input_str = "hello"
target_str = "elloh"
input_data = [char_to_idx[c] for c in input_str]
target_data = [char_to_idx[c] for c in target_str]
# Convertir en encodage one-hot
input_one_hot = np.eye(len(char_set))[input_data]
# Convertir en tenseur PyTorch
inputs = torch.tensor(input_one_hot, dtype=torch.float32)
targets = torch.tensor(target_data, dtype=torch.long)
# Hyperparamètres du modèle
input_size = len(char_set)
hidden_size = 8
output_size = len(char_set)
num_epochs = 200
learning_rate = 0.1
# Définir le modèle RNN
class RNNModel(nn.Module):
def __init__(self, input_size, hidden_size, output_size):
super(RNNModel, self).__init__()
self.rnn = nn.RNN(input_size, hidden_size, batch_first=True)
self.fc = nn.Linear(hidden_size, output_size)
def forward(self, x, hidden):
out, hidden = self.rnn(x, hidden)
out = self.fc(out) # Appliquer la couche entièrement connectée
return out, hidden
model = RNNModel(input_size, hidden_size, output_size)
# Définir la fonction de perte et l'optimiseur
criterion = nn.CrossEntropyLoss()
optimizer = optim.Adam(model.parameters(), lr=learning_rate)
# Entraîner le RNN
losses = []
hidden = None # L'état caché initial est None
for epoch in range(num_epochs):
optimizer.zero_grad()
# Passe avant
outputs, hidden = model(inputs.unsqueeze(0), hidden)
hidden = hidden.detach() # Empêcher l'explosion du gradient
# Calculer la perte
loss = criterion(outputs.view(-1, output_size), targets)
loss.backward()
optimizer.step()
losses.append(loss.item())
if (epoch + 1) % 20 == 0:
print(f"Epoch [{epoch + 1}/{num_epochs}], Loss: {loss.item():.4f}")
# Tester le RNN
with torch.no_grad():
test_hidden = None
test_output, _ = model(inputs.unsqueeze(0), test_hidden)
predicted = torch.argmax(test_output, dim=2).squeeze().numpy()
print("Séquence d'entrée : ", ''.join([idx_to_char[i] for i in input_data]))
print("Séquence prédite : ", ''.join([idx_to_char[i] for i in predicted]))
Explication du code :
Préparation des données:
- Utilisez la séquence de caractères
hello, et convertissez-la en encodage one-hot. - La séquence cible est
elloh, c'est-à-dire décaler d'un caractère vers la droite.
- Utilisez la séquence de caractères
Construction du modèle:
- Utiliser
torch.nn.RNNCréez un réseau de neurones récurrent. - Ajouter une couche entièrement connectée
torch.nn.LinearUtilisé pour mapper l'état caché vers la sortie.
- Utiliser
Partie d'entraînement:
- Chaque époque calcule la perte et effectue la rétropropagation.
- L'état caché est passé à travers
hidden.detach()pour éviter l'explosion du gradient.
Partie de test:
- Le modèle produit les résultats des caractères prédits.
Visualisation:
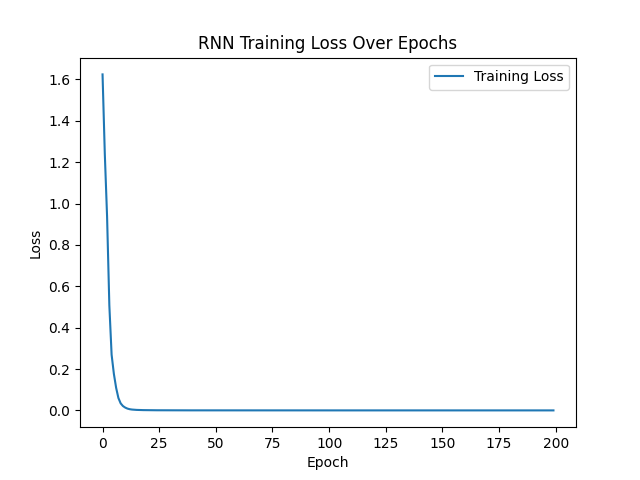
- Utilisez Matplotlib pour tracer l'évolution de la perte d'entraînement.
En supposant que votre modèle soit bien entraîné, la sortie pourrait être la suivante :
Epoch [20/200], Loss: 0.0013
Epoch [40/200], Loss: 0.0003
Epoch [60/200], Loss: 0.0002
Epoch [80/200], Loss: 0.0001
Epoch [100/200], Loss: 0.0001
Epoch [120/200], Loss: 0.0001
Epoch [140/200], Loss: 0.0001
Epoch [160/200], Loss: 0.0001
Epoch [180/200], Loss: 0.0001
Epoch [200/200], Loss: 0.0001
Input sequence:  hello
D'après les résultats, l'image montre une diminution progressive de la perte, ce qui indique que l'entraînement du modèle est efficace.
8. Code de visualisation :Exemple
import torch.nn as nn
import torch.optim as optim
import matplotlib.pyplot as plt
import numpy as np
# Jeu de données : prédiction de séquence de caractères (Hello -> Elloh)
char_set = list("hello")
char_to_idx = {c: i for i, c in enumerate(char_set)}
idx_to_char = {i: c for i, c in enumerate(char_set)}
# Préparation des données
input_str = "hello"
target_str = "elloh"
input_data = [char_to_idx[c] for c in input_str]
target_data = [char_to_idx[c] for c in target_str]
# Convertir en encodage one-hot
input_one_hot = np.eye(len(char_set))[input_data]
# Convertir en tenseur PyTorch
inputs = torch.tensor(input_one_hot, dtype=torch.float32)
targets = torch.tensor(target_data, dtype=torch.long)
# Hyperparamètres du modèle
input_size = len(char_set)
hidden_size = 8
output_size = len(char_set)
num_epochs = 200
learning_rate = 0.1
# Définir le modèle RNN
class RNNModel(nn.Module):
def __init__(self, input_size, hidden_size, output_size):
super(RNNModel, self).__init__()
self.rnn = nn.RNN(input_size, hidden_size, batch_first=True)
self.fc = nn.Linear(hidden_size, output_size)
def forward(self, x, hidden):
out, hidden = self.rnn(x, hidden)
out = self.fc(out) # Appliquer la couche entièrement connectée
return out, hidden
model = RNNModel(input_size, hidden_size, output_size)
# Définir la fonction de perte et l'optimiseur
criterion = nn.CrossEntropyLoss()
optimizer = optim.Adam(model.parameters(), lr=learning_rate)
# Entraîner le RNN
losses = []
hidden = None # L'état caché initial est None
for epoch in range(num_epochs):
optimizer.zero_grad()
# Propagation avant
outputs, hidden = model(inputs.unsqueeze(0), hidden)
hidden = hidden.detach() # Empêcher l'explosion du gradient
# Calculer la perte
loss = criterion(outputs.view(-1, output_size), targets)
loss.backward()
optimizer.step()
losses.append(loss.item())
if (epoch + 1) % 20 == 0:
print(f"Epoch [{epoch + 1}/{num_epochs}], Loss: {loss.item():.4f}")
# Tester le RNN
with torch.no_grad():
test_hidden = None
test_output, _ = model(inputs.unsqueeze(0), test_hidden)
predicted = torch.argmax(test_output, dim=2).squeeze().numpy()
print("Séquence d'entrée : ", ''.join([idx_to_char[i] for i in input_data]))
print("Séquence prédite : ", ''.join([idx_to_char[i] for i in predicted]))
# Visualiser la perte
plt.plot(losses, label="Perte d'entraînement")
plt.xlabel("Époque")
plt.ylabel("Perte")
plt.title("Perte d'entraînement du RNN au fil des époques")
plt.legend()
plt.show()
Après exécution, l'image affichée est la suivante :