Multimodale große Modelle
Multimodale große Modelle ermöglichen es KI, mehrere Informationsformen gleichzeitig zu verarbeiten, wie Text, Bilder, Audio und Video, und sind heute eine der zentralsten Entwicklungsrichtungen für große Modelle.
Dieser Artikel erklärt das Konzept, den Entwicklungsprozess, die internen Prinzipien und typische Fähigkeiten der Multimodalität von Grund auf und bietet am EndeErstellen Sie Ihre erste multimodale Anwendung in 5 Minutenein lauffähiges Beispiel.
1. Was ist Multimodalität?
Gewöhnliche große Modelle können normalerweise nur eine Art von Information verarbeiten—TextWenn Sie einer traditionellen KI ein Bild geben und sie fragen: „Wie viele Katzen sind auf dem Bild?“, kann das Modell dies ohne multimodale Unterstützung nicht beantworten.
Aber die reale Welt besteht nicht aus Text; sie besteht vielmehr aus mehreren Arten von Sinnesinformationen:
| Sinnesorgan | Entsprechende Information |
|---|---|
| Augen | Image |
| Ohr | Klang |
| Mund | Sprache |
| Hand | Aktion |
| Video | Bild + Zeit |
| Webseite | Text + Bild + Struktur |
Daher entstandMultimodaldieses Konzept.
In einem Satz verstanden:
Multimodal = ein Modell, das gleichzeitig mehrere Informationsformen versteht und generiert.
Sehen wir uns zwei typische Beispiele an:
1. Eingabe eines Bildes plus einer Frage:„Ist das Essen auf diesem Bild kalorienreich?“Das Modell antwortet:„Das sind frittiertes Hähnchen und Pommes frites, geschätzt etwa 1,200 Kalorien.“
-
2. Spracheingabe:„Hilf mir, dieses Meeting zusammenzufassen“Das Modell gibt eine Textzusammenfassung mit Handlungsvorschlägen aus.
Diese Fähigkeit, Bilder zu beschreiben und Audio zusammenzufassen, ist die direkteste Manifestation von Multimodalität.
2. Was ist eine Modalität?
Modalität istdie Darstellungsform von Informationen.。
Verschiedene Modalitäten entsprechen unterschiedlichen Eingaben und Ausgaben. Die folgende Tabelle listet gängige Modalitäten und ihre typischen Anwendungen auf:
| Modalität | Eingabebeispiel | Ausgabebeispiel | Typische Anwendung |
|---|---|---|---|
| Text | Romane, Chat-Protokolle | Antworten, Artikel | Q&A, Schreiben, Übersetzung |
| Image | Fotos, Screenshots | Bildverständnis, Bilderzeugung | OCR, visuelle Fragen und Antworten |
| Audio | Sprache, Musik | Text transkribieren, Sprache synthetisieren | Besprechungszusammenfassungen, Sprachassistenten |
| Video | Videostream | Videoanalyse, Zeitachse | Unterrichtszusammenfassungen, Inhaltsabruf |
| Sensor | GPS, Temperatur | Steuersignal | Robotik, autonomes Fahren |
| Aktion | Mausklicks, Tastatureingabe | Aktionen ausführen | GUI-Agent, Automatisierung |
Je mehr Modalitäten ein Modell unterstützt, desto näher kommen seine Fähigkeiten denen des Menschen, weshalb alle führenden Labore Textmodelle zu multimodalen Modellen aufrüsten.
3. Entwicklungsprozess multimodaler großer Modelle
Von der Verarbeitung ausschließlich von Text bis zum Sehen, Hören und Ausgeben von Video haben multimodale große Modelle drei klare Phasen durchlaufen.
Phase 1: Sprachmodelle (LLM)
In dieser Phase nehmen Modelle Text sowohl als Eingabe als auch als Ausgabe. Repräsentative Produkte sind die OpenAI GPT-Serie, Anthropic Claude und Google Gemini.
Sie können Code schreiben, Artikel verfassen, übersetzen und Fragen beantworten. Sie sind sehr leistungsfähig, haben aber eine grundlegende Einschränkung:Sie können nicht sehen.。
Phase 2: Vision-Sprachmodelle (VLM)
VLM fügt die Fähigkeit hinzu, 'Bilder zu sehen', zusätzlich zu einem LLM. Ein typischer Anwendungsfall ist das Hochladen eines Screenshots einer Webseite und die Frage 'Warum ist das Layout falsch?' Das Modell antwortet 'CSS-Konflikt'.
Modelle in dieser Phase beginnen, Fähigkeiten wie Bildverständnis, OCR und Diagrammverständnis zu besitzen.
Phase 3: Native multimodale Modelle
Native multimodale Modelle behandeln 'Bild' und 'Text' nicht mehr als zwei aneinandergereihte Module. Stattdessen verarbeiten sievom allerersten Trainingsbeginn an Bilder, Audio, Video und Text auf einheitliche Weise.。
Sie besitzen vollständige Fähigkeiten: Sehen, Hören, Sprechen, Schlussfolgern und Handeln. Dies ist auch die heutige Hauptrichtung in der Branche.
4. Wie funktionieren multimodale Modelle intern?
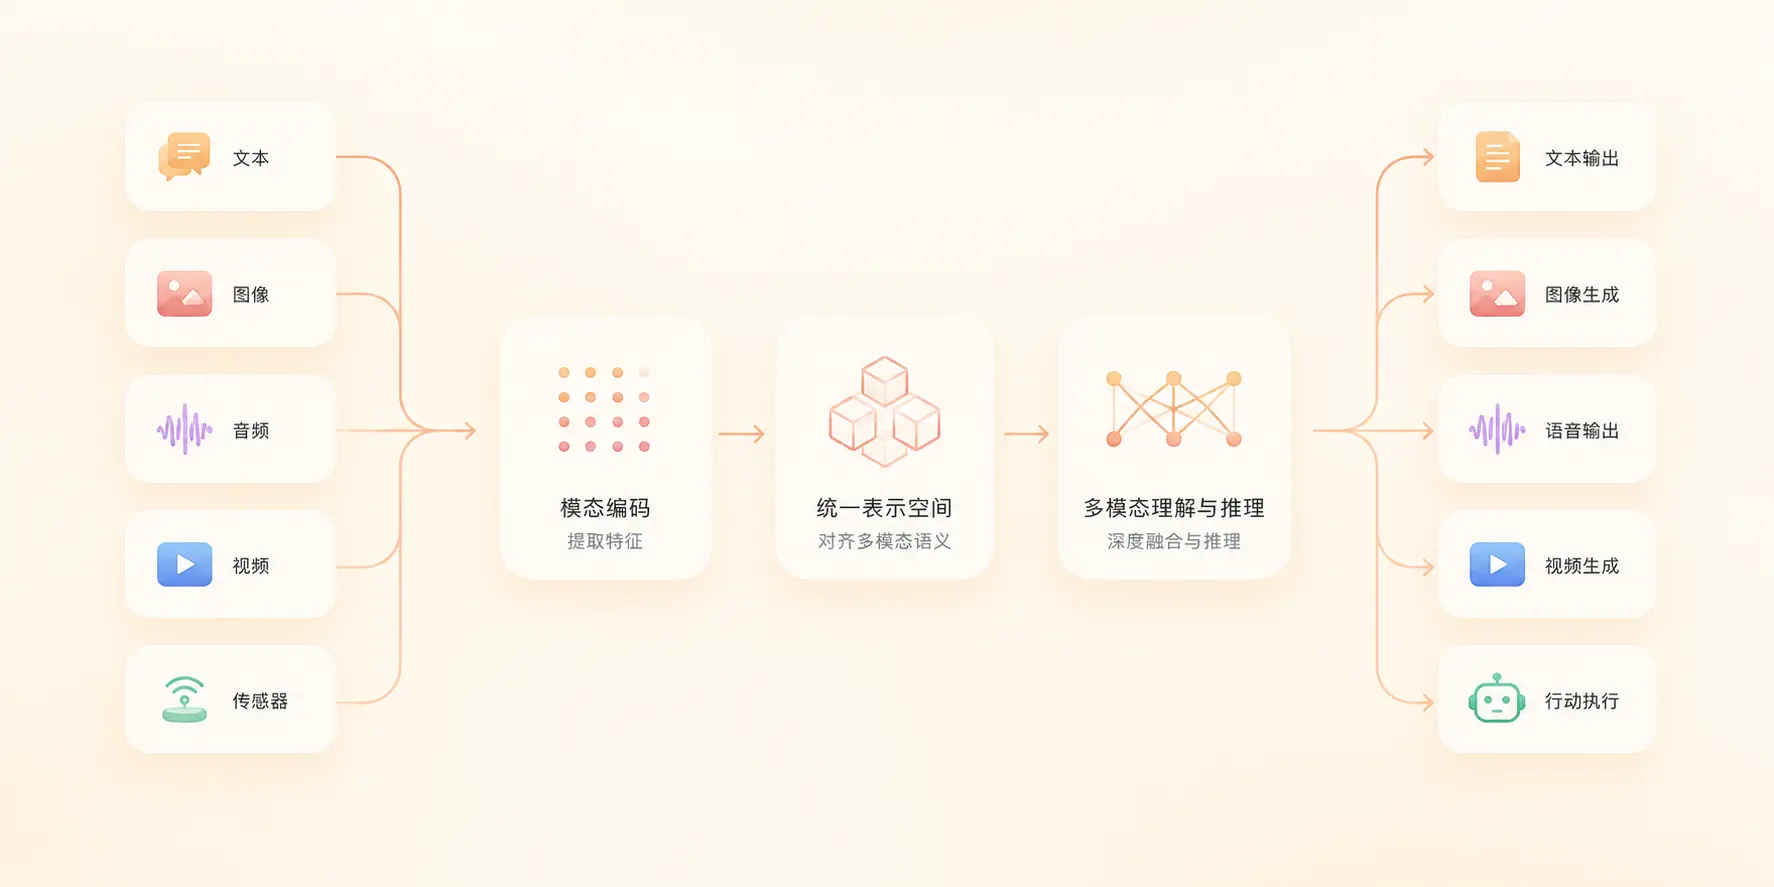
Die interne Funktionsweise multimodaler Modelle lässt sich in einem Satz zusammenfassen:Alle Daten in einen einheitlichen Vektorraum umwandeln.。
Zum Beispiel:
Die drei Ausdrücke "one只cat", "cat" und cat.png werden, obwohl sie aus unterschiedlichen Modalitäten stammen, nach der Kodierung in benachbarten Regionen des Vektorraums landen.
Der Gesamtprozess ist in der folgenden Abbildung dargestellt:
Die obige Abbildung zeigt die vollständige Pipeline von der Eingabe zur Ausgabe; im Folgenden schlüsseln wir jeden Schritt auf.
Schritt 1: Kodierung
Verschiedene Modalitäten müssen zunächst in Zahlen umgewandelt werden, bevor das Modell sie verarbeiten kann.
| Modalität | Rohdaten | Kodiert |
|---|---|---|
| Text | Hallo | [2034, 789] eine Reihe von Token-IDs |
| Image | Pixelmatrix | Visueller Merkmalsvektor |
| Audio | Wellenform | Spektraler Merkmalsvektor |
Schritt 2: Einheitlicher semantischer Raum
Der entscheidende Schritt nach der Kodierung besteht darin, "cat", "cat" und cat.png im Vektorraumnahe beieinander zu platzieren。
Dies ist die Essenz des "modalitätsübergreifenden Verständnisses": die Merkmale verschiedener Modalitäten in denselben Raum zu projizieren.
Schritt 3: Ausgabe generieren
Nach dem Schlussfolgern im einheitlichen Raum "rekonstruiert" das Modell die Ergebnisse bei Bedarf in verschiedene Modalitäten.
Die Ausgabe kann eines der folgenden sein: Text, Bild, Audio und Video.
Zum Beispiel: ein Bild hochladen → es beschreiben → dann ein Einführungsvideo generieren; dies ist eine vollständige multimodale Generierungskette.
5. Warum kann der Transformer Multimodalität vereinheitlichen?
Es gibt nur einen Kernpunkt:den Attention-Mechanismus。
Die Kernformel des Transformers ist Attention(Q, K, V), was bedeutet: "Das Modell entscheidet selbst, worauf es sich konzentriert."
Zum Beispiel: Wenn ein Benutzer fragt "Wer spielt im Bild Basketball?", wird das Modell:
- Sieh dir zuerst das Bild an und identifiziere alle Personen darauf
- Identifiziere den Basketball im Bild
- Bestimme die Beziehung zwischen "wer" und "Basketball"
- Kombiniere den Kontext und gib die Antwort aus
Diese Fähigkeit, "autonom zu entscheiden, worauf fokussiert wird", macht Transformer natürlich geeignet für die Verarbeitung multimodaler Eingaben:
| Eingabe | Worauf das Modell seinen Fokus richtet |
|---|---|
| Nur Text | Semantische Beziehungen zwischen Sätzen |
| Bild + Text | Entsprechung zwischen Bildbereichen und Textbeschreibungen |
| Video + Text | Beziehung zwischen Zeitachsensegmenten und Fragen |
Das ist auch der Grund, warum Attention zu einem "Standardmerkmal" fast aller modernen großen Modelle geworden ist — es wurde von Natur aus für modalitätsübergreifende Verarbeitung entworfen.
6. Typische Fähigkeiten multimodaler Modelle
Multimodale Modelle haben fünf typische Fähigkeiten; die folgende Abbildung zeigt die Beziehungen zwischen ihnen.
1. Bildverständnis
Gib einen Screenshot ein, und das Modell gibt Seitenprobleme, UI-Analysen oder OCR-Ergebnisse aus.
Das häufigste Szenario für Programmierer ist: den Fehler als Screenshot aufnehmen und die KI das Problem lokalisieren lassen.
2. Bildgenerierung
Gib eine Textbeschreibung wie "Generiere eine futuristische Stadt" ein, und das Modell liefert ein KI-Bild zurück.
Typische Anwendungen: Poster, Cover, Spiel-Assets, Produktskizzen.
3. Sprachinteraktion
Sprache als Eingabe, das Modell antwortet in Echtzeit, mit Fähigkeiten, die ASR (Sprache-zu-Text), TTS (Text-zu-Sprache) und Konversation abdecken.
4. Videoverständnis
Lade ein Lehrvideo hoch, und das Modell gibt eine Zusammenfassung, eine Zeitleiste und beantwortbare Schlüsselabschnitte aus.
5. Agent
Gib "Hilf mir, eine PPT zu erstellen" ein, und das Modell beginnt, eine vollständige Aktionskette auszuführen: Materialien suchen → Gliederung erstellen → Folien erstellen → überarbeiten → exportieren.
Agent ist die ultimative Form, die "sehen, hören, sprechen" mit "praktischer Ausführung" kombiniert.
7. Fünf Begriffe, die Einsteiger verstehen müssen
Beim Lesen multimodaler Dokumentation werden die folgenden Begriffe immer wieder auftauchen; präge sie dir zuerst ein:
| Begriff | Bedeutung | Beispiel |
|---|---|---|
| Token | Die kleinste vom Modell verarbeitete Einheit; Text wird nach Wörtern aufgeteilt | "Hello world" → [Hello][world] |
| Embedding | Der Prozess der Umwandlung von Informationen in numerische Koordinaten | "Cat" → [0.12, 0.78, 0.33, ...] |
| Kontext | Die Historie und Hintergrundinformationen der aktuellen Konversation | Benutzer sagt "Apple" + "Kontext: Telefon" = iPhone, nicht die Frucht |
| Attention | Bestimmt, auf welchen Teil der Eingabe das Modell seinen Fokus richtet | Wenn das Modell ein Bild betrachtet, schaut es zuerst auf "Person" und dann auf "Basketball" |
| Inferenz | Der Prozess, durch den das Modell basierend auf der Eingabe eine Ausgabe erzeugt | Nachdem der Benutzer eine Frage eingegeben hat, "denkt und antwortet" das Modell |
Diese fünf Begriffe ziehen sich durch alle Dokumentationen zu großen Modellen; baue zuerst Intuition auf und sieh dir Details bei Bedarf erneut an.
8. Praktische Erfahrung: Baue deine erste multimodale Anwendung in 5 Minuten
Ziel dieses Abschnitts: ein Bild hochladen, die KI gibt eine Textbeschreibung aus.
Der gesamte Prozess erfordert keinen Hintergrund in Deep Learning; es reicht, Python zu kennen.
8.1 Projekt vorbereiten
Erstelle zuerst ein Projekt multimodal-demo und verwende die openai-Bibliothek zum Testen:
Beispiel
mkdir multimodal-demo
# In das Projektverzeichnis wechseln
cd multimodal-demo
# Installiere das offizielle OpenAI-SDK (kompatibel mit mehreren multimodalen Modellen)
pip install openai
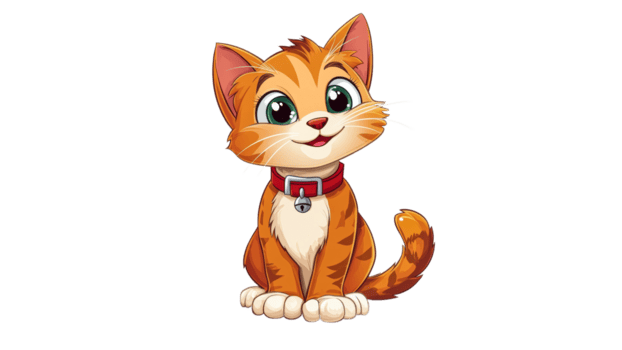
Inmultimodal-demolade im Verzeichnis ein Bild namenscat-cartoon.webphoch, das Bild sieht wie folgt aus (du kannst es mit Rechtsklick zum Testen speichern):
8.2 Aufrufcode schreiben
Dieses Beispiel verwendetArks Coding Plan, und das Modell doubao-seed-2.0-pro unterstützt multimodale Verarbeitung.
Speichere den folgenden Code als test.py:
Beispiel
import os
from io import BytesIO
from openai import OpenAI
from PIL import Image
# ==================== Ark-Konfiguration ====================
ARK_API_KEY = "ark-xxxx" # Hier deinen Key eintragen
ARK_BASE_URL = "https://ark.cn-beijing.volces.com/api/coding/v3" # Es wird empfohlen, die universelle v3-API zu verwenden
MODEL_ENDPOINT = "doubao-seed-2.0-pro" # Modell, das multimodale Verarbeitung unterstützt
# Client initialisieren
client = OpenAI(
api_key=ARK_API_KEY,
base_url=ARK_BASE_URL,
timeout=60
)
def prepare_image_base64(image_path: str, max_size: int = 1024) -> str:
"""
Lokales Bild einlesen, den Alpha-Kanal verarbeiten, es skalieren und in einen Base64-String umwandeln
"""
if not os.path.exists(image_path):
raise FileNotFoundError(f"Testbild nicht gefunden: {image_path}")
with Image.open(image_path) as img:
# 1. Den transparenten RGBA-Hintergrund verarbeiten
if img.mode == "RGBA":
background = Image.new("RGB", img.size, (255, 255, 255))
background.paste(img, mask=img.split()[-1])
img = background
elif img.mode != "RGB":
img = img.convert("RGB")
# 2. Proportional skalieren (um zu verhindern, dass große Bilder Payload/Token aufblähen)
img.thumbnail((max_size, max_size))
# 3. In Base64 konvertieren
buf = BytesIO()
img.save(buf, format="JPEG", quality=85) # Die Qualität angemessen komprimieren
b64 = base64.b64encode(buf.getvalue()).decode("utf-8")
return f"data:image/jpeg;base64,{b64}"
def multimodal_chat(img_path: str, prompt: str):
"""Multimodaler Konversationstest"""
try:
print(f"Bild wird verarbeitet: {img_path} ...")
img_b64 = prepare_image_base64(img_path)
print("Anfrage wird an die Volcano Engine Ark-Plattform gesendet...")
res = client.chat.completions.create(
model=MODEL_ENDPOINT,
messages=[
{
"role": "user",
"content": [
{"type": "text", "text": prompt},
{"type": "image_url", "image_url": {"url": img_b64}}
]
}
],
temperature=0.7,
max_tokens=1024
)
print("\n" + "="*10 + " Erkennungsergebnis " + "="*10)
print(res.choices[0].message.content)
print("="*30)
return res
except FileNotFoundError as e:
print(f"[Fehler] {e}")
except Exception as e:
print(f"[API-Anfrage fehlgeschlagen] Bitte prüfen, ob das Netzwerk oder Endpoint/Key korrekt ist. Fehlermeldung:\n{e}")
return None
if __name__ == "__main__":
# Testkonfiguration
image_file = "./cat-cartoon.webp"
question = "Beschreibe den Inhalt dieses Bildes im Detail und analysiere das Hauptmotiv, die Farben und die Szene"
# Simuliert das Erstellen eines temporären Testbilds (falls lokal kein entsprechendes Bild vorhanden ist, für schnelles visuelles Debugging)
if not os.path.exists(image_file):
print(f"{image_file} nicht erkannt, temporäres Testbild wird generiert...")
Image.new('RGB', (200, 200), color = (73, 109, 137)).save(image_file)
multimodal_chat(image_file, question)
Führen Sie Pyhton aus, die Ausgabe ist wie folgt:
在发送请求至火山引擎方舟平台...

========== 识别结果 ==========
这是一张**Q版萌系卡通风格的数字角色插画**,整体背景为纯净的纯白色,没有任何环境元素,所有视觉重心都集中在中心的小猫主体上,是典型的独立角色立绘/吉祥物设计。
---
### 一、画面主体详细描述
主体是一只端正坐姿的卡通幼橘猫,是经过萌化设计的家养橘白虎斑猫形象,整体气质乖巧天真、亲人友好:
1.  **比例与姿态**:采用萌系设计特有的大头短身比例,头部占整体高度的60%左右,
...
Öffnen Sie die Browser-Konsole, und Sie sehen die textuelle Beschreibung des Bildes durch das Modell. Die gesamte Pipeline ist:
Benutzer lädt ein Bild hoch → Browser übergibt die Bild-URL an das OpenAI SDK → Multimodales Modell versteht das Bild → Gibt eine textuelle Beschreibung zurück → Gibt sie in der Konsole aus.
8.3 Häufige Erweiterungen
Nachdem Sie den oben stehenden minimalen lauffähigen Code abgeschlossen haben, können Sie weiter erweitern:
| Was Sie tun möchten | Wie Sie es ändern |
|---|---|
| Wechseln zum Hochladen lokaler Dateien | Nachdem der Benutzer ein Bild hochgeladen hat, lesen Sie es, konvertieren Sie es in base64 und weisen Sie es dannimage_file zu |
| Fortlaufenden Multi-Turn-Dialog unterstützen | Historische Fragen und Antworten anmessages-Array anhängen |
| Zu Modellen anderer Anbieter wechseln | Geben Sie beim Erstellen des OpenAI-ClientsbaseURLan, z. B. Qwen-, OpenAI- und Anthropic-kompatible Endpunkte |
| Sprachverarbeitung. | Behalten Sietype: "image_url"bei, ändern Sie zutype: "input_audio", und stellen Sie base64-Audio bereit. |
9. Lernpfad (empfohlen)
Wenn Sie neu bei großen Sprachmodellen sind, ist das folgende Diagramm ein bewährter 6-Wochen-Lernpfad.
10. Was wird in der Zukunft passieren?
Wenn man auf die Entwicklung der Softwareformen zurückblickt, ist ein klarer Trend erkennbar:
In der Vergangenheit: Software = Funktionalität.
Heute: Software = Modell.
Zukunft: Software = multimodale intelligente Agenten.
Das bedeutet, dass Benutzer in Zukunft nur einen Satz sagen müssen, wie z. B. "eine Website erstellen", und das Modell automatisch den gesamten Prozess von Design, Programmierung, Deployment und Betrieb abschließt.
Multimodalität ist nicht so einfach wie "dem Modell eine Bildanzeigefunktion hinzuzufügen".
Was sie wirklich verändert, ist:
Computer beginnen, die reale Welt direkt zu verstehen.
Genau das ist der wichtigste Paradigmenwechsel in der aktuellen KI-Branche und auch die Richtung, in die alle Entwickler investieren sollten.
Häufig gestellte Fragen
Was ist besser: multimodale Modelle oder reguläre LLMs?
Es hängt vom Szenario ab: Für das Schreiben von reinem Text, Codegenerierung und Übersetzung ist ein reguläres LLM kosteneffizienter; wenn Sie Bilder ansehen, Audio hören oder Video verstehen müssen, ist ein multimodales Modell die einzige Wahl.
Können multimodale Modelle lokal ausgeführt werden?
Ja, aber die Kosten sind relativ hoch. VLMs mit kleinen Parametern (wie Qwen2-VL-7B) können auf Consumer-GPUs mit 16GB VRAM ausgeführt werden; größere Modelle erfordern normalerweise Cloud-GPUs oder API-Aufrufe.
Muss die Ausgabe eines multimodalen Modells Text sein?
Nicht unbedingt. Native multimodale Modelle können Text, Bilder, Audio und sogar Video ausgeben; reine VLMs geben normalerweise nur Text aus.
Wie wählt man eine multimodale API aus?
Wenn Sie nur Bildverständnis benötigen: OpenAI gpt-4o, Gemini 2.5 Flash und Qwen2-VL sind allesamt kosteneffiziente Optionen; wenn Sie "sehen + hören + Echtzeit-Sprache" benötigen, wird empfohlen, direkt die OpenAI Realtime API oder Gemini Live zu verwenden.
Weitere Erweiterungen