CrewAI erstellt intelligente Agenten.
CrewAI ist ein Open-Source-Framework für Multi-Agenten-Zusammenarbeit, das speziell dafür entwickelt wurde, mehrere KI-Agenten zu orchestrieren und zu koordinieren, damit sie zusammenarbeiten.
CrewAI kann eine komplexe Aufgabe in mehrere Rollen aufteilen, wobei jede für einen Teil verantwortlich ist, und sie durch Prozesszusammenarbeit abschließen.
Vergleichendes Verständnis:
- Einzelner Agent: Ein großes Modell, von Anfang bis Ende.
- CrewAIProduktmanager + Ingenieur + Analyst + Redakteur, jeder erledigt seine eigene Aufgabe.
CrewAI ist ein Tool zum Koordinieren, Verwalten und Strukturieren von KI-Agenten, das auf LangChain und Pydantic aufbaut, um Rollenspiel-, autonome und kollaborative Agententeams zu ermöglichen.
- Crew: Eine, die aus mehreren besteht
AgentDas Projektteam wurde gebildet. - Agent (Mitglied): : Einzelpersonen im Team, jede hat eine klare
role(Rolle),goal(Ziel) undbackstory(Hintergrundgeschichte). - Task: Die konkrete Arbeit, die vom Team erledigt werden muss. Eine
CrewEnthält mehrere geordnete oder paralleleTask, und weist sie den passendenAgent。 - Process: Definiert den Workflow des Teams, z. B. ob Aufgaben sequenziell oder gleichzeitig ausgeführt werden.
Einfach ausgedrückt bietet crewAI eine strukturierte Möglichkeit zu definieren, wer (Agent) was (Task) unter welchem Prozess (Process) tut, um letztendlich die Teamziele zu erreichen.
Das folgende Flussdiagramm zeigt deutlich, wie die Kernkomponenten im crewAI-Framework zusammenarbeiten:

Der Prozess beginnt mit der Definition von Agenten mit bestimmten Rollen und Zielen und dann mit der Erstellung spezifischer Aufgaben für sie.
Als Nächstes werden diese Agenten und ihre Aufgaben zu einer Crew organisiert, und für die Crew wird ein Kollaborationsprozess ausgewählt, z. B. sequenzielle oder parallele Ausführung. Schließlich führt die Crew alle Aufgaben gemäß dem definierten Prozess aus und liefert das Endergebnis.
Umgebungseinrichtung und Installation
Bevor wir mit dem Bauen beginnen, müssen wir die Entwicklungsumgebung vorbereiten.
Voraussetzung
Python-Versionsanforderungen:
- Muss: Python ≥ 3.10 und < 3.14
- Du kannst im Terminal eingeben
python --versionum es zu prüfen. Wenn der Versionsbereich nicht erfüllt ist, wird es später viele Probleme geben, und es wird nicht empfohlen, es auszusitzen.
CrewAI verwendetUVfür die Verwaltung von Abhängigkeiten und Paketen, mit nur einem Ziel:
Multi-Agent-Projekte stabiler zu machen und sie nicht durch Umgebungsprobleme zu Fall zu bringen.
Einführende UV-Tutorial-Referenz:UV - Python-Paket- und Umgebungsverwaltungstool。
API-Schlüssel:
crewAI selbst stellt keine KI-Modelle bereit; es muss eine Verbindung zu großen Sprachmodellen wie OpenAIs GPT, Anthropics Claude und anderen herstellen.
crewAI installieren
Öffne dein Terminal oder dein Kommandozeilen-Tool und verwende den pip-Befehl, um das crewAI-Paket zu installieren.
# 正常安装
pip install crewai
# 其他依赖
pip install langchain
pip install openai


# 如果安装慢,可以使用国内镜像安装
pip install crewai -i https://mirrors.aliyun.com/pypi/simple/
pip install langchain -i https://mirrors.aliyun.com/pypi/simple/
pip install openai -i https://mirrors.aliyun.com/pypi/simple/
Wenn du einige der integrierten erweiterten Tools von crewAI (wie die Websuche) verwenden möchtest, kannst du zusätzliche Abhängigkeiten installieren:
# 正常安装
pip install 'crewai[tools]'

# 如果安装慢,可以使用国内镜像安装
pip install 'crewai[tools]' -i https://mirrors.aliyun.com/pypi/simple/
In China können wir das große DeepSeek-Modell zum Testen verwenden. Wenn du noch keines hast, musst du zuerst zuhttps://platform.deepseek.com/api_keysgehen und einen API-Schlüssel erstellen.
DeepSeek-API-Dokumentationsreferenz:https://api-docs.deepseek.com/zh-cn/。
Erstelle nach der Installation eine neue Python-Datei, zum Beispielmy_first_crew.py, und importiere die erforderlichen Bibliotheken.
Für Modelle von Drittanbietern (einschließlich DeepSeek) muss das LLM von crewAI auf der untersten Ebene über LiteLLM laufen. Vor der Verwendung müssen wir installieren:
pip install -U litellm
Beispiel
from crewai.llm import LLM
# =====================================================
# LLM-Konfiguration (DeepSeek | LiteLLM-Standardformat)
# =====================================================
llm = LLM(
model="deepseek/deepseek-v4-flash", # Wichtig: Muss den Anbieter deepseek enthalten, dann den Modellnamen deepseek-v4-flash oder deepseek-v4-pro schreiben
api_key="sk-xxxxx", # API-Schlüssel setzen
api_base="https://api.deepseek.com/v1",
temperature=0.7,
)
# =====================================================
# Agenten
# =====================================================
researcher = Agent(
role="Technischer Forscher",
goal="Suche nach den neuesten, genauen und verifizierbaren technischen Materialien und liefere Code-Nachweise.",
backstory="Geschickt darin, technische Probleme systematisch zu analysieren, mit Schwerpunkt auf Fakten und Reproduzierbarkeit.",
llm=llm,
verbose=True,
allow_delegation=False,
)
writer = Agent(
role="Technischer Blogautor",
goal="Forschungsergebnisse zu technischen Artikeln organisieren, die für Anfänger zum Lesen geeignet sind.",
backstory="Geschickt darin, komplexe Konzepte in klare Schritte zu zerlegen und vollständige Beispiele zu liefern.",
llm=llm,
verbose=True,
allow_delegation=True,
)
# =====================================================
# Tasks
# =====================================================
research_task = Task(
description=(
"Eingehende Recherche: Python für automatisierte Datenbereinigung verwenden."\n"
"Zu den Schwerpunktthemen gehören: pandas, numpy, fehlende Werte, doppelte Werte und Probleme mit inkonsistenten Formaten."\n"
"Muss vollständige, ausführbare Codebeispiele bereitstellen."
),
agent=researcher,
expected_output=(
"Ein Forschungsbericht, der Problemklassifizierung, Lösungscode und den vollständigen Bereinigungsprozess enthält."
),
)
write_task = Task(
description=(
"Verfasse auf Basis des Forschungsberichts einen technischen Blog für Einsteiger."\n"
"Titel: \"Python-Datenbereinigung für Einsteiger: Verabschieden Sie sich mit pandas von schmutzigen Daten\"."
),
agent=writer,
context=[research_task],
expected_output="Ein Markdown-Technikblog mit nicht weniger als 800 Wörtern.",
)
# =====================================================
# Crew
# =====================================================
crew = Crew(
agents=[researcher, writer],
tasks=[research_task, write_task],
process=Process.sequential,
verbose=True,
)
# =====================================================
# Ausführen
# =====================================================
if __name__ == "__main__":
result = crew.kickoff()
output = result.raw
with open("python_data_cleaning_blog.md", "w", encoding="utf-8") as f:
f.write(output)
Als Nächstes wird die Aufgabe mit der Ausführung beginnen und relevante Informationen ausgeben:

Nach Abschluss wird der Ausgabeinhalt in die Datei python_data_cleaning_blog.md geschrieben.
Im Folgenden werden die relevanten Attribute im Code erläutert.
LLM (Modellschicht) Schlüsselattribute
| Attribute | Beispielwert | Zweck | Konsequenz eines Fehlers |
|---|---|---|---|
model |
deepseek/deepseek-v4-flash |
LiteLLM kanonische Syntax:Service Provider/Model Name |
Fehlenddeepseek/Wirft direkt einen FehlerLLM Provider NOT provided |
api_key |
sk-xxxxx |
Modellauthentifizierung | Wenn leer oder falsch, direkt 401 / LLM Failed |
api_base |
https://api.deepseek.com/v1 |
DeepSeek-API-Adresse | Hängt von der Adresse des jeweiligen Modells ab |
temperature |
0.7 |
Steuert die Zufälligkeit der Ausgabe | Zu hoch macht den Inhalt diffus; zu niedrig macht den Text starr |
Agent (Intelligenter Agent) Schlüsselattribute
| Attribute | Zweck | Wesen |
|---|---|---|
role |
"Identitätsbezeichnung" des Agenten | Wird in den System-Prompt geschrieben |
goal |
Kernziel des aktuellen Agenten | Bestimmt die Richtung der Antwort |
backstory |
Verhaltensbeschränkungen und Stil | Stabilisiert die Ausgabequalität |
llm |
Welches Modell verwendet werden soll | Muss explizit gebunden werden |
verbose |
Ausführungsprozess ausgeben | Beeinflusst nur Logs |
allow_delegation |
Ob Aufgaben-Delegierung erlaubt ist | Extrem anfällig für Fallstricke |
researcher
| Attribute | Wert | Designabsicht |
|---|---|---|
allow_delegation |
False |
Unendliche Aufgabenzerlegung verhindern |
goal |
Materialien finden + Code bereitstellen | Ausgabe ist 'Rohmaterial' |
writer (Schreiben)
| Attribute | Wert | Risiko |
|---|---|---|
allow_delegation |
True |
Kann erneut Delegierung an research auslösen |
context |
[research_task] |
Hat bereits Eingabe, eigentlich keine Notwendigkeit erneut zu delegieren |
Fazit
In einer sequentiellen Pipeline sollte der schreibende Agentdie Delegierung deaktivieren, andernfalls ist ein Fehlschlagen bei erneuter Delegierung leicht möglich.
Schlüsselattribute von Task
Gemeinsame Task-Felder:
| Attribute | Zweck | Kernpunkt |
|---|---|---|
description |
Tatsächlicher, an das LLM gesendeter Aufgabentext | Je spezifischer, desto stabiler |
agent |
Wer führt aus | Muss eindeutig sein |
expected_output |
Ergebnisbeschränkungen | Nicht erforderlich, aber dringend empfohlen |
context |
Abhängige vorgelagerte Tasks | Kern der sequenziellen Ausführung |
research_task:
| Attribute | Beschreibung |
|---|---|
agent=researcher |
Researcher binden |
Keinecontext |
Task der ersten Stufe |
| Ausgabe | Strukturierte Recherche-Inhalte |
write_task:
| Attribute | Beschreibung |
|---|---|
context=[research_task] |
Rechercheergebnisse zwingend lesen |
agent=writer |
Nur organisieren und ausdrücken |
| Ausgabe | Finaler Markdown-Text |
Crew (Actuator) Schlüsselattribute
| Attribute | Beispielwert | Zweck | Fehlerfolgen |
|---|---|---|---|
agents |
[researcher, writer] |
Alle verfügbaren Agents | Wenn einer fehlt, wird direkt ein Fehler ausgelöst. |
tasks |
[research_task, write_task] |
Ausführungswarteschlange | Reihenfolge gemäß Liste |
process |
Process.sequential |
Ausführungsstrategie | Parallele Ausführung bricht Abhängigkeiten |
verbose |
True |
Log-Schalter | Muss bool sein |
kickoff() und Ausgabestruktur
| Ausdruck | Type | Zweck |
|---|---|---|
crew.kickoff() |
CrewOutput |
Container für Ausführungsergebnisse |
result.raw |
str |
Finale Textausgabe |
result.tasks_output |
list/dict | Ausgabe jeder Task |
result.token_usage |
dict | Statistiken |
crewai-Befehl
Wir können dencrewaiBefehl verwenden, um die vollständige Projektstruktur zu generieren:
crewai create crew <项目名>
Zum Beispiel erstellen wir ein Projekt example-agent-test und führen folgenden Befehl aus:
crewai create crew example-agent-test
Als Nächstes erscheint folgender Inhalt. Sie können zuerst den Anbieter des großen Modells auswählen:
Creating folder example_agent_test...
Cache expired or not found. Fetching provider data from the web...
Downloading  [####################################]  1102019/56339
Select a provider to set up:
1. openai
2. anthropic
3. gemini
4. nvidia_nim
5. groq
6. huggingface
7. ollama
8. watson
9. bedrock
10. azure
11. cerebras
12. sambanova
13. other
q. Quit
In diesem Kapitel wählen wir DeepSeek. Geben Sie zuerst 13 ein, um other auszuwählen, dann können Sie mit der Maus scrollen, um zu sehen, dass DeepSeek bei 23 steht. Geben Sie einfach die Zahl 23 ein:
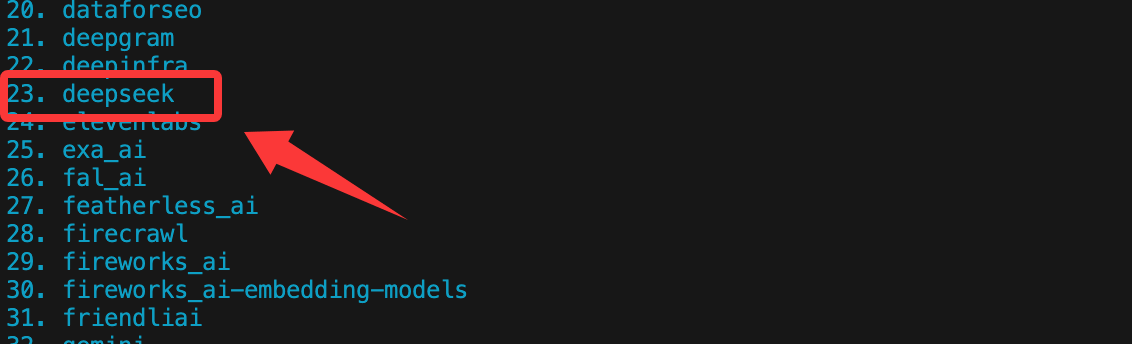
Wenn Sie API-Schlüssel für andere Modelle haben, wählen Sie einfach entsprechend der Nummer aus.
Nach Abschluss sehen Sie das generierte Verzeichnis wie folgt:
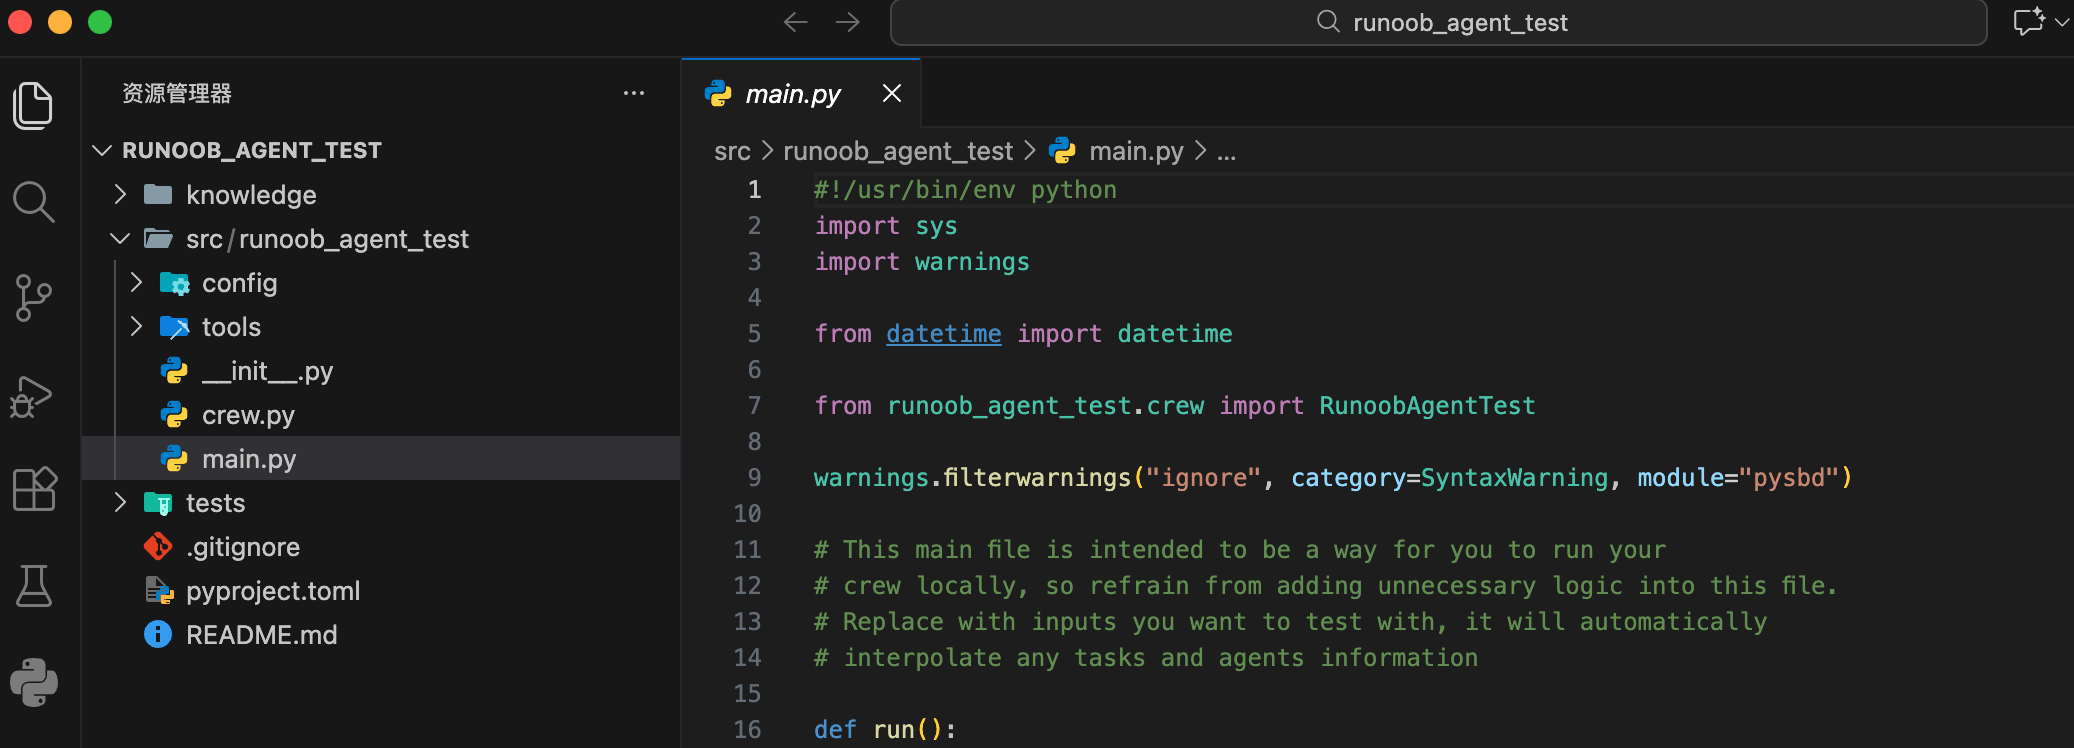
Beschreibung der Projektstruktur:
my_project/
├── .env                # 环境变量(API Key)
├── pyproject.toml      # 项目依赖声明
├── README.md
└── src/
    └── my_project/
        ├── main.py     # 程序入口
        ├── crew.py     # Crew 与 Agent 的核心逻辑
        ├── tools/      # 自定义工具
        └── config/
            ├── agents.yaml  # Agent 定义
            └── tasks.yaml   # Task 定义
Führen Sie Ihre Crew aus.
Wechseln Sie in das Projektstammverzeichnis:
cd my_project
Abhängigkeiten sperren und installieren:
crewai install
Ausführen:
crewai run
Oder direkt:
python src/my_project/main.py
API-Schlüssel konfigurieren
Aus Sicherheitsgründen wird nicht empfohlen, den API Key direkt im Code zu schreiben; wir können ihn als Umgebungsvariable setzen.
Im Code setzen (nur zum Testen):
import os
os.environ["OPENAI_API_KEY"] = "你的-openai-api-key-here"
Empfohlene Vorgehensweise: verwenden Sie.envDatei
Erstellen Sie im Projektstammverzeichnis eine Datei mit dem Namen.envDatei.
Schreiben Sie Folgendes in die Datei:OPENAI_API_KEY=你的-openai-api-key-here
Verwenden Sie im Python-Codepython-dotenvPaket zum Laden.
Installationsbefehl:
pip install python-dotenv
Laden Sie es als Nächstes im Code:
from dotenv import load_dotenv
load_dotenv() # 这会自动加载 .env 文件中的变量
# 现在 os.environ["OPENAI_API_KEY"] 就已经有了值
Kernkomponenten: Ausführliche Erklärung und Praxis
Jetzt bauen wir unser KI-Team Schritt für Schritt auf, ganz so wie ein Unternehmen. Wir werden ein Team zur Erstellung eines technischen Blogs simulieren.
Schritt 1: Den Agenten definieren
Agentist Ihr Teammitglied. Beim Erstellen müssen Sie mehrere Schlüsselattribute definieren:
| Parameter | Beschreibung | Beispiel |
|---|---|---|
| role | Die Rolle oder Position des Agenten. | Senior Technical Writer |
| goal | Das ultimative Ziel des Agenten. | Create accessible, practical technical tutorials |
| backstory | Die Hintergrundgeschichte der Rolle, die verwendet wird, um ihr Verhalten und ihren Ton zu formen. | 你是一位拥有10年全栈开发经验的开发者,热爱分享,擅长将复杂概念简单化。 |
| llm | Geben Sie das große Sprachmodell an, das vom Agenten verwendet wird. | ChatOpenAI(model="gpt-4", temperature=0.7) |
| verbose | Setzen aufTrueWenn gesetzt, gibt es den detaillierten Denkprozess des Agenten aus. |
True(sehr nützlich beim Debuggen) |
| allow_delegation | Ob diesem Agenten erlaubt werden soll, Aufgaben an andere Agenten zu delegieren. | True |
Erstellen wir zwei Agenten: einenresearcherund einenwriter。
Beispiel
llm = ChatOpenAI(model="gpt-3.5-turbo", temperature=0.7)
# Den Forscher-Agenten erstellen
researcher = Agent(
role='Technischer Forscher',
goal='Finde die neuesten, genauesten und relevantesten technischen Informationen für das zugewiesene Thema.',
backstory='Du bist ein fokussierter und gründlicher technischer Analyst, geschickt darin, Kernpunkte aus riesigen Informationsmengen herauszufiltern und die Zuverlässigkeit von Quellen zu überprüfen.',
llm=llm, # Das oben definierte Modell verwenden
verbose=True, # Detaillierte Protokolle ausgeben
allow_delegation=False # Forscher muss keine Aufgaben delegieren
)
# Autor-Agenten erstellen
writer = Agent(
role='Technischer Blog-Autor',
goal='Schreibe einen gut strukturierten, lebendigen und interessanten technischen Blogartikel mit vollständigen Codebeispielen auf Grundlage der vom Forscher bereitgestellten Materialien.',
backstory='Du bist ein sehr beliebter technischer Blogger mit freundlichem Schreibstil und strenger Logik, besonders geschickt darin, komplexe Konzepte durch Analogien und Beispiele zu erklären.',
llm=llm,
verbose=True,
allow_delegation=True # Wenn der Autor es für notwendig hält, kann er Aufgaben delegieren (zum Beispiel zurückgehen und den Forscher bitten, Materialien zu ergänzen)
)
Schritt 2: Aufgabe erstellen
Taskist ein bestimmtes Arbeitselement, das zugewiesen werden muss anAgentzu erledigen. Wichtige Attribute sind:
| Parameters | Beschreibung | Beispiel |
|---|---|---|
| description | Eine klare Beschreibung der Aufgabe. | 研究 "Python异步编程asyncio" 在 2023 年后的核心应用场景和最佳实践。 |
| agent | Verantwortlich für die Ausführung dieser AufgabeAgentObjekt. |
researcher |
| expected_output | Eine detaillierte Beschreibung der zu liefernden Ergebnisse der Aufgabe. | 一份结构化的研究报告,包含概述、3-4个核心应用场景、2-3个代码片段示例以及总结。 |
Wir erstellen eine Aufgabe für den Forscher und eine für den Autor.
example
research_task = Task(
description=(
"Führen Sie eine eingehende Recherche zum Thema 'Automatisierte Datenbereinigung mit Python' durch.\n"
"Konzentrieren Sie sich auf die neueste Verwendung der Bibliotheken pandas und numpy (nach 2023), häufige Probleme mit schmutzigen Daten (wie fehlende Werte, doppelte Werte, inkonsistente Formate) und effiziente Bereinigungs-Workflows.\n"
"Bitte geben Sie spezifische Codeausschnitte an, um jeden Schritt zu veranschaulichen."
),
agent=researcher, # Diese Aufgabe dem Forscher zuweisen
expected_output=(
"Ein vollständiger Forschungsbericht im folgenden Format:\n"
"1. Themenüberblick\n"
"2. Klassifizierung häufiger Datenprobleme (mindestens 3 Kategorien)\n"
"3. pandas/numpy-Lösungen für jede Art von Problem (mit Codeausschnitten)\n"
"4. Ein vollständiges End-to-End-Beispiel für einen Bereinigungs-Workflow\n"
"5. Zusammenfassung und Empfehlungen"
)
)
# Schreibaufgabe erstellen
write_task = Task(
description=(
"Verwenden Sie den vom Forscher bereitgestellten Forschungsbericht und schreiben Sie einen technischen Blogartikel für Anfänger.\n"
"Der Artikeltitel lautet: 'Python-Datenbereinigung für Anfänger: Verabschieden Sie sich mit pandas von schmutzigen Daten'.\n"
"Anforderungen an den Artikel: leicht verständliche Sprache, progressive Logik, alle vom Researcher bereitgestellten wichtigen Code-Schnipsel einfügen und detaillierte Kommentare hinzufügen.\n"
"Stelle abschließend ein vollständiges, ausführbares Beispiel bereit, das den gesamten Prozess der Bereinigung eines simulierten Datensatzes demonstriert."
),
agent=writer, # Diese Aufgabe dem Writer zuweisen
expected_output=(
"Ein Blogartikel im Markdown-Format mit nicht weniger als 800 Wörtern."\n"
"Enthalte eine Einleitung, einen Hauptteil (mit Unterabschnitten), Codeblöcke und eine Zusammenfassung."\n"
"Ein vollständiges Python-Skript mit simulierten Daten und Bereinigungscode muss am Ende des Artikels angehängt werden."
),
# Der context-Parameter ist sehr wichtig! Er legt die Abhängigkeiten dieser Aufgabe fest, d. h. research_task muss zuerst abgeschlossen werden.
context=[research_task]
)
Hinweis write_taskin dercontext=[research_task], der Abhängigkeiten zwischen Aufgaben festlegt, was bedeutet, dass der Writer warten muss, bis der Researcher die Aufgabe abgeschlossen hat, bevor er mit der Arbeit beginnt.
Schritt 3: Das Team aufbauen und Prozesse einrichten (Crew & Process)
Jetzt setze denAgentundTaskzusammen inCrew, und definiere ihre ArbeitProcess。
Beispiel
blog_crew = Crew(
agents=[researcher, writer], # Welche Mitglieder bilden das Team
tasks=[research_task, write_task], # Welche Aufgaben hat das Team
process=Process.sequential, # Prozesstyp: sequenzielle Ausführung. Der Researcher beendet zuerst, dann arbeitet der Writer.
verbose=2 # Ausführlichkeit der Logs während der Team-Ausführung festlegen (0=leise, 1=grundlegend, 2=ausführlich)
)
crewAI unterstützt hauptsächlich zwei Prozesse:
Process.sequential: Aufgaben werden in der Reihenfolge der Liste ausgeführt. Geeignet für Pipeline-Operationen mit strengen Abhängigkeiten.Process.hierarchical: Kombiniert mit einem Manager-Agent, der Aufgaben koordiniert und zuweist. Geeignet für komplexere, dynamische Kollaborationsszenarien.
Schritt 4: Die Aufgabe ausführen und Ergebnisse erhalten.
Alles ist bereit, starte dein KI-Team!
Beispiel
result = blog_crew.kickoff()
# Das Endergebnis ausgeben
print("###################### Endergebnisse ######################")
print(result)
Führe dein Python-Skript aus (python my_first_crew.py). Da wirverbose=Trueundverbose=2, siehst du im Terminal den Denkprozess jedes Agenten und die Aufgabenausführungsprotokolle und schließlich den generierten Blogartikel.
Fortgeschrittene Techniken: Agents mit Tools ausstatten
crewAI ermöglicht esAgentexterne Tools aufzurufenTool, wie z. B. das Durchsuchen des Webs, das Abfragen von Datenbanken, das Durchführen von Berechnungen usw.
Das folgende Beispiel stattet den Researcher mitWebsucheundBerechnungs-Tools aus:
Beispiel
# Tools initialisieren
# Hinweis: SerperDevTool erfordert einen separaten API-Schlüssel. Bitte registriere dich unter https://serper.dev/, um ihn zu erhalten.
search_tool = SerperDevTool(serper_api_key="your-serper-api-key")
calc_tool = CalculatorTool()
# Einen mit Tools ausgestatteten Researcher erstellen
advanced_researcher = Agent(
role='Leitender technischer Researcher',
goal='Suche nach den neuesten Technologietrends und führe eine quantitative Analyse durch',
backstory='Du bist nicht nur gut darin, Informationen zu finden, sondern kannst auch einfache Berechnungen und Vergleiche mit Daten durchführen.',
tools=[search_tool, calc_tool], # Die Tool-Liste dem Agenten zuweisen
llm=llm,
verbose=True
)
Erstelle eine Aufgabe unter Verwendung von Tools.
analysis_task = Task(
description=(
Suche und vergleiche die Star-Wachstumszahlen von 'FastAPI' und 'Django' auf GitHub im letzten Jahr.\n"
Berechne die Wachstumsraten beider und analysiere mögliche Gründe.
),
agent=advanced_researcher,
expected_output=Ein kurzer Bericht mit konkreten Daten, Berechnungsprozess und Ursachenanalyse.
)