Мультимодальность больших моделей
Мультимодальные большие модели позволяют ИИ одновременно обрабатывать несколько форм информации, таких как текст, изображения, аудио и видео, и являются одним из наиболее важных направлений развития больших моделей сегодня.
Эта статья с нуля объясняет понятие, процесс развития, внутренние принципы и типичные возможности мультимодальности, а в конце приводитСоздайте свое первое мультимодальное приложение за 5 минутрабочий пример.
1. Что такое мультимодальность?
Обычные большие модели обычно могут обрабатывать только один тип информации —текстЕсли вы дадите традиционному ИИ изображение и спросите его: «Сколько кошек на изображении?», модель не сможет этого сделать без поддержки мультимодальности.
Но реальный мир состоит не из текста, а из множества типов сенсорной информации:
| Орган чувств | Соответствующая информация |
|---|---|
| Глаза | Image |
| Ухо | Звук |
| Рот | Язык |
| рука | Действие |
| Видео | Изображение + Время |
| Веб-страница | Текст + Изображение + Структура |
Поэтому,мультимодальностькак понятие и возникла.
Чтобы понять это в одном предложении:
Мультимодальность = одна модель, которая одновременно понимает и генерирует несколько форм информации.
Рассмотрим два типичных примера:
1. На вход подаётся изображение и вопрос:«В этой еде на картинке много калорий?»Модель отвечает:«Это жареная курица и картофель фри, по оценке — около 1,200 калорий.»
-
2. На вход подаётся голос:«Помоги мне суммировать эту встречу»Модель выводит текстовое резюме с предложениями по действиям.
Эта способность описывать изображения и суммировать аудио — самое прямое проявление мультимодальности.
2. Что такое модальность?
Модальность — этоформа представления информации.。
Разные модальности соответствуют разным входам и выходам. В таблице ниже перечислены распространённые модальности и их типичные применения:
| Модальность | Пример ввода | Пример вывода | Типичное применение |
|---|---|---|---|
| Текст | Романы, логи чатов | Ответы, статьи | Вопросы и ответы, написание текстов, перевод |
| Image | Фотографии, скриншоты | Понимание изображений, генерация изображений | OCR, визуальные вопросы и ответы |
| Аудио | Речь, музыка | Транскрибирование текста, синтез речи | Резюме встреч, голосовые помощники |
| Видео | Видеопоток | Анализ видео, временная шкала | Учебные конспекты, извлечение контента |
| Датчик | GPS, температура | Управляющий сигнал | Робототехника, автономное вождение |
| Действие | Щелчки мыши, ввод с клавиатуры | Выполнять действия | GUI-агент, автоматизация |
Чем больше модальностей поддерживает модель, тем ближе ее возможности к человеческим, поэтому все ведущие лаборатории переводят текстовые модели в мультимодальные.
3. Процесс разработки мультимодальных больших моделей
От обработки только текста до способности видеть, слышать и выводить видео — мультимодальные большие модели прошли через три чётких этапа.
Этап 1: Языковые модели (LLM)
На этом этапе модели принимают текст и как входные данные, и как выходные. Типичные представители — серия GPT от OpenAI, Claude от Anthropic и Gemini от Google.
Они умеют писать код, писать статьи, переводить и отвечать на вопросы. Они обладают большими возможностями, но имеют фундаментальное ограничение:Они не могут видеть.。
Этап 2: Визуально-языковые модели (VLM)
VLM добавляет к LLM возможность «видеть изображения». Типичный сценарий использования — загрузить скриншот веб-страницы и спросить: «почему вёрстка неправильная?». Модель отвечает: «конфликт CSS».
Модели на этом этапе начинают обладать такими возможностями, как понимание изображений, OCR и понимание графиков.
Этап 3: Нативные мультимодальные модели
Нативные мультимодальные модели больше не рассматривают «изображение» и «текст» как два объединённых модуля. Вместо этого с самого начала обучения ониобрабатывают изображения, аудио, видео и текст единым образом.。
Они обладают полным набором возможностей: видеть, слышать, говорить, рассуждать и действовать. Это также основное направление в индустрии сегодня.
4. Как мультимодальные модели работают изнутри?
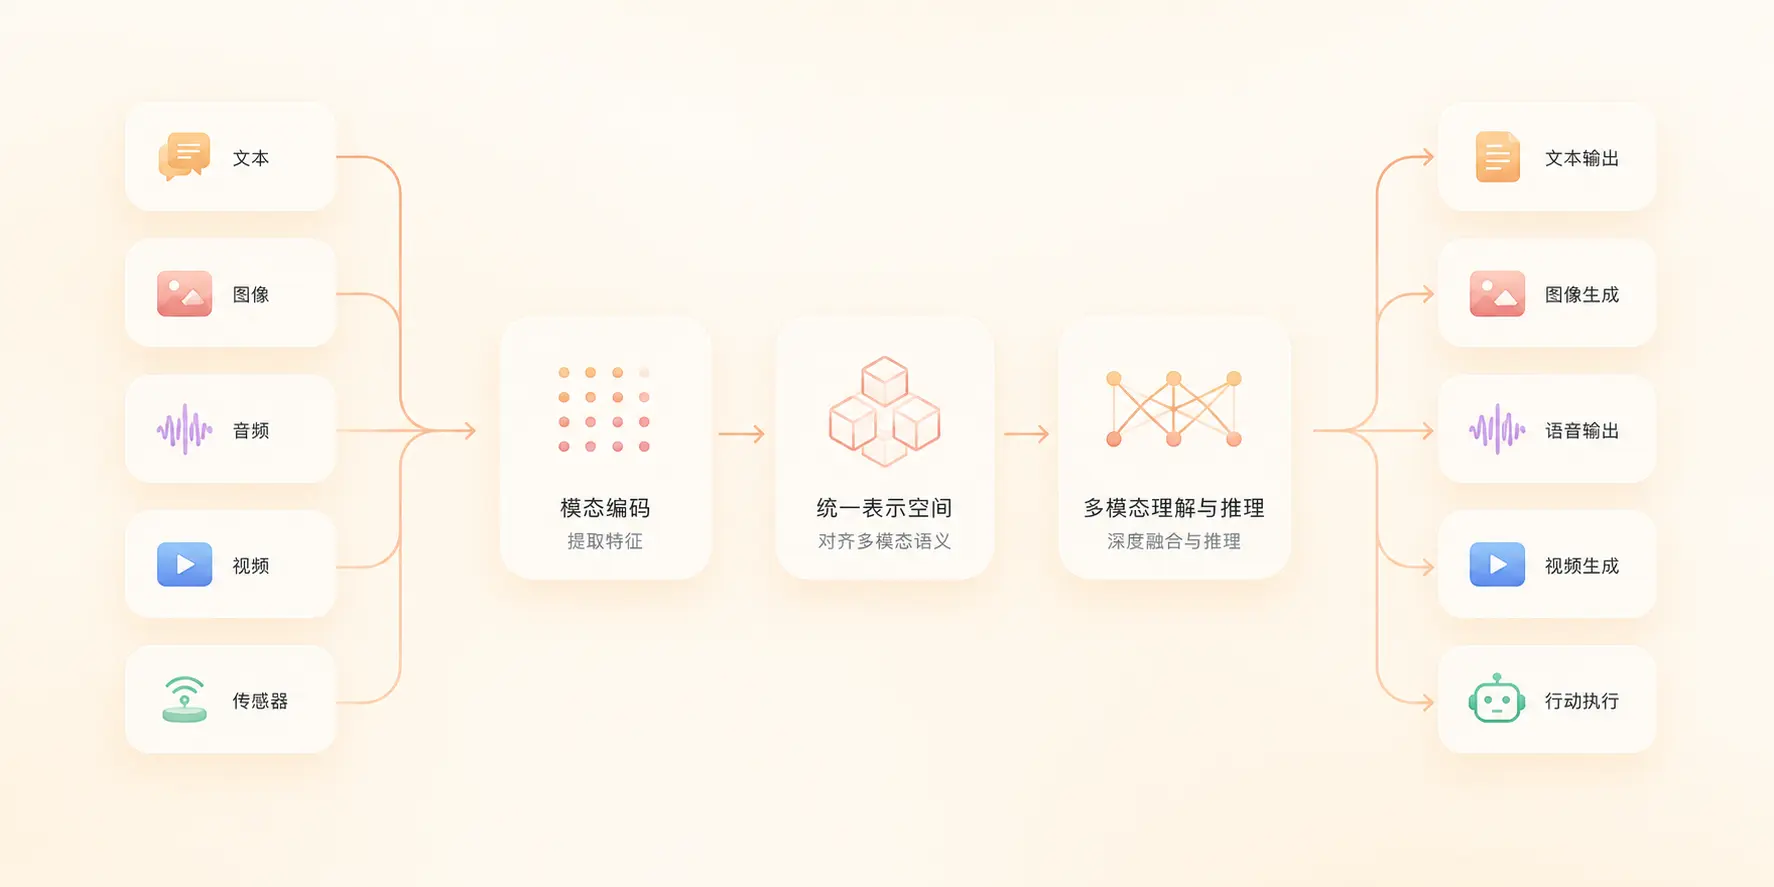
Внутреннюю работу мультимодальных моделей можно резюмировать одной фразой:преобразовать все данные в единое векторное пространство.。
Например:
Три выражения "one只cat", "cat" и cat.png, хотя и относятся к разным модальностям, после кодирования окажутся в близких областях векторного пространства.
Общий процесс показан на рисунке ниже:
На рисунке выше показан полный пайплайн от входа до выхода; давайте разберём каждый шаг ниже.
Шаг 1: Кодирование
Разные модальности сначала должны быть преобразованы в числа, прежде чем модель сможет их обработать.
| Модальность | Необработанные данные | Закодировано |
|---|---|---|
| Текст | Привет | [2034, 789] набор идентификаторов токенов |
| Image | Матрица пикселей | Вектор визуальных признаков |
| Аудио | Форма волны | Спектральный вектор признаков |
Шаг 2: Единое семантическое пространство
Ключевой шаг после кодирования — сделать "cat", "cat" и cat.png в векторном пространствеблизкими друг к другу。
В этом суть "кросс-модального понимания": проецирование признаков разных модальностей в одно и то же пространство.
Шаг 3: Генерация вывода
После рассуждения в едином пространстве модель по запросу "восстанавливает" результаты в разные модальности.
Выводом может быть любой из следующих: текст, изображение, аудио и видео.
Например: загрузите изображение → опишите его → затем сгенерируйте вступительное видео; это полная цепочка мультимодальной генерации.
5. Почему Transformer способен унифицировать мультимодальность?
Есть только одна основная причина:механизм внимания。
Основная формула Transformer — Attention(Q, K, V), что означает "модель сама решает, на что обращать внимание".
Например: когда пользователь спрашивает «Кто играет в баскетбол на изображении?», модель будет:
- Сначала посмотреть на изображение и определить всех людей на нём
- Определить баскетбольный мяч на изображении
- Определить связь между «кто» и «баскетболом»
- Объединить контекст и вывести ответ
Эта способность «автономно решать, на чём сосредоточиться» делает Transformer естественно подходящим для обработки мультимодального ввода:
| Ввод | На чём сосредоточена модель |
|---|---|
| Только текст | Семантические связи между предложениями |
| Изображение + текст | Соответствие между областями изображения и текстовыми описаниями |
| Видео + текст | Связь между сегментами временной шкалы и вопросами |
Именно поэтому Attention стал «стандартной функцией» почти всех современных больших моделей — он изначально был разработан для кросс-модальности.
6. Типичные возможности мультимодальных моделей
Мультимодальные модели обладают пятью типичными возможностями; на рисунке ниже показаны связи между ними.
1. Понимание изображений
Загрузите скриншот, и модель выдаст проблемы страницы, анализ UI или результаты OCR.
Самый распространённый сценарий для программистов: сделать скриншот ошибки и позволить ИИ найти проблему.
2. Генерация изображений
Введите текстовое описание, например «Сгенерируй футуристический город», и модель вернёт ИИ-изображение.
Типичные применения: постеры, обложки, игровые ресурсы, эскизы продуктов.
3. Речевое взаимодействие
Речь в качестве входных данных, модель отвечает в реальном времени, а возможности охватывают ASR (преобразование речи в текст), TTS (преобразование текста в речь) и разговор.
4. Понимание видео
Загрузите обучающее видео, и модель выводит краткое содержание, временную шкалу и ключевые сегменты для ответов на вопросы.
5. Агент
Введите "Помоги мне сделать PPT", и модель начинает выполнять полную цепочку действий: поиск материалов → генерация структуры → создание слайдов → редактирование → экспорт.
Агент — это высшая форма, объединяющая "видеть, слышать, говорить" с "практическим исполнением".
7. Пять терминов, которые должны понимать новички
При чтении документации, связанной с мультимодальностью, следующие термины будут встречаться часто; сначала запомните их:
| Термин | Значение | Пример |
|---|---|---|
| Токен | Наименьшая единица, обрабатываемая моделью; текст разбивается на слова | "Hello world" → [Hello][world] |
| Эмбеддинг | Процесс преобразования информации в числовые координаты | "Cat" → [0.12, 0.78, 0.33, ...] |
| Контекст | История и фоновая информация текущего разговора | Пользователь говорит "Apple" + "Контекст: телефон" = iPhone, а не фрукт |
| Внимание | Определяет, на какую часть входных данных фокусируется модель | При просмотре изображения модель сначала смотрит на "person", затем на "basketball" |
| Инференс | Процесс, посредством которого модель генерирует выходные данные на основе входных | После того как пользователь вводит вопрос, модель "думает и отвечает" |
Эти пять терминов встречаются во всей документации по большим моделям; сначала сформируйте интуитивное понимание, а затем при необходимости возвращайтесь к деталям.
8. Практический опыт: создайте своё первое мультимодальное приложение за 5 минут
Цель этого раздела: загрузить изображение, ИИ выводит текстовое описание.
Весь процесс не требует опыта в глубоком обучении; достаточно знать Python.
8.1 Подготовьте проект
Сначала создайте проект multimodal-demo и используйте библиотеку openai для тестирования:
Пример
mkdir multimodal-demo
# Перейти в каталог проекта
cd multimodal-demo
# Установить официальный SDK OpenAI (совместим с несколькими мультимодальными моделями)
pip install openai
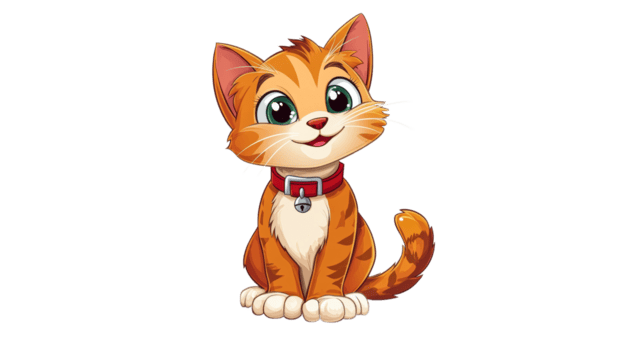
В каталогеmultimodal-demoзагрузите изображениеcat-cartoon.webp, изображение выглядит следующим образом (можно щёлкнуть правой кнопкой мыши, чтобы сохранить его для тестирования):
8.2 Напишите код вызова
В этом примере используетсяArk's Coding Plan, а их модель doubao-seed-2.0-pro поддерживает мультимодальную обработку.
Сохраните следующий код как test.py:
Пример
import os
from io import BytesIO
from openai import OpenAI
from PIL import Image
# ==================== Конфигурация Ark ====================
ARK_API_KEY = "ark-xxxx" # Введите ваш ключ здесь
ARK_BASE_URL = "https://ark.cn-beijing.volces.com/api/coding/v3" # Рекомендуется использовать универсальный API v3
MODEL_ENDPOINT = "doubao-seed-2.0-pro" # Модель, поддерживающая мультимодальность
# Инициализация клиента
client = OpenAI(
api_key=ARK_API_KEY,
base_url=ARK_BASE_URL,
timeout=60
)
def prepare_image_base64(image_path: str, max_size: int = 1024) -> str:
"""
Прочитать локальное изображение, обработать альфа-канал, изменить его размер и преобразовать в строку base64
"""
if not os.path.exists(image_path):
raise FileNotFoundError(f"Тестовое изображение не найдено: {image_path}")
with Image.open(image_path) as img:
# 1. Обработать прозрачный фон RGBA
if img.mode == "RGBA":
background = Image.new("RGB", img.size, (255, 255, 255))
background.paste(img, mask=img.split()[-1])
img = background
elif img.mode != "RGB":
img = img.convert("RGB")
# 2. Масштабировать пропорционально (чтобы большие изображения не раздували Payload/Token)
img.thumbnail((max_size, max_size))
# 3. Преобразовать в Base64
buf = BytesIO()
img.save(buf, format="JPEG", quality=85) # Сжать качество соответствующим образом
b64 = base64.b64encode(buf.getvalue()).decode("utf-8")
return f"data:image/jpeg;base64,{b64}"
def multimodal_chat(img_path: str, prompt: str):
"""Тест мультимодального диалога"""
try:
print(f"Обработка изображения: {img_path} ...")
img_b64 = prepare_image_base64(img_path)
print("Отправка запроса на платформу Volcano Engine Ark...")
res = client.chat.completions.create(
model=MODEL_ENDPOINT,
messages=[
{
"role": "user",
"content": [
{"type": "text", "text": prompt},
{"type": "image_url", "image_url": {"url": img_b64}}
]
}
],
temperature=0.7,
max_tokens=1024
)
print("\n" + "="*10 + " Результат распознавания " + "="*10)
print(res.choices[0].message.content)
print("="*30)
return res
except FileNotFoundError as e:
print(f"[Ошибка] {e}")
except Exception as e:
print(f"[Ошибка API-запроса] Проверьте, правильно ли указаны сеть или Endpoint/Key. Сообщение об ошибке:\n{e}")
return None
if __name__ == "__main__":
# Тестовая конфигурация
image_file = "./cat-cartoon.webp"
question = "Опишите содержимое этого изображения подробно, проанализировав основной объект, цвета и сцену"
# Имитация создания временного тестового изображения (если соответствующего изображения нет локально, для быстрой визуальной отладки)
if not os.path.exists(image_file):
print(f"{image_file} не обнаружен, создаётся временное тестовое изображение...")
Image.new('RGB', (200, 200), color = (73, 109, 137)).save(image_file)
multimodal_chat(image_file, question)
Запустите Pyhton, вывод будет следующим:
在发送请求至火山引擎方舟平台...

========== 识别结果 ==========
这是一张**Q版萌系卡通风格的数字角色插画**,整体背景为纯净的纯白色,没有任何环境元素,所有视觉重心都集中在中心的小猫主体上,是典型的独立角色立绘/吉祥物设计。
---
### 一、画面主体详细描述
主体是一只端正坐姿的卡通幼橘猫,是经过萌化设计的家养橘白虎斑猫形象,整体气质乖巧天真、亲人友好:
1.  **比例与姿态**:采用萌系设计特有的大头短身比例,头部占整体高度的60%左右,
...
Откройте консоль браузера, и вы увидите текстовое описание изображения от модели. Весь конвейер выглядит так:
Пользователь загружает изображение → Браузер передаёт URL изображения в OpenAI SDK → Мультимодальная модель понимает изображение → Возвращает текстовое описание → Выводит в консоль.
8.3 Распространённые расширения
После выполнения минимального рабочего кода выше вы можете продолжить расширение:
| Что вы хотите сделать | Как изменить |
|---|---|
| Перейти к загрузке локальных файлов | После того как пользователь загрузит изображение, прочитайте его, преобразуйте в base64, а затем присвойте егоimage_file |
| Поддержка непрерывного многоходового диалога | Добавьте исторические вопросы и ответы вmessagesмассив |
| Переключиться на модели других вендоров | Укажите при создании клиента OpenAI.baseURL, например эндпоинты, совместимые с Qwen, OpenAI, Anthropic |
| Обработка речи. | оставьтеtype: "image_url"Измените наtype: "input_audio", и предоставьте аудио в base64. |
9. Путь обучения (рекомендуется)
Если вы новичок в больших языковых моделях, приведённая ниже схема — это проверенный 6-недельный путь обучения.
10. Что произойдёт в будущем?
Оглядываясь на эволюцию форм программного обеспечения, можно увидеть чёткую тенденцию:
В прошлом: ПО = функциональность.
Сейчас: ПО = модель.
Будущее: ПО = мультимодальные интеллектуальные агенты.
Это означает, что в будущем пользователям достаточно будет сказать одну фразу, например «сделай сайт», и модель автоматически выполнит весь процесс проектирования, написания кода, развёртывания и эксплуатации.
Мультимодальность не так проста, как «добавление в модель функции просмотра изображений».
Что она на самом деле меняет:
Пусть компьютеры начнут напрямую понимать реальный мир.
Это именно важнейший сдвиг парадигмы в текущей индустрии ИИ, а также направление, в которое следует вкладываться всем разработчикам.
Часто задаваемые вопросы
Что лучше: мультимодальные модели или обычные LLM?
Зависит от сценария: для написания простого текста, генерации кода и перевода обычная LLM более экономически эффективна; когда нужно просматривать изображения, слушать аудио или понимать видео, мультимодальная модель — единственный выбор.
Могут ли мультимодальные модели работать локально?
Да, но стоимость относительно высока. Малопараметрические VLM (например, Qwen2-VL-7B) могут работать на потребительских GPU с 16GB VRAM; более крупные модели обычно требуют облачных GPU или вызовов API.
Должен ли вывод мультимодальной модели быть текстом?
Не обязательно. Нативные мультимодальные модели могут выводить текст, изображения, аудио и даже видео; чистые VLM обычно выводят только текст.
Как выбрать мультимодальный API?
Если вам нужно только понимание изображений: OpenAI gpt-4o, Gemini 2.5 Flash и Qwen2-VL — все это экономически эффективные варианты; если вам нужно «видеть + слышать + голос в реальном времени», рекомендуется напрямую использовать OpenAI Realtime API или Gemini Live.
Другие расширения