Grundlagen großer Sprachmodelle (LLM)
Ein Large Language Model (LLM) ist das Gehirn eines KI-Agenten; es zu verstehen, ist die Grundlage für den Aufbau intelligenter Agenten.
Der Grund, warum ein großes Sprachmodell mit Ihnen sprechen, Artikel schreiben und programmieren kann, ist im Wesentlichen, dass es auf Grundlage des von Ihnen bereitgestellten Textes (Prompt) Wort für Worterrätund die vernünftigste Fortsetzung erzeugt.
Einfach ausgedrückt ist ein großes Sprachmodell ein Deep-Learning-Modell, das mit massiven Textdaten trainiert wurde und menschliche Sprache verstehen und erzeugen kann. Durch die Analyse massiver Textmengen im Internet lernt das Modell die statistischen Muster der Sprache, und wenn es eine Eingabe erhält, erzeugt es gemäß den erlernten Mustern die vernünftigste Fortsetzung.

Wir können uns ein großes Sprachmodell als einenäußerst fleißigen Schüler mit einem außergewöhnlichen Gedächtnis vorstellen:
Lernphase (Training): Es hat fast alle öffentlich verfügbaren Texte im Internet gelesen – Bücher, Artikel, Webseiten, Code usw. (die Datenmenge kann Billionen von Wörtern erreichen). Dabei memoriert es nicht, sondern lernt ein äußerst komplexes Regelwerk der Sprache.
Anwendungsphase (Inferenz): Wenn Sie ihm eine Frage stellen oder ihm eine Anweisung geben, wendet es die erlernten Regeln an, um Wort für Wort die logischste und kontextuell passendste Antwort zu erzeugen.
Seine „Größe“ zeigt sich hauptsächlich in zwei Aspekten:
- Große Parameteranzahl: Das Modell enthält intern zig Milliarden oder sogar Billionen anpassbarer Parameter, die das erlernte Sprachwissen speichern.
- Große Trainingsdatenmenge: Die Menge der für das Training verwendeten Textdaten ist enorm und deckt die Essenz der öffentlich verfügbaren Internetinformationen ab.
Die folgende Abbildung zeigt den Prozess, wie ein LLM Text Wort für Wort generiert – es sagt jeweils ein Wort voraus, fügt dieses neue Wort dann in die Eingabe ein, sagt weiter das nächste Wort voraus und wiederholt diesen Zyklus, bis eine vollständige Antwort erzeugt ist:

Animationsdemo:
Jeder Schritt tut nur eine Sache: basierend auf dem vorangehenden Text das nächste Wort vorhersagen.
Obwohl LLMs leistungsfähig sind, haben sie auch klare Grenzen:
| Fähigkeit | Beschreibung | Einschränkung |
|---|---|---|
| Wissensstichtag | Trainingsdaten haben einen Stichtag | Kann neue Informationen nach dem Training nicht kennen |
| Mathematische Berechnungen | Kann einfache Berechnungen durchführen | Komplexe Berechnungen sind fehleranfällig |
| Echtzeitinformationen | Erfordert externe Tools zur Unterstützung | Kann nicht selbst auf Echtzeitdaten zugreifen |
| Faktische Genauigkeit | Kann falsche Informationen erzeugen | Erfordert Faktenprüfung |
| Verarbeitung langer Texte | Die Kontextlänge ist begrenzt | Bei extrem langen Texten können Informationen verloren gehen |
| Logische Konsistenz | Kann widersprüchlich sein | Erfordert sorgfältiges Design und Validierung |
Wichtiger Hinweis:LLMs sind nicht allwissend; sie sind im Wesentlichen statistische Mustervergleichssysteme. Nur wenn wir ihre Grenzen verstehen, können wir ihre Fähigkeiten besser nutzen.
Zentrales Funktionsprinzip: Eine kurze Analyse der Transformer-Architektur
Die bemerkenswerten Fähigkeiten von LLMs sind untrennbar mit ihrer zugrunde liegenden Kerntechnologie verbunden –Transformer-ArchitekturEs ist nicht nötig, tief in komplexe mathematische Prinzipien einzutauchen, aber Sie können ihre Kernideen verstehen.
Stell dir vor, du möchtest einen Artikel über das Sonnensystem schreiben:
- Materialien durchsehenZuerst würdest du viele relevante Bücher und Webseiten ansehen.
- Kernpunkte identifizierenDu würdest feststellen, dass Wörter wie Sonne, Planeten, Umlaufbahnen und Schwerkraft häufig vorkommen und miteinander zusammenhängen.
- Sprache organisierenBasierend auf dem Punkt, den du machen möchtest (z. B. die Einführung von Mars), würdest du gezielt zuvor gesehene Informationen über Mars' Größe, Farbe, Position usw. verwenden und sie zu kohärenten Sätzen ordnen.
Die Funktionsweise des Transformers ist ähnlich; sein Kernprozess ist in drei Phasen unterteilt:
- EingabeverarbeitungDeine Wörter werden in Tokens (Wörter oder Zeichen) zerlegt und in Zahlen (Vektoren) umgewandelt, die Computer verstehen können.
- Kontextverständnis (Kern):Self-Attention-Mechanismusbeginnt zu arbeiten. Er ermöglicht es dem Modell, bei der Verarbeitung jedes Wortes in einem Satz die Wichtigkeit vonallen anderen Wörternim Satz abzuwägen. Dieser Prozess istparallelund extrem schnell.
- Generierung und Iteration: Das Modell berechnet eine Wahrscheinlichkeitsverteilung basierend auf seinem Verständnis aller Wörter und sagt das wahrscheinlichste nächste Wort voraus. Nachdem es dieses Wort ausgewählt und ausgegeben hat, verwendet es dieses als neue Eingabe und wiederholt den gesamten Prozess, bis eine vollständige Antwort generiert wurde.
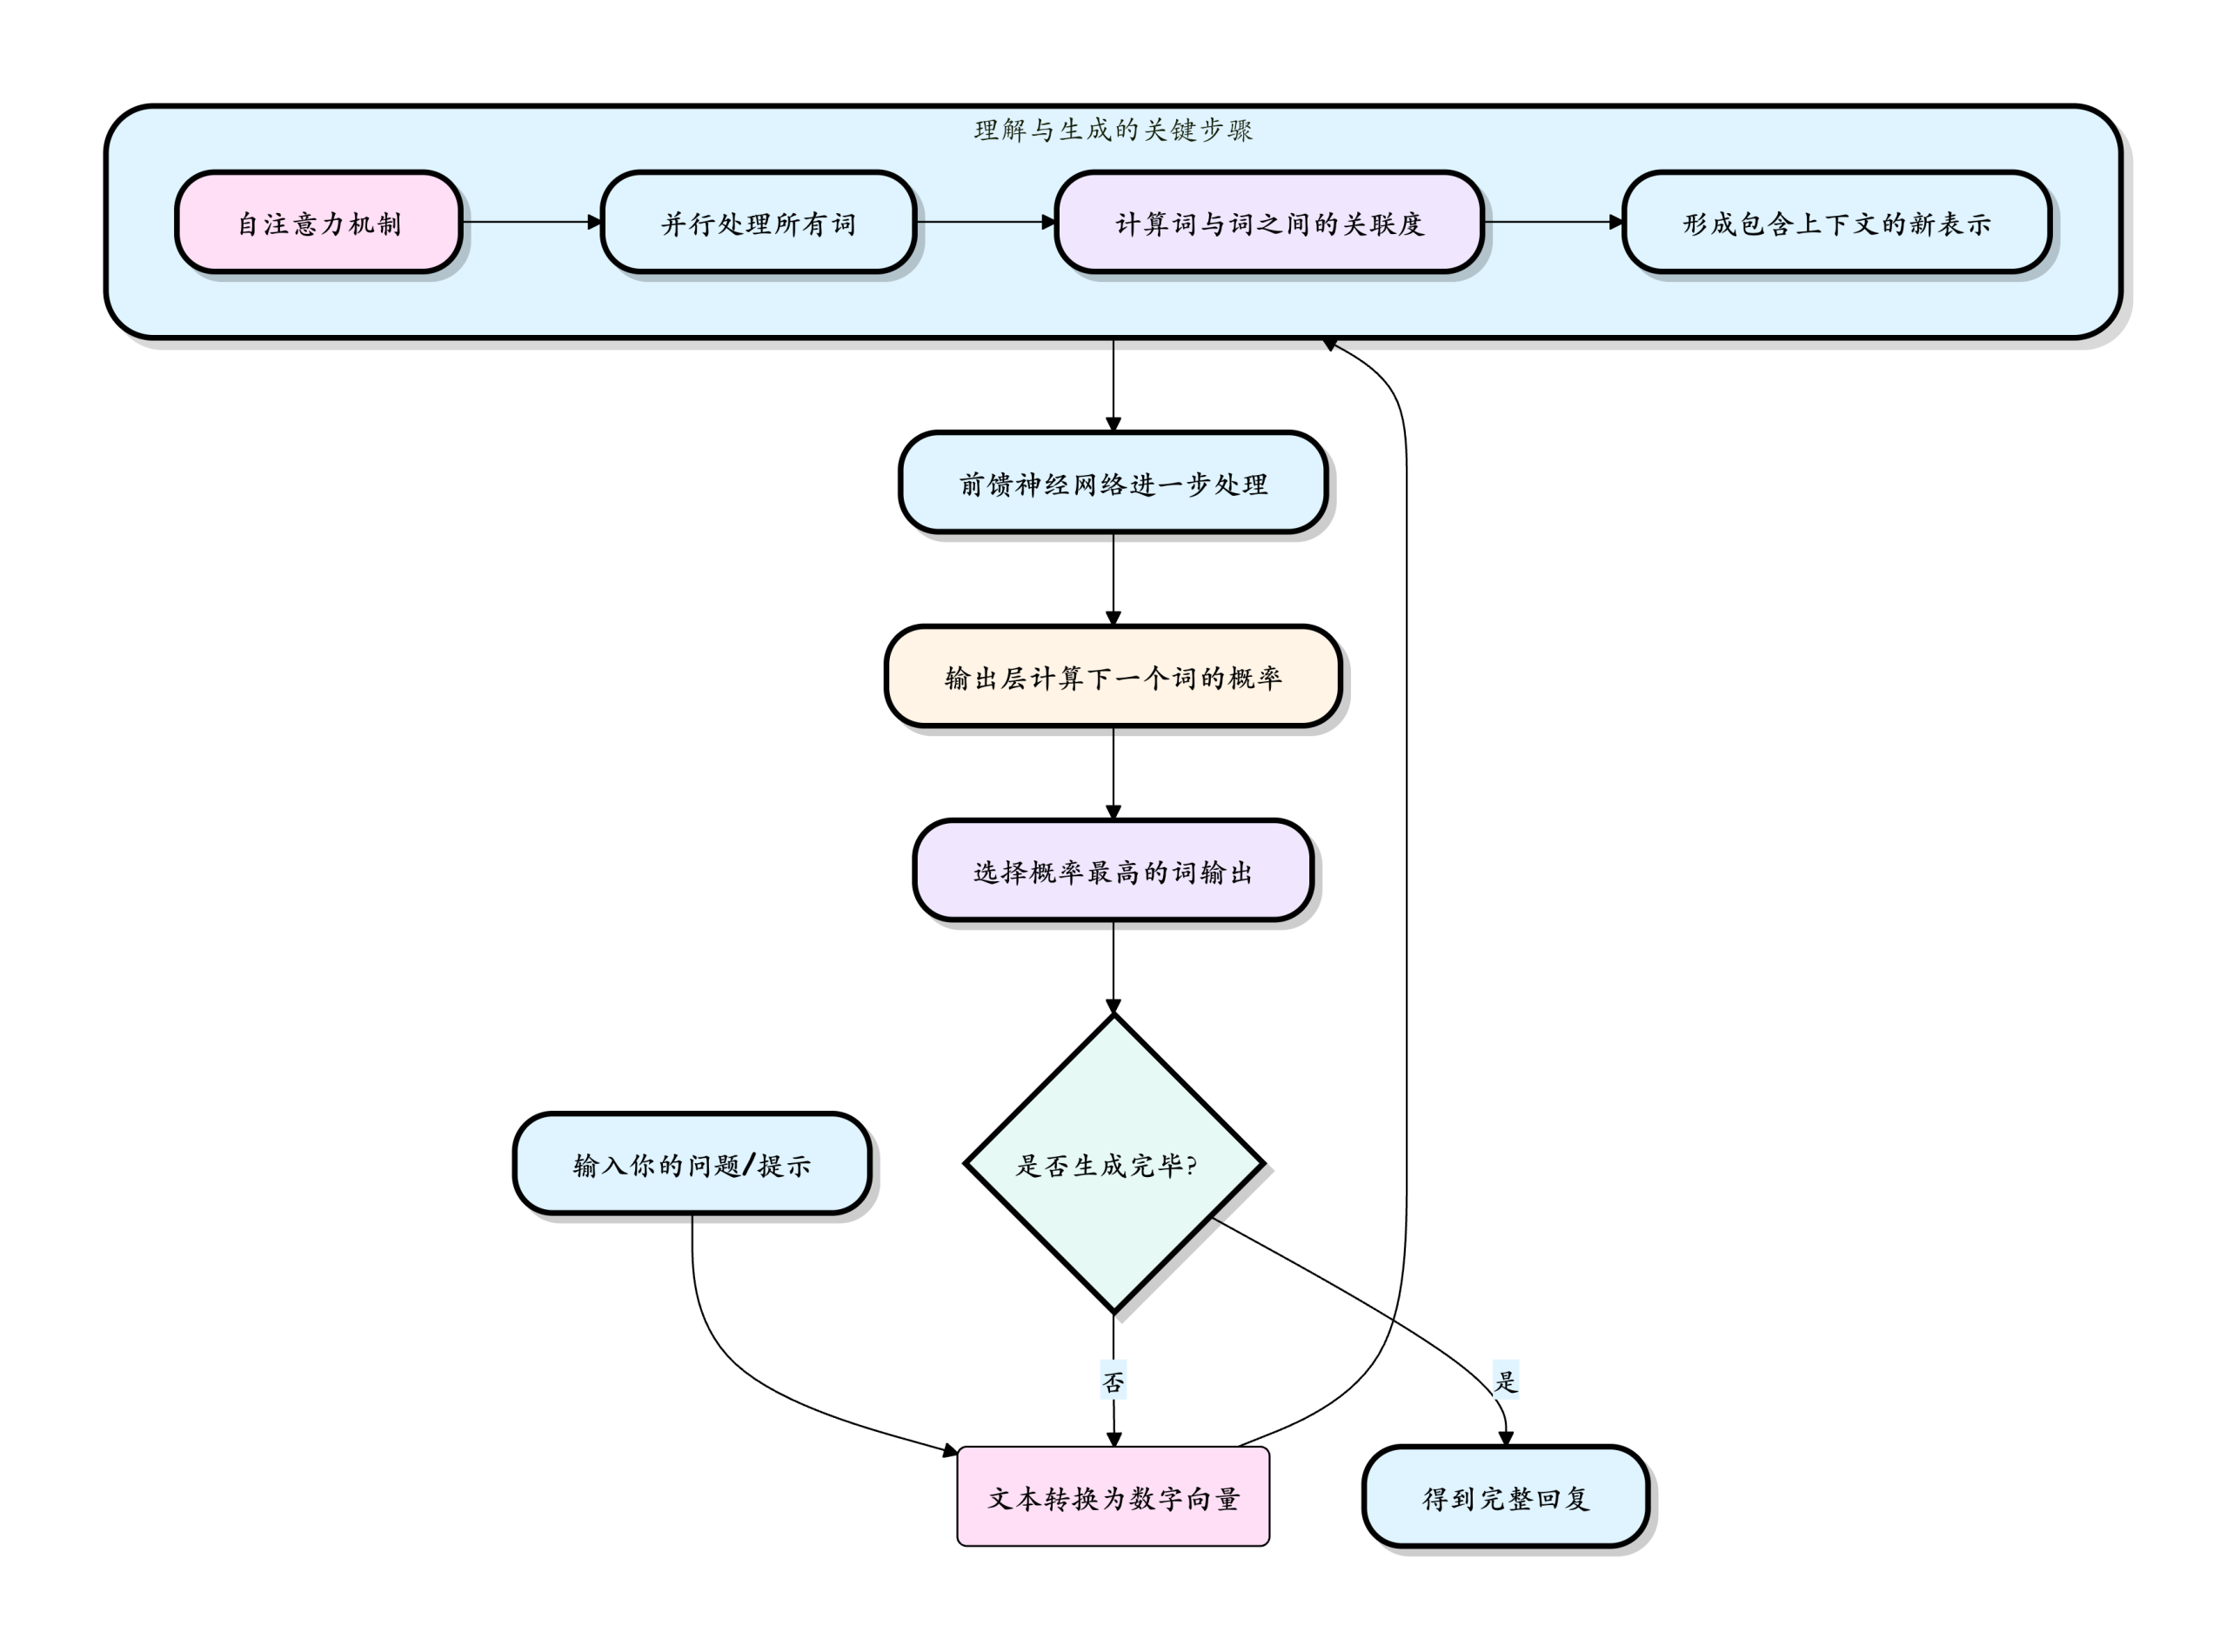
Self-Attention ist die entscheidendste Innovation des Transformers. Nehmen wir den Satz „Apples Telefon hat einen sehr großen Akku“ als Beispiel: Wenn das Modellesdieses Wort verarbeitet, hilft der Self-Attention-Mechanismus dem Modell zu bestimmenesundAppleundTelefonsind stark korreliert. Die folgende Abbildung zeigt die Verteilung der Attention-Gewichte in diesem Prozess:
Es ist genau diese Fähigkeit,parallel zu verarbeitenundglobalen Kontext tief zu verstehen,die es LLMs auf Transformer-Basis ermöglicht, frühere Technologien (wie RNN) bei Sprachaufgaben weit zu übertreffen.
Wie man mit LLM interagiert: Einführung in Prompt Engineering
PromptEr ist die Eingabe, die du dem LLM gibst. Er sagt dem Modell, was du willst, ähnlich wie Anweisungen an einen Assistenten – je klarer die Anweisungen, desto besser die Ergebnisse. Die Qualität des Prompts bestimmt direkt die Qualität der Antwort.
Ein guter Prompt besteht normalerweise aus den folgenden vier Teilen:
Grundprinzipien
Sei klar und konkret: Vermeide vage Formulierungen. Sag nichtSchreibe etwas über Hunde, sondern sage stattdessenSchreibe in lebendiger und anschaulicher Sprache eine kurze Einführung von etwa 100 Wörtern über die Persönlichkeitsmerkmale von Golden Retrievern für Kinder im Alter von 6-8 Jahren.。
Kontext bereitstellenTeile dem Modell deine Identität, deinen Hintergrund und deine Ziele mit. Zum Beispiel:Du bist ein erfahrener Python-Programmiermentor. Bitte erkläre einem Anfänger, der gerade die Grundsyntax gelernt hat, was List Comprehensions sind, und gib ein einfaches Beispiel.
Format angeben: Wenn du eine Ausgabe in einem bestimmten Format benötigst, gib es bitte klar an, zum Beispiel:Bitte fasse die folgenden Punkte in drei Stichpunkten zusammenoderBitte gib die Ausgabe im JSON-Format aus。
Schrittweises Denken (Chain-of-Thought): Bei komplexen Problemen kannst du das Modell im Prompt dazu anleiten, Schritt für Schritt zu argumentieren, zum Beispiel:Bitte analysiere dieses Problem Schritt für Schritt: Liste zuerst die bekannten Bedingungen auf, leite dann die Zwischenschritte ab und gib schließlich die Schlussfolgerung an.Dieser Ansatz kann die Genauigkeit komplexer Schlussfolgerungsaufgaben erheblich verbessern.
Häufige Anwendungsszenarien von LLM
| Szenariokategorie | Konkretes Beispiel | Beschreibung |
|---|---|---|
| Inhaltserstellung und -bearbeitung | E-Mails, Berichte, Blogs schreiben; Geschichten fortsetzen; Texte redigieren; Texte in verschiedenen Stilen übersetzen | Schnell Entwürfe erstellen, Inspiration und verschiedene Ausdrucksweisen liefern |
| Informationsbeschaffung und Zusammenfassung | Lange Dokumente schnell lesen und Kernpunkte extrahieren; Fragen und Antworten auf Basis von Wissensdatenbanken | Versteht Fragen besser als traditionelle Suche, kann zusammenfassen und integrieren |
| Programmierunterstützung | Code erklären, Code-Schnipsel generieren, Fehler debuggen, Code refaktorieren, Testfälle schreiben | Dient als 24/7-Programmierpartner und verbessert die Entwicklungseffizienz erheblich |
| Konversation und Kundenservice | Intelligente Chatbots, personalisierte Tutoren, Rollenspiele | Bietet anthropomorphe, kontextuell kohärente interaktive Erlebnisse |
| Logisches Denken und Analyse | Mathematikprobleme lösen, einfache logische Schlussfolgerungen ziehen, Datentrends analysieren, Pläne erstellen | Zeigt erstaunliche Denkfähigkeiten in begrenzten Bereichen |
API-Aufrufe und Parametereinstellungen
Um einen KI-Agenten zu erstellen, müssen Sie lernen, LLMs über eine API aufzurufen.
In diesem Kapitel verwenden wir die OpenAI API als Beispiel, um grundlegende Aufrufmethoden einzuführen.
openai ist eine leistungsstarke Python-Bibliothek für die Interaktion mit einer Reihe von OpenAI-Modellen und -Diensten. Details finden Sie unter:Python OpenAI。
Open-Source-Adresse:https://github.com/openai/openai-python
Grundlegende API-Aufrufe
1. Installieren Sie die erforderlichen Bibliotheken
pip install openai
Dann müssen Sie ein Konto auf der offiziellen OpenAI-Website registrieren und auf der API-Schlüssel-Seite einen API-Schlüssel generieren.
Beispiel
from openai import OpenAI
client = OpenAI(
# Dies ist der Standard und kann weggelassen werden
api_key=Der API-Schlüssel, den Sie beantragt haben,
)
response = client.responses.create(
model="gpt-4o",
instructions="Du bist ein Coding-Assistent, der wie ein Pirat spricht.",
input="Wie prüfe ich, ob ein Python-Objekt eine Instanz einer Klasse ist?",
)
print(response.output_text)
Der Zugriff auf OpenAI ist innerhalb des Landes immer noch etwas umständlich. Viele inländische Dienste unterstützen ebenfalls OpenAI, wie DeepSeek und Alibabas Qwen.
DeepSeek
Die DeepSeek API ist vollständig kompatibel mit dem OpenAI API-Format. Sie müssen nur ein paar Konfigurationen ändern, um direkt das OpenAI SDK oder kompatible Tools zu verwenden, um auf die DeepSeek API zuzugreifen.
Kernkonfigurationsparameter:
| Parameter | Wert/Beschreibung |
|---|---|
| base_url | Erforderlich, fester Wert:https://api.deepseek.com(Kann auch eintragenhttps://api.deepseek.com/v1, nur für OpenAI-Kompatibilität; v1 hat nichts mit der Modellversion zu tun) |
| api_key | Erforderlich. Sie müssen zuerst einen exklusiven API-Schlüssel auf der offiziellen DeepSeek-Website beantragen (Antragsadresse:https://platform.deepseek.com/) |
| model | Erforderlich,
|
Beispiel
from openai import OpenAI
# Client initialisieren (Kernkonfiguration: durch Ihren API-Schlüssel ersetzen)
client = OpenAI(
api_key=os.environ.get('DEEPSEEK_API_KEY'), # Empfohlen, über Umgebungsvariable zu konfigurieren, oder direkt hartcodieren (nicht empfohlen)
base_url="https://api.deepseek.com" # Feste DeepSeek-Domain
)
# Chat-API aufrufen
try:
response = client.chat.completions.create(
model="deepseek-v4-flash", # Modell angeben, Optionen: deepseek-v4-flash / deepseek-v4-pro
messages=[
{"role": "system", "content": "Du bist ein hilfreicher Assistent"}, # Definition der Systemrolle
{"role": "user", "content": "Hallo"}, # Benutzerfrage
],
stream=False # Nicht-Streaming-Ausgabe (gibt das vollständige Ergebnis auf einmal zurück)
)
# Antwortinhalt ausgeben
print("Antwort:", response.choices[0].message.content)
except Exception as e:
print("Aufruf fehlgeschlagen:", str(e))
Alibaba Bailian
Das Tongyi Qianwen von Alibaba Cloud Bailian unterstützt die OpenAI-kompatible Schnittstelle. Sie müssen nur den API-Schlüssel, die BASE_URL und den Modellnamen anpassen, um Ihren vorhandenen OpenAI-Code zum Alibaba Cloud Bailian-Dienst zu migrieren.
Wir müssen den Alibaba Cloud Bailian-Modellservice aktivieren und einen API-KEY erhalten.
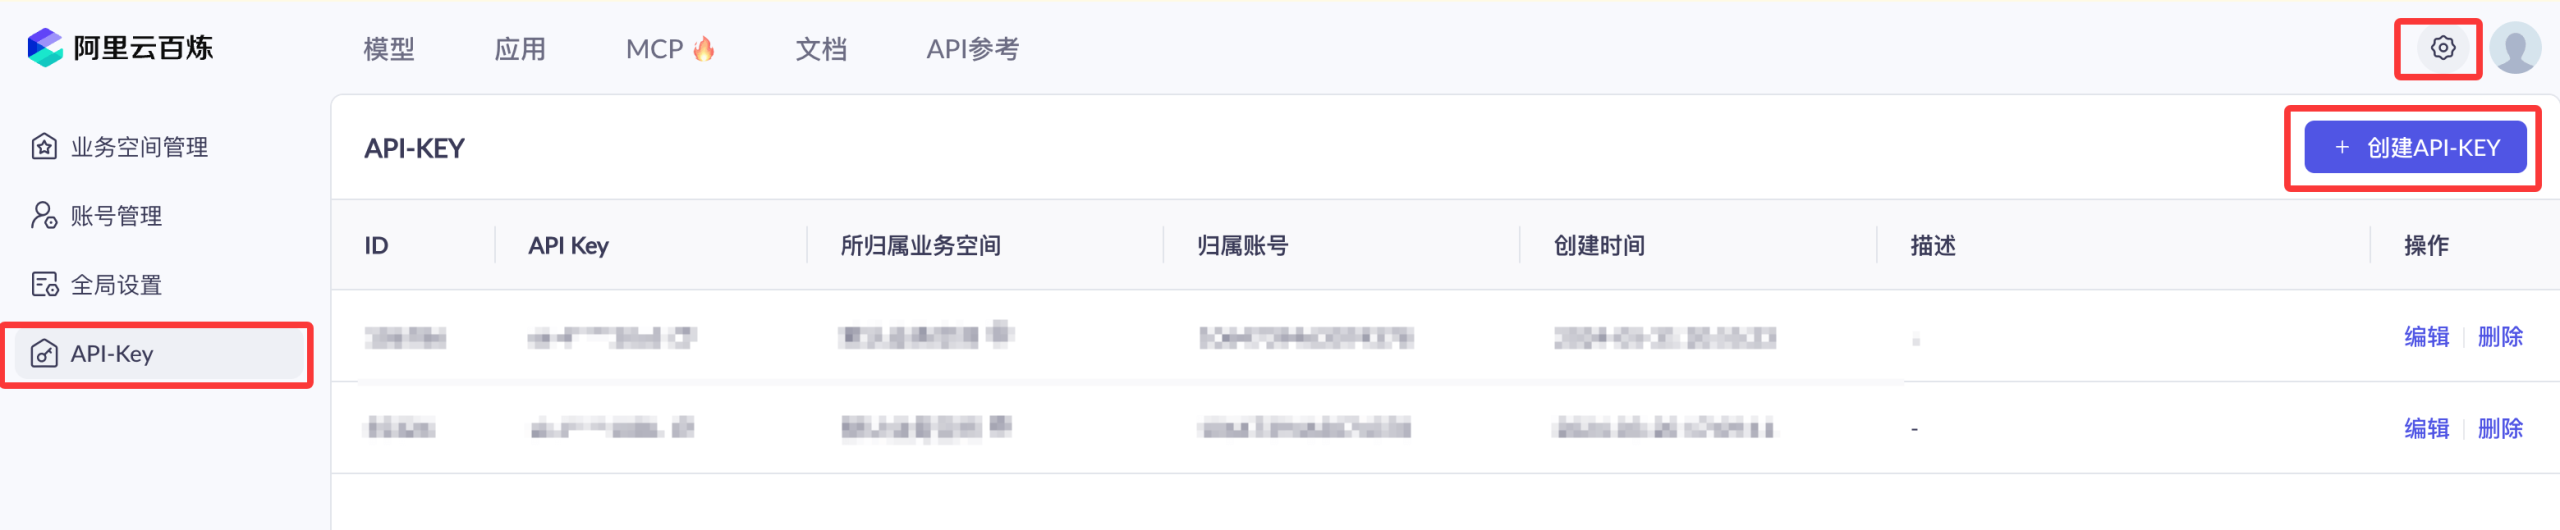
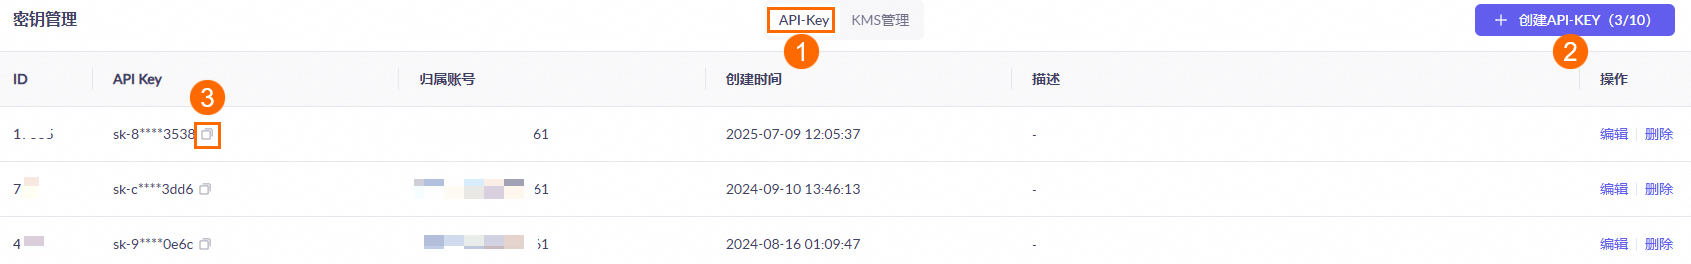
Wir können zunächst das Alibaba Cloud-Hauptkonto verwenden, um auf die Bailian-Modellserviceplattform zuzugreifen:https://bailian.console.aliyun.com/, klicken Sie dann oben rechts auf Anmelden. Nach der Anmeldung klicken Sie oben rechts auf das Zahnradsymbol ⚙️, wählen Sie API-Schlüssel aus und kopieren Sie dann den API-Schlüssel. Wenn Sie keinen haben, können Sie auch einen API-Schlüssel erstellen:
Die Aktivierung von Alibaba Cloud Bailian ist kostenlos. Nur Modellaufrufe (nach Überschreiten des kostenlosen Kontingents), Modellbereitstellung und Modell-Fine-Tuning verursachen entsprechende Kosten.
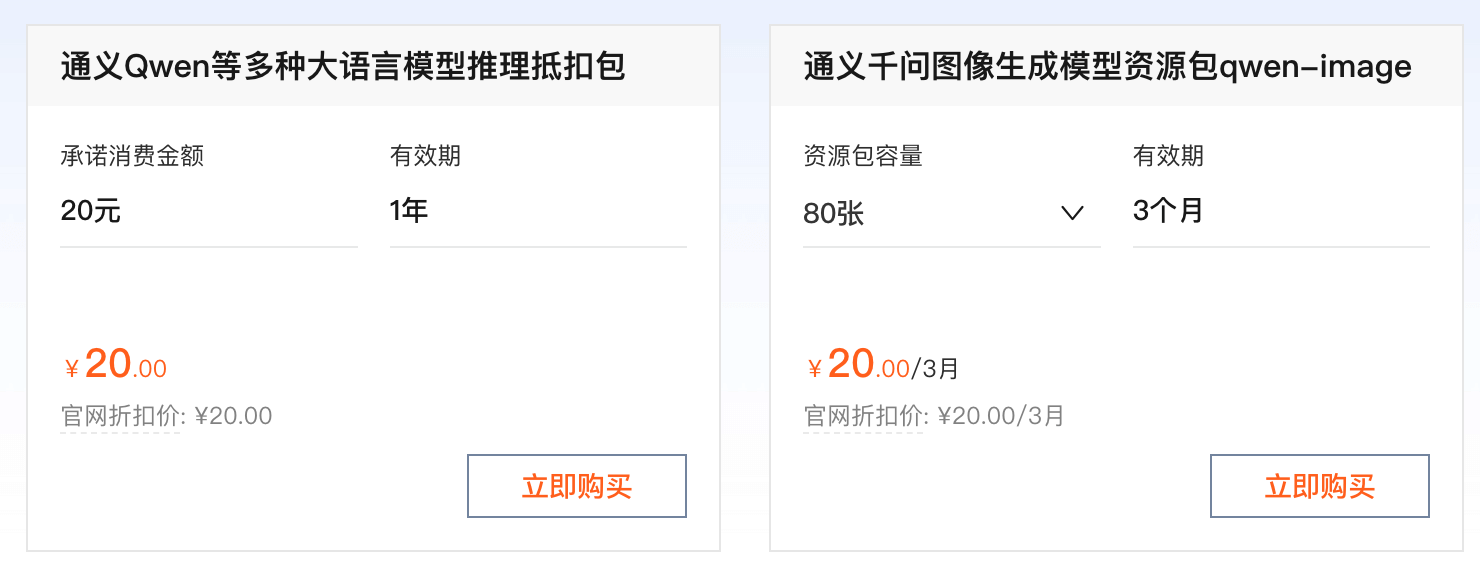
Für die Nutzung der API werden Sie nun pro Token abgerechnet. Glücklicherweise ist es nicht teuer. Wir können zunächst das günstigste Paket kaufen:Alibaba Cloud Bailian-Dienstplattform für große Modelle。
Sie können auch direkt das Coding Plan-Paket von Bailian und Ark verwenden:https://www.example.com/claude-code/coding-plan.html。
Nutzung
Als Nächstes verwenden wir das OpenAI SDK, um auf das Qwen-Modell auf Bailian zuzugreifen.
Beispiel für einen Nicht-Streaming-Aufruf
Beispiel
import os
def get_response():
client = OpenAI(
api_key="sk-xxx", # Bitte verwenden Sie den Alibaba Cloud Bailian API-Schlüssel
base_url="https://dashscope.aliyuncs.com/compatible-mode/v1", # Geben Sie die base_url des DashScope SDK ein
)
completion = client.chat.completions.create(
model="qwen-plus", # Hier wird qwen-plus als Beispiel verwendet; Sie können den Modellnamen nach Bedarf ändern. Modellliste: https://help.aliyun.com/zh/model-studio/getting-started/models
messages=[{'role': 'system', 'content': 'Sie sind ein hilfreicher Assistent.'},
{'role': 'user', 'content': 'Wer sind Sie?'}]
)
# JSON-Daten
#print(completion.model_dump_json())
print(completion.choices[0].message.content)
if __name__ == '__main__':
get_response()
Das Ausführen des Codes liefert das folgende Ergebnis:
I am Tongyi Qianwen, a large-scale language model independently developed by the Tongyi Lab under Alibaba Group. I can help you answer questions and create text, such as writing stories, official documents, emails, scripts, logical reasoning, programming, and more. I can also express opinions and play games. If you have any questions or need help, feel free to let me know at any time!
Beispiel für einen Streaming-Aufruf
Beispiel
def get_response():
client = OpenAI(
api_key="sk-xxx",
base_url="https://dashscope.aliyuncs.com/compatible-mode/v1",
)
completion = client.chat.completions.create(
model="qwen-plus",
messages=[
{'role': 'system', 'content': 'Sie sind ein hilfreicher Assistent.'},
{'role': 'user', 'content': 'Wer sind Sie?'}
],
stream=True,
stream_options={"include_usage": True}
)
for chunk in completion:
# Der Chunk enthält möglicherweise keine choices oder delta
if hasattr(chunk, "choices") and len(chunk.choices) > 0:
choice = chunk.choices[0]
if hasattr(choice, "delta") and hasattr(choice.delta, "content"):
print(choice.delta.content, end='', flush=True)
if __name__ == '__main__':
get_response()
Das Ausführen des Codes liefert das folgende Ergebnis:
I am Tongyi Qianwen, a large-scale language model independently developed by the Tongyi Lab under Alibaba Group. I can help you answer questions and create text, such as writing stories, official documents, emails, scripts, logical reasoning, programming, and more. I can also express opinions and play games. If you have any questions or need help, feel free to let me know at any time!
Große Sprachmodelle im Mainstream
Im Folgenden finden Sie eine Zusammenstellung offizieller Websites und API-Dokumentationsadressen für große Sprachmodelle im Mainstream: