Grand modèle multimodal
Les grands modèles multimodaux permettent à l'IA de traiter simultanément plusieurs formes d'informations, comme le texte, les images, l'audio et la vidéo, et constituent aujourd'hui l'une des directions de développement les plus centrales des grands modèles.
Cet article explique à partir de zéro le concept, le processus de développement, les principes internes et les capacités typiques de la multimodalité, et fournit à la finCréez votre première application multimodale en 5 minutesun exemple exécutable.
1. Qu'est-ce que le multimodal ?
Les grands modèles ordinaires ne peuvent généralement traiter qu'un seul type d'information—le texteSi vous donnez une image à une IA traditionnelle et lui demandez : « Combien de chats y a-t-il dans l'image ? », le modèle ne peut pas le faire sans prise en charge multimodale.
Mais le monde réel n'est pas composé de texte ; il est plutôt constitué de plusieurs types d'informations sensorielles :
| Organe sensoriel | Informations correspondantes |
|---|---|
| Yeux | Image |
| Oreille | Son |
| Bouche | Langage |
| main | Action |
| Vidéo | Image + Temps |
| Page web | Texte + Image + Structure |
Par conséquent,MultimodalCe concept est né.
Pour le comprendre en une phrase :
Multimodal = un modèle qui comprend et génère simultanément plusieurs formes d'information.
Examinons deux exemples typiques :
1. Saisir une image et une question :"La nourriture sur cette image est-elle riche en calories ?"Le modèle répond :"Il s'agit de poulet frit et de frites, estimés à environ 1,200 calories."
-
2. Saisir une voix :"Aidez-moi à résumer cette réunion"Le modèle produit un résumé textuel avec des suggestions d'actions.
Cette capacité à décrire des images et à résumer l'audio est la manifestation la plus directe de la multimodalité.
2. Qu'est-ce qu'un modal ?
La modalité estla forme de représentation de l'information.。
Différentes modalités correspondent à différentes entrées et sorties. Le tableau ci-dessous répertorie les modalités courantes et leurs applications typiques :
| Modalité | Exemple d'entrée | Exemple de sortie | Application typique |
|---|---|---|---|
| Texte | Romans, journaux de discussion | Réponses, articles | Questions-réponses, rédaction, traduction |
| Image | Photos, captures d'écran | Compréhension d'images, génération d'images | OCR, questions-réponses visuelles |
| Audio | Parole, musique | Transcrire du texte, synthétiser la parole | Résumés de réunions, assistants vocaux |
| Vidéo | Flux vidéo | Analyse vidéo, chronologie | Résumés pédagogiques, récupération de contenu |
| Capteur | GPS, température | Signal de commande | Robotique, conduite autonome |
| Action | Clics de souris, saisie au clavier | Exécuter des actions | Agent GUI, automatisation |
Plus un modèle prend en charge de modalités, plus ses capacités se rapprochent de celles des humains, c’est pourquoi tous les principaux laboratoires font évoluer les modèles de texte en modèles multimodaux.
3. Processus de développement des grands modèles multimodaux
Du traitement uniquement du texte à la capacité de voir, d'entendre et de produire de la vidéo, les grands modèles multimodaux ont connu trois étapes claires.
Phase 1 : Modèles de langage (LLM)
À ce stade, les modèles prennent le texte en entrée comme en sortie. Les produits représentatifs incluent la série GPT d'OpenAI, Anthropic Claude et Google Gemini.
Ils peuvent écrire du code, rédiger des articles, traduire et répondre à des questions. Ils sont très performants, mais ont une limitation fondamentale :Ils ne peuvent pas voir.。
Phase 2 : Modèles de vision-langage (VLM)
Le VLM ajoute la capacité de « voir des images » à un LLM. Un cas d'usage typique consiste à téléverser une capture d'écran d'une page web et à demander « pourquoi la mise en page est-elle incorrecte ? » Le modèle répond « conflit CSS ».
Les modèles à ce stade commencent à posséder des capacités telles que la compréhension d'images, l'OCR et la compréhension de graphiques.
Phase 3 : Modèles multimodaux natifs
Les modèles multimodaux natifs ne traitent plus « image » et « texte » comme deux modules concaténés. Au contraire, dès le tout début de l'entraînement, ilstraitent les images, l'audio, la vidéo et le texte de manière unifiée.。
Ils possèdent des capacités complètes : voir, entendre, parler, raisonner et agir. C'est également la direction dominante de l'industrie aujourd'hui.
4. Comment les modèles multimodaux fonctionnent-ils en interne ?
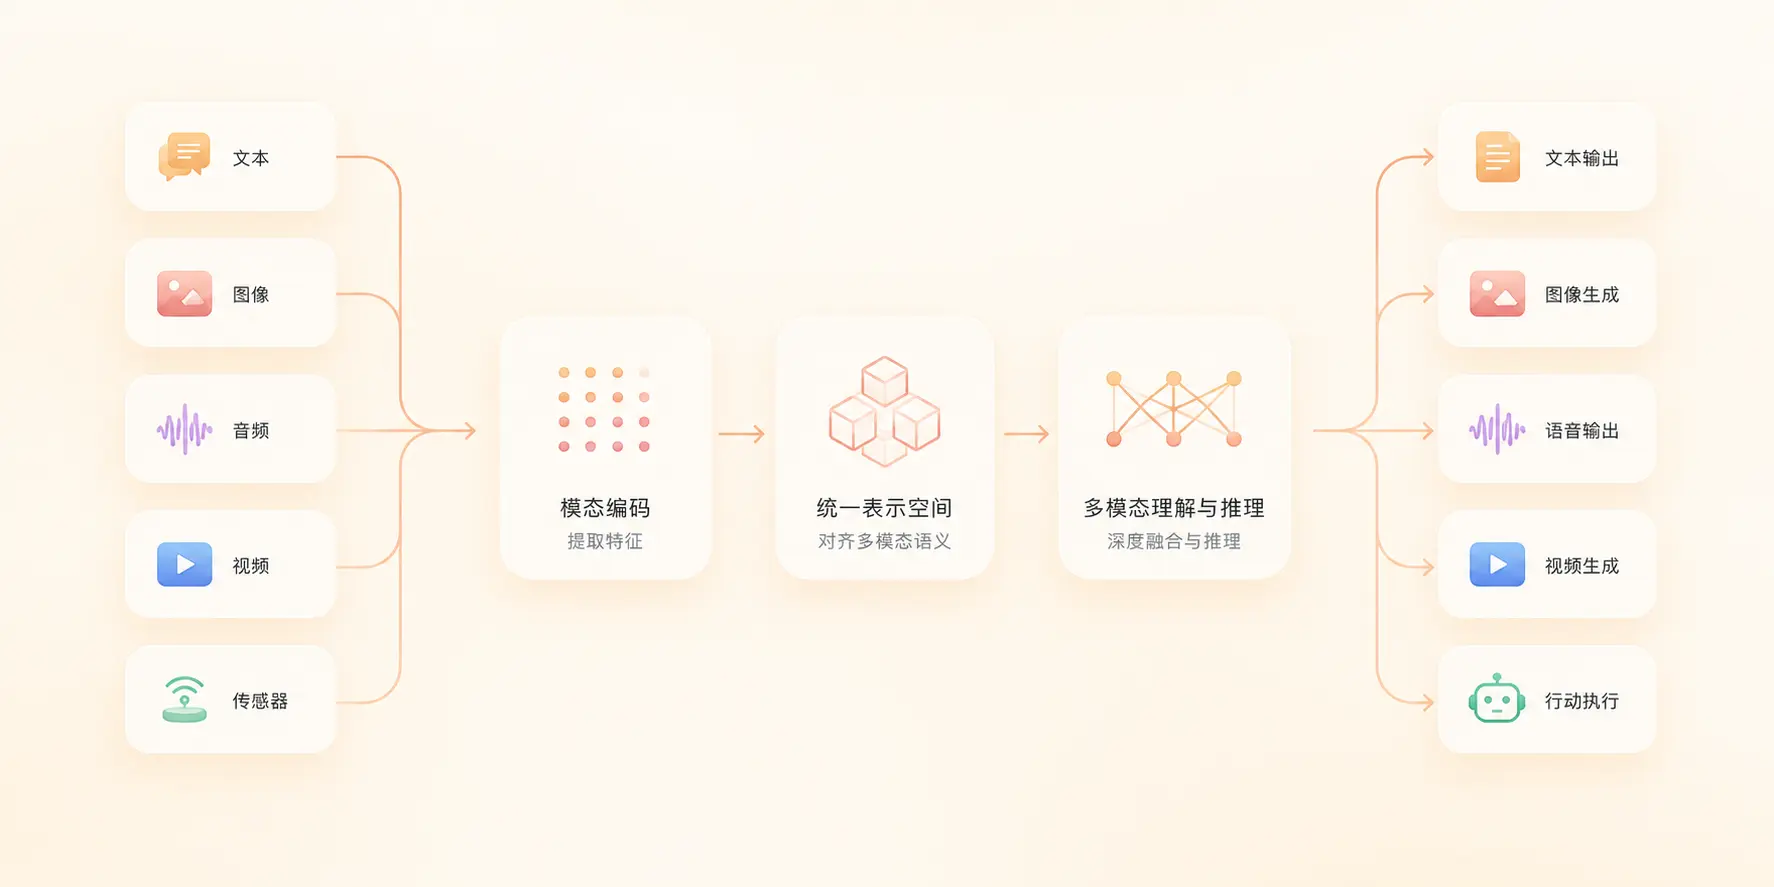
Le fonctionnement interne des modèles multimodaux peut se résumer en une phrase :Convertir toutes les données en un espace vectoriel unifié.。
Par exemple :
Les trois expressions "one只cat", "cat" et cat.png, bien qu'issues de modalités différentes, se retrouveront dans des régions voisines de l'espace vectoriel après encodage.
Le processus global est illustré dans la figure ci-dessous :
La figure ci-dessus montre le pipeline complet de l'entrée à la sortie ; décomposons chaque étape ci-dessous.
Étape 1 : Encodage
Les différentes modalités doivent d'abord être converties en nombres avant que le modèle puisse les traiter.
| Modalité | Données brutes | Encodé |
|---|---|---|
| Texte | Bonjour | [2034, 789] un ensemble d'identifiants de tokens |
| Image | Matrice de pixels | Vecteur de caractéristiques visuelles |
| Audio | Forme d'onde | Vecteur de caractéristiques spectrales |
Étape 2 : Espace sémantique unifié
L'étape clé après l'encodage est de rendre "cat", "cat" et cat.png dans l'espace vectorielproches les uns des autres。
C'est l'essence de la "compréhension intermodale" : projeter les caractéristiques de différentes modalités dans le même espace.
Étape 3 : Génération de sortie
Après un raisonnement dans l'espace unifié, le modèle "restaure" les résultats dans différentes modalités à la demande.
La sortie peut être l'un des éléments suivants : texte, image, audio et vidéo.
Par exemple : téléverser une image → la décrire → puis générer une vidéo d'introduction ; c'est une chaîne complète de génération multimodale.
5. Pourquoi le Transformer peut-il unifier la multimodalité ?
Il n'y a qu'une seule raison fondamentale :Mécanisme d'attention。
La formule centrale du Transformer est Attention(Q, K, V), ce qui signifie que "le modèle décide lui-même sur quoi se concentrer."
Par exemple : lorsqu’un utilisateur demande « Qui joue au basket-ball dans l’image ? », le modèle va :
- D’abord regarder l’image et identifier toutes les personnes qui s’y trouvent
- Identifier le ballon de basket-ball dans l’image
- Déterminer la relation entre « qui » et « basket-ball »
- Combiner le contexte pour produire la réponse
Cette capacité à « décider de manière autonome sur quoi se concentrer » rend le Transformer naturellement adapté au traitement d’entrées multimodales :
| Entrée | Ce sur quoi le modèle se concentre |
|---|---|
| Texte uniquement | Relations sémantiques entre les phrases |
| Image + texte | Correspondance entre les régions de l’image et les descriptions textuelles |
| Vidéo + texte | Relation entre les segments de la timeline et les questions |
C'est aussi pour cela que l'Attention est devenue une "caractéristique standard" de presque tous les grands modèles modernes — elle était intrinsèquement conçue pour l'inter-modalité.
6. Capacités typiques des modèles multimodaux
Les modèles multimodaux ont cinq capacités typiques ; la figure ci-dessous montre les relations entre elles.
1. Compréhension d'images
Saisissez une capture d'écran, et le modèle produit les problèmes de page, une analyse de l'UI ou des résultats OCR.
Le scénario le plus courant pour les programmeurs est : capturez l'erreur, laissez l'IA localiser le problème.
2. Génération d'images
Saisissez une description textuelle comme "Générer une ville futuriste", et le modèle renvoie une image IA.
Applications typiques : affiches, couvertures, ressources de jeu, croquis de produits.
3. Interaction vocale
La parole en entrée, le modèle répond en temps réel, avec des capacités couvrant l'ASR (transcription de la parole), le TTS (synthèse vocale) et la conversation.
4. Compréhension vidéo
Téléversez une vidéo pédagogique, et le modèle produit un résumé, une chronologie et des segments clés permettant de répondre.
5. Agent
Saisissez « Aidez-moi à créer un PPT », et le modèle commence à exécuter une chaîne d'actions complète : rechercher des ressources → générer un plan → créer des diapositives → réviser → exporter.
L'Agent est la forme ultime combinant « voir, entendre, parler » avec « l'exécution pratique ».
7. Cinq termes que les débutants doivent comprendre
Lors de la lecture d'une documentation liée au multimodal, les termes suivants apparaîtront de façon répétée ; mémorisez-les d'abord :
| Terme | Signification | Exemple |
|---|---|---|
| Token | La plus petite unité traitée par le modèle ; le texte est découpé en mots | "Hello world" → [Hello][world] |
| Embedding | Le processus de conversion d'informations en coordonnées numériques | "Chat" → [0.12, 0.78, 0.33, ...] |
| Contexte | L'historique et les informations contextuelles de la conversation actuelle. | L'utilisateur dit "Apple" + "Contexte : téléphone" = iPhone, pas le fruit |
| Attention | Détermine sur quelle partie de l'entrée le modèle se concentre. | Lorsqu'il regarde une image, le modèle regarde d'abord "personne" puis "basket-ball". |
| Inférence | Le processus par lequel le modèle génère une sortie à partir d'une entrée. | Après que l'utilisateur a saisi une question, le modèle "réfléchit et répond". |
Ces cinq termes parcourent toute la documentation sur les grands modèles ; développez d'abord votre intuition, puis revenez aux détails si nécessaire.
8. Expérience pratique : créez votre première application multimodale en 5 minutes
Objectif de cette section : téléversez une image, l'IA produit une description textuelle.
L'ensemble du processus ne nécessite aucune connaissance en apprentissage profond ; il suffit de savoir Python.
8.1 Préparer le projet
Créez d'abord un projet multimodal-demo, puis utilisez la bibliothèque openai pour tester :
Exemple
mkdir multimodal-demo
# Entrer dans le répertoire du projet
cd multimodal-demo
# Installer le SDK officiel d'OpenAI (compatible avec plusieurs modèles multimodaux)
pip install openai
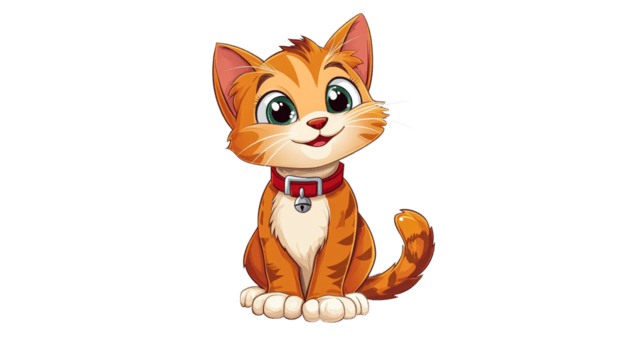
Dansmultimodal-demoTéléversez une image dans le répertoirecat-cartoon.webp, l'image est la suivante (vous pouvez faire un clic droit pour l'enregistrer afin de la tester) :
8.2 Écrire le code d'appel
Cet exemple utiliseArk's Coding Plan, et son modèle doubao-seed-2.0-pro prend en charge le traitement multimodal.
Enregistrez le code suivant sous le nom test.py:
Exemple
import os
from io import BytesIO
from openai import OpenAI
from PIL import Image
# ==================== Configuration Ark ====================
ARK_API_KEY = "ark-xxxx" # Remplissez votre clé ici
ARK_BASE_URL = "https://ark.cn-beijing.volces.com/api/coding/v3" # Il est recommandé d'utiliser l'API v3 universelle
MODEL_ENDPOINT = "doubao-seed-2.0-pro" # Modèle prenant en charge le multimodal
# Initialiser le client
client = OpenAI(
api_key=ARK_API_KEY,
base_url=ARK_BASE_URL,
timeout=60
)
def prepare_image_base64(image_path: str, max_size: int = 1024) -> str:
"""
Lire l'image locale, traiter le canal alpha, la redimensionner et la convertir en une chaîne base64
"""
if not os.path.exists(image_path):
raise FileNotFoundError(f"Image de test introuvable : {image_path}")
with Image.open(image_path) as img:
# 1. Traiter le fond transparent RGBA
if img.mode == "RGBA":
background = Image.new("RGB", img.size, (255, 255, 255))
background.paste(img, mask=img.split()[-1])
img = background
elif img.mode != "RGB":
img = img.convert("RGB")
# 2. Redimensionner proportionnellement (pour éviter que les grandes images ne fassent exploser le Payload/Token)
img.thumbnail((max_size, max_size))
# 3. Convertir en Base64
buf = BytesIO()
img.save(buf, format="JPEG", quality=85) # Compresser la qualité de manière appropriée
b64 = base64.b64encode(buf.getvalue()).decode("utf-8")
return f"data:image/jpeg;base64,{b64}"
def multimodal_chat(img_path: str, prompt: str):
"""Test de conversation multimodale"""
try:
print(f"Traitement de l'image : {img_path} ...")
img_b64 = prepare_image_base64(img_path)
print("Envoi de la requête à la plateforme Volcano Engine Ark...")
res = client.chat.completions.create(
model=MODEL_ENDPOINT,
messages=[
{
"role": "user",
"content": [
{"type": "text", "text": prompt},
{"type": "image_url", "image_url": {"url": img_b64}}
]
}
],
temperature=0.7,
max_tokens=1024
)
print("\n" + "="*10 + " Résultat de reconnaissance " + "="*10)
print(res.choices[0].message.content)
print("="*30)
return res
except FileNotFoundError as e:
print(f"[Erreur] {e}")
except Exception as e:
print(f"[Échec de la requête API] Veuillez vérifier si le réseau ou l'Endpoint/Key est correct. Message d'erreur :\n{e}")
return None
if __name__ == "__main__":
# Configuration de test
image_file = "./cat-cartoon.webp"
question = "Décrivez le contenu de cette image en détail, en analysant le sujet principal, les couleurs et la scène"
# Simuler la création d'une image de test temporaire (s'il n'y a pas d'image correspondante localement, pour un débogage visuel rapide)
if not os.path.exists(image_file):
print(f"{image_file} non détecté, génération d'une image de test temporaire...")
Image.new('RGB', (200, 200), color = (73, 109, 137)).save(image_file)
multimodal_chat(image_file, question)
Exécutez Pyhton, la sortie est la suivante :
在发送请求至火山引擎方舟平台...

========== 识别结果 ==========
这是一张**Q版萌系卡通风格的数字角色插画**,整体背景为纯净的纯白色,没有任何环境元素,所有视觉重心都集中在中心的小猫主体上,是典型的独立角色立绘/吉祥物设计。
---
### 一、画面主体详细描述
主体是一只端正坐姿的卡通幼橘猫,是经过萌化设计的家养橘白虎斑猫形象,整体气质乖巧天真、亲人友好:
1.  **比例与姿态**:采用萌系设计特有的大头短身比例,头部占整体高度的60%左右,
...
Ouvrez la console du navigateur, et vous verrez la description textuelle de l'image par le modèle. L'ensemble du pipeline est :
L'utilisateur téléverse une image → Le navigateur transmet l'URL de l'image au SDK OpenAI → Le modèle multimodal comprend l'image → Renvoie une description textuelle → Affiche dans la console.
8.3 Extensions courantes
Après avoir terminé le code exécutable minimal ci-dessus, vous pouvez continuer à étendre :
| Ce que vous voulez faire | Comment modifier |
|---|---|
| Passer au téléversement de fichiers locaux | Après que l'utilisateur a téléversé une image, lisez-la, convertissez-la en base64, puis affectez-la àimage_file |
| Prendre en charge le dialogue multi-tours continu | Ajouter les questions-réponses historiques àmessagesarray |
| Passer aux modèles d'autres fournisseurs | Spécifiez lors de la construction du client OpenAI.baseURL, comme les points de terminaison compatibles Qwen, OpenAI, Anthropic |
| Traitement de la parole. | mainteneztype: "image_url"Remplacez partype: "input_audio", et fournissez de l'audio en base64. |
9. Parcours d'apprentissage (recommandé)
Si vous débutez avec les grands modèles de langage, le diagramme ci-dessous est un parcours d'apprentissage éprouvé de 6 semaines.
10. Que se passera-t-il à l'avenir ?
En revenant sur l'évolution des formes de logiciels, une tendance claire se dégage :
Par le passé : logiciel = fonctionnalité.
Aujourd'hui : logiciel = modèle.
Futur : Logiciel = Agents intelligents multimodaux.
Cela signifie qu'à l'avenir, les utilisateurs n'auront qu'à dire une phrase, comme « crée un site web », et le modèle accomplira automatiquement tout le processus de conception, de codage, de déploiement et d'exploitation.
La multimodalité n'est pas aussi simple que « ajouter une fonction de visualisation d'images au modèle ».
Ce que cela change réellement, c'est :
Permettre aux ordinateurs de commencer à comprendre directement le monde réel.
C'est exactement le changement de paradigme le plus important dans l'industrie actuelle de l'IA, et aussi la direction dans laquelle tous les développeurs devraient investir.
Questions fréquentes
Qu'est-ce qui est mieux : les modèles multimodaux ou les LLM classiques ?
Cela dépend du scénario : pour la rédaction en texte brut, la génération de code et la traduction, un LLM classique est plus économique ; lorsque vous devez visualiser des images, écouter de l'audio ou comprendre la vidéo, un modèle multimodal est le seul choix.
Les modèles multimodaux peuvent-ils fonctionner localement ?
Oui, mais le coût est relativement élevé. Les VLM à faible nombre de paramètres (comme Qwen2-VL-7B) peuvent fonctionner sur des GPU grand public avec 16GB de VRAM ; les modèles plus grands nécessitent généralement des GPU cloud ou des appels API.
La sortie d'un modèle multimodal doit-elle être du texte ?
Pas nécessairement. Les modèles multimodaux natifs peuvent produire du texte, des images, de l'audio et même de la vidéo ; les VLM purs produisent généralement uniquement du texte.
Comment choisir une API multimodale ?
Si vous avez seulement besoin de compréhension d'images : OpenAI gpt-4o, Gemini 2.5 Flash et Qwen2-VL sont tous des choix économiques ; si vous avez besoin de « voir + écouter + voix en temps réel », il est recommandé d'utiliser directement l'API OpenAI Realtime ou Gemini Live.
Autres extensions