Modelos multimodales grandes (Multimodal)
Los grandes modelos multimodales permiten que la IA procese simultáneamente texto, imágenes, audio, video y otras formas de información; es una de las direcciones de desarrollo más importantes de los grandes modelos actuales.
Este artículo explica desde cero el concepto, el proceso de desarrollo, los principios internos y las capacidades típicas de la multimodalidad, y al final proporcionaun ejemplo ejecutable para crear tu primera aplicación multimodal en 5 minutos.
1. ¿Qué es la multimodalidad?
Los grandes modelos ordinarios suelen procesar solo un tipo de información:texto; si le das a una IA tradicional una imagen y le preguntas "¿cuántos gatos hay en esta imagen?", si no admite multimodalidad, el modelo no podrá hacerlo.
Pero el mundo real no está compuesto solo de texto, sino por múltiples tipos de información sensorial:
| Sentido | Información correspondiente |
|---|---|
| Ojos | Imagen |
| Oídos | Sonido |
| Boca | Lenguaje |
| mano | Acción |
| Video | Imagen + tiempo |
| Página web | Texto + imagen + estructura |
Por lo tanto,el concepto de multimodalidad (Multimodal)surge en respuesta a esta necesidad.
Para entenderlo en una frase:
Multimodal = un solo modelo que comprende y genera múltiples formas de información simultáneamente.
Veamos dos ejemplos típicos:
1. Entrada de imagen más pregunta:"¿La comida en esta imagen tiene muchas calorías?", el modelo responde:"Esto es pollo frito y papas fritas, aproximadamente 1200 calorías."
-
2. Entrada de voz:"Ayúdame a resumir esta reunión", el modelo genera un resumen de texto y adjunta sugerencias de acción.
Esta capacidad de describir imágenes y resumir audio es la manifestación más directa de la multimodalidad.
2. ¿Qué es una modalidad (Modal)?
La modalidad (Modality) se refiere a laforma de representación de la información。
. Diferentes modalidades corresponden a diferentes entradas y salidas. La siguiente tabla enumera las modalidades comunes y sus aplicaciones típicas:
| Modalidad | Ejemplo de entrada | Ejemplo de salida | Aplicación típica |
|---|---|---|---|
| Texto (Text) | Novelas, registros de chat | Respuestas, artículos | Preguntas y respuestas, redacción, traducción |
| Imagen (Image) | Fotos, capturas de pantalla | Comprensión de imágenes, generación de imágenes | OCR, preguntas y respuestas visuales |
| Audio (Audio) | Voz, música | Transcripción de texto, síntesis de voz | Resúmenes de reuniones, asistentes de voz |
| Video (Video) | Flujo de video | Análisis de video, línea de tiempo | Resúmenes educativos, búsqueda de contenido |
| Sensor (Sensor) | GPS, temperatura | Señales de control | Robótica, conducción autónoma |
| Acción (Action) | Clic de mouse, entrada de teclado | Ejecutar acciones | Agente GUI, automatización |
Cuantas más modalidades admita un modelo, más cerca estará su capacidad de la de un humano; por eso todos los laboratorios líderes están actualizando sus modelos de texto a modelos multimodales.
3. Proceso de evolución de los grandes modelos multimodales
Desde solo procesar texto hasta poder ver, oír y generar video, los grandes modelos multimodales han pasado por tres etapas claras.
Primera etapa: modelo de lenguaje (LLM)
En esta etapa, tanto la entrada como la salida del modelo son texto. Los productos representativos incluyen la serie GPT de OpenAI, Anthropic Claude y Google Gemini.
Pueden escribir código, redactar artículos, traducir, responder preguntas y tienen capacidades sólidas, pero con una limitación fundamental:no pueden ver。
Segunda etapa: modelo de lenguaje visual (VLM)
El VLM añade a la base del LLM la capacidad de "ver imágenes". Un uso típico es subir una captura de pantalla de una página web y preguntar "¿por qué el diseño está mal?"; el modelo responde "conflicto de CSS".
En esta etapa, los modelos comienzan a tener capacidades como: comprensión de imágenes, OCR, comprensión de gráficos, etc.
Tercera etapa: modelo nativo multimodal
El modelo nativo multimodal ya no trata la "imagen" y el "texto" como dos módulos concatenados, sino que desde el inicio del entrenamientoprocesa de manera unificada imágenes, sonido, video y texto。
. Tiene capacidades completas: ver, oír, hablar, razonar y ejecutar; esta es también la dirección principal de la industria actual.
4. ¿Cómo funciona internamente un modelo multimodal?
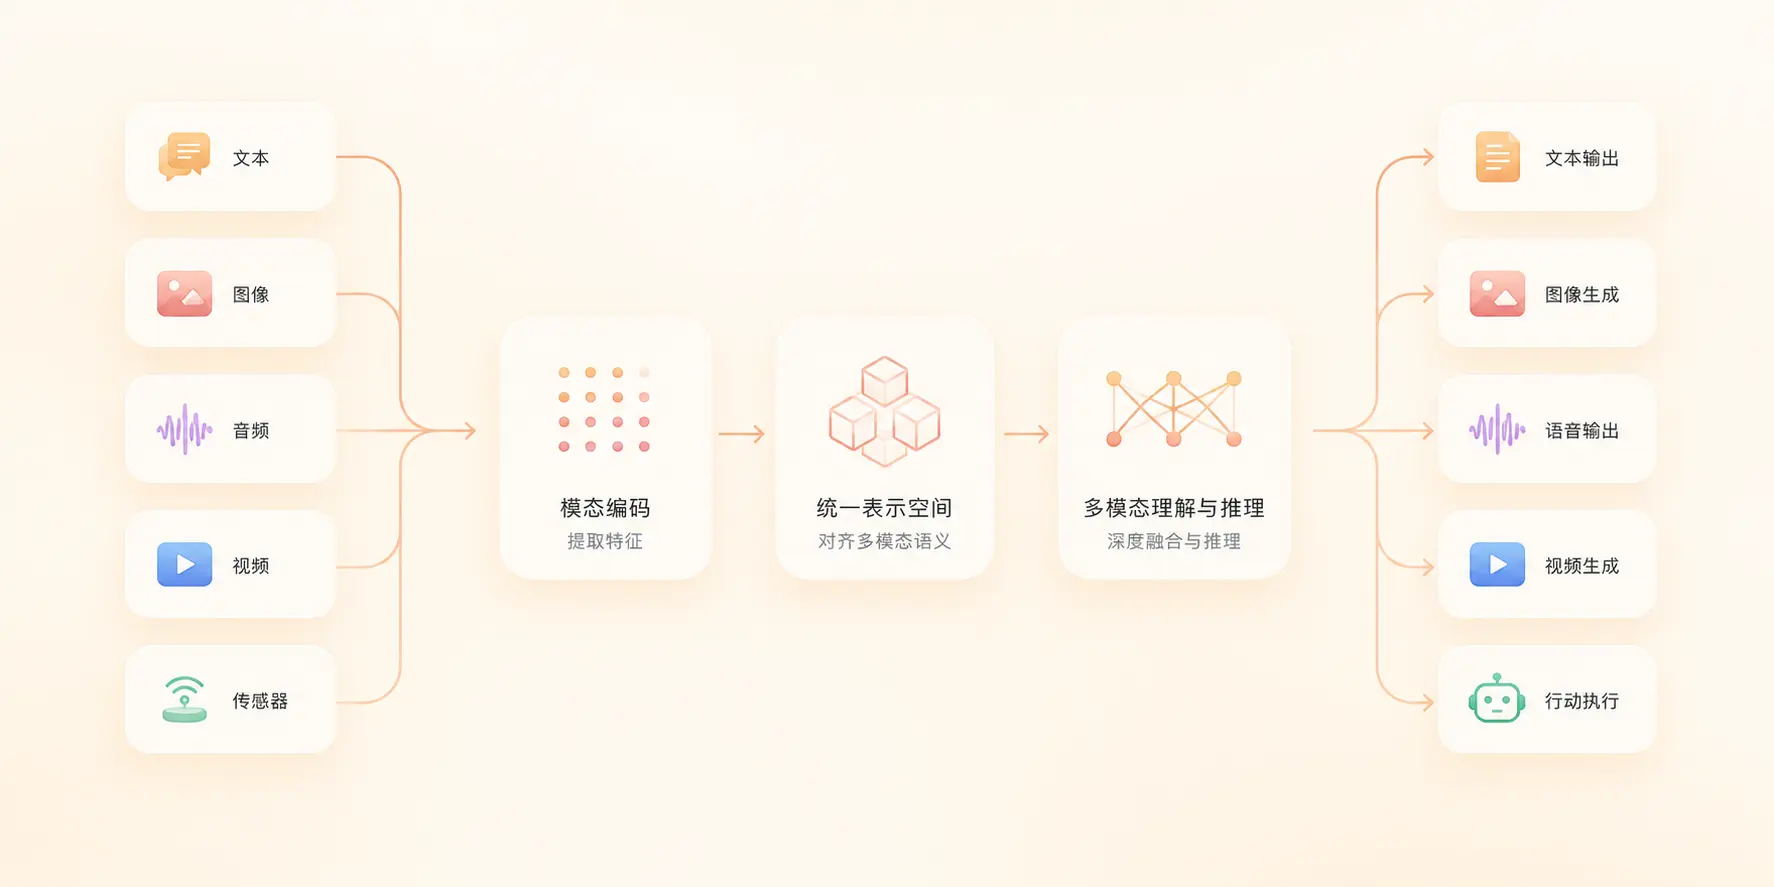
El funcionamiento interno de un modelo multimodal se puede resumir en una frase:convertir todos los datos en un espacio vectorial unificado。
Por ejemplo:
"un gato", "cat" y cat.png son tres expresiones; aunque provienen de diferentes modalidades, después de la codificación se ubican en regiones cercanas dentro del espacio vectorial.
El flujo general se muestra en la siguiente figura:
La figura anterior muestra la cadena completa desde la entrada hasta la salida; a continuación desglosamos cada paso.
Primer paso: codificación (Encoding)
Las diferentes modalidades deben convertirse primero en números para que el modelo pueda procesarlas.
| Modalidad | Datos originales | Después de la codificación |
|---|---|---|
| Texto | "Hola" | [2034, 789] un conjunto de IDs de token |
| Imagen | Matriz de píxeles | Vector de características visuales |
| Audio | Forma de onda | Vector de características espectrales |
Segundo paso: espacio semántico unificado
El paso clave después de la codificación es lograr que "gato", "cat", cat.png en el espacio vectorialestén cercanos entre sí。
Esta es la esencia de la "comprensión entre modalidades": proyectar las características de diferentes modalidades en un mismo espacio.
Tercer paso: generación de salida
Después de razonar en el espacio unificado, el modelo "restaura" el resultado a diferentes modalidades según sea necesario.
La salida puede ser cualquiera de las siguientes: texto, imagen, audio o video.
Por ejemplo: subir una imagen → describirla → luego generar un video de presentación; esta es una cadena completa de generación multimodal.
5. ¿Por qué Transformer puede unificar la multimodalidad?
Solo hay una razón central:El mecanismo de Attention (atención)。
La fórmula central del Transformer es Attention(Q, K, V), que significa "el modelo decide por sí mismo en qué debe prestar atención".
Por ejemplo: cuando el usuario pregunta "¿quién está jugando al baloncesto en la imagen?", el modelo:
- Primero observa la imagen y reconoce a todas las personas en ella
- Identifica el balón de baloncesto en la imagen
- Determina la relación entre "quién" y "balón de baloncesto"
- Integra el contexto y produce la respuesta
Esta capacidad de "decidir autónomamente el foco de atención" hace que el Transformer sea naturalmente adecuado para procesar entradas multimodales:
| Entrada | En qué se fija el modelo |
|---|---|
| Texto puro | Relaciones semánticas entre oraciones |
| Imagen + texto | Correspondencia entre regiones de imagen y descripciones de texto |
| Video + texto | Relación entre segmentos de la línea de tiempo y la pregunta |
Esta es también la razón por la que la Attention se ha convertido en el "estándar" de casi todos los grandes modelos modernos: está diseñada por naturaleza para lo multimodal.
6. Capacidades típicas de los modelos multimodales
Los modelos multimodales tienen cinco capacidades típicas; la siguiente figura muestra la relación entre ellas.
1. Comprensión de imágenes
Al ingresar una captura de pantalla, el modelo genera problemas de la página, análisis de UI o resultados de OCR.
El escenario más común para programadores es: capturar el error y dejar que la IA localice el problema.
2. Generación de imágenes
Al ingresar una descripción textual como "genera una ciudad del futuro", el modelo devuelve una imagen generada por IA.
Aplicaciones típicas: carteles, portadas, materiales para juegos, bocetos de productos.
3. Interacción por voz
Hablar es la entrada; el modelo responde en tiempo real. Sus capacidades cubren ASR (voz a texto), TTS (texto a voz) y diálogo.
4. Comprensión de video
Al subir un video educativo, el modelo genera un resumen, una línea de tiempo y segmentos clave con capacidad de preguntas y respuestas.
5. Agente inteligente (Agent)
Al ingresar "ayúdame a hacer un PPT", el modelo comienza a ejecutar una cadena de acciones completa: buscar información → generar un esquema → crear diapositivas → modificar → exportar.
El Agente es la forma final que combina "ver, oír, hablar" con la "ejecución práctica".
7. Cinco términos que todo principiante debe entender
Al leer documentación relacionada con multimodalidad, estos términos de la siguiente tabla aparecerán repetidamente; memorízalos primero:
| Término | Significado | Ejemplo |
|---|---|---|
| Token (unidad léxica) | La unidad mínima que procesa el modelo; el texto se divide por palabras | "Hola mundo" → [Ho][la][mundo] |
| Embedding (incrustación) | El proceso de convertir información en coordenadas numéricas | "gato" → [0.12, 0.78, 0.33, ...] |
| Contexto (Context) | El historial y la información de fondo de la conversación actual | Si el usuario dice "manzana" + "contexto: teléfono" = iPhone, no la fruta |
| Attention (atención) | Determina en qué parte de la entrada se enfoca el modelo | Al mirar una imagen, el modelo primero observa a la "persona" y luego el "balón" |
| Inference (inferencia) | El proceso mediante el cual el modelo genera una salida a partir de una entrada | Después de que el usuario ingresa una pregunta, el modelo "piensa y responde" |
Estos cinco términos aparecen en toda la documentación de grandes modelos; primero desarrolla la intuición y cuando encuentres detalles, vuelve a consultarlos.
8. Experiencia práctica: crea tu primera aplicación multimodal en 5 minutos
Objetivo de esta sección: subir una imagen y que la IA genere una descripción de texto.
Todo el proceso no requiere conocimientos previos de aprendizaje profundo; solo necesitas saber Python.
8.1 Preparación del proyecto
Primero crea un proyecto multimodal-demo y usa la librería openai para probar:
Ejemplo
mkdir multimodal-demo
# Entrar al directorio del proyecto
cd multimodal-demo
# Instalar el SDK oficial de OpenAI (compatible con varios modelos multimodales)
pip install openai
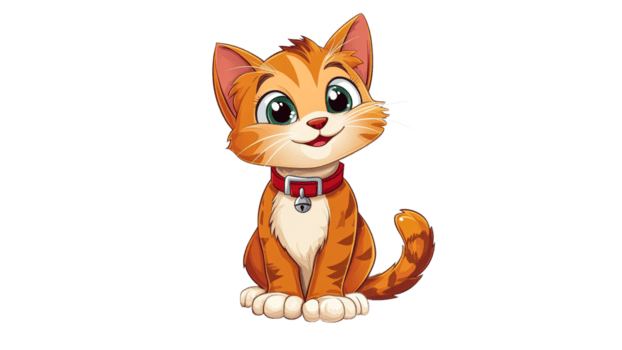
Enmultimodal-demoSube una imagen al directoriocat-cartoon.webp, la imagen es la siguiente (puedes hacer clic derecho y guardarla para probar):
8.2 Escribir el código de llamada
Este ejemplo utilizael Coding Plan de Jie Fangzhou, y su modelo doubao-seed-2.0-pro admite multimodalidad.
Guarda el siguiente código como test.py:
Ejemplo
import os
from io import BytesIO
from openai import OpenAI
from PIL import Image
# ==================== Configuración de Ark ====================
ARK_API_KEY = "ark-xxxx" # Aquí coloca tu Key
ARK_BASE_URL = "https://ark.cn-beijing.volces.com/api/coding/v3" # Se recomienda usar la interfaz general v3
MODEL_ENDPOINT = "doubao-seed-2.0-pro" # Modelo compatible con multimodalidad
# Inicializar el cliente
client = OpenAI(
api_key=ARK_API_KEY,
base_url=ARK_BASE_URL,
timeout=60
)
def prepare_image_base64(image_path: str, max_size: int = 1024) -> str:
"""
Lee la imagen local, procesa el canal alfa, reduce la escala y convierte a cadena base64
"""
if not os.path.exists(image_path):
raise FileNotFoundError(f"No se encontró la imagen de prueba: {image_path}")
with Image.open(image_path) as img:
# 1. Procesar el fondo transparente RGBA
if img.mode == "RGBA":
background = Image.new("RGB", img.size, (255, 255, 255))
background.paste(img, mask=img.split()[-1])
img = background
elif img.mode != "RGB":
img = img.convert("RGB")
# 2. Reducción de escala proporcional (evita que imágenes grandes excedan el Payload/Token)
img.thumbnail((max_size, max_size))
# 3. Convertir a Base64
buf = BytesIO()
img.save(buf, format="JPEG", quality=85) # Comprimir la calidad adecuadamente
b64 = base64.b64encode(buf.getvalue()).decode("utf-8")
return f"data:image/jpeg;base64,{b64}"
def multimodal_chat(img_path: str, prompt: str):
"""Prueba de diálogo multimodal"""
try:
print(f"Procesando imagen: {img_path} ...")
img_b64 = prepare_image_base64(img_path)
print("Enviando solicitud a la plataforma Volcano Engine Ark...")
res = client.chat.completions.create(
model=MODEL_ENDPOINT,
messages=[
{
"role": "user",
"content": [
{"type": "text", "text": prompt},
{"type": "image_url", "image_url": {"url": img_b64}}
]
}
],
temperature=0.7,
max_tokens=1024
)
print("\n" + "="*10 + " Resultado de reconocimiento " + "="*10)
print(res.choices[0].message.content)
print("="*30)
return res
except FileNotFoundError as e:
print(f"【Error】{e}")
except Exception as e:
print(f"【Error en la solicitud API】Verifica que la red o el Endpoint/Key sean correctos. Información del error:\n{e}")
return None
if __name__ == "__main__":
# Configuración de prueba
image_file = "./cat-cartoon.webp"
question = "Describe en detalle el contenido de esta imagen, analizando el sujeto, los colores y la escena"
# Simula la creación de una imagen de prueba temporal (si no hay una imagen local, facilita una depuración visual rápida)
if not os.path.exists(image_file):
print(f"No se detectó {image_file}, generando una imagen de prueba temporal...")
Image.new('RGB', (200, 200), color = (73, 109, 137)).save(image_file)
multimodal_chat(image_file, question)
Ejecuta Pyhton y el resultado de salida es el siguiente:
在发送请求至火山引擎方舟平台...

========== 识别结果 ==========
这是一张**Q版萌系卡通风格的数字角色插画**,整体背景为纯净的纯白色,没有任何环境元素,所有视觉重心都集中在中心的小猫主体上,是典型的独立角色立绘/吉祥物设计。
---
### 一、画面主体详细描述
主体是一只端正坐姿的卡通幼橘猫,是经过萌化设计的家养橘白虎斑猫形象,整体气质乖巧天真、亲人友好:
1.  **比例与姿态**:采用萌系设计特有的大头短身比例,头部占整体高度的60%左右,
...
Abre la consola del navegador y verás la descripción textual de la imagen generada por el modelo. Todo el flujo es:
El usuario sube una imagen → el navegador envía la URL de la imagen al SDK de OpenAI → el modelo multimodal comprende la imagen → devuelve una descripción textual → se imprime en la consola.
8.3 Extensiones comunes
Después de completar el código mínimo ejecutable anterior, puedes seguir ampliándolo:
| Qué quieres hacer | Cómo modificarlo |
|---|---|
| Cambiar a subida de archivos locales | Después de que el usuario suba la imagen, léela, conviértela a base64 y asígnala aimage_file |
| Soporte para conversaciones continuas de múltiples turnos | Añade el historial de preguntas y respuestas amessagesarray |
| Cambiar a modelos de otros proveedores | Especificar al construir el cliente de OpenAIbaseURL, como endpoints compatibles de Qwen, OpenAI, Anthropic |
| Procesar audio/voz | tomartype: "image_url"Cambiar atype: "input_audio", y proporcionar audio en base64 |
9. Ruta de aprendizaje (recomendada)
Si eres nuevo en los grandes modelos, la siguiente imagen muestra una ruta de aprendizaje de 6 semanas probada.
10. ¿Qué sucederá en el futuro?
Al revisar la evolución de las formas de software, se puede ver una tendencia clara:
Pasado: software = funciones.
Presente: software = modelos.
Futuro: software = agentes multimodales.
Esto significa que en el futuro el usuario solo necesitará decir una frase, por ejemplo "haz un sitio web", y el modelo completará automáticamente todo el proceso de diseño, codificación, implementación y operación.
Lo multimodal no es tan simple como "añadir una función de ver imágenes al modelo".
Lo que realmente cambia es:
Hacer que las computadoras comiencen a comprender directamente el mundo real.
Esta es la transformación de paradigma más importante en la industria de la IA actual, y también es una dirección en la que vale la pena que todos los desarrolladores inviertan.
Preguntas frecuentes
¿Qué es mejor, un modelo multimodal o un LLM normal?
Depende del escenario: para escritura de texto puro, generación de código y traducción, el LLM normal ofrece mejor relación calidad-precio; cuando necesitas ver imágenes, escuchar audio o comprender videos, el modelo multimodal es la única opción.
¿Se puede ejecutar un modelo multimodal localmente?
Sí, pero el costo es alto. Los VLM de parámetros pequeños (como Qwen2-VL-7B) pueden ejecutarse en tarjetas gráficas de consumo con 16GB de VRAM; los modelos más grandes generalmente requieren GPU en la nube o llamadas a API.
¿La salida de un modelo multimodal siempre es texto?
No necesariamente. Los modelos multimodales nativos pueden generar texto, imágenes, audio e incluso video; los VLM puros generalmente solo generan texto.
¿Cómo elegir una API multimodal?
Si solo necesitas comprensión de imágenes: OpenAI gpt-4o, Gemini 2.5 Flash y Qwen2-VL son opciones rentables; si necesitas "ver + oír + voz en tiempo real", se recomienda usar directamente la API Realtime de OpenAI o Gemini Live.
Otras extensiones