Dify Erste-Schritte-Tutorial
Dify (Do It For You) ist derzeit die beliebteste Open-Source-Plattform für die Entwicklung von LLM-Anwendungen, die speziell für die Erstellung generativer KI-Anwendungen konzipiert wurde, die von großen Sprachmodellen (LLMs) angetrieben werden.
Dify integriert KI-Workflow-Orchestrierung, RAG-Wissensdatenbanken, Agent-Frameworks, Modellverwaltung und Observability in eine einzige visuelle Plattform, sodass Sie schnell vom Prototyp in die Produktion wechseln können, ohne LLM-Infrastruktur von Grund auf neu aufbauen zu müssen.
Dify vereinfacht die Erstellung von KI-Anwendungen durch die Integration von RAG-Pipelines, KI-Workflows, Observability-Tools und Modellverwaltung.
Wenn LangChaineine Teilefabrik für KI-Anwendungen ist(flexibel, erfordert aber viel handgeschriebenen Code), dann ist Difyeine visuelle IDE für KI-Anwendungen– alle Komponenten sind vorhanden, einfach ziehen, verbinden und ausführen.

Vergleich mit anderen Tools
Im Folgenden werden Dify, LangChain und n8n anhand wichtiger Dimensionen verglichen.
| Dimension | Dify | LangChain | n8n |
|---|---|---|---|
| Hauptnutzer | Entwickler + Produktmanager | Entwickler | Betrieb/Automatisierung |
| Programmieranforderungen | Low-Code / No-Code | Erfordert das Schreiben von Python/JS | Low-Code |
| Integriertes RAG | Vollständig integriert | Erfordert manuelle Zusammenstellung | Eingeschränkt |
| Agent-Framework | Integriert | Integriert | Eingeschränkt |
| Observability | Integriert | Drittanbieter erforderlich | Eingeschränkt |
| Selbst gehostet | Vollständig unterstützt | Unterstützt | Unterstützt |
| Lizenz | Apache 2.0 | MIT | Fair-Code |
Das intuitive visuelle Orchestrierungsstudio von Dify macht es zur idealen Wahl für Startups und Unternehmen, die schnell funktionsfähige KI-Anwendungen erstellen müssen.
LangChain ist besser geeignet für komplexe Anwendungen auf Unternehmensebene, die benutzerdefinierte Integrationen und eine tiefe Beteiligung von Entwicklern erfordern.
Wer verwendet Dify?
Von der Biomedizin bis zur Automobilindustrie bietet Dify zuverlässige Lösungen für eine Vielzahl von Unternehmen.
Volvo Cars nutzt Dify zur schnellen Ideenvalidierung bei der strategischen Navigation an der KI-Front.
Nutzer loben Dify sehr dafür, die Entwicklung von KI-Agenten zu demokratisieren, indem leistungsstarke AI/ML-Funktionen in einer No-Code-Plattform kombiniert werden.
Kernkonzepte
Bevor Sie beginnen, lassen Sie uns die grundlegenden Konzepte von Dify verstehen:
| Konzept | Beschreibung |
|---|---|
| App | Die grundlegende Bereitstellungseinheit in Dify. Jede App entspricht einer unabhängigen KI-Funktion mit eigenem System-Prompt, zugehöriger Wissensdatenbank, Werkzeugkonfiguration und API-Schlüssel. |
| Wissensbasis | Eine Wissensdatenbank ist Ihre eigene Datensammlung, die in KI-Anwendungen integriert werden kann. Sie stellt LLMs Ihre proprietären Daten als zusätzliche Wahrheitsquelle beim Antworten bereit, wodurch Antworten genauer, relevanter und weniger anfällig für Halluzinationen werden. |
| RAG (Retrieval-Augmented Generation) | Wenn ein Benutzer eine Frage stellt, ruft das System zuerst die relevantesten Informationen aus der Wissensdatenbank ab (Retrieval), kombiniert dann die abgerufenen Ergebnisse mit der ursprünglichen Frage des Benutzers und sendet sie an das LLM (Augmented), und das LLM generiert basierend auf diesem Kontext eine präzisere Antwort (Generation). |
| Workflow | Erstellen und testen Sie leistungsstarke KI-Workflows auf einer visuellen Arbeitsfläche, indem Sie mehrstufige KI-Verarbeitungslogik durch Ziehen von Knoten und Verbinden von Linien definieren. |
| Agent | Agenten können basierend auf LLM Function Calling oder ReAct definiert werden, wobei ihnen vorgefertigte oder benutzerdefinierte Tools hinzugefügt werden. Dify bietet über 50 integrierte Tools für KI-Agenten, wie Google Search, DALL E, Stable Diffusion und WolframAlpha. |
| Knoten | Die Grundeinheit eines Workflows; jeder Knoten führt eine bestimmte Operation aus: LLM-Reasoning, Wissensabruf, Codeausführung, HTTP-Anfragen, bedingte Verzweigungen usw. |
Installation und Start
Vier Installationsmethoden, vom sofortigen Start bis zur Bereitstellung eines Hochverfügbarkeits-Clusters.
Methode 1: Dify Cloud (Am schnellsten, Onboarding in 0 Sekunden)
Besuchen Siecloud.dify.ai, registrieren Sie ein Konto und beginnen Sie sofort mit der Nutzung.
Der kostenlose Sandbox-Plan umfasst 200 Nachrichten pro Monat und 5 Anwendungen, ohne dass eine Umgebungskonfiguration erforderlich ist.
Geeignet für schnelle Tests, persönliche Projekte und Prototyping.

Methode 2: Docker Compose Self-Hosting (Empfohlen für die Produktion)
Geeignet für Benutzer mit technischem Hintergrund und bietet volle Kontrolle über Daten und Bereitstellungsumgebung.
Systemanforderungen
| Ressource | Mindestanforderung | Empfohlene Konfiguration |
|---|---|---|
| CPU | 2 Kerne | 4 Kerne |
| Gedächtnis | 4 GB | 8 GB |
| Festplatte | 20 GB | 50 GB+ |
| Docker | Engine 20.10+ | Neueste Version |
| Docker Compose | v2.2+ | Neueste Version |
Installationsschritte
Schritt 1: Repository klonen
Klonen Sie das Dify-Repository auf Ihren lokalen Rechner:
git clone https://github.com/langgenius/dify.git
cd dify
Schritt 2: Wechseln Sie in das docker-Verzeichnis und kopieren Sie die Umgebungskonfiguration
cd docker
# 从模板复制环境配置文件
cp .env.example .env
Schritt 3 (Wichtig): SECRET_KEY konfigurieren
Seit v1.14.1 verlassen sich Docker-Bereitstellungen nicht mehr auf einen öffentlichen Standard-Geheimschlüssel. Wenn SECRET_KEY leer ist, generiert und speichert die API automatisch einen Laufzeitschlüssel dauerhaft. Es wird empfohlen, ihn explizit in der .env-Datei festzulegen.
# 生成一个安全的随机密钥
openssl rand -base64 42
Bearbeiten Sie die .env-Datei, suchen Sie SECRET_KEY und setzen Sie ihn auf die oben generierte Zufallszeichenfolge:
SECRET_KEY=your-very-long-random-secret-key-here
Schritt 4: Dienst starten
# 启动所有 Dify 服务(首次会拉取镜像,约需 3-10 分钟)
docker compose up -d
Schritt 5: Zugreifen und initialisieren
Öffnen Sie http://localhost/install in Ihrem Browser und schließen Sie die Registrierung des Administratorkontos ab.
Schritt 6: Dienststatus überprüfen
# 查看所有容器状态,全部为 healthy 即表示运行正常
docker compose ps
Wenn sich alle Container (api, worker, web, db, redis, weaviate, nginx usw.) im Status „healthy“ befinden, laufen die Dienste normal.
Stoppen und neu starten
# 停止所有服务(数据保留在 Docker volumes 中)
docker compose down

# 重新启动所有服务
docker compose up -d
Upgrade auf eine neue Version
# 进入 docker 目录
cd dify/docker

# 拉取最新代码
git pull origin main

# 拉取新镜像
docker compose pull

# 重新启动
docker compose up -d
Daten werden in Docker-Volumes persistiert, und Updates wirken sich nicht auf vorhandene Anwendungen, Wissensdatenbanken oder den Gesprächsverlauf aus. Es wird empfohlen, die PostgreSQL-Datenbank vor größeren Versions-Upgrades zu sichern.
Methode 3: One-Click-Deployment im AWS Marketplace
Für Startups und kleine Unternehmen, die auf AWS tätig sind, ermöglicht Dify Premium im AWS Marketplace die One-Click-Bereitstellung in Ihrem eigenen AWS VPC und unterstützt benutzerdefiniertes Logo und Branding.
Methode 4: Kubernetes-Bereitstellung (Hochverfügbarkeit)
Für Szenarien, die eine Hochverfügbarkeitskonfiguration erfordern, stellt die Community Helm Charts und YAML-Dateien bereit, um Dify in einem Kubernetes-Cluster bereitzustellen.
# 添加 Dify Helm 仓库
helm repo add dify https://langgenius.github.io/dify-helm

# 使用自定义 values.yaml 安装
helm install dify dify/dify -f values.yaml
Modellanbieter konfigurieren
Nach der Installation besteht der erste Schritt darin, Ihr KI-Modell zu verbinden.
Vorgehensweise
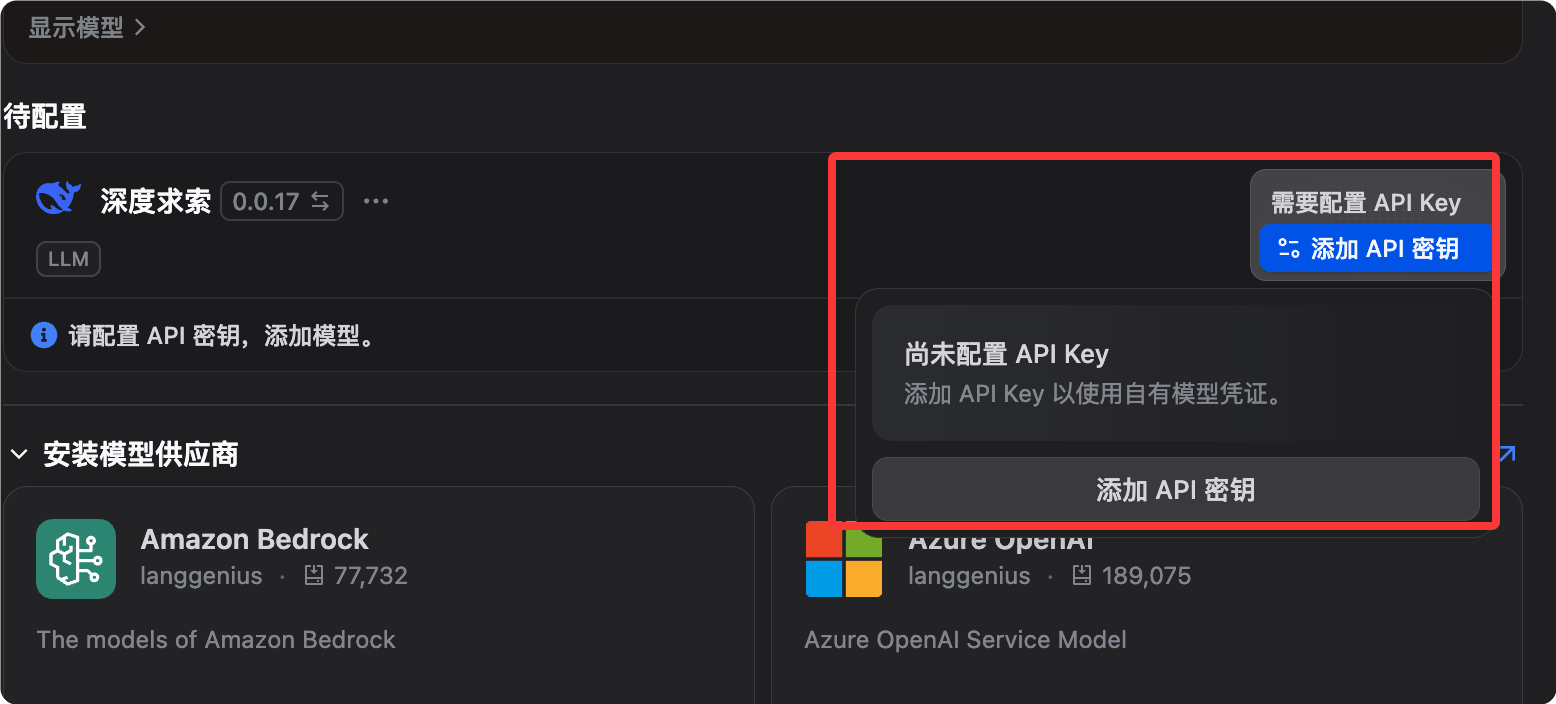
Nachdem Sie sich bei Dify angemeldet haben, klicken Sie auf den Avatar in der oberen rechten Ecke, gehen Sie zu den Einstellungen und wählen Sie Modellanbieter.

Zum Beispiel können wir den DeepSeek-Modellanbieter installieren und dann den API-Schlüssel konfigurieren:
Konfiguration gängiger Anbieter
Anthropic (Claude-Serie):
Provider: Anthropic
API Key: sk-ant-xxxxxxxx(从 console.anthropic.com 获取)
推荐模型:claude-sonnet-4-6(综合性能最佳)
OpenAI:
Provider: OpenAI
API Key: sk-xxxxxxxx(从 platform.openai.com 获取)
推荐模型:gpt-4o(性价比高)
Google (Gemini-Serie):
Provider: Google
API Key: xxxxxxxx(从 aistudio.google.com 获取)
推荐模型:gemini-2.0-flash(速度快,适合大量请求)
OpenRouter (ein Schlüssel für den Zugriff auf 300+ Modelle):
Provider: OpenRouter
API Key: sk-or-xxxxxxxx(从 openrouter.ai 获取)
Base URL: https://openrouter.ai/api/v1
Lokales Modell (Ollama):
Provider: Ollama
Base URL: http://host.docker.internal:11434  # Docker 内访问宿主机
(先在宿主机运行:ollama pull llama3.3)
Embedding-Modell konfigurieren (erforderlich für Wissensdatenbank)
Die Vektorisierung der Wissensdatenbank erfordert ein Embedding-Modell. Nachfolgend finden Sie empfohlene Optionen:
| Modell | Funktionen | Geeignete Szenarien |
|---|---|---|
| OpenAI text-embedding-3-small | Günstig und effektiv | Allgemeine Szenarien |
| Zhipu AI embedding-3 | Ausgezeichnete chinesische Unterstützung | Inhalt hauptsächlich auf Chinesisch |
| Lokales nomic-embed-text (Ollama) | Vollständig offline | Hohe Anforderungen an die Datensicherheit |
Modellverfügbarkeit überprüfen
Gehen Sie zurück zu den Einstellungen, suchen Sie den konfigurierten Anbieter und klicken Sie neben dem Modellnamen auf die Schaltfläche Testen. Ein grünes Häkchen zeigt eine erfolgreiche Konfiguration an.
Detaillierte Erklärung der fünf Anwendungstypen
Klicken Sie auf der Dify-Startseite auf App erstellen. Sie sehen fünf Typen, die jeweils unterschiedlichen Nutzungsszenarien entsprechen.
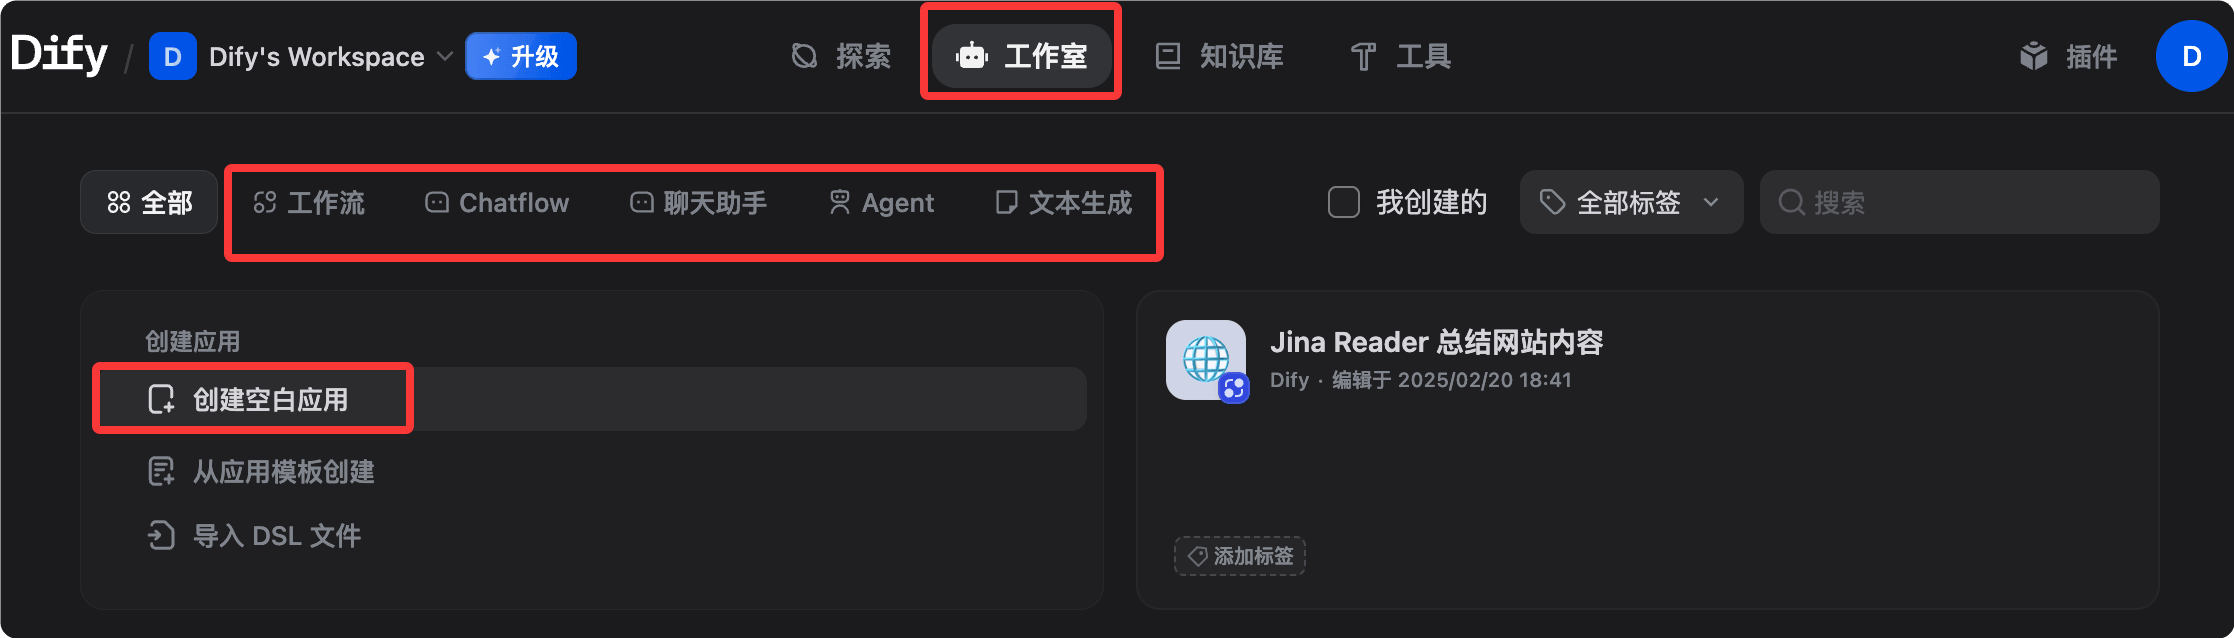
Klicken Sie, um eine leere Anwendung zu erstellen, und Sie sehen fünf Arten von Anwendungen:

1. Chatbot (Konversationsassistent)
Eine standardmäßige Multi-Turn-Konversationsanwendung mit dauerhaftem Sitzungsgedächtnis.
| Attribute | Beschreibung |
|---|---|
| Geeignete Szenarien | Kundenservice-Bots, persönliche Assistenten, FAQ-Fragen und -Antworten |
| Kernfunktionen | Integrierter Gesprächsspeicher (konfigurierbare Speicherstrategie), anbindbare Wissensdatenbank (RAG aktivieren), unterstützt Streaming-Ausgabe, Veröffentlichung als Web-Einbettungscode mit einem Klick. |
2. Textgenerator
Eine Eingabe zu einer Ausgabe, kein Gesprächsverlauf wird beibehalten.
| Attribute | Beschreibung |
|---|---|
| Geeignete Szenarien | Artikelumschreibung, Zusammenfassungsgenerierung, SEO-Copywriting, E-Mail-Entwurf |
| Kernfunktionen | Klare Struktur (Eingabeformular + Ausgabetext), geeignet für Stapelverarbeitung, unterstützt Variablenplatzhalter (z. B. {{product_name}}) |
3. Agent
Eine KI, die proaktiv Tools aufrufen, autonom mehrstufige Aufgaben planen und ausführen kann.
| Attribute | Beschreibung |
|---|---|
| Geeignete Szenarien | Datenabfrage und -analyse, Suche und Zusammenfassung, Codeausführung |
| Kernfunktionen | Unterstützt zwei Reasoning-Modi: Function Calling und ReAct; über 50 integrierte Tools (Suche, Bildgenerierung, Code-Interpreter usw.); unterstützt benutzerdefinierte API-Tools; der Tool-Aufrufprozess ist für Benutzer sichtbar |
4. Chatflow (Konversationsfluss)
Fügt Multi-Turn-Konversationsfunktionen zusätzlich zu Workflow hinzu und kombiniert Prozessorchestrierung mit Konversationskontext.
| Attribute | Beschreibung |
|---|---|
| Geeignete Szenarien | Komplexe Kundenserviceprozesse, Chatbots, die mehrstufige Entscheidungsfindung erfordern |
| Kernfunktionen | Sowohl die Knotenorchestrierungsfunktionen von Workflow als auch Multi-Turn-Konversationsgedächtnis, wodurch automatisierte Prozesse innerhalb der Konversation ausgelöst werden können |
5. Workflow
Ein rein automatisierter mehrstufiger Verarbeitungsablauf ohne Konversationsoberfläche, der über API ausgelöst oder manuell ausgeführt wird.
| Attribute | Beschreibung |
|---|---|
| Geeignete Szenarien | Stapel-Datenverarbeitung, geplante automatisierte Aufgaben, Backend-KI-Verarbeitungspipelines |
| Kernfunktionen | KI-Workflows auf einer visuellen Leinwand erstellen und testen; unterstützt parallele Zweige, Schleifen und bedingte Logik; unterstützt Human-in-the-Loop (Human Input node); Ausgabeergebnisse können in andere Systeme integriert werden |
Auswahlleitfaden
Entscheiden Sie schnell anhand Ihrer Anforderungen, welchen Anwendungstyp Sie verwenden sollten:
需要多轮对话?
├─ 是 → 需要复杂流程逻辑?
│        ├─ 是 → Chatflow
│        └─ 否 → Chatbot oder  Agent(需要工具调用时选 Agent)
└─ 否 → 单次输入输出?
          ├─ 是 → Text Generator
          └─ 需要多步骤自动化 → Workflow
Wissensdatenbank (RAG): KI mit Ihren privaten Daten antworten lassen
Die Wissensdatenbank ist eine der leistungsstärksten Funktionen von Dify und der Kern der meisten Unternehmensanwendungen.
Eine Wissensdatenbank erstellen
- Wählen Sie in der Navigationsleiste Knowledge (Wissensdatenbank) aus und klicken Sie auf Create Knowledge (Wissensdatenbank erstellen).
- Benennen Sie die Wissensdatenbank, z. B. 'Produkthandbuch' oder 'Interne Richtliniendokumente'
- Wählen Sie eine Erstellungsmethode
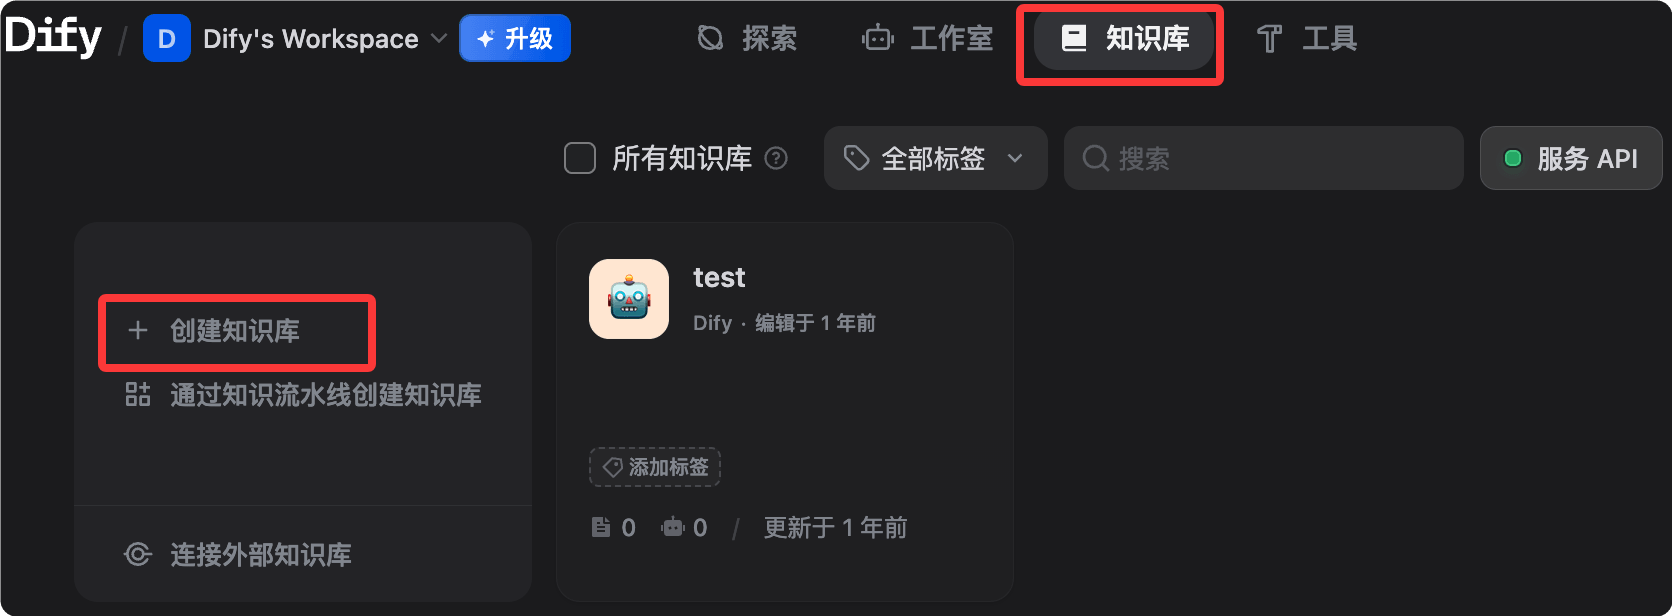
Methode 1: Dateien hochladen (am häufigsten)
Dify akzeptiert Dateien in den Formaten PDF, Word (.docx), Markdown (.md), reiner Text (.txt), CSV und HTML.
Markdown oder reiner Text wird empfohlen, da sie am zuverlässigsten zu parsen sind.
PDFs mit komplexen Layouts oder gescannte Versionen erfordern möglicherweise eine Vorverarbeitung; es wird empfohlen, OCR-Tools zu verwenden, um den Text vor dem Hochladen zu extrahieren.
Methode 2: Knowledge Pipeline (Enterprise-Level)
Knowledge Pipeline ist ein visuelles, knotenbasiertes Orchestrierungssystem, das speziell für die Aufnahme und Verarbeitung von Dokumenten entwickelt wurde.
Es adressiert drei große Schwachstellen von traditionellem RAG: verstreute Datenquellen, Informationsverlust beim Parsen (Diagramme und Formeln werden verworfen) und Black-Box-Verarbeitung (wodurch Fehlerursachen schwer zu diagnostizieren sind).
Methode 3: Externe Wissensdatenbank-API
Synchronisieren Sie vorhandene externe Wissensdatenbanken über API, ohne dass Daten migriert werden müssen.
Dokument-Chunking-Strategie
Nach dem Hochladen führt Dify automatisch ein Text-Chunking durch. Die wichtigsten Parameter werden unten erläutert:
| Parameter | Beschreibung | empfohlener Wert |
|---|---|---|
| Chunk-Größe | Token-Anzahl pro Chunk | 500-1000 (Chinesisch) |
| Chunk-Überlappung | Anzahl überlappender Token zwischen benachbarten Chunks | 50-100 |
| Trennzeichen | Aufteilen nach (Absatz/Satz) | Absatz |
Für chinesische Inhalte wird empfohlen, die Chunk-Größe auf etwa 500 Token festzulegen. Zu lang macht die Suche ungenauer; zu kurz verliert den Kontext.
Index-Modi
| Mode | Beschreibung | Kosten |
|---|---|---|
| Hohe Qualität (Standard) | Die Verwendung eines Embedding-Modells zur Generierung von Vektoren liefert die besten Ergebnisse | Verbraucht Embedding-API |
| Sparmodus | Invertierter Index (Schlüsselwortabgleich), kein Embedding erforderlich | Kostenlos |
Retrieval-Konfiguration
Gehe zur Wissensdatenbank, wähle Einstellungen und konfiguriere die Abrufparameter:
| Abrufmethode | Beschreibung | Anwendbare Szenarien |
|---|---|---|
| Vektorabruf | Semantischer Ähnlichkeitsabgleich | Bedeutungsbezogene Anfragen |
| Volltextabruf | Stichwortabgleich. | Exakte Begriffssuche |
| Hybrider Abruf (empfohlen) | Beides kombinieren und ein Reranking-Modell verwenden, um die Genauigkeit zu verbessern | Allgemeine Szenarien |
Der Ähnlichkeitsschwellenwert sollte auf 0.5-0.7 gesetzt werden.
Wenn der Ähnlichkeitsschwellenwert zu hoch ist, werden keine Ergebnisse zurückgegeben; ist er zu niedrig, werden irrelevante Inhalte zurückgegeben. Es wird empfohlen, mit 0.6 zu testen und anhand der Ergebnisse fein abzustimmen.
Abrufergebnisse testen
Klicke in der Wissensdatenbank auf Retrieval-Test, gib eine Testfrage ein und sieh dir die zurückgegebenen Chunks direkt an, um die Abrufqualität zu überprüfen, ohne tatsächlich eine Konversation zu starten.
Wissensdatenbank mit einer Anwendung verknüpfen
Wähle auf der Bearbeitungsseite der Anwendung Kontext aus, klicke auf Hinzufügen, wähle die erstellte Wissensdatenbank aus und speichere.
Nach der Verknüpfung ruft jede Konversation in der Anwendung vor der Antwort zuerst aus der Wissensdatenbank ab.
Workflow: Mehrstufige Aufgaben visuell orchestrieren
Definiere mehrstufige KI-Verarbeitungslogik durch Ziehen und Verbinden von Knoten.
Workflow-Editor öffnen
Wähle beim Erstellen einer Anwendung Workflow aus, oder klicke in einer vorhandenen Workflow-Anwendung auf Bearbeiten, um die Arbeitsfläche zu öffnen.

Hauptknotentypen
Die folgenden Knoten werden im Workflow-Editor am häufigsten verwendet und ihre Funktionen:
| Knoten | Funktion | Typischer Anwendungsfall |
|---|---|---|
| Start | Prozesseinstieg, definiert Eingabevariablen | Empfängt Benutzereingaben oder externe Parameter |
| LLM | Sprachmodell aufrufen | Textgenerierung, Analyse, Übersetzung |
| Wissensabruf | Aus der Wissensdatenbank abrufen | RAG-Szenarien |
| IF/ELSE | Bedingte Verzweigung | Leitet je nach Inhalt unterschiedliche Verarbeitungspfade weiter |
| Code | Python- oder JS-Code ausführen | Datentransformation, Formatverarbeitung, Berechnungen |
| HTTP-Anfrage | Externe API aufrufen | Datenbank abfragen, Benachrichtigungen senden |
| Vorlage | Rendern von Variablenvorlagen | Ausgaben mehrerer Knoten kombinieren |
| Variablenzuweiser | Variablen setzen/aktualisieren | Daten zwischen Knoten übergeben |
| Iteration | Listen durchlaufen | Mehrere Datenelemente stapelweise verarbeiten |
| Agent | Eingebetteter Agent-Knoten | Verleiht einem Schritt im Workflow die Fähigkeit zum autonomen Schlussfolgern |
| Menschliche Eingabe | Pausieren und auf menschliche Prüfung warten | Zentraler Entscheidungspunkt für Mensch-Maschine-Zusammenarbeit |
| Ende | Prozessausgang, definiert die Ausgabe | Gibt das Endergebnis zurück |

Variablenübergabe zwischen Knoten
Die Ausgabe jedes Knotens kann von nachfolgenden Knoten über die Syntax {{node_name.output_variable_name}} referenziert werden.
Das Folgende ist ein Beispiel für die Variablenübergabe in einem typischen RAG-Q&A-Workflow:
Start 节点输出 user_query
  ↓
Knowledge Retrieval 节点:
  输入:{{Start.user_query}}
  输出:result(检索结果)
  ↓
LLM 节点:
  System Prompt:你是一个客服助理,根据以下资料回答问题
  User:用户问题:{{Start.user_query}}
        参考资料:{{Knowledge Retrieval.result}}
  ↓
End 节点:
  返回:{{LLM.text}}
Human-Input-Knoten (HITL)
Der Human-Input-Knoten ist ein wichtiges Update, das Workflows ermöglicht, die Ausführung an entscheidenden Entscheidungspunkten zu pausieren.
Dieser Knoten erzeugt eine UI-Oberfläche zur menschlichen Überprüfung und Änderung von Variablen (z. B. Bearbeiten von Entwürfen oder Korrigieren von Daten) und bestimmt dann den weiteren Pfad basierend auf benutzerdefinierten Schaltflächen (wie "Approve", "Reject" oder "Escalate").
Dies löst das binäre Dilemma früherer Workflows – "entweder vollständig automatisiert oder vollständig manuell" – und ermöglicht es auch Hochrisikoszenarien (Vertragsprüfung, medizinische Beratung, Finanzentscheidungen), von automatisierter KI zu profitieren.
Debuggen des Workflows
Klicken Sie oben rechts auf der Canvas auf Run (Run), geben Sie Testparameter ein und beobachten Sie Eingabe/Ausgabe und Latenz jedes Knotens.
Neben Knoten erscheinen grüne (Erfolg) oder rote (Fehler) Indikatoren; klicken Sie darauf, um detaillierte Ausführungsprotokolle anzuzeigen.
Praxisszenario 1: Unternehmensinterner Wissens-Q&A-Bot
Verwenden Sie Dify, um einen Chatbot zu erstellen, der Fragen zu internen Dokumenten präzise beantworten kann, mit Quellenangaben in den Antworten.
Geschäftlicher Hintergrund
Das Unternehmen verfügt über eine große Anzahl interner Dokumente (HR-Richtlinien, Produkthandbücher, technisches Wiki). Mitarbeiter müssen oft Informationen finden, aber die Dokumente sind verstreut und schwer zu durchsuchen.
Schritt 1: Wissensdatenbank vorbereiten
- Dokumente organisieren: HR-Richtlinien (PDF), Produkthandbücher (Word) und technisches Wiki (Markdown) zur Verwendung exportieren.
- Wählen Sie unter Knowledge die Option Create Knowledge und nennen Sie sie "Company Internal Knowledge Base".
- Laden Sie Dateien hoch und wählen Sie den hochwertigen Indexierungsmodus.
- Warten Sie, bis die Vektorisierung abgeschlossen ist (wird durch Fortschrittsbalken angezeigt).
Tipps zur Optimierung der Dokumentqualität: Entfernen Sie irrelevante Informationen, Kopf-/Fußzeilen und Sonderzeichen. Verwenden Sie klare Überschriften und kurze Absätze. Wenn ein Dokument mehrere verschiedene Themen abdeckt, ziehen Sie eine Aufteilung in separate Dateien in Betracht.
Schritt 2: Chatbot-Anwendung erstellen
- Klicken Sie auf Create App, wählen Sie Chatbot und nennen Sie ihn "Internal Assistant".
- Wählen Sie ein Modell (Claude Sonnet 4.6 oder GPT-4o empfohlen).
- Schreiben Sie den System Prompt.

You are an internal company knowledge assistant, specifically helping employees find information in internal documents.

Code of conduct:
- Only answer based on the provided knowledge base content; do not fabricate information
- Cite the source document name when answering
- If the relevant information is not found in the knowledge base, directly say "I did not find the relevant information in the documents" and suggest contacting the corresponding department
- Use concise, professional language
- Do not discuss topics other than company confidential matters
- Klicken Sie unter Context auf Add und wählen Sie "Company Internal Knowledge Base".
- Konfigurieren Sie die Retrieval-Parameter: Hybrid-Retrieval, Ähnlichkeitsschwelle 0,6, Top 5 Segmente zurückgeben.
Schritt 3: Testen und Optimieren
Testen Sie mit echten Fragen. Hier sind empfohlene Testfälle:
测试问题示例:
"年假怎么申请?" → 应该从 HR 政策文档返回正确步骤
"产品 A 的定价是多少?" → 应该从产品手册返回准确价格
"如何配置 VPN?" → 应该从技术 Wiki 返回步骤
"CEO 是谁?" → 如果文档中没有,应该诚实说不知道
Häufige Optimierungsvorgänge
| Problem | Lösung |
|---|---|
| Ungenaue Antworten | Senken Sie die Ähnlichkeitsschwelle (z. B. 0,5) und erhöhen Sie die Anzahl der zurückgegebenen Chunks. |
| Irrelevante Antworten | Erhöhen Sie die Schwelle (z. B. 0,7) und prüfen Sie, ob das Dokument-Chunking sinnvoll ist. |
| Unvollständige Antworten | Erhöhen Sie die Chunk-Größe, damit jeder Chunk vollständigere Absätze enthält. |
Schritt 4: Veröffentlichen und Integrieren
Als Web-App veröffentlichen: Wählen Sie auf der App-Seite Overview, klicken Sie auf Embedded, kopieren Sie den Embed-Code und fügen Sie ihn in eine interne Wiki- oder Intranetseite ein.
Als API veröffentlichen: Wählen Sie auf der App-Seite API Reference, kopieren Sie den API Key und rufen Sie das Beispiel auf:
# 调用聊天 API,向知识问答机器人发送问题
curl -X POST 'https://api.dify.ai/v1/chat-messages' \
  -H 'Authorization: Bearer app-xxxxxxxx' \
  -H 'Content-Type: application/json' \
  -d '{
    "inputs": {},
    "query": "年假怎么申请?",
    "response_mode": "blocking",
    "user": "employee-001"
  }'
Praxisszenario 2: Automatisierte Content-Generierungspipeline
Verwenden Sie Workflow, um Marketinginhalte für verschiedene Kanäle parallel zu generieren.
Geschäftlicher Hintergrund
Das Marketingteam muss Produkt-Update-Logs (technische Sprache) stapelweise in Inhalte für verschiedene Kanäle umwandeln: Beiträge für den WeChat Public Account, technische Blogs und Kurzvideoskripte.
Workflow-Design
Start(输入:更新日志文本)
  ↓ 并行分支
  ├─→ LLM-1:生成微信推文(轻松活泼,500字,含表情符号)
  ├─→ LLM-2:生成技术博客(专业详细,1500字,含代码示例)
  └─→ LLM-3:生成短视频脚本(口语化,300字,分镜头格式)
  ↓ 合并
End(输出:三份内容)
Konkrete Aufbauschritte
Schritt 1: Erstellen Sie eine Workflow-App und nennen Sie sie "Content Generation Pipeline".
Schritt 2: Konfigurieren Sie den Start-Knoten und fügen Sie Eingabevariablen hinzu:
| Variablenname | Type | Beschreibung |
|---|---|---|
| update_content | Texttyp | Ursprüngliches Produkt-Update-Protokoll |
| product_name | Texttyp | Produktname |
| version | Texttyp | Versionsnummer |
Schritt 3: Fügen Sie drei LLM-Knoten hinzu (parallel).
Verbinden Sie alle drei LLM-Knoten mit dem Start-Knoten, und Dify führt sie automatisch parallel aus.
LLM-1 (WeChat-Beitrag) Beispiel-Prompt:
你是一位擅长社交媒体写作的内容创作者。

请将以下 {{product_name}} v{{version}} 的更新日志改写成微信公众号推文:
- 字数:400-600字
- 语气:轻松活泼,贴近用户
- 结构:开头吸引眼球,中间介绍亮点,结尾引导互动
- 适当使用 emoji
- 不要使用技术术语,用用户能理解的语言

更新日志原文:
{{Start.update_content}}
LLM-2 (technischer Blog) und LLM-3 (Kurzvideo-Skript) werden ähnlich konfiguriert; passen Sie einfach den Prompt und das Modell an.
Schritt 4: Fügen Sie einen End-Knoten hinzu und konfigurieren Sie Ausgabevariablen:
wechat_post:引用 {{LLM-1.text}}
tech_blog:引用 {{LLM-2.text}}
video_script:引用 {{LLM-3.text}}
Schritt 5: Integrieren Sie es über die API in interne Tools.
Beispiel
def generate_content(update_content: str, product_name: str, version: str):
"""Rufen Sie die Dify Workflow-API auf, um stapelweise Multi-Version-Inhalte zu generieren."""
# API-URL: Ersetzen Sie api.dify.ai durch Ihre Dify-Instanzdomäne
url = "https://api.dify.ai/v1/workflows/run"
# Anfrage-Header: Ersetzen Sie durch den API-Schlüssel Ihrer App
headers = {
"Authorization": "Bearer app-xxxxxxxx", # Erforderlich: App-API-Schlüssel
"Content-Type": "application/json"
}
# Anfragekörper: Übergeben Sie die drei im Start-Knoten definierten Eingabevariablen
payload = {
"inputs": {
"update_content": update_content, # Ursprüngliches Update-Protokoll
"product_name": product_name, # Produktname
"version": version # Versionsnummer
},
"response_mode": "blocking", # Blocking-Modus, warten auf das vollständige Ergebnis
"user": "content-team" # Benutzerkennung, verwendet für die Protokollverfolgung
}
response = requests.post(url, headers=headers, json=payload)
# Extrahieren Sie das Feld outputs aus der Antwort, das die Generierungsergebnisse der drei LLM-Knoten enthält
return response.json()["data"]["outputs"]
Praxisszenario 3: Kundensupport-Agent (mit Human-in-the-Loop)
Erstellen Sie ein intelligentes System zur Bearbeitung von Kundendienst-Tickets: KI bearbeitet Standardprobleme automatisch, und komplexe Probleme werden mit Voranalyse an menschliche Agenten weitergeleitet.
Geschäftlicher Hintergrund
Eine E-Commerce-Plattform erhält durchschnittlich 500+ Kundendienst-Tickets pro Tag; die meisten sind Standardfragen (Logistik-Anfragen, Rückgaberichtlinien), aber etwa 20% erfordern manuelle Bearbeitung (komplexe Beschwerden, große Rückerstattungen).
Workflow-Design
Start(接收用户工单:问题类型 + 内容 + 订单号)
  ↓
LLM-分类:判断问题类型(standard / complex)
  ↓
IF/ELSE:问题类型是否为 standard?
  ├─ standard →
  │    Knowledge Retrieval(从客服知识库检索)
  │      ↓
  │    LLM-回复:生成标准回答
  │      ↓
  │    End(直接回复用户)
  │
  └─ complex →
       LLM-预分析:生成问题摘要和建议处理方案
         ↓
       Human Input(人工审核,可编辑 AI 建议,选择"批准"/"修改"/"升级")
         ↓
       End(发送经过人工确认的回复)
Wichtige Knotenkonfiguration
Klassifizierungs-LLM-Knoten (gibt strukturiertes JSON aus):
Beispiel
"system": "Sie sind ein Experte für die Klassifizierung von Kundendienst-Tickets. Bitte analysieren Sie das folgende Ticket und geben Sie das Klassifizierungsergebnis im JSON-Format aus.",
"output_schema": {
"category": "Standard oder komplex",
"reason": "Klassifizierungsgrund (ein Satz)",
"priority": "niedrig / mittel / hoch"
},
"criteria": {
"standard": Logistik-Anfrage, Rückgaberichtlinie, normale Rückerstattung (<500 Yuan), Kontoprobleme,
"complex": Große Rückerstattung (>500 Yuan), Beschwerden, Streitigkeiten, Produktqualitätsprobleme
}
}
Konfiguration des Human-Input-Knotens:
| Konfigurationselement | Beschreibung |
|---|---|
| Anzeigeinhalt | KI-Voranalyse-Ergebnisse + vorgeschlagener Antwortentwurf |
| Editierbare Felder. | Antwortinhalt, Priorität |
| Benutzerdefinierte Schaltflächen. | Genehmigen (gemäß KI-Vorschlag antworten), Mit Änderungen genehmigen (nach manueller Bearbeitung antworten), Eskalieren (an ein spezialisiertes Bearbeitungsteam weiterleiten) |
Erwartete Ergebnisse
| Tickettyp | Verarbeitungsmethode | Effektverbesserung |
|---|---|---|
| Standardfragen (etwa 80%) | Vollautomatische Verarbeitung durch KI | Antwortzeit von 4 Stunden auf 30 Sekunden reduziert |
| Komplexe Fragen (etwa 20%) | KI unterstützt Menschen, indem sie Analysen und Entwürfe bereitstellt | Manuelle Bearbeitungszeit um 60% reduziert |
| insgesamt | - | Ticketbearbeitungseffizienz um etwa das 3-Fache verbessert |
Externe Veröffentlichung: API, Web-Einbettung und MCP-Server
Das Veröffentlichen von Dify-Anwendungen in externen Systemen unterstützt drei Methoden: API-Aufrufe, Web-Einbettung und MCP-Server.
Als API veröffentlichen
Jede Dify-Anwendung verfügt automatisch über eine REST-API. Gehen Sie zur Anwendungsseite und wählen Sie API-Zugriff aus, um sie zu erhalten.
Beispiel für API-Aufruf einer Chat-Anwendung:
# 调用聊天 API(流式返回模式)
curl -X POST 'https://api.dify.ai/v1/chat-messages' \
  -H 'Authorization: Bearer {API_KEY}' \
  -H 'Content-Type: application/json' \
  -d '{
    "inputs": {},
    "query": "你好",
    "response_mode": "streaming",
    "conversation_id": "",
    "user": "user-001"
  }'
Beispiel für API-Aufruf einer Workflow-Anwendung:
# 调用 Workflow API(阻塞模式)
curl -X POST 'https://api.dify.ai/v1/workflows/run' \
  -H 'Authorization: Bearer {API_KEY}' \
  -H 'Content-Type: application/json' \
  -d '{
    "inputs": {"your_variable": "your_value"},
    "response_mode": "blocking",
    "user": "user-001"
  }'
Das API-Key-Format beginnt mit app-. Stellen Sie sicher, dass Sie ihn im Request-Header als Authorization: Bearer übergeben, nicht als Query-Parameter. Jeder API-Key gehört zu genau einer bestimmten Anwendung, und Keys verschiedener Anwendungen sind nicht austauschbar.
Webseiten-Einbettung
Wählen Sie auf der Anwendungsseite Übersicht aus, klicken Sie auf Eingebettet, und es werden drei Einbettungsmethoden angeboten:
Methode 1: iframe-Einbettung
Beispiel
<iframe
src="https://udify.app/chatbot/xxxxxxxx"
style="width: 100%; height: 100%; min-height: 700px"
frameborder="0"
allow="microphone">
</iframe>
Methode 2: Bubble-Button (schwebt in der unteren rechten Ecke der Webseite)
Beispiel
<script>
window.difyChatbotConfig = { token: 'xxxxxxxx' }
</script>
<script
src="https://udify.app/embed.min.js"
id="xxxxxxxx"
defer>
</script>
Methode 3: Vollbild-Webseite, unabhängig aufgerufen, teilen Sie den Link direkt: https://udify.app/chat/xxxxxxxx.
Als MCP-Server veröffentlichen
Dify unterstützt das Veröffentlichen erstellter Workflows oder Agents als standardmäßige MCP-Server, mit Unterstützung für Vorautorisierung und Modi ohne Authentifizierung.
Das bedeutet: Die Wissensdatenbank-Q&A-Anwendung, die Sie in Dify erstellen, kann direkt zu einem Tool-Knoten für KI-Programmierwerkzeuge wie Claude Code, Cursor, omp usw. werden und nahtlos in den Entwicklungsworkflow integriert werden.
Vorgehensweise: Wählen Sie in der Anwendung Veröffentlichen aus und klicken Sie auf MCP-Server.
Beobachtbarkeit: Monitoring und kontinuierliche Optimierung
Überwachen und optimieren Sie die Leistung von KI-Anwendungen kontinuierlich durch Protokolle, Anmerkungen, Statistiken und die Integration externer Plattformen.
Anwendungsprotokolle anzeigen
Wählen Sie auf der Anwendungsseite Protokolle aus, um die vollständige Eingabe/Ausgabe jeder Konversation, die Token-Nutzung (Eingabe und Ausgabe getrennt gezählt), die Antwortzeit, das Modell und Parameterinformationen anzuzeigen.
Konversationen annotieren
Klicken Sie in den Protokollen auf eine bestimmte Konversation und dann neben der Antwort auf die Schaltfläche „Gefällt mir“ oder „Gefällt mir nicht“, um eine ideale Antwort als Anmerkung hinzuzufügen.
Verwendungszwecke von Annotationsdaten sind: Aufbau von Fine-Tuning-Datensätzen aus Anmerkungen, Identifizierung von Abdeckungslücken in der Wissensdatenbank und Erkennung häufig auftretender Fehlertypen.
Anwendungsdatenstatistiken
Wählen Sie auf der Anwendungsseite Übersicht aus und klicken Sie auf Analytics, um Folgendes anzuzeigen:
| Statistisches Element | Beschreibung |
|---|---|
| Trend der Konversationsanzahl | Tägliche/wöchentliche/monatliche Änderungen des Konversationsvolumens |
| Durchschnittlicher Token-Verbrauch | Durchschnittliche Token-Nutzung pro Konversation |
| Bewertung der Nutzerzufriedenheit | Statistiken zur Verteilung von Gefällt mir/Gefällt mir nicht |
| Anzahl aktiver Nutzer | Anzahl eindeutiger Nutzer, die die Anwendung verwenden |
Externe Observability-Plattformen integrieren
Dify unterstützt Observability-Plattformen wie Opik, Langfuse und Arize Phoenix.
Am Beispiel von Langfuse: Wählen Sie in den Einstellungen Monitoring aus, wählen Sie Langfuse, geben Sie den Public Key und den Secret Key ein und speichern Sie. Danach wird die Aufrufkette aller Anwendungen automatisch mit Langfuse synchronisiert, wo Sie vollständiges Span-Tracing und Details zu Token-Kosten einsehen können.
Kontinuierlicher Optimierungszyklus
Es wird empfohlen, den folgenden kontinuierlichen Optimierungsprozess zu etablieren:
部署上线
  ↓
收集对话日志(1-2 周)
  ↓
分析差评对话:哪些问题回答得不好?
  ↓
改进知识库(补充文档、调整分块)或优化 Prompt
  ↓
A/B 测试:对比改进前后的效果
  ↓
再次部署
Preise und Pläne.
Verstehen Sie die Kostenstrukturen von Dify Cloud und Self-Hosting und wählen Sie die Option, die am besten zu Ihnen passt.
Dify-Cloud-Plan
| Plan | Monatliche Gebühr | Beschreibung |
|---|---|---|
| Sandbox | Kostenlos | 200 Nachrichten/Monat, 5 Apps, geeignet für Testszenarien |
| Professional | $59/Monat | 5,000 Nachrichten/Monat, 50 Apps, unterstützt Teamzusammenarbeit |
| Team | $159/Monat | 10,000 Nachrichten/Monat, unbegrenzte Apps, vorrangiger Support |
| Enterprise | Individuell | Unbegrenzte Nutzung, Option für Private Deployment, SLA-Garantie |
Self-Hosting-Kosten.
Die selbst gehostete Community Edition ist völlig kostenlos und ohne Nutzungsbeschränkungen.
Sie zahlen nur für das Server-Hosting (ein VPS kostet etwa $5-50/Monat) und die API-Aufrufgebühren für KI-Modelle.
Kostenschätzung (selbst gehostet, 10,000 Konversationen/Monat):
| Komponente | Geschätzte Kosten |
|---|---|
| VPS (4 Kerne, 8 GB) | $20-40/Monat |
| Claude Sonnet 4.6 (etwa 1K Token pro Konversation) | ~$30/Monat |
| Embedding(text-embedding-3-small) | ~$2/Monat |
| Gesamt | ~$52-72/Monat |
Im Vergleich zu Dify Cloud Professional ($59/Monat, zzgl. Modell-API-Gebühren) ist Self-Hosting bei intensiver Nutzung in der Regel wirtschaftlicher.
Tipps zur Kostensenkung
| Tipp | Beschreibung |
|---|---|
| Wissensdatenbanken im Economy-Modus indexieren | Wenn die vorhandene Keyword-Suche ausreicht, ist keine Vektorisierung erforderlich |
| Das passende Modell wählen | Verwenden Sie GPT-4o-mini oder Gemini Flash für einfache Q&A und Flaggschiff-Modelle für komplexe Aufgaben |
| Ein Token-Limit festlegen | Legen Sie max_tokens im LLM-Knoten fest, um übermäßig lange einzelne Aufrufe zu verhindern |
| Caching aktivieren | Ähnliche Fragen verwenden automatisch die vorherige Antwort erneut (Prompt-Cache) |
Häufige Probleme und Fehlerbehebung
Behandelt Fehlerbehebungsmethoden für vier Hauptkategorien häufiger Probleme: Startvorgang, Wissensdatenbank-Abruf, API-Aufrufe und Workflows.
Startproblem
Problem: Dienste nach docker compose up -d unhealthy
Beispiel
docker compose logs api
# Logs des worker-Containers anzeigen
docker compose logs worker
# Prüfen, ob ausreichend Arbeitsspeicher vorhanden ist (mindestens 4 GB erforderlich)
free -h
# Prüfen, ob der Port belegt ist (80 oder 443)
sudo lsof -i :80
Problem: Beim Zugriff auf http://localhost wird 502 Bad Gateway angezeigt
Beispiel
docker compose ps
Nachdem bestätigt wurde, dass api, web und worker alle healthy sind, greifen Sie erneut zu.
Probleme beim Abruf aus der Wissensdatenbank
Frage: Relevanter Inhalt kann in der Wissensdatenbank nicht gefunden werden.
Schritte zur Fehlerbehebung:
- Klicken Sie in der Wissensdatenbank auf Retrieval Testing, testen Sie bestimmte Fragen und bestätigen Sie, ob sie abgerufen werden können.
- Wenn nichts abgerufen wird: Senken Sie den Ähnlichkeitsschwellenwert (von 0.6 auf 0.3) und testen Sie, ob es Ergebnisse gibt.
- Wenn immer noch kein Ergebnis vorliegt: Bestätigen Sie, dass die Konfiguration des Embedding-Modells korrekt ist und ob der Wissensdatenbank-Index abgeschlossen wurde.
- Wenn Ergebnisse vorhanden sind, aber der Inhalt falsch ist: Überprüfen Sie die Dokument-Chunking-Strategie und erwägen Sie, große Dateien manuell aufzuteilen.
Problem: RAG liefert irrelevanten Inhalt zurück.
Überprüfen Sie den abgerufenen Chunk-Inhalt. Wenn der Chunk irrelevant ist, verringern Sie die Chunk-Größe und erhöhen Sie den Score-Schwellenwert. Wenn kein Chunk zurückgegeben wird, ist der Schwellenwert möglicherweise zu hoch eingestellt; senken Sie ihn vorübergehend auf 0.3 und testen Sie erneut. Bestätigen Sie außerdem, dass die Wissensdatenbank im Orchestrierungsbereich der Anwendung verknüpft wurde.
Probleme bei API-Aufrufen
Problem: API gibt 401 Unauthorized zurück
Überprüfen Sie das API Key-Format — Dify-Anwendungs-API-Keys beginnen mit app-. Stellen Sie sicher, dass er im Request-Header als Authorization: Bearer übergeben wird, nicht als Query-Parameter. Bestätigen Sie außerdem, dass dieser API Key zur richtigen Anwendung gehört — Keys sind auf Anwendungsebene, und Keys für verschiedene Anwendungen sind nicht austauschbar.
Frage: Streaming-Antwort wurde mittendrin abgeschnitten.
Dies ist normalerweise ein Timeout-Problem. Überprüfen Sie die Timeout-Einstellungen des Reverse-Proxys — Nginx verwendet standardmäßig 60 Sekunden, was für komplexe Workflows möglicherweise nicht ausreicht.
# nginx.conf 中增加超时配置,确保长时间运行的工作流不被中断
proxy_read_timeout 300s;
proxy_connect_timeout 300s;
proxy_send_timeout 300s;
Workflow-Probleme.
Problem: Ein Knoten im Workflow hat einen Fehler gemeldet.
Schritte zur Fehlerbehebung:
- Öffnen Sie das Debug-Panel, um die Eingabe/Ausgabe des Knotens anzuzeigen, der den Fehler gemeldet hat.
- Klicken Sie auf die rote Markierung neben dem Knoten, um detaillierte Fehlerinformationen anzuzeigen.
- Häufige Ursache: falscher Variablenreferenzpfad (überprüfen Sie die Schreibweise von {{node name.variable name}})
Ressourcen
Empfohlene Lernpfade und verwandte Ressourcen, die Ihnen helfen, vom Anfänger zum Profi zu werden.
Empfohlener Lernpfad
注册 Dify Cloud,用 Sandbox 体验
    ↓
配置自己的模型提供商(Anthropic oder  OpenAI)
    ↓
创建第一个知识库,上传 5-10 个文档,测试检索效果
    ↓
创建 Chatbot 应用,关联知识库,完成场景实战一
    ↓
学习 Workflow,完成场景实战二(内容生成流水线)
    ↓
探索 Human Input 节点,完成场景实战三(客服 Agent)
    ↓
用 Docker Compose 搭建本地/服务器自托管版本
    ↓
通过 API 将 Dify 应用集成到现有系统
    ↓
探索 MCP Server 发布,接入 AI 编程工具生态
Offizielle Ressourcen
| Ressourcen | Link | Erklärung |
|---|---|---|
| Offizielle Website | dify.ai | Produktinformationen und Registrierungseinstieg |
| Dokumentation | docs.dify.ai | Vollständige Dokumentation zur Produktnutzung |
| GitHub | github.com/langgenius/dify | Apache 2.0 Open Source, Sie können den Quellcode einsehen und Issues einreichen |
| Discord-Community | discord.gg/FngNHpbcY7 | Kommunizieren Sie mit Community-Mitgliedern und dem offiziellen Team |
| Vorlagen-Marktplatz | In-App-Vorlagen | Verwenden Sie direkt von der Community geteilte Workflow-Vorlagen |
| Dify-Blog | dify.ai/blog | Funktionsupdates und Anwendungsfälle |
| FAQ zur Wissensdatenbank | docs.dify.ai/faq | Offizielle Antworten auf häufige Fragen |