Веб-скрейпинг на Python - BeautifulSoup
Веб-скрейпинг на Python — это процесс автоматического извлечения информации из интернета путём написания программ на Python.
Базовый процесс веб-скрейпинга обычно включает отправку HTTP-запросов для получения содержимого веб-страниц, разбор веб-страниц и извлечение данных, а затем сохранение данных.
Богатая экосистема Python делает его популярным языком для разработки веб-скраперов, особенно благодаря мощной поддержке библиотек.
Вообще говоря, процесс веб-скрейпинга можно разделить на следующие шаги:
- Отправка HTTP-запросов: Скрапер получает HTML-страницы с целевого веб-сайта через HTTP-запросы. Обычно используемые библиотеки включают
requests。 - Разбор HTML-содержимого: После получения HTML-страницы скраперу необходимо разобрать содержимое и извлечь данные. Распространённые библиотеки включают
BeautifulSoup、lxml、Scrapy, и т. д. - Извлечение данных: Извлеките необходимые данные, находя HTML-элементы (такие как теги, атрибуты, имена классов и т. д.).
- Сохранение данных: Сохраняйте извлечённые данные в таких форматах, как базы данных, CSV-файлы и JSON-файлы, для дальнейшего использования или анализа.
В этой главе в основном представлена BeautifulSoup — библиотека Python для разбора HTML- и XML-документов. Она может извлекать данные с веб-страниц и обычно используется для веб-скрапинга и интеллектуального анализа данных.
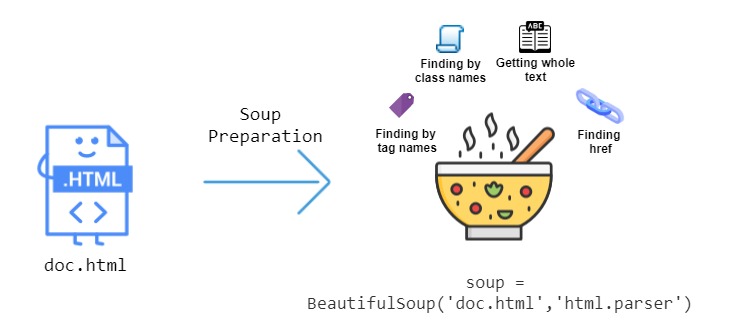
BeautifulSoup
BeautifulSoup — это библиотека Python для извлечения данных с веб-страниц, особенно подходящая для разбора HTML- и XML-файлов.
BeautifulSoup может извлекать и обрабатывать содержимое веб-страниц, предоставляя простой API, что делает её очень подходящей для задач веб-скрапинга и извлечения данных.
Установка BeautifulSoup
Чтобы использовать BeautifulSoup, необходимо установить beautifulsoup4 и lxml или html.parser (парсер HTML).
Мы можем использовать pip для установки этих зависимостей:
pip install beautifulsoup4
pip install lxml  # 推荐使用 lxml 作为解析器(速度更快)
Если у вас нет lxml, вы можете использовать встроенный в Python html.parser в качестве парсера.
Базовое использование
BeautifulSoup используется для разбора данных HTML или XML и предоставляет методы для навигации, поиска и изменения дерева разбора.
К распространённым операциям BeautifulSoup относятся поиск тегов, получение атрибутов тегов, извлечение текста и т. д.
Чтобы использовать BeautifulSoup, нужно сначала импортировать BeautifulSoup и загрузить HTML-страницу в объект BeautifulSoup.
Обычно вы сначала используете библиотеку для веб-скрейпинга (например,requests), чтобы получить содержимое веб-страницы:
Пример
import requests
# Использовать requests для получения содержимого веб-страницы
url = 'https://cn.bing.com/' # Собрать содержимое веб-страницы поисковой системы Bing
response = requests.get(url)
# Использовать BeautifulSoup для разбора веб-страницы
soup = BeautifulSoup(response.text, 'lxml') # Использовать парсер lxml
# Разобрать содержимое веб-страницы с помощью парсера html.parser
# soup = BeautifulSoup(response.text, 'html.parser')
Получить заголовок веб-страницы:
Пример
import requests
# Укажите сайт, заголовок которого вы хотите получить
url = 'https://cn.bing.com/' # Собрать содержимое веб-страницы поисковой системы Bing
# Отправьте HTTP-запрос, чтобы получить содержимое веб-страницы
response = requests.get(url)
# Проблема с искажённым китайским текстом
response.encoding = 'utf-8'
# Убедитесь, что запрос выполнен успешно
if response.status_code == 200:
# Используйте BeautifulSoup для разбора содержимого веб-страницы
soup = BeautifulSoup(response.text, 'lxml')
# Найдите тег <title>
title_tag = soup.find('title')
# Выведите текст заголовка
if title_tag:
print(title_tag.get_text())
else:
print("Тег <title> не найден")
else:
print("Запрос не выполнен, код состояния:", response.status_code)
После выполнения приведённого выше кода выводится заголовок:
搜索 - Microsoft 必应
Проблема с искажённым китайским текстом
При использовании библиотеки requests для парсинга китайских веб-страниц могут возникать проблемы с кодировкой, из-за чего китайский контент отображается неправильно. Чтобы гарантировать правильный парсинг и отображение китайских веб-страниц, обычно необходимо обрабатывать кодировку символов веб-страницы.
Автоматическое определение кодировки: requests обычно автоматически определяет кодировку веб-страницы на основе Content-Type в заголовках ответа, но иногда это может быть неточно. В таких случаях можно использовать chardet для автоматического определения кодировки.
Пример
url = 'https://cn.bing.com/'
response = requests.get(url)
# Использовать chardet для автоматического определения кодировки
import chardet
encoding = chardet.detect(response.content)['encoding']
print(encoding)
response.encoding = encoding
После запуска приведённого выше кода вывод будет следующим:
utf-8
Если вы знаете кодировку веб-страницы (например, utf-8 или gbk), вы можете напрямую задатьresponse.encoding:
response.encoding = 'utf-8' # 或者 'gbk',根据实际情况选择
Поиск тегов
BeautifulSoup предоставляет несколько методов для поиска тегов на веб-странице. Наиболее часто используемые включаютfind()иfind_all()。
find()Возвращает первый соответствующий тегfind_all()Возвращает все соответствующие теги
Пример
import requests
# Укажите сайт, заголовок которого вы хотите получить
url = 'https://www.baidu.com/' # Собрать содержимое веб-страницы поисковой системы Bing
# Отправьте HTTP-запрос, чтобы получить содержимое веб-страницы
response = requests.get(url)
# Проблема с искажённым китайским текстом
response.encoding = 'utf-8'
soup = BeautifulSoup(response.text, 'lxml')
# Найти первый тег <a>
first_link = soup.find('a')
print(first_link)
print("----------------------------")
# Получить атрибут href первого тега <a>
first_link_url = first_link.get('href')
print(first_link_url)
print("----------------------------")
# Найти все теги <a>
all_links = soup.find_all('a')
print(all_links)
Результат вывода аналогичен следующему:
<a class="mnav" href="http://news.baidu.com" name="tj_trnews">新闻</a>
----------------------------
http://news.baidu.com
----------------------------
[<a class="mnav" href="http://news.baidu.com" name="tj_trnews">新闻</a>, <a class="mnav" href="https://www.hao123.com" name="tj_trhao123">hao123</a>, <a class="mnav" href="http://map.baidu.com" name="tj_trmap">地图</a>, <a class="mnav" href="http://v.baidu.com" name="tj_trvideo">视频</a>,
Получение текста тега
С помощьюget_text()метода можно извлечь текстовое содержимое внутри тега:
Пример
import requests
# Укажите сайт, заголовок которого вы хотите получить
url = 'https://www.baidu.com/' # Собрать содержимое веб-страницы поисковой системы Bing
# Отправьте HTTP-запрос, чтобы получить содержимое веб-страницы
response = requests.get(url)
# Проблема с искажённым китайским текстом
response.encoding = 'utf-8'
soup = BeautifulSoup(response.text, 'lxml')
# Получить текстовое содержимое первого тега <p>
paragraph_text = soup.find('p').get_text()
# Получить всё текстовое содержимое на странице
all_text = soup.get_text()
print(all_text)
Результат вывода аналогичен следующему:
Baidu it, and you'll know.
Поиск дочерних и родительских тегов
Вы можете использоватьparentиchildrenсвойства, чтобы получить доступ к родительскому и дочерним тегам:# 获取当前标签的父标签 parent_tag = first_link.parent # 获取当前标签的所有子标签 children = first_link.children
Пример
import requests
# Укажите сайт, заголовок которого вы хотите получить
url = 'https://www.baidu.com/' # Собрать содержимое веб-страницы поисковой системы Bing
# Отправьте HTTP-запрос, чтобы получить содержимое веб-страницы
response = requests.get(url)
# Проблема с искажённым китайским текстом
response.encoding = 'utf-8'
soup = BeautifulSoup(response.text, 'lxml')
# Найти первый тег <a>
first_link = soup.find('a')
print(first_link)
print("----------------------------")
# Получить родительский тег текущего тега
parent_tag = first_link.parent
print(parent_tag.get_text())
Результат вывода аналогичен следующему:
<a class="mnav" href="http://news.baidu.com" name="tj_trnews">新闻</a>
----------------------------
 新闻 hao123 地图 视频 贴吧  登录   更多产品
Поиск тегов с определёнными атрибутами
Вы можете находить теги с определёнными атрибутами, передавая параметры атрибутов.
Например, найти все теги div с именем класса example-class:
# 查找所有 class="example-class" 的 <div> 标签
divs_with_class = soup.find_all('div', class_='example-class')

# 查找具有 id="unique-id" 的 <p> 标签
unique_paragraph = soup.find('p', id='unique-id')
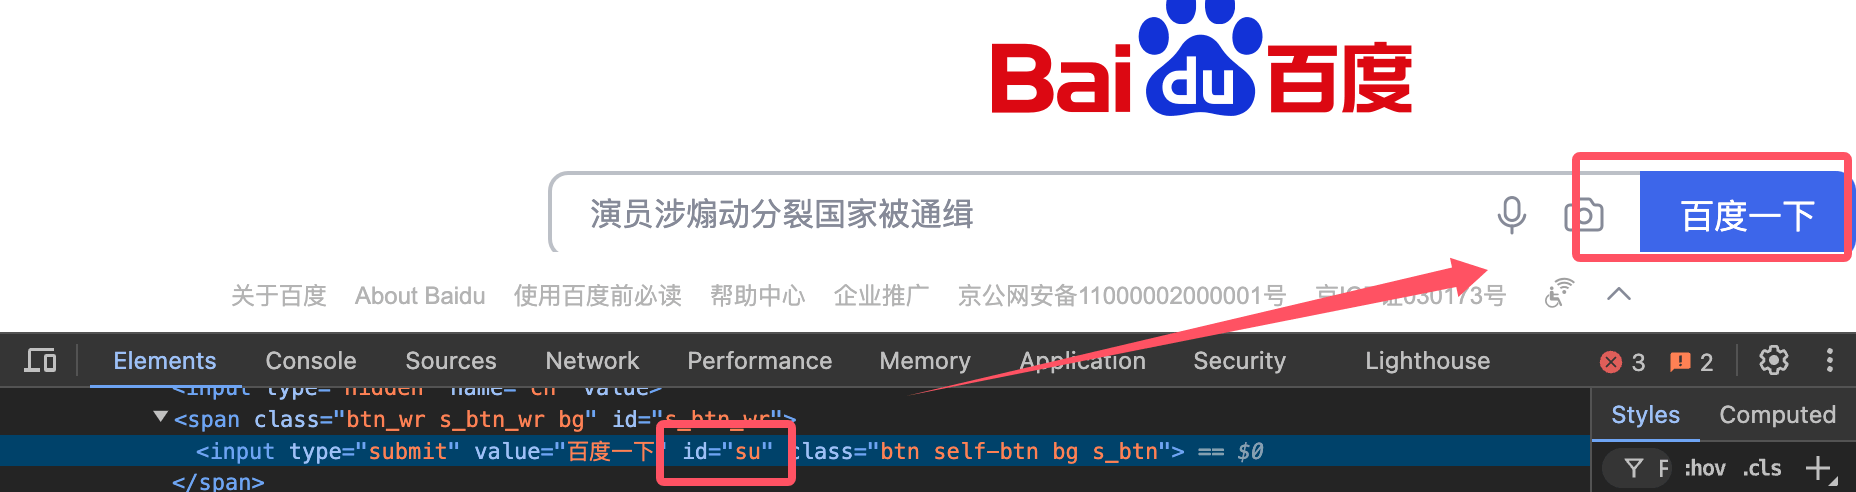
Получить кнопку поиска с id su:
Пример
import requests
# Укажите сайт, заголовок которого вы хотите получить
url = 'https://www.baidu.com/' # Собрать содержимое веб-страницы поисковой системы Bing
# Отправьте HTTP-запрос, чтобы получить содержимое веб-страницы
response = requests.get(url)
# Проблема с искажённым китайским текстом
response.encoding = 'utf-8'
soup = BeautifulSoup(response.text, 'lxml')
# Найти тег <input> с id="unique-id"
unique_input = soup.find('input', id='su')
input_value = unique_input['value'] # Получить значение поля ввода
print(input_value)
Результат вывода:
Baidu it.
Продвинутое использование
Селекторы CSS
BeautifulSoup также поддерживает поиск тегов с помощью CSS-селекторов.
Метод select() позволяет использовать синтаксис селекторов в стиле jQuery для поиска тегов:
# 使用 CSS 选择器查找所有 class 为 'example' 的 <div> 标签
example_divs = soup.select('div.example')

# 查找所有 <a> 标签中的 href 属性
links = soup.select('a[href]')
Обработка вложенных тегов
BeautifulSoup поддерживает глубоко вложенные структуры HTML. Вы можете обрабатывать такие структуры, рекурсивно находя дочерние теги:
# 查找嵌套的 <div> 标签
nested_divs = soup.find_all('div', class_='nested')
for div in nested_divs:
    print(div.get_text())
Изменение содержимого веб-страницы
BeautifulSoup позволяет изменять содержимое HTML.
Мы можем изменять атрибуты и текст тегов или удалять теги:
Пример
first_link['href'] = 'http://new-url.com'
# Изменить текстовое содержимое первого тега <p>
first_paragraph = soup.find('p')
first_paragraph.string = 'Updated content'
# Удалить тег
first_paragraph.decompose()
Преобразование в строку
Вы можете преобразовать разобранный объект BeautifulSoup обратно в строку HTML:
# 转换为字符串
html_str = str(soup)
Атрибуты и методы BeautifulSoup
Ниже перечислены часто используемые атрибуты и методы в BeautifulSoup:
| Метод/атрибут | Описание | Пример |
|---|---|---|
BeautifulSoup() | Используется для разбора документов HTML или XML и возвращает объект BeautifulSoup. | soup = BeautifulSoup(html_doc, 'html.parser') |
.prettify() | Форматирует и делает удобочитаемым содержимое документа, создавая структурированную строку. | print(soup.prettify()) |
.find() | Находит первый подходящий тег. | tag = soup.find('a') |
.find_all() | Находит все подходящие теги и возвращает список. | tags = soup.find_all('a') |
.find_all_next() | Находит все теги, соответствующие условиям после текущего тега. | tags = soup.find('div').find_all_next('p') |
.find_all_previous() | Находит все теги, соответствующие условиям перед текущим тегом. | tags = soup.find('div').find_all_previous('p') |
.find_parent() | Возвращает родительский тег текущего тега. | parent = tag.find_parent() |
.find_all_parents() | Найти все родительские теги текущего тега. | parents = tag.find_all_parents() |
.find_next_sibling() | Найти следующий соседний тег текущего тега. | next_sibling = tag.find_next_sibling() |
.find_previous_sibling() | Найти предыдущий соседний тег текущего тега. | prev_sibling = tag.find_previous_sibling() |
.parent | Получить родительский тег текущего тега. | parent = tag.parent |
.next_sibling | Получить следующий соседний тег текущего тега. | next_sibling = tag.next_sibling |
.previous_sibling | Получить предыдущий соседний тег текущего тега. | prev_sibling = tag.previous_sibling |
.get_text() | Извлечь текстовое содержимое внутри тега, игнорируя все HTML-теги. | text = tag.get_text() |
.attrs | Вернуть все атрибуты тега в виде словаря. | href = tag.attrs['href'] |
.string | Получить строковое содержимое внутри тега. | string_content = tag.string |
.name | Вернуть имя тега. | tag_name = tag.name |
.contents | Вернуть все дочерние элементы тега в виде списка. | children = tag.contents |
.descendants | Вернуть все элементы-потомки тега в виде генератора. | for child in tag.descendants: print(child) |
.parent | Получить родительский тег текущего тега. | parent = tag.parent |
.previous_element | Получить предыдущий элемент текущего тега (исключая текст). | prev_elem = tag.previous_element |
.next_element | Получить следующий элемент текущего тега (исключая текст). | next_elem = tag.next_element |
.decompose() | Удалить текущий тег и его содержимое из дерева. | tag.decompose() |
.unwrap() | Удалить сам тег, сохранив только его дочернее содержимое. | tag.unwrap() |
.insert() | Вставить новый тег или текст в тег. | tag.insert(0, new_tag) |
.insert_before() | Вставить новый тег перед текущим тегом. | tag.insert_before(new_tag) |
.insert_after() | Вставить новый тег после текущего тега. | tag.insert_after(new_tag) |
.extract() | Удалить тег и вернуть тег. | extracted_tag = tag.extract() |
.replace_with() | Заменить текущий тег и его содержимое. | tag.replace_with(new_tag) |
.has_attr() | Проверить, есть ли у тега указанный атрибут. | if tag.has_attr('href'): |
.get() | Получить значение указанного атрибута. | href = tag.get('href') |
.clear() | Очистить всё содержимое тега. | tag.clear() |
.encode() | Закодировать содержимое тега как поток байтов. | encoded = tag.encode() |
.is_empty_element | Проверить, является ли тег пустым элементом (например,<br>、<img>и т.д.). | if tag.is_empty_element: |
.is_ancestor_of() | Проверить, является ли текущий тег предком указанного тега. | if tag.is_ancestor_of(another_tag): |
.is_descendant_of() | Проверить, является ли текущий тег потомком указанного тега. | if tag.is_descendant_of(another_tag): |
Другие атрибуты
| Метод/атрибут | Описание | Пример |
|---|---|---|
.style | Получить встроенный стиль тега. | style = tag['style'] |
.id | Получить у тегаidатрибута. | id = tag['id'] |
.class_ | Получить у тегаclassатрибута. | class_name = tag['class'] |
.string | Получить строковое содержимое внутри тега, игнорируя другие теги. | content = tag.string |
.parent | Получить родительский элемент тега. | parent = tag.parent |
Другое
| Метод/атрибут | Описание | Пример |
|---|---|---|
find_all(string) | Использовать строку для поиска подходящих тегов. | tag = soup.find_all('div', class_='container') |
find_all(id) | Найти указанныйidtag. | tag = soup.find_all(id='main') |
find_all(attrs) | Найти теги с указанными атрибутами. | tag = soup.find_all(attrs={"href": "http://example.com"}) |