Funktionsweise der KI
Sie fragen sich vielleicht: Ich möchte KI nur nutzen, warum sollte ich verstehen, wie sie funktioniert?
Der Grund ist einfach: Wenn Sie wissen, woher die Fähigkeiten der KI kommen, können Sie sie besser nutzen.
Sie wissen, wann Sie ihr vertrauen und wann Sie sie infrage stellen sollten.
-
Sie wissen, worin sie gut ist und worin nicht.
-
Sie wissen, woher Halluzinationen kommen und wie Sie ihre Auswirkungen verringern können.
Intuitives Verständnis neuronaler Netze
Der Kern moderner KI sindneuronale Netze, ein Name, der von der Neuronenstruktur des menschlichen Gehirns stammt.
Analogie zu Neuronen im Gehirn
Das menschliche Gehirn hat etwa 86 Milliarden Neuronen, die miteinander verbunden sind und Signale übertragen. Jedes Neuron empfängt Eingaben von anderen Neuronen, verarbeitet sie und gibt sie dann an andere Neuronen aus. Der Lernprozess ist der Prozess der Anpassung der Stärke dieser Verbindungen.
Künstliche neuronale Netze leihen sich diese Idee aus, vereinfachen sie jedoch stark.
Drei grundlegende Schichten
Ein typisches neuronales Netz ist in drei Schichten unterteilt: Eingabeschicht, verborgene Schicht und Ausgabeschicht.
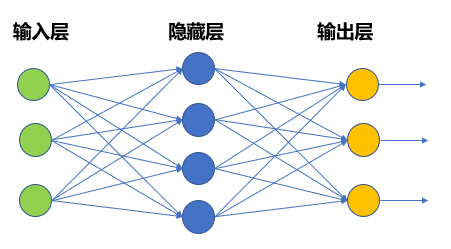
Wir verwenden das Beispiel, zu erkennen, ob ein Bild eine Katze oder ein Hund ist:
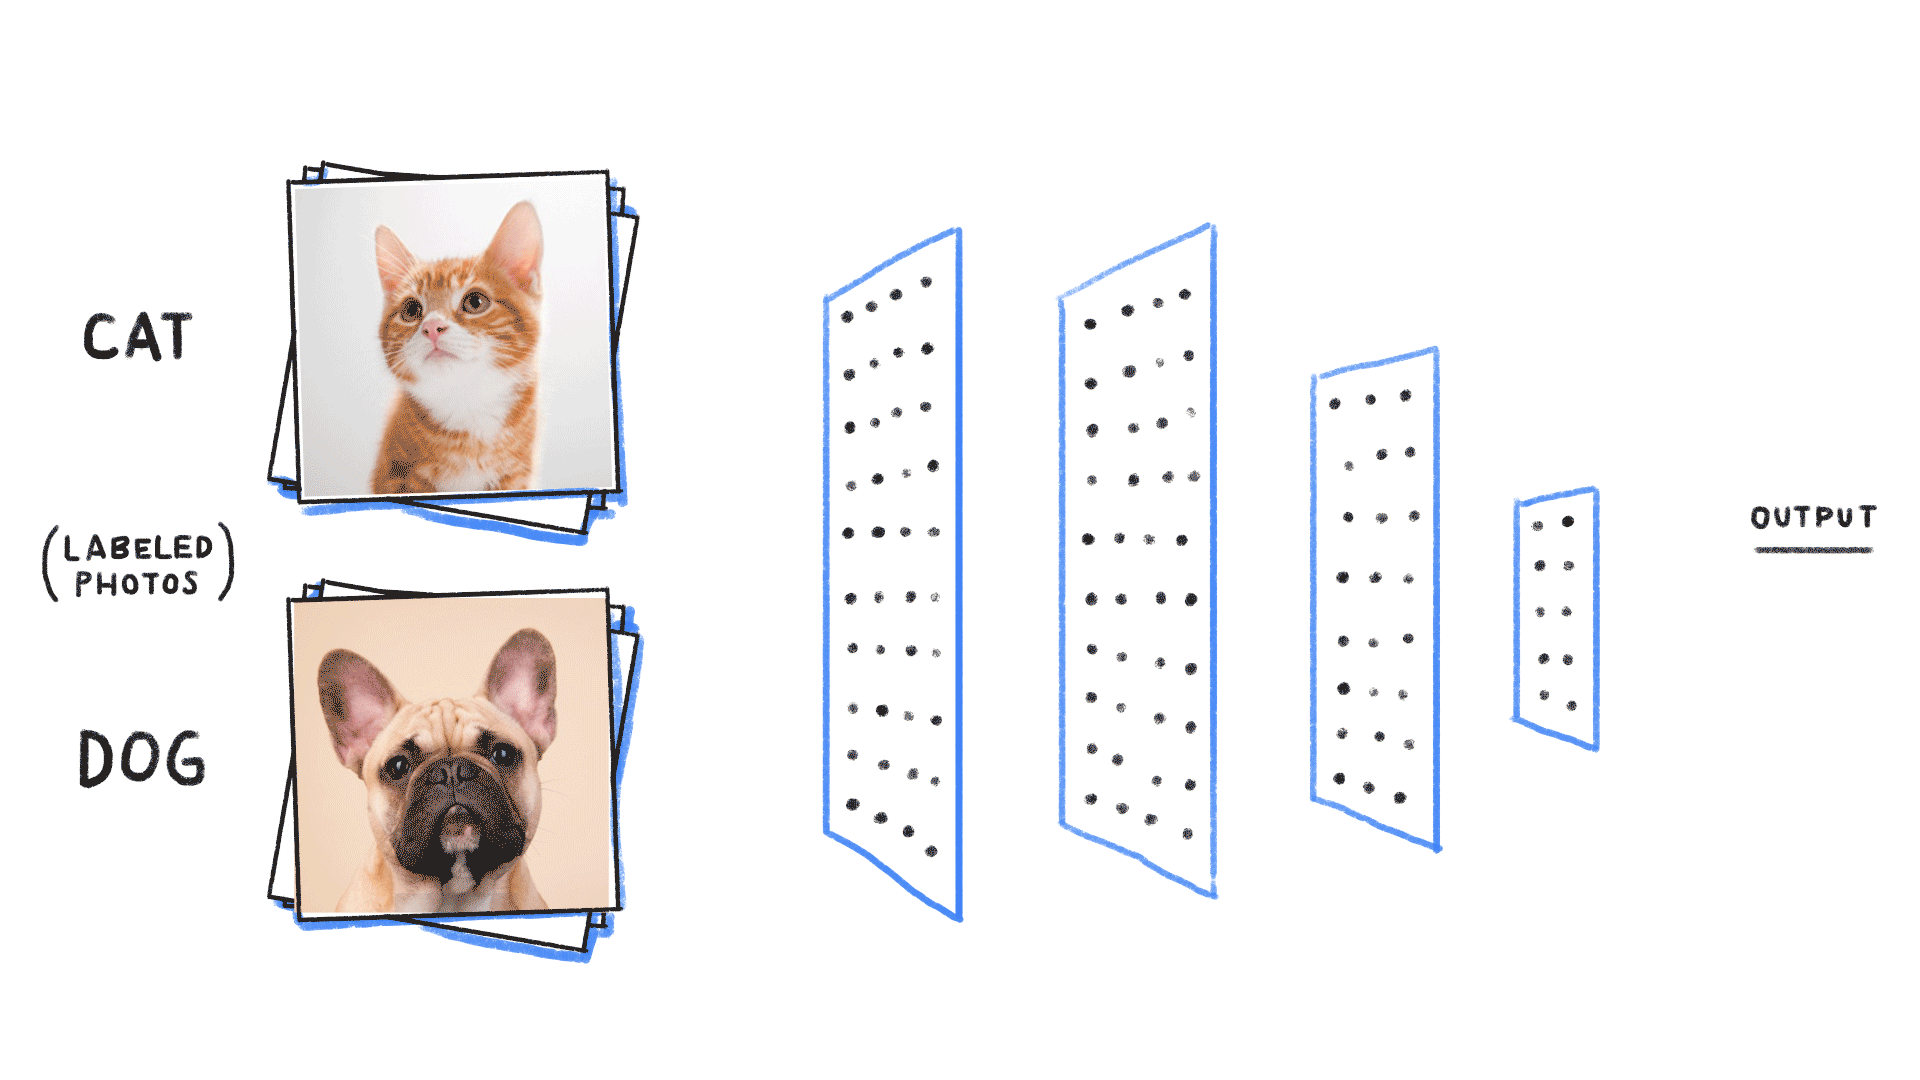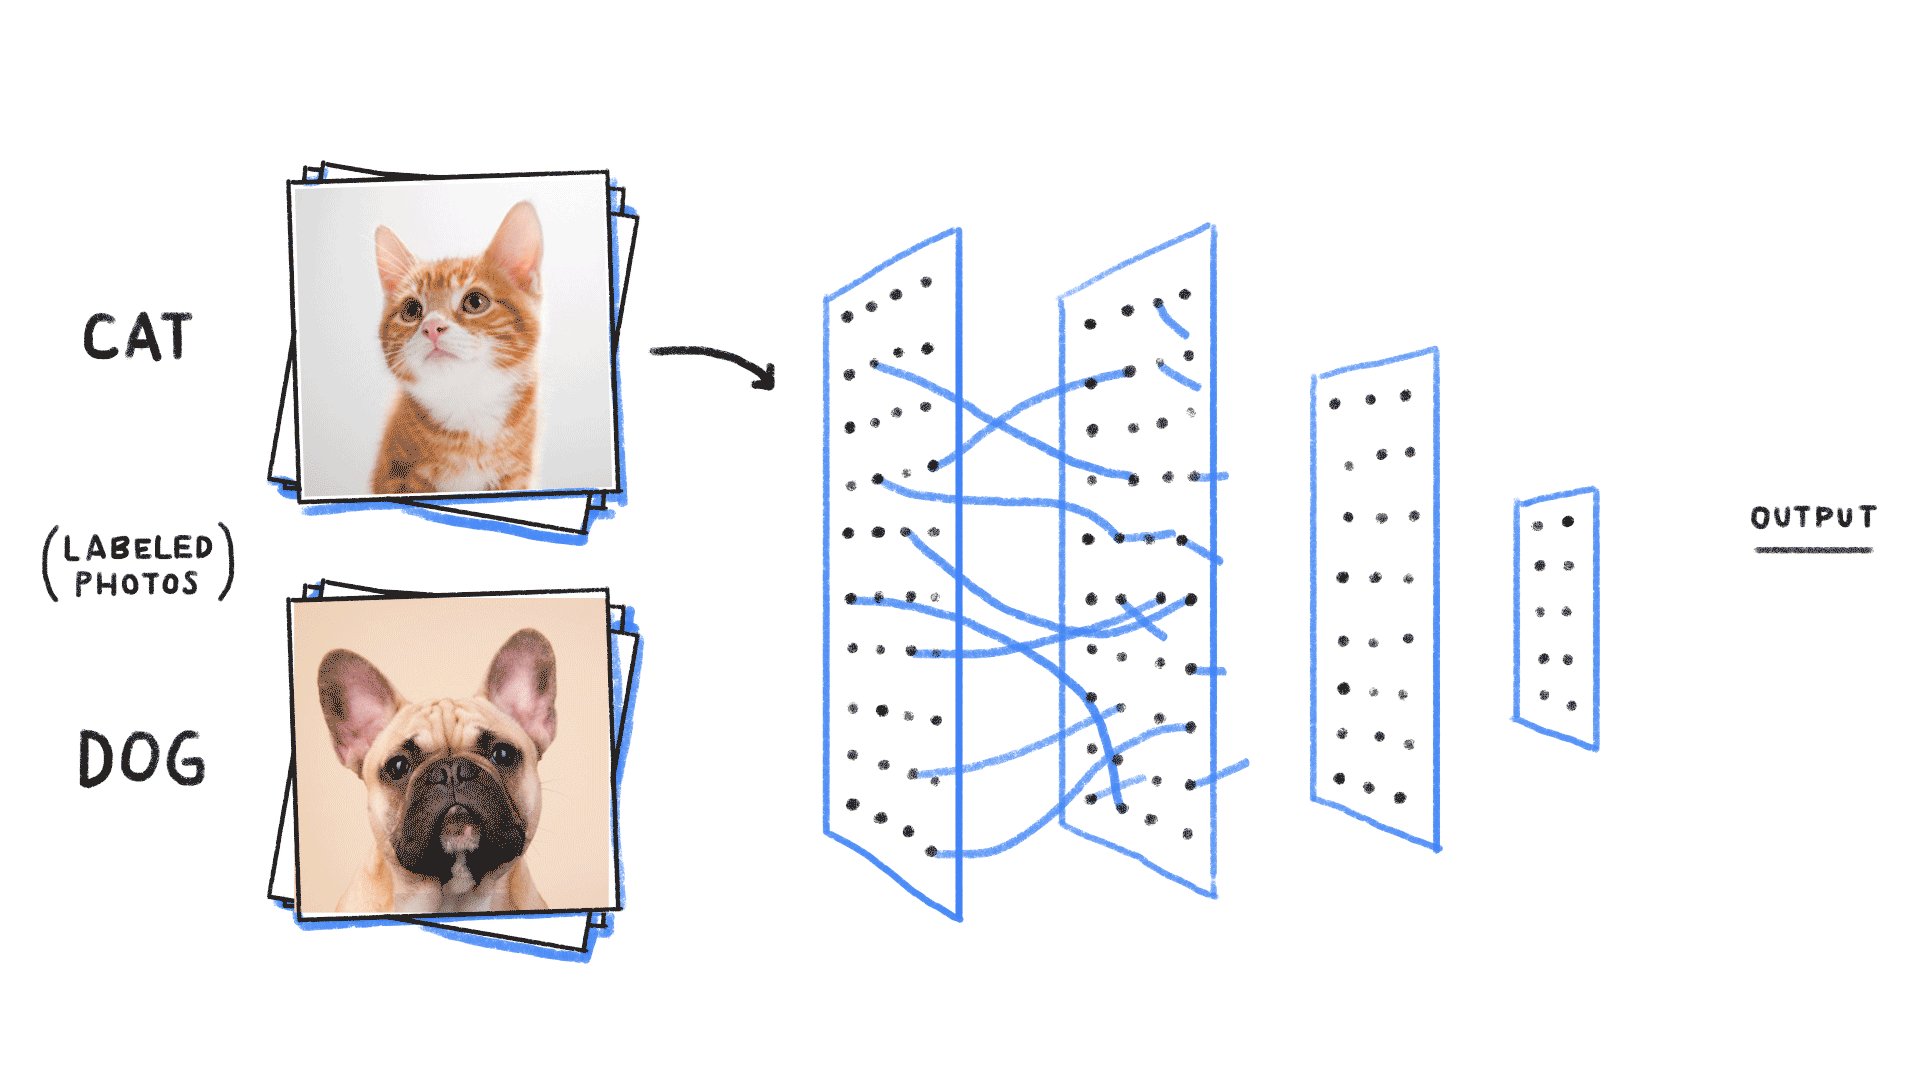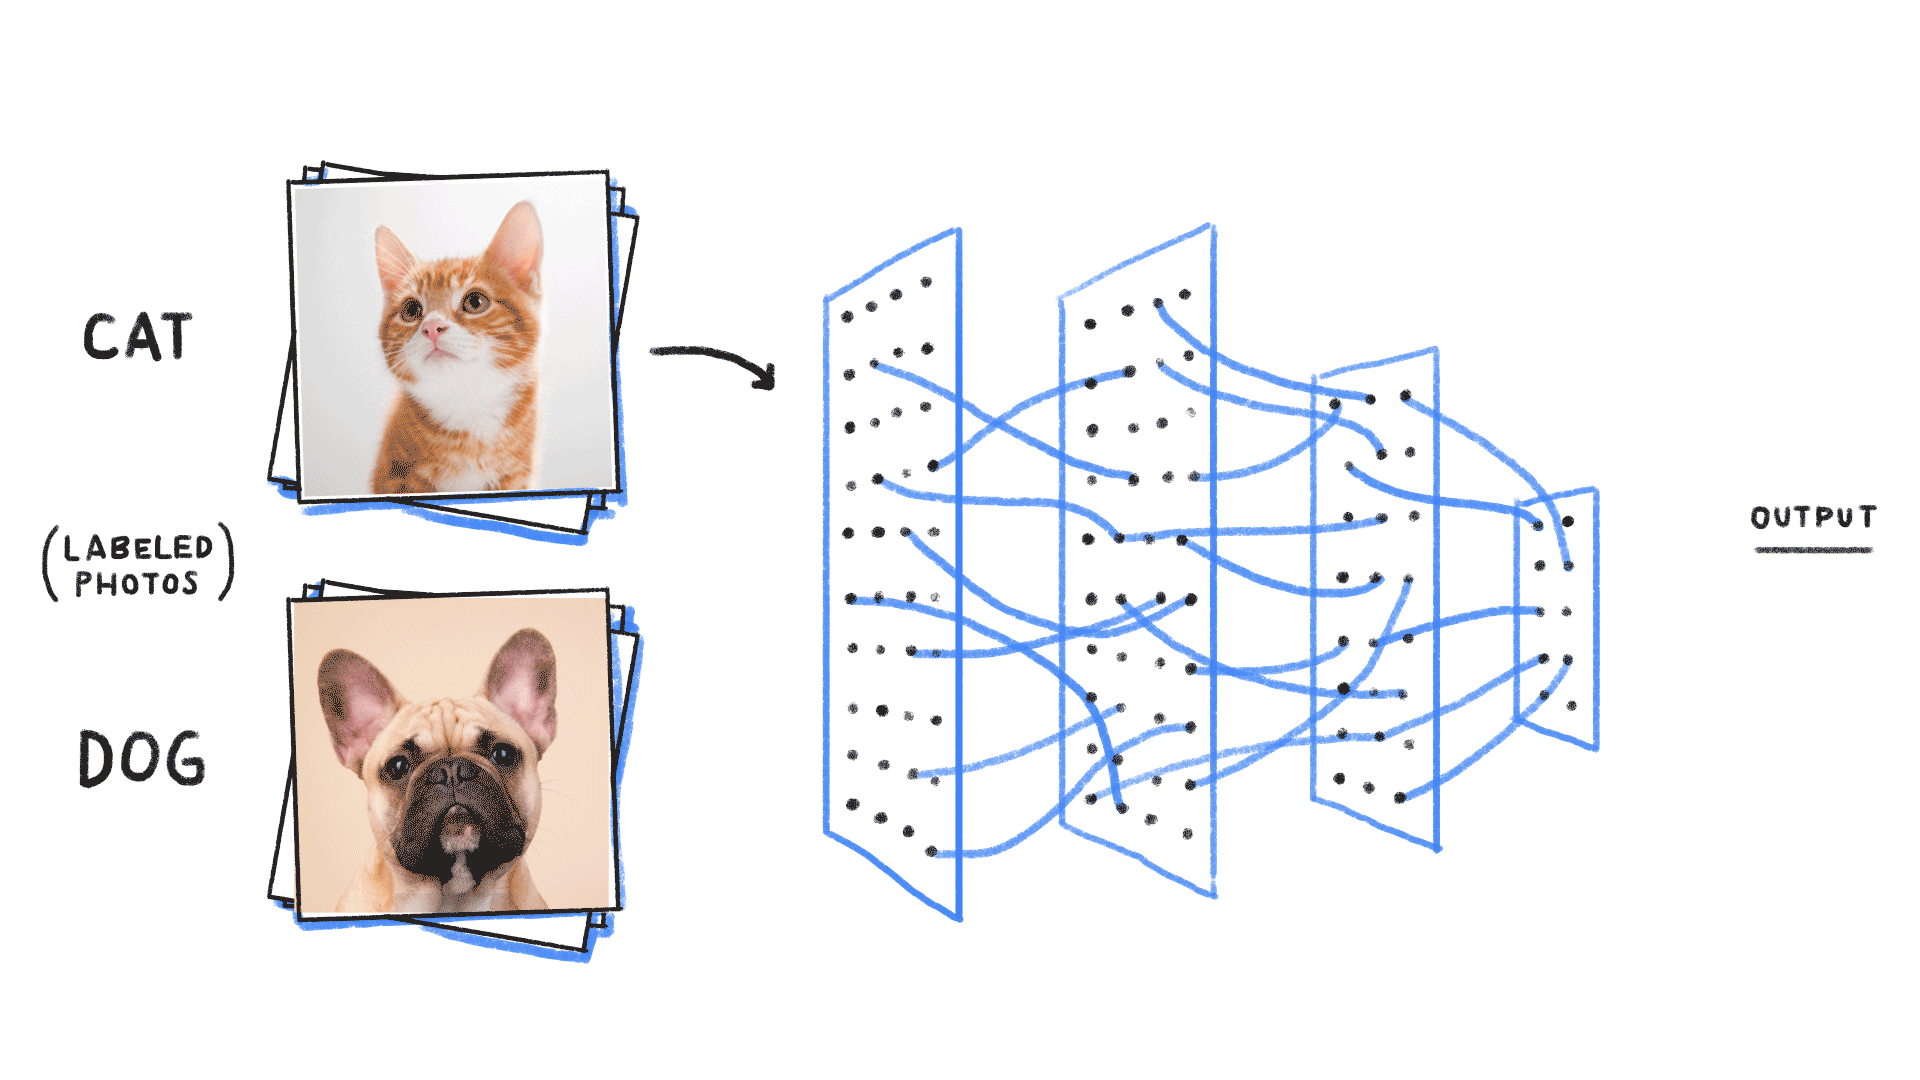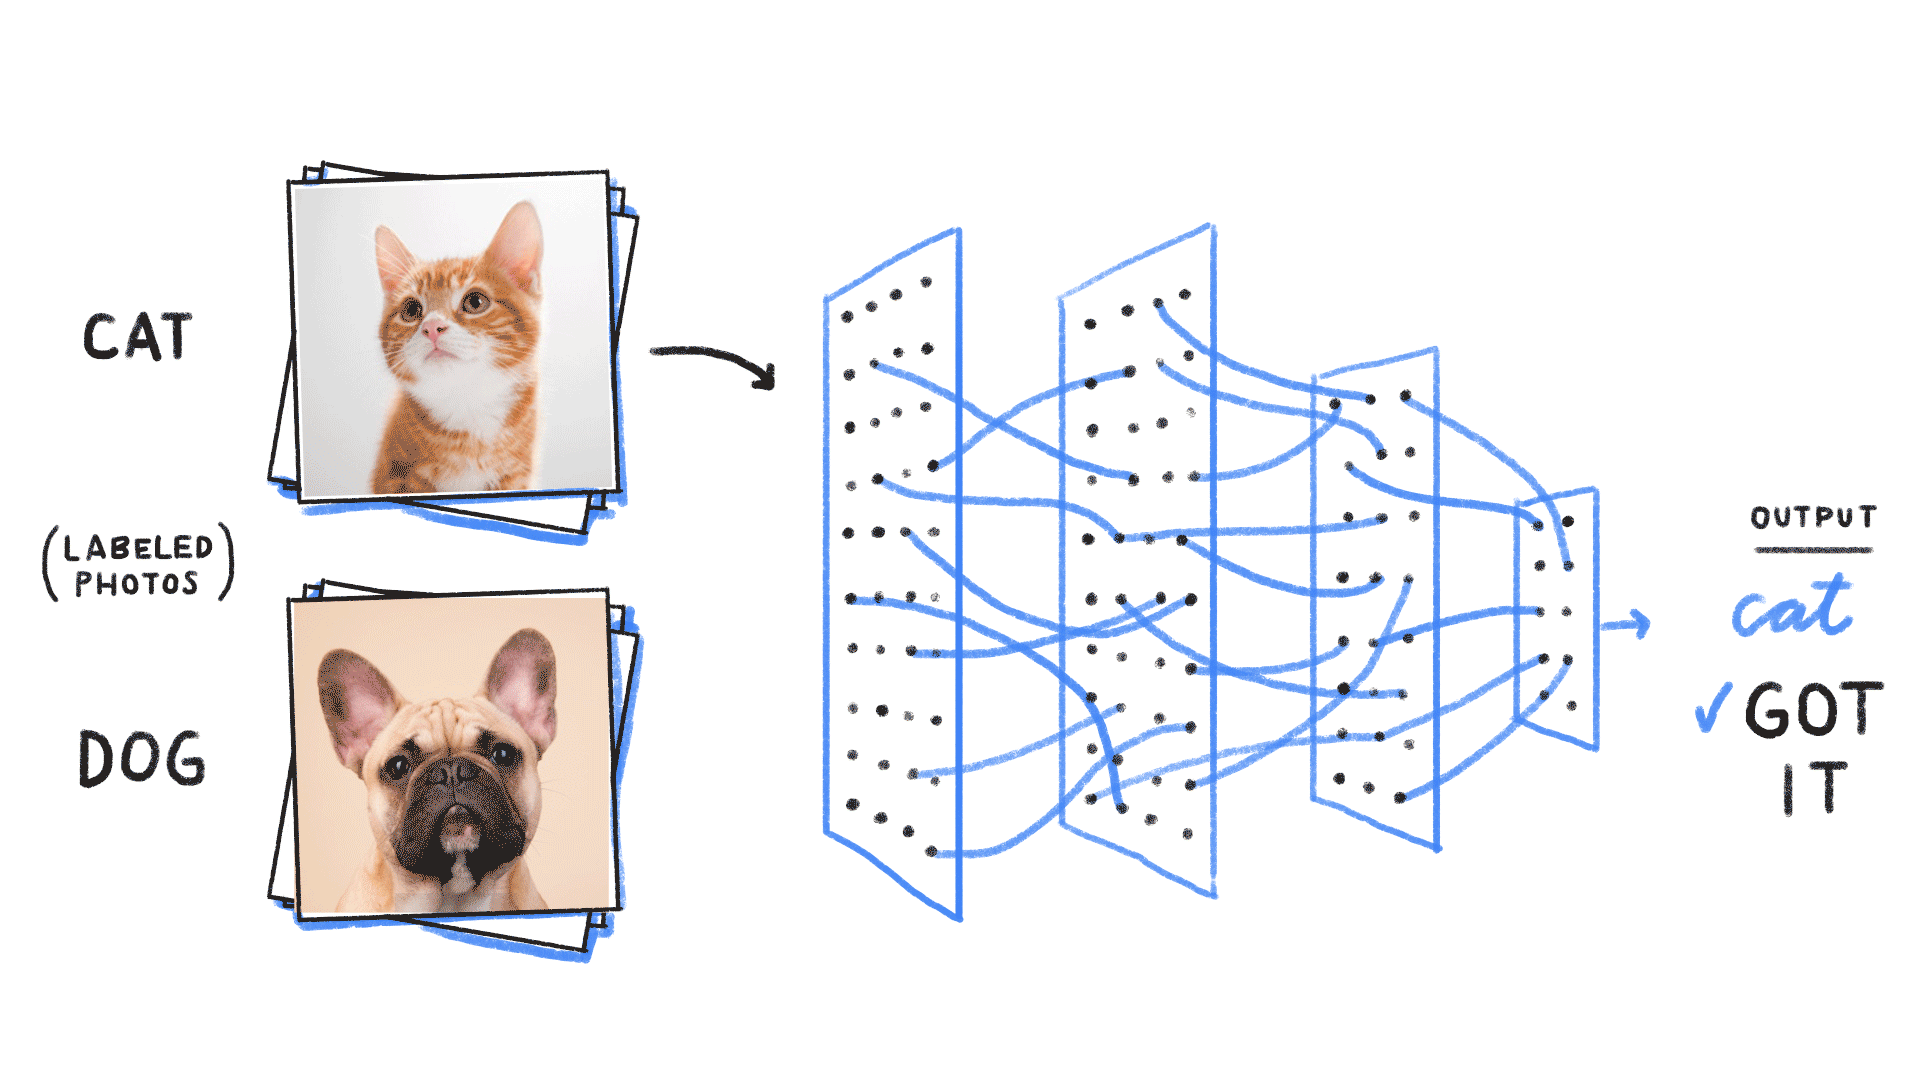
| Ebene | Funktion | In diesem Beispiel |
|---|---|---|
| Eingabeschicht | Empfängt Rohdaten | Jede Pixel- und Farbinformation des Bildes |
| Verborgene Schicht | Merkmale Schicht für Schicht extrahieren | Kanten → Texturen → Organe wie Ohren und Augen |
| Ausgabeschicht | Das Endergebnis liefern | "85% Wahrscheinlichkeit, dass es eine Katze ist", "15% Wahrscheinlichkeit, dass es ein Hund ist" |
Jede Schicht hat viele Neuronen. Jedes Neuron empfängt die Ausgabe der vorherigen Schicht, führt eine einfache Berechnung durch und gibt sie an die nächste Schicht weiter.
-
Die erste Schicht könnte erkennen: "hier ist eine vertikale Linie" oder "hier ist ein Kreis".
-
Die zweite Schicht kombiniert diese: Eine vertikale Linie plus ein Kreis könnte ein Ohr sein.
-
Die dritte Schicht kombiniert weiter: zwei spitze Ohren, Schnurrhaare, Katzenaugen – das ist sehr wahrscheinlich eine Katze.
Das Erstaunliche daran ist, dass diese Merkmale nicht von Menschen entworfen werden; das Modell lernt sie selbst aus Daten.
Das einfachste Neuron
Verwenden wir ein paar Zeilen Python-Code, um zu zeigen, was ein Neuron tut:
Beispiel
# Grundlegende Berechnungslogik eines künstlichen Neurons
# Keine komplexe Mathematik, nur gewichtete Summe + Aktivierung
# ============================================
def simple_neuron(inputs: list, weights: list, bias: float) -> float:
"""
Das einfachste Neuron
inputs: Eingabewerte (von Neuronen in der vorherigen Schicht)
weights: Gewichte (Wichtigkeit jeder Eingabe, während des Trainings gelernt)
bias: Bias (Schwellenwert, während des Trainings gelernt)
"""
# Schritt 1: Gewichtete Summe
# Multipliziere jede Eingabe mit ihrem entsprechenden Gewicht und summiere dann alle auf
weighted_sum = 0.0
for input_value, weight in zip(inputs, weights):
weighted_sum += input_value * weight
# Bias hinzufügen
weighted_sum += bias
# Schritt 2: Aktivierungsfunktion (macht die Ausgabe nichtlinear)
# Hier verwenden wir das einfachste ReLU: negative Zahlen werden 0, positive Zahlen bleiben unverändert
output = max(0.0, weighted_sum)
return output
# Simulation: ein Neuron, das bestimmt "ist das ein Katzenohr"
# Eingabe: [Spitzheit, Höhenposition, hat Fell]
inputs = [0.8, 0.9, 0.7] # Diese drei Merkmale sind alle ziemlich offensichtlich
# Gewichte: nach dem Training gelernt (im Beispiel nehmen wir an, dass diese Werte bereits gut gelernt sind)
weights = [0.5, 0.4, 0.3]
# Bias: Schwellenwert
bias = -0.6
result = simple_neuron(inputs, weights, bias)
print(f"Neuron output: {result:.3f}")
print(f"Judgment: {'likely a cat ear' if result > 0 else 'not likely'}")
# Output: Neuron output: 0.660
# Output: Judgment: likely a cat ear
Was dieses Neuron tut, ist sehr einfach: Es bildet eine gewichtete Summe der Eingaben, leitet diese durch eine Aktivierungsfunktion und gibt das Ergebnis aus.
Wenn jedoch Tausende solcher Neuronen miteinander verbunden sind und jede Schicht unterschiedliche Merkmale lernt, bringt das gesamte System eine erstaunliche Intelligenz hervor.
Merken Sie sich diese Intuition: Ein neuronales Netzwerk = viele einfache Recheneinheiten, die miteinander verbunden sind und durch Anpassen der Verbindungsgewichte lernen.
Training vs. Inferenz: Zwei verschiedene Phasen
Der KI-Lebenszyklus ist in zwei völlig unterschiedliche Phasen unterteilt: Training und Inferenz.
Den Unterschied zwischen diesen beiden Phasen zu verstehen, kann Ihnen helfen, viele Dinge zu begreifen – zum Beispiel, warum das Training so teuer ist, während die Inferenz relativ günstig ist.
Training: Die KI lernen lassen
Training ist ein Prozess: Dem Modell große Mengen an Daten zeigen, es kontinuierlich Parameter anpassen lassen und Vorhersagen immer genauer machen.
Zum Beispiel das Trainieren eines Modells zur Erkennung von Katzen und Hunden:
-
1. Millionen beschrifteter Bilder vorbereiten (dieses ist eine Katze, jenes ist ein Hund)
-
2. Das Modell raten lassen „Was ist das?“; anfangs wird es oft falsch raten
-
3. Ihm sagen „Du hast falsch geraten, es sollte eine Katze sein“, und es die Gewichtungen im Netzwerk anpassen lassen
-
4. Millionen Male wiederholen, bis das Modell immer genauer vorhersagt
Die Trainingsphase erfordert enorme Rechenleistung und Daten.Ein großes Modell benötigt möglicherweise Tausende von GPUs, die über mehrere Monate hinweg trainiert werden, was Millionen von Dollar kostet.
Inferenz: KI nutzen
Inferenz ist ein Prozess: Das trainierte Modell verwenden, neue Eingaben übergeben, Ausgaben erhalten.
Du schickst ChatGPT eine Nachricht, es antwortet dir – das ist Inferenz.
Du nutzt dein Handy, um ein Foto zu machen und eine Pflanze zu identifizieren – auch das ist Inferenz.
Die Merkmale der Inferenz:
Keine Notwendigkeit, Parameter anzupassen, es werden nur die trainierten Gewichte für Berechnungen verwendet.
-
Normalerweise wird nur eine GPU oder sogar ein Smartphone-Chip benötigt.
-
Die Kosten sind viel geringer als beim Training.
Vergleich der beiden
| Dimension | Training | Inferenz |
|---|---|---|
| Ziel | Wissen lernen, Gewichte anpassen | Gelerntes Wissen anwenden, Antworten liefern |
| Datenmenge | Benötigt riesige Datenmengen | Eine einzelne Eingabe reicht aus |
| Rechenanforderungen | Extrem hoch (tausende GPUs) | Relativ niedrig (einzelne GPU oder Smartphone) |
| Kosten | Extrem hoch (Millionen von Dollar) | Relativ niedrig (ein paar Cent pro Mal) |
| Häufigkeit | Ein paar Mal oder Dutzende Male | Millionen Male pro Sekunde |
| Wer macht es | Unternehmen wie OpenAI, Anthropic | Gewöhnliche Benutzer oder Anwendungen |
Als Analogie: Training ist wie „zehn Jahre hart lernen“, Inferenz ist wie „Probleme in einer Prüfung lösen“.
Das Lernen erfordert viel Zeit und Energie, aber sobald man es gelernt hat, geht das Lösen von Problemen schnell.
Wenn Sie ChatGPT verwenden, führen Sie eine „Inferenz“ durch – das Modell „lernt“ nicht durch Ihre Gespräche und wird dadurch auch nicht „schlauer“. Sein Wissen endet zum Zeitpunkt des Abschlusses des Trainings.
Einführung in die Transformer-Architektur
Im Jahr 2017 veröffentlichte Google ein Papier mit dem Titel „Attention Is All You Need“ und schlug darin die Transformer-Architektur vor.
Dieses Papier hat das gesamte KI-Feld verändert. Heutige große Sprachmodelle basieren fast alle auf Transformer.
Warum ist Transformer so wichtig?
Vor Transformer wurden Sequenzdaten (wie Sätze) mit RNN oder LSTM verarbeitet.
Ihr Problem ist: Sie können jeweils nur ein Wort verarbeiten, weshalb es schwierig ist, langfristige Abhängigkeiten zu erfassen.
Zum Beispiel: „Ich habe meine Geldbörse in einem Café in Peking liegen gelassen. Als ich am nächsten Tag zurückging, um danach zu suchen, war ____ noch da.“ — füllen Sie „sie“ in die Lücke ein. Sie wissen, dass sich „sie“ auf „Geldbörse“ bezieht, weil Sie sich an den früheren Inhalt erinnern.
Wenn alte Modelle „noch da“ verarbeiteten, hatten sie die Existenz der „Geldbörse“ möglicherweise bereits vergessen.
Der Durchbruch von Transformer liegt darin:Es kann den gesamten Satz auf einmal sehen und durch den Aufmerksamkeitsmechanismus erkennen, auf welche Wörter es sich konzentrieren muss.
Encoder und Decoder
Ein vollständiger Transformer ist in zwei Teile unterteilt:
| Komponente | Funktion | Typische Anwendungsszenarien |
|---|---|---|
| Encoder | Versteht die Eingabe und konvertiert Text in Vektordarstellungen | Textklassifizierung, Sentiment-Analyse, semantische Suche |
| Decoder | Generiert Ausgabetext basierend auf dem Verständnis | Schreiben, Übersetzung, Dialoggenerierung |
Einige Modelle verwenden nur den Encoder (wie BERT), einige nur den Decoder (wie GPT) und einige beide (wie T5).
Die GPT-Serie, Claude und Llama verwenden alle „Decoder-only“-Architekturen – ihre Stärke ist die Generierung flüssigen Texts.
Was ist der Aufmerksamkeitsmechanismus?
Die Aufmerksamkeit ist das Kernstück von Transformer und der Schlüssel zu seiner Fähigkeit, lange Texte zu verarbeiten.
Analogie: Menschliche Aufmerksamkeit beim Lesen
Wenn Sie einen Satz lesen, wenden Sie nicht für jedes Wort dieselbe Mühe auf.
Zum Beispiel: „Es hat einen langen Schwanz und dreieckige Ohren“ – wenn Sie „es“ sehen, konzentrieren Sie sich auf „Schwanz“ und „Ohren“, um festzustellen, um welches Tier es sich handelt.
Genau das tut der Aufmerksamkeitsmechanismus:Basierend auf der aktuellen Position, die verarbeitet wird, entscheidet er dynamisch, auf welche Wörter in der Eingabe fokussiert werden soll.

Animationsdemo:
Jeder Schritt tut nur eins: das nächste Wort basierend auf dem vorherigen Kontext vorhersagen
Wie wird Aufmerksamkeit berechnet?
Einfach ausgedrückt generiert jedes Wort drei Vektoren:
-
Query:Nach welchen Informationen suche ich?
-
Key:Welche Informationen enthält mein Inhalt?
-
Value:Was ist mein tatsächlicher Inhalt?
Berechnen Sie die Ähnlichkeit zwischen der Query an jeder Position und den Keys an allen Positionen, um Aufmerksamkeitsgewichte zu erhalten, und verwenden Sie diese Gewichte dann, um eine gewichtete Summe der Values zu berechnen, was die Ausgabe für diese Position ergibt.
Sie müssen sich die Details nicht merken, sondern nur diese Intuition:Attention = Zuweisung eines Gewichts zu jedem Wort im Satz, das seine Bedeutung für die aktuelle Position angibt.
Warum ist Attention so wichtig?
Attention bringt mehrere entscheidende Vorteile mit sich:
-
Erstens können Langstreckenabhängigkeiten erfasst werden. Egal wie weit zwei Wörter voneinander entfernt sind, solange sie zusammenhängen, kann die Attention-Mechanismus sie verknüpfen.
-
Zweitens wird paralleles Rechnen unterstützt. Im Gegensatz zu RNNs, die Wort für Wort verarbeiten, kann sie den gesamten Satz gleichzeitig verarbeiten.
-
Drittens ein gewisses Maß an Interpretierbarkeit. Man kann sich die Attention-Gewichte ansehen und erkennen, worauf sich das Modell konzentriert.
Wenn man zum Beispiel „It has a long tail“ übersetzt, kann man sehen, dass sich die Aufmerksamkeit des Modells beim Übersetzen von „it“ hauptsächlich auf „tail“ richtet.
Pre-training und Fine-tuning
Heutige große Modelle verwenden typischerweise ein zweistufiges Training: Pre-training + Fine-tuning.
Pre-training: Lernen von Allgemeinwissen auf massiven Daten
Pre-training funktioniert so: Man nimmt große Mengen an Text aus dem Internet (Wikipedia, Bücher, Webseiten, Code usw.) und lässt das Modell eine Sache tun — das nächste Wort vorhersagen.
Man gibt „The weather today is really“ ein und lässt das Modell erraten, welches Wort als Nächstes kommt.
-
Man gibt „1 + 1 = “ ein und lässt das Modell erraten, welches Wort als Nächstes kommt.
Dieser Prozess hat keine bestimmte Aufgabe; er lässt das Modell lediglich umfassend Sprache, Wissen, Logik, Code und so weiter lernen.
Pre-training ist der teuerste Teil: viele Daten, massive Rechenleistung und lange Dauer.
Fine-tuning: Optimierung für spezifische Aufgaben
Das Modell nach dem Pre-training ist sehr wissend, aber nicht unbedingt gehorsam.
Wenn man ihm eine Frage stellt, redet es vielleicht endlos weiter, anstatt direkt zu antworten.
Wenn man es bittet, Code zu schreiben, schreibt es vielleicht auf halbem Weg und fängt dann an, etwas anderes zu schreiben.
Beim Fine-tuning werden hochwertige Dialogdaten verwendet, um das Modell weiter zu trainieren und ihm beizubringen:
-
Anweisungen zu verstehen und wie gefordert auszugeben
-
Den Konversationsstil beizubehalten und schädliche Anfragen abzulehnen
-
Sicherere und nützlichere Inhalte auszugeben
-
Das Datenvolumen für das Fine-tuning ist viel kleiner als das für das Pre-training, aber die Qualitätsanforderungen sind höher.
Verstehen anhand einer Analogie
-
Pre-training ist wie das Lesen von zehntausend Büchern – von der Grundschule bis zur Universität, bei dem man sich breit gefächert alle Arten von Wissen aneignet.
-
Fine-tuning ist wie eine Berufsausbildung – nach dem Abschluss geht man in einem Unternehmen arbeiten und lernt, wie man mit Kollegen kommuniziert, wie man E-Mails schreibt und wie man Arbeitsaufgaben erledigt.
Pre-training verleiht dem Modell Wissen; Fine-tuning macht das Modell nutzbar.
Das ist auch der Grund, warum unter großen Modellen einige zwar klug, aber schwer zu bedienen sind, während andere durchschnittlich, aber einfach zu bedienen sind – der Unterschied liegt oft im Fine-tuning.
Warum halluziniert KI?
Halluzination ist eines der bekanntesten Probleme der KI: Sie erfindet gravierend Fakten, Namen, Arbeiten und Daten, die nicht existieren.
Verständnis aus der Perspektive der probabilistischen Vorhersage
Um Halluzinationen zu verstehen, muss man zunächst zur grundlegendsten Arbeitsweise der KI zurückkehren:
Sie überprüft keine Fakten, sondern sagt das wahrscheinlichste nächste Wort voraus.
Man fragt: Wer hat das Telefon erfunden? — Sie weißAlexander Graham BellDiese Sequenz tritt am wahrscheinlichsten auf.
Aber man fragt: Wer hat das Beispieltutorial erfunden? — Solche Informationen sind in den Trainingsdaten möglicherweise nicht vorhanden, aber sie erfindet einen plausibel klingenden Namen basierend auf statistischen Mustern.
Sie weiß nicht, was sie nicht weiß – sie weiß nur, dass an dieser Position diese Wörter die höchste Wahrscheinlichkeit haben, aufzutreten.
Häufige Ursachen für Halluzinationen
| Ursache | Erklärung | Beispiel |
|---|---|---|
| Unzureichende Trainingsdaten | Dieses Thema kommt in den Trainingsdaten selten vor, daher hat das Modell es nicht gut gelernt | Das Stellen einer sehr nischenhaften professionellen Frage |
| Wissensstichtag | Dinge, die nach dem Stichtag der Trainingsdaten passiert sind, sind dem Modell unbekannt | Die Frage „Was ist 2025 passiert?“ (angenommen, das Modell wurde 2024 trainiert) |
| Verwechslung von Quellen | Das Vermischen von Informationen aus mehreren Quellen und das anschließende Verwechseln | „Zhang San hat Papier A geschrieben“ (tatsächlich hat es Li Si geschrieben, aber Zhang San und Li Si treten oft zusammen auf) |
| Überanpassung (Overfitting) | Das Auswendiglernen von Rauschen während des Trainings und die Behandlung als Fakt | Das Erfinden von Zitaten, die nicht existieren |
Wie man die Auswirkungen von Halluzinationen reduziert
Als Benutzer kann man Folgendes tun:
-
Erstens: Wichtige Informationen überprüfen. Wenn es um Medizin, Recht, Investitionen, Nachrichtenfakten usw. geht, unbedingt nachprüfen.
-
Zweitens: Das Modell nach Quellen fragen. Fragen Sie es: „Was ist die Quelle dieser Information?“ „Kannst du mir ein Zitat nennen?“
-
Drittens: Retrieval-Augmented Generation (RAG) verwenden. Füttern Sie das Modell mit Ihren eigenen Dokumenten und lassen Sie es basierend auf diesen Dokumenten antworten, anstatt sich Dinge auszudenken.
-
Viertens: Mehrere Modelle zur Kreuzvalidierung verwenden. Stellen Sie mehreren Modellen dieselbe Frage; wenn sie alle dasselbe sagen, ist es glaubwürdiger.
Weitere ErweiterungenDenken Sie daran: Egal wie real sich das anhört, was die KI sagt, es kann erfunden sein. Bleiben Sie bei risikoreichen Entscheidungen immer skeptisch.