KI-Agent
Vielleicht bist du diese Art der Interaktion gewohnt: Du stellst eine Frage, und die KI gibt eine Antwort.
-
Du bittest sie, einen Artikel zu schreiben, und sie schreibt einen Artikel.
-
Du bittest sie, einen Satz zu übersetzen, und sie übersetzt einen Satz.
In diesem Modus ist die KI eher wie ein Berater – sie gibt dir Ratschläge, erledigt die Dinge aber nicht direkt.
Aber was, wenn die Aufgabe etwas komplexer ist? Zum Beispiel: Hilf mir, das Wetter von morgen in Peking zu prüfen. Wenn die Temperatur 25 Grad übersteigt, empfiehl ein Kurzarmhemd für höchstens 300 Yuan, fasse dann die Ergebnisse in einer E-Mail zusammen und schicke sie meinem Chef.
Bei einer gewöhnlichen Konversations-KI musst du es in mehrere Schritte aufteilen:
-
Schritt 1: Prüfe das Wetter von morgen in Peking.
-
Schritt 2: Wenn es 25 Grad übersteigt, empfiehl ein Kurzarmhemd für höchstens 300 Yuan.
-
Schritt 3: Schreibe eine E-Mail an meinen Chef mit dem Inhalt ...
Bei jedem Schritt musst du manuell weitermachen.
undAI AgentDie Idee dahinter ist: Du sagst nur einmal „hilf mir, das zu erledigen“, und er erledigt den Rest von selbst.
Er bestimmt automatisch, was zu tun ist, welche Tools aufgerufen werden, in welcher Reihenfolge sie ausgeführt werden und wie angepasst wird, wenn Probleme auftreten, bis die Aufgabe abgeschlossen ist.
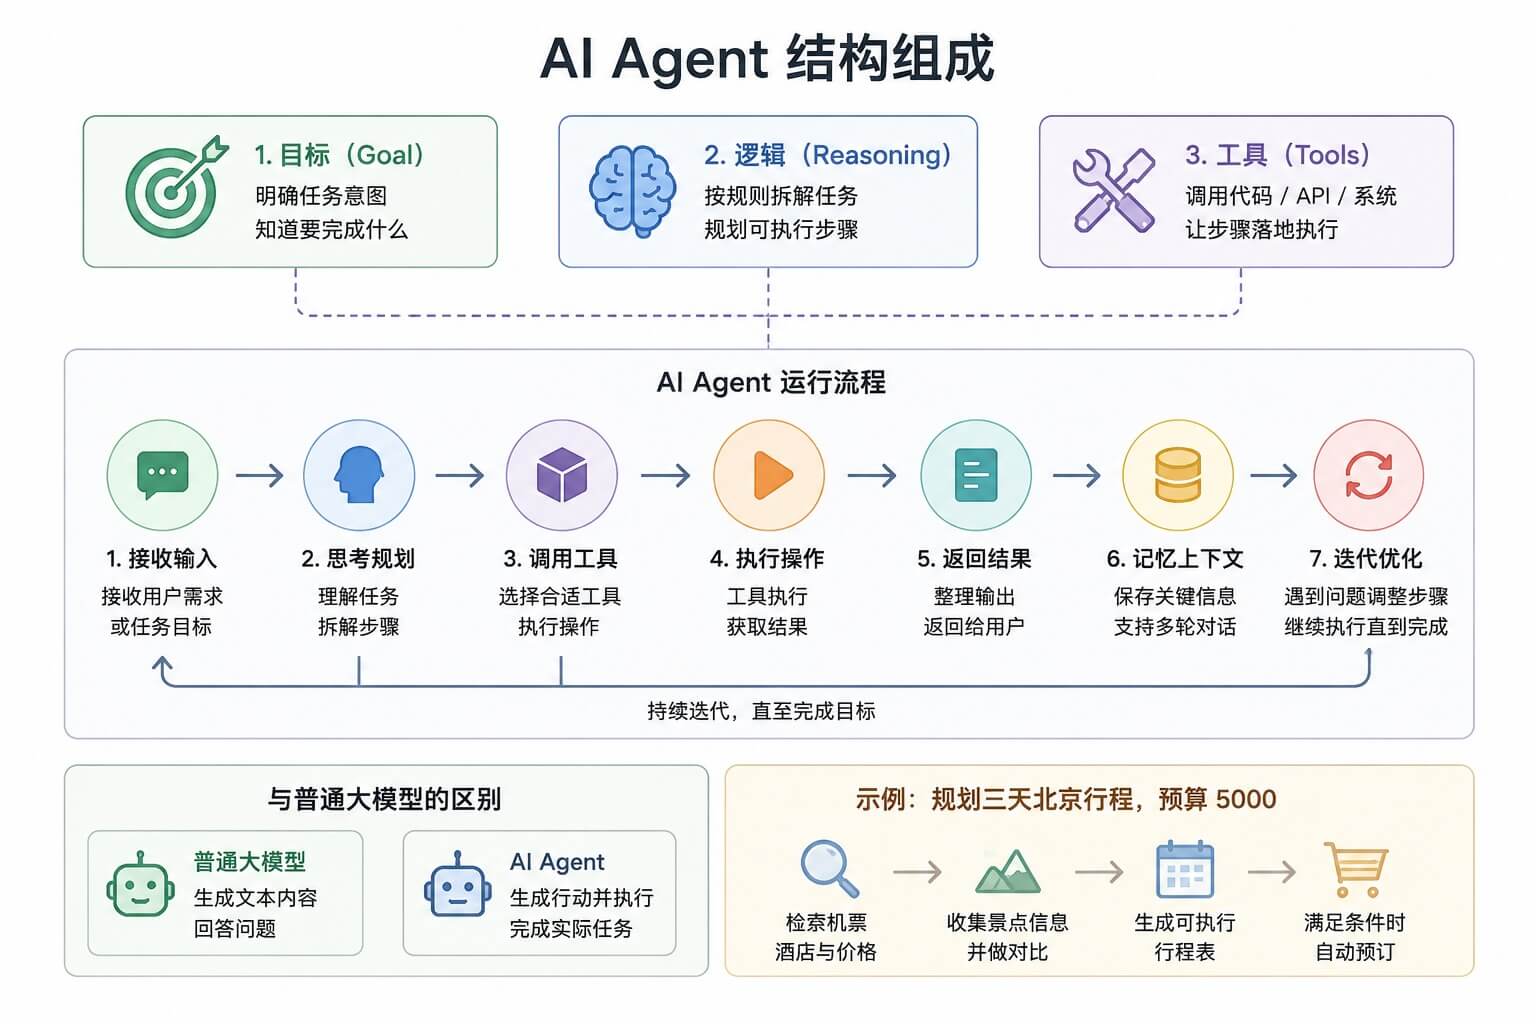
Einfach verstanden: Ein reguläres LLM ist ein Stratege, der dir Ratschläge gibt; ein AI Agent ist ein Ausführender, der das Ziel übernimmt und die Dinge selbstständig erledigt.
Was ist ein AI Agent?
Ein AI Agent ist ein autonomes System, das seine Umgebung wahrnehmen, Entscheidungen treffen und handeln kann.
Eine eher akademische Definition lautet:Ein Agent ist eine in einer Umgebung befindliche Entität; er nimmt die Umgebung über Sensoren wahr und wirkt über Aktoren auf die Umgebung ein, um eine Reihe von Zielen zu erreichen.。
Diese Definition klingt etwas abstrakt, also schlüsseln wir sie in einfacher Sprache auf.
Agent vs. reguläres LLM
Schau dir zunächst eine Vergleichstabelle an:
| Merkmal | Reguläres LLM | KI-Agent |
|---|---|---|
| Interaktionsmodus | Frage-und-Antwort, nutzergesteuert | Autonome Ausführung, zielgesteuert |
| Fähigkeitsgrenze | Nur integrierte Modellfähigkeiten | Kann Fähigkeiten durch Tools erweitern |
| Gedächtnis | Gesprächskontext (begrenzt) | Kurzzeit- + Langzeitgedächtnis |
| Planung | Keine (oder erfordert Nutzeranleitung) | Autonome Aufgabenzerlegung und -planung |
| Feedback-Schleife | Keine (einzelne Generierung) | Beobachten-Denken-Handeln-Schleife |
Ein konkretes Beispiel: „Hilf mir, für morgen einen Flug von Shanghai nach Peking zu buchen, mit einem Preis unter 1.500 Yuan.“
Ein reguläres LLM könnte antworten: „Okay, ich kann dir einen Codeausschnitt schreiben, um Flugpreise abzufragen, oder dir sagen, auf welcher Website du nachsehen kannst.“ Aber es wird nicht tatsächlich nach Flügen suchen, geschweige denn einen für dich buchen.
Ein qualifizierter Agent hingegen wird:
-
1. Das Ziel verstehen: Für morgen einen Flug von Shanghai nach Peking buchen, unter 1.500 Yuan.
-
2. Eine Aktion festlegen: Ich muss eine Flugabfrage-API aufrufen.
-
3. Die Aktion ausführen: Die API aufrufen und die Liste der Flüge abrufen.
-
4. Die Ergebnisse beobachten: 10 Flüge erhalten, von denen 3 unter 1.500 Yuan liegen.
-
5. Noch einmal nachdenken: Welche soll gewählt werden? Vielleicht müssen Abflug- und Ankunftszeiten geprüft oder der Nutzer nach Präferenzen gefragt werden.
-
6. Weiter handeln: Vielleicht eine weitere API aufrufen, um Pünktlichkeitsraten zu prüfen, oder dem Nutzer direkt Optionen empfehlen.
-
7. Aufgabe abschließen: Dem Nutzer helfen, einen Sitzplatz zu sichern, und einen Bestelllink generieren.
Siehst du den Unterschied?Ein normales LLM gibt dir Antworten; ein Agent gibt dir Ergebnisse.。
Kernfähigkeiten eines Agenten
Ein vollständiger Agent besitzt typischerweise die folgenden drei Kernfähigkeiten:
| Fähigkeit | Beschreibung | Analogie |
|---|---|---|
| Wahrnehmung | Umgebungsinformationen und Feedback erhalten | Augen, Ohren |
| Entscheidung | Darüber nachdenken, was zu tun ist und wie es zu tun ist | Gehirn |
| Aktion | Konkrete Operationen ausführen | Hände, Füße |
-
Wahrnehmungbedeutet, dass der Agent sehen kann, was passiert. Zum Beispiel sendet ein Nutzer eine Nachricht, eine API gibt ein Ergebnis zurück oder eine neue Datei wird dem Dateisystem hinzugefügt – das sind alles Wahrnehmungseingaben.
-
Entscheidungbedeutet, dass der Agent anhand der wahrgenommenen Informationen entscheidet, was als Nächstes zu tun ist. Soll er dem Nutzer direkt antworten? Muss er ein Tool aufrufen? Muss er eine große Aufgabe in kleinere Teilaufgaben zerlegen? Das sind alles Entscheidungen.
-
Aktionbedeutet, dass der Agent die Entscheidungen tatsächlich ausführt. Eine Such-API aufrufen, eine Datei lesen, eine E-Mail senden, eine Datenbank bedienen – das sind alles Aktionen.
Grundarchitektur eines Agenten
Schauen wir uns nun das Standard-„Vierteiliges Puzzle“ eines Agenten an: Gehirn, Tools, Gedächtnis und Planung.
Schauen wir zuerst auf ein Architekturdiagramm:

Gehirn: LLM als Reasoning-Kern
Das Gehirn eines Agenten ist typischerweise ein großes Sprachmodell, wie GPT-4, Claude, Llama usw.
Dieses LLM ist verantwortlich für:
-
1. Die Absicht des Nutzers verstehen: Wenn der Nutzer sagt „Hilf mir, ein Ticket zu buchen“, was will er wirklich?
-
2. Entscheidungen treffen: Was soll ich als Nächstes tun?
-
3. Parameter für Tool-Aufrufe generieren: Welche Parameter werden benötigt, um eine Flugabfrage-API aufzurufen?
-
4. Die endgültige Antwort organisieren: Nachdem genügend Informationen gesammelt wurden, wie geben wir dem Nutzer eine klare Zusammenfassung?
Das LLM ist der Kern eines Agenten, aber nicht alles – so wie das menschliche Gehirn wichtig ist, braucht man trotzdem Hände und Füße, um Dinge zu erledigen.
Tools: Die Grenzen der KI-Fähigkeiten erweitern
Native LLMs haben zwei offensichtliche Einschränkungen:
-
1. Wissensstichtag: Es weiß nicht, was nach Abschluss des Trainings passiert ist.
-
2. Keine Interaktionsfähigkeit: Es kann nicht direkt Dateien lesen, Datenbanken abfragen oder APIs aufrufen.
Tools sollen diese Probleme lösen.
Häufige Tool-Typen:
| Tool-Typ | Funktion | Beispiel |
|---|---|---|
| Such-Tools | Neueste Informationen erhalten | Google Search, Bing Search |
| Berechnungs-Tools | Mathematische Operationen ausführen | Taschenrechner, Wolfram Alpha |
| Dateioperationen | Lokale Dateien lesen/schreiben | PDF lesen, CSV schreiben |
| API-Aufrufe | Mit externen Systemen interagieren | Flüge buchen, E-Mails senden, Wetter prüfen |
| Datenbankabfragen | Strukturierte Daten speichern und abrufen | SQL-Abfragen, Vektorabruf |
| Codeausführung | Code ausführen, um Probleme zu lösen | Python REPL, Jupyter |
Einem Agenten Tools zu geben ist, als würde man eine Person mit einem Computer ausstatten – plötzlich kann sie nicht nur denken, sondern auch handeln.
Gedächtnis: Kurzzeit- vs. Langzeitgedächtnis
LLMs sind von Natur aus amnesisch – jede Konversation beginnt von vorn, es sei denn, man stopft den Kontext hinein.
Und ein Agent muss sich eine Menge merken:
Kurzzeitgedächtnis: Was hat der Nutzer gerade gesagt? Welches Tool habe ich im letzten Schritt aufgerufen? Welches Ergebnis habe ich erhalten?
-
Langzeitgedächtnis: Was sind die Präferenzen des Nutzers? Wie wurden ähnliche Aufgaben in der Vergangenheit behandelt? Welche Lehren wurden gezogen?
Gängige Implementierungsansätze für Speichersysteme:
| Speichertyp | Gespeicherter Inhalt | Implementierungsmethode |
|---|---|---|
| Kurzzeitgedächtnis | Konversationsverlauf und Zwischenschritte der aktuellen Sitzung | Direkt im Kontextfenster des LLM platziert |
| Langzeitgedächtnis | Benutzereinstellungen, historische Aufgaben, Wissensdokumente | Vektordatenbank + Ähnlichkeitssuche |
| Zusammenfassungsgedächtnis | Komprimierte historische Zusammenfassungen | Das LLM regelmäßig Zusammenfassungen generieren lassen |
Ein gutes Gedächtnissystem kann einen Agenten so wirken lassen, als würde er sich an dich erinnern, anstatt sich jedes Mal zu verhalten, als würde er dich zum ersten Mal treffen.
Planung: Aufgabenzerlegung
Komplexe Aufgaben werden nicht in einem einzigen Schritt erledigt; ein Agent muss ein großes Ziel in kleinere Schritte zerlegen können.
Zum Beispiel: Hilf mir, eine Geburtstagsparty für 10 Personen zu planen.
Der Agent könnte es so planen:
-
1. Zuerst klären: Wie hoch ist das Budget? Wann ist es? Wo ist es? Was sind die Vorlieben des Ehrengastes?
-
2. Dann: In der Nähe gelegene Veranstaltungsorte suchen.
-
3. Als Nächstes: Das Menü entwerfen.
-
4. Danach: Eine Einkaufsliste erstellen.
-
5. Schließlich: Einen Zeitplan erstellen.
Gängige Planungsstrategien:
-
Chain-of-Thought: Schritt für Schritt durchdenken – was zuerst zu tun ist, was als Nächstes.
-
Tree-of-Thought: Mehrere mögliche Pfade gleichzeitig betrachten und den optimalen auswählen.
-
Reflexion: Nach Abschluss eines Schritts zurückblicken und prüfen, ob Probleme vorliegen und ob Anpassungen nötig sind.
Tool-Nutzung / Funktionsaufruf
Tool-Aufruf ist die grundlegendste und wichtigste Fähigkeit eines Agenten.
Beginnen wir damit zu erklären, was es ist.
Was ist Function Calling?
Einfach gesagt:Function Calling bedeutet, dass das LLM ein strukturiertes JSON ausgibt, das angibt, welche Funktion es aufrufen möchte und welche Parameter übergeben werden sollen.。
Es ist nicht so, dass das LLM die Funktion tatsächlich ausführt – es teilt nur mit, dass es sie aufrufen möchte, und du musst die Ausführung weiterhin übernehmen.
Der gesamte Prozess läuft normalerweise so ab:
-
1. Du sagst dem LLM: "Hier sind einige Funktionen, die du aufrufen kannst. Name, Parameter und Zweck jeder Funktion sind..."
-
2. Der Benutzer sendet eine Nachricht: "Hilf mir, das Wetter morgen in Beijing zu prüfen."
-
3. Das LLM antwortet: "Ich möchte die Funktion get_weather aufrufen, mit den Parametern city='Beijing', date='tomorrow'."
-
4. Du rufst die Funktion auf (fragst tatsächlich die Wetter-API ab) und erhältst das Ergebnis.
-
5. Du gibst das Ergebnis an das LLM zurück: "Der vorherige Funktionsaufruf ergab: Temperatur 25 Grad, sonnig."
-
6. Basierend auf diesem Ergebnis gibt das LLM dem Benutzer eine natürlichsprachliche Antwort: "In Beijing wird es morgen sonnig, 25 Grad, sehr angenehm."
Siehst du? Das LLM übernimmt das Denken, und du übernimmst die Ausführung.
Definieren eines JSON-Schemas für ein Tool
Damit das LLM Tools aufrufen kann, musst du ihm zuerst mitteilen, welche Tools verfügbar sind.
Dieser Prozess des Mitteilens ist das Beschreiben der Funktionen mit JSON Schema.
Sehen wir uns ein Standardformat für Funktionsdefinitionen an:
Beispiel
tool_definition = {
"type": "function",
"function": {
"name": "get_weather", # Funktionsname
"description": "Abfrage des Wetters für eine angegebene Stadt an einem angegebenen Datum", # Beschreibung des Funktionszwecks; das LLM sieht sich dies an
"parameters": {
"type": "object",
"properties": {
"city": {
"type": "string",
"description": "Stadtname, z. B. 'Beijing', 'Shanghai', 'Shenzhen'",
},
"date": {
"type": "string",
"description": "Datum, im Format YYYY-MM-DD, z. B. '2024-06-18'",
},
"unit": {
"type": "string",
"enum": ["celsius", "fahrenheit"],
"description": "Temperatureinheit, Celsius oder Fahrenheit, Standard Celsius",
},
},
"required": ["city", "date"], # Erforderliche Parameter
},
},
}
# Weiteres Tool: Suche
search_tool = {
"type": "function",
"function": {
"name": "web_search",
"description": "Durchsuche das Internet nach den neuesten Informationen, geeignet zum Überprüfen von Nachrichten, Echtzeitdaten und unbekanntem Wissen",
"parameters": {
"type": "object",
"properties": {
"query": {
"type": "string",
"description": "Suchbegriff oder Frage",
},
"num_results": {
"type": "integer",
"description": "Anzahl der zurückzugebenden Ergebnisse, Standard 5",
"default": 5,
},
},
"required": ["query"],
},
},
}
# Weiteres Tool: Rechner
calculator_tool = {
"type": "function",
"function": {
"name": "calculate",
"description": "Führe mathematische Berechnungen durch, unterstützt Addition, Subtraktion, Multiplikation, Division, Potenzierung usw.",
"parameters": {
"type": "object",
"properties": {
"expression": {
"type": "string",
"description": "Mathematischer Ausdruck, z. B. '25 * 4 + 10', 'sqrt(16)'",
},
},
"required": ["expression"],
},
},
}
print(fDefinierte {len([tool_definition, search_tool, calculator_tool])} Tools: get_weather, web_search, calculate)
# Ausgabe: Definierte 3 Tools: get_weather, web_search, calculate
Wichtige Punkte:
-
description ist sehr wichtig — das LLM verlässt sich auf diese Beschreibung, um zu verstehen, was das Tool tut und wann es verwendet werden sollte.
-
Parameter sollten ebenfalls klar beschrieben werden — wenn unit beispielsweise eine enum-Einschränkung hat, weiß das LLM, dass es nur aus diesen beiden Werten wählen kann.
-
required kennzeichnet die erforderlichen Felder — das LLM stellt sicher, dass diese Parameter immer Werte haben.
Praxisnaher Code: Such- und Berechnungstools zu KI hinzufügen
Jetzt schreiben wir ein vollständiges, ausführbares Beispiel.
Zur Demonstration verwenden wir Python, um den vollständigen Function-Calling-Ablauf zu simulieren.
Beispiel
# Eine vereinfachte Demo eines Agent-Tool-Aufrufs
# Kein echter API-Schlüssel erforderlich, Demonstration mit Mock-Daten
# ============================================
import json
import random
from typing import Dict, Any, List, Optional
class SimpleAgent:
"""Eine einfache Agent-Demo-Klasse"""
def __init__(self):
# Verfügbare Tools registrieren
self.tools = self._define_tools()
# Gesprächsverlauf (Speicher)
self.messages: List[Dict] = []
def _define_tools(self) -> List[Dict]:
"""Alle verfügbaren Tools definieren"""
return [
{
"name": "web_search",
"description": "Durchsuche das Internet nach den neuesten Informationen",
"parameters": {
"query": {"type": "string", "description": "Suchbegriff"},
},
"required": ["query"],
},
{
"name": "calculate",
"description": "Mathematische Berechnungen durchführen",
"parameters": {
"expression": {"type": "string", "description": "Mathematischer Ausdruck"},
},
"required": ["expression"],
},
{
"name": "get_weather",
"description": "Wetter abfragen",
"parameters": {
"city": {"type": "string", "description": "Stadtname"},
"date": {"type": "string", "description": "Datum"},
},
"required": ["city", "date"],
},
]
def _call_tool(self, tool_name: str, parameters: Dict[str, Any]) -> str:
"""(Mock) Ruft das Tool auf und gibt das Ergebnis zurück"""
print(f" [Tool-Aufruf] {tool_name}({parameters})")
if tool_name == "web_search":
query = parameters["query"]
# Simuliertes Suchergebnis
results = {
"example": Example (Rookie Tutorial) ist eine Website zum Programmierenlernen, die eine Vielzahl von Programmier-Tutorials und Beispielen bietet.,
"Wetter in Peking am 18. Juni 2024": "Peking 2024-06-18: Sonnig, 25°C, Luftfeuchtigkeit 45%.",
"Bevölkerung von Shanghai": "Shanghais Wohnbevölkerung im Jahr 2024 beträgt ungefähr 24.89 Millionen.",
}
return results.get(query, f"Suchergebnisse: Keine genauen Informationen für '{query}' gefunden, dies ist ein simuliertes Ergebnis.")
elif tool_name == "calculate":
expr = parameters["expression"]
try:
# Hinweis: Verwende eval nicht in der Produktion; dies dient nur zur Demonstration
result = eval(expr, {"__builtins__": None}, {
"sqrt": lambda x: x**0.5,
"pow": pow,
})
return f"Berechnungsergebnis: {expr} = {result}"
except Exception as e:
return f"Berechnungsfehler: {e}"
elif tool_name == "get_weather":
city = parameters["city"]
date = parameters["date"]
# Simulierte Wetterdaten
weathers = ["Sonnig", "Bewölkt", "Leichter Regen", "Bedeckt"]
temp = random.randint(15, 35)
return f"{city} {date}:{random.choice(weathers)},{temp}°C"
else:
return f"Unbekanntes Tool: {tool_name}"
def _decide_action(self, user_input: str) -> Dict[str, Any]:
"""
(Simulierter) LLM-Entscheidungsprozess
In einem echten Projekt wird hier die tatsächliche LLM-API aufgerufen
"""
# Hier werden zur Simulation einfache Regeln verwendet; in realen Szenarien sollte ein LLM verwendet werden
if "Suche" in user_input or "Nachschlagen" in user_input or "Was ist" in user_input:
# Suchbegriff extrahieren (einfache Simulation)
query = user_input.replace("Suche", "").replace("Nachschlagen", "").replace("Was ist", "").strip()
if not query:
query = "Beispiel"
return {
"action": "call_tool",
"tool": "web_search",
"parameters": {"query": query},
}
elif "Berechne" in user_input or "ergibt" in user_input:
# Ausdruck extrahieren (einfache Simulation)
return {
"action": "call_tool",
"tool": "calculate",
"parameters": {"expression": "25 * 4 + 10"}, # Beispielhafte feste Werte
}
elif "Wetter" in user_input:
return {
"action": "call_tool",
"tool": "get_weather",
"parameters": {"city": "Peking", "date": "2024-06-18"},
}
else:
return {
"action": "respond",
"content": "Okay, ich helfe dir dabei." + user_input,
}
def run(self, user_input: str) -> str:
"""Agent ausführen, um Benutzereingabe zu verarbeiten"""
print(f"[Benutzereingabe] {user_input}")
self.messages.append({"role": "user", "content": user_input})
# Schritt 1: Entscheiden, was zu tun ist
decision = self._decide_action(user_input)
if decision["action"] == "call_tool":
# Schritt 2: Das Tool aufrufen
tool_result = self._call_tool(decision["tool"], decision["parameters"])
self.messages.append({"role": "tool", "content": tool_result})
# Schritt 3: Die endgültige Antwort basierend auf dem Tool-Ergebnis generieren
# (Hier wird einfach verkettet; in Wirklichkeit sollte das LLM sie generieren)
final_response = f"Basierend auf meiner Abfrage: {tool_result}\n\nIch hoffe, diese Information ist hilfreich für dich!"
self.messages.append({"role": "assistant", "content": final_response})
return final_response
else:
# Direkt antworten
self.messages.append({"role": "assistant", "content": decision["content"]})
return decision["content"]
# ============================================
# Diesen Agenten testen
# ============================================
agent = SimpleAgent()
print("=" * 60)
response1 = agent.run("Suche, was ein Beispiel ist")
print(f"[Agentenantwort]\n{response1}")
print("\n" + "=" * 60)
response2 = agent.run("Hilf mir, das Wetter in Peking am 2024-06-18 zu prüfen")
print(f"[Agentenantwort]\n{response2}")
print("\n" + "=" * 60)
response3 = agent.run("Berechne, was 25 * 4 + 10 ergibt")
print(f"[Agentenantwort]\n{response3}")
Obwohl dieses Beispiel einfach ist, zeigt es den vollständigen geschlossenen Kreislauf von Function Calling:
Verstehen → Entscheiden → Das Tool aufrufen → Das Ergebnis beobachten → Eine Antwort generieren.
In einem echten Projekt,_decide_actiondieser Schritt würde durch einen echten LLM-Aufruf ersetzt, bei dem das Modell entscheidet, welches Tool verwendet und welche Parameter übergeben werden.
ReAct-Planungsschleife
Nachdem die Tool-Aufruf-Fähigkeiten vorhanden sind, stellt sich die nächste Frage: Wann aufhören?
Einfache Aufgaben können in einem Schritt erledigt werden, aber komplexe Aufgaben erfordern oft mehrere Iterationsrunden.
Das ist das Problem, das das ReAct-Framework lösen soll.
Gedanke → Aktion → Beobachtung
Der Name ReAct stammt aus der Kombination von Reasoning und Acting.
Die Kernidee ist einfach: Der Agent soll wie ein Mensch einen Schritt denken, einen Schritt handeln, beobachten und diese Schleife dann wiederholen, bis die Aufgabe abgeschlossen ist.
Schauen wir uns ein Flussdiagramm an:

Jeder Zyklus besteht aus drei Schritten:
| Schritt | Englisch | Was es tut |
|---|---|---|
| Gedanke | Gedanke | Was muss ich jetzt tun? Warum? |
| Aktion | Aktion | Ein Tool aufrufen, um eine bestimmte Operation auszuführen |
| Beobachtung | Beobachtung | Das Ergebnis der Aktion festhalten |
Dann kehrt man zum Gedanken zurück — basierend auf den beobachteten Ergebnissen entscheiden, was als Nächstes zu tun ist.
Diese Schleife läuft weiter, bis der Agent feststellt, dass die Aufgabe abgeschlossen ist; dann verlässt er die Schleife und gibt die endgültige Antwort.
Verwenden wir ein konkretes Beispiel, um zu sehen, wie ReAct funktioniert:
-
Nutzerfrage: In welchem Jahr wurde SpaceX gegründet? Wie hieß ihre erste Rakete, die erfolgreich eine Umlaufbahn erreichte?
-
Gedanke 1: Ich muss das Gründungsjahr von SpaceX und das Modell seiner frühesten Rakete finden, die einen Orbitalstart absolviert hat. Diese Informationen können aus verschiedenen Quellen stammen, daher ist es am besten, mit Schlüsselwörtern zu suchen, die beide auf einmal abdecken.
-
Aktion 1: web_search aufrufen, um nach "SpaceX founding time first orbital rocket" zu suchen.
-
Beobachtung 1: Die Zusammenfassung des Suchergebnisses zeigt: "SpaceX (Space Exploration Technologies Corp.) wurde 2002 von Elon Musk gegründet. Ihre erste Rakete, die erfolgreich in die Erdumlaufbahn eintrat, war Falcon 1, die am 28. September 2008 bei ihrem vierten Testflug erfolgreich war." (Die Informationen sind vollständig und decken beide Teilfragen ab.)
-
Gedanke 2: Die Suchergebnisse liefern bereits sowohl das Gründungsjahr (2002) als auch die erste Orbitalrakete (Falcon 1). Es gibt keine Mehrdeutigkeit und die Informationen sind glaubwürdig. Eine zusätzliche Suche ist nicht nötig.
-
Endgültige Antwort: SpaceX wurde 2002 gegründet, und ihre erste Rakete, die erfolgreich eine Umlaufbahn erreichte, war Falcon 1, die diesen Meilenstein am 28. September 2008 erreichte.
-
Hinweis: Siehst du? Jeder Schritt hat einen klaren "Gedanken", eine klare "Aktion" und eine klare "Beobachtung", und der Agent entscheidet selbst, wann er aufhört — hier dauerte es nur 1 Aktionsrunde, um alle benötigten Informationen zu sammeln, sodass er ohne zusätzliche Schleifen direkt zur endgültigen Antwort überging.
Bedingungen für die Beendigung der Schleife
Die ReAct-Schleife kann nicht unbegrenzt laufen; sie benötigt eine Abbruchbedingung.
Häufige Abbruchbedingungen:
| Abbruchbedingung | Beschreibung | Beispiel |
|---|---|---|
| Aufgabe abgeschlossen | Der Agent stellt fest, dass genügend Informationen gesammelt wurden, um die Frage des Nutzers zu beantworten. | Ich habe die Antwort gefunden, jetzt kann ich antworten. |
| Maximale Anzahl an Schritten erreicht. | Um Endlosschleifen zu verhindern, wird eine maximale Anzahl an Runden festgelegt (z. B. 10 Schritte). | Bereits 10 Mal iteriert, erzwungener Stopp. |
| Nutzerunterbrechung | Der Nutzer sagt proaktiv "Stopp" oder "Genug". | Keine Notwendigkeit zu prüfen, ich weiß es. |
| Sicheres Scheitern. | Der Agent stellt fest, dass diese Aufgabe nicht abgeschlossen werden kann. | Ich habe mehrfach gesucht, aber die relevanten Informationen nicht gefunden. |
Beim Entwerfen eines Agenten sollte man unbedingt ein Sicherheitsventil für "maximale Schritte" vorsehen — sonst dreht er sich im Kreis und hört nie auf.
Design des Gedächtnissystems
Wenn ein Agent lange arbeitet, tritt ein Problem auf: Das Kontextfenster kann nicht die gesamte Konversationshistorie aufnehmen.
An diesem Punkt ist ein gutes Gedächtnissystem erforderlich.
Gesprächsverlauf: Kurzzeitgedächtnis
Das einfachste Gedächtnis besteht darin, den Gesprächsverlauf vollständig zu speichern.
Jedes Mal werden alle vorherigen Nachrichten in das LLM gestopft, damit es sich merken kann, was gerade passiert ist.
Aber dieser Ansatz hat einen offensichtlichen Nachteil: Das Kontextfenster des LLM ist begrenzt.
Zum Beispiel hat GPT-4 8K oder 32K, und Claude hat 200K – obwohl groß, ist es immer noch nicht unendlich.
Solange das Gespräch kurz ist, ist es in Ordnung, aber sobald es sehr lang wird oder jede Runde von Tool-Aufrufen viel Inhalt zurückgibt, geht schnell der Platz aus.
Vektordatenbank: Langzeitgedächtnis
Wenn es zu viel zu merken gibt und der Kontext es nicht fassen kann, ist eine übliche Lösung:Erinnerungen in einer Vektordatenbank speichern und bei Bedarf die relevanten "abrufen".。
Dieser Ansatz heißt RAG (Retrieval-Augmented Generation) und gilt gleichermaßen für Agenten.
Workflow:
-
Immer wenn eine Erinnerung erzeugt wird (was der Benutzer gesagt hat, das vom Tool zurückgegebene Ergebnis, das Denken des Agenten), wird sie in einen Vektor (Embedding) umgewandelt.
-
2. Diesen Vektor in der Vektordatenbank speichern.
-
3. Wenn der Agent sich erinnern muss, wird auch die aktuelle Frage in einen Vektor umgewandelt.
-
4. Die Vektordatenbank nach den wenigen "ähnlichsten" Erinnerungen durchsuchen.
-
5. Nur diese wenigen relevanten Erinnerungen in den LLM-Kontext setzen.
Auf diese Weise müssen selbst bei zehntausend historischen Erinnerungen nur die relevantesten abgerufen und verwendet werden.
Zusammenfassungsbasierte Gedächtniskompression
Ein weiteres Schema zur Gedächtnisoptimierung:Speichern Sie nicht die vollständigen Gesprächstexte; stattdessen erzeugt ein großes Modell regelmäßig prägnante Zusammenfassungen historischer Sitzungen, und nur die Zusammenfassungen werden dauerhaft gespeichert.。
Originaler langer Dialog:
Benutzer: Hilf mir, das Wetter zu prüfen.
-
Agent: In welcher Stadt soll ich nachschauen?
-
Benutzer: Peking.
-
Agent: Welcher Tag?
-
Benutzer: Morgen.
-
……
Komprimierte Zusammenfassung:
用户需要查询北京明日天气,Agent 先后确认城市与日期,用户明确查询时间为明天。
Dieser Ansatz kann den Token-Overhead erheblich reduzieren: Ein vollständiges Gespräch, das ursprünglich 500 Token belegte, benötigt nur eine 50-Token-Zusammenfassung, um die Kerninformationen zu behalten.
Produktionsprojekte verwenden normalerweise mehrere Lösungen zusammen und verwalten das Gesprächsgedächtnis in Schichten:
- Jüngste aktuelle Dialoge: vollständig beibehalten, direkt in den Modellkontext gesendet;
- Weiter zurückliegende historische Dialoge: einheitlich Zusammenfassungen erzeugen, wobei der Originaltext durch Zusammenfassungen ersetzt wird;
- Langfristige Schlüsselinformationen: in einer Vektordatenbank gespeichert, bei Bedarf abgerufen.
Mainstream-Agent-Frameworks
Nachdem Sie die Prinzipien verstanden haben, können Sie Ihren eigenen Agenten schreiben oder vorhandene Frameworks verwenden.
Die derzeit beliebtesten sind:
LangChain-Agenten
LangChain ist derzeit das beliebteste Framework für die Entwicklung von LLM-Anwendungen und verfügt über ein integriertes Agent-System.
Kernkonzepte:
Agent: das Gehirn, entscheidet, was zu tun ist.
Tools: Liste der Tools.
Toolkits: Tool-Sammlungen (zum Beispiel mehrere datenbankbezogene Tools zusammen bündeln).
AgentExecutor: der Ausführer, verantwortlich für die Ausführung der ReAct-Schleife.
LangChains Vorteil ist sein reiches Ökosystem – viele fertige Tool-Integrationen, sofort einsatzbereit.
Der Nachteil ist, dass es sich manchmal etwas schwerfällig anfühlt, mit vielen Abstraktionsebenen, was das Debugging bei Problemen schwierig macht.
LlamaIndex-Agenten
LlamaIndex (früher GPT Index genannt) konzentriert sich stärker auf die Datenanbindung – das Verbinden Ihrer privaten Daten (Dokumente, Datenbanken, APIs) mit dem LLM.
Seine Agent-Stärken sind:
-
1. Abfragen strukturierter und unstrukturierter Daten.
-
2. Routing zwischen mehreren Datenquellen.
-
3. Dokumenten-Fragebeantwortung (RAG).
Wenn dein Agent umfangreich mit "deinen Daten" arbeiten muss, ist LlamaIndex eine gute Wahl.
AutoGPT-Prinzipien
AutoGPT ist ein Projekt, das Anfang 2023 populär wurde, und sein Merkmal ist: vollständige Autonomie.
Du gibst ihm ein großes Ziel (z. B. "hilf mir, eine Website zu bauen"), und es wird selbst:
-
1. Eine Aufgabenliste erstellen.
-
2. Aufgaben ausführen.
-
3. Selbst reflektieren.
-
4. Den Plan anpassen.
-
5. Weiter voranschreiten.
AutoGPT ließ viele Menschen zum ersten Mal die Kraft "autonomer Agenten" sehen, aber es zeigte auch viele Probleme mit Agenten auf:
Es läuft oft weiter in die falsche Richtung, ohne rechtzeitig Verluste zu stoppen.
Es neigt dazu, in Endlosschleifen zu geraten und dieselben Aktionen zu wiederholen.
Hohe Kosten — ein Durchlauf kann Dutzende Dollar an API-Gebühren verbrauchen.
Aber AutoGPT ist als Proof of Concept sehr lehrreich.
CrewAI-Multi-Agent
Was wir gerade besprochen haben, sind einzelne Agenten, während der Ansatz von CrewAI ist: mehrere Agenten zu einem Team zusammenzuschließen und zusammenarbeiten zu lassen.
Zum Beispiel kannst du definieren:
Product-Manager-Agent: verantwortlich für das Verstehen von Anforderungen und das Schreiben von PRDs.
Engineer-Agent: verantwortlich für das Schreiben von Code.
Reviewer-Agent: verantwortlich für Code Review und das Geben von Feedback.
Lass sie dann wie ein echtes Team zusammenarbeiten — miteinander diskutieren, Aufgaben zuweisen und Ergebnisse liefern.
Multi-Agent ist eine sehr vielversprechende Richtung: Ein einzelner Agent kann Fehler machen, aber mehrere Agenten können sich gegenseitig korrigieren und ergänzen.
Praxis: Aufbau eines automatisierten Informationsbeschaffungs-Agenten
Jetzt verbinden wir die Wissenspunkte von vorhin und schreiben einen wirklich nutzbaren Agenten.
Der Agent, den wir erstellen werden, heißtexample-researcher— gib ihm ein Thema, und er wird automatisch suchen, organisieren und einen Recherchebericht erstellen.
Beispiel
# Praxis: Automatischer Agent zur Informationssammlung
# ============================================
import json
import time
from typing import Dict, Any, List
class ResearchAgent:
"""
Ein einfacher rechercheorientierter Agent:
Zu einem Thema automatisch relevante Informationen suchen und sie in einem Bericht zusammenstellen
"""
def __init__(self, max_steps: int = 5):
self.max_steps = max_steps
self.memory: List[Dict] = [] # Gedächtnis
self.known_facts: List[str] = [] # Gesammelte Fakten
self.queries_used: List[str] = [] # Verwendete Suchbegriffe
def _search_web(self, query: str) -> str:
"""(Simulierte) Websuche"""
print(f" Suche: {query}")
time.sleep(0.5) # Simulierte Verzögerung
# Simulierte Wissensbasis
knowledge_base = {
"Künstliche Intelligenz": "Künstliche Intelligenz (KI) ist ein Teilgebiet der Informatik, das sich der Entwicklung von Systemen widmet, die Aufgaben ausführen können, für die normalerweise menschliche Intelligenz erforderlich ist.",
"Maschinelles Lernen": "Maschinelles Lernen ist eine Teilmenge der künstlichen Intelligenz, die es Computern ermöglicht, aus Daten zu lernen, ohne explizit programmiert zu werden.",
"Deep Learning": "Deep Learning ist eine Teilmenge des maschinellen Lernens, basiert auf mehrschichtigen neuronalen Netzen und eignet sich besonders für die Verarbeitung unstrukturierter Daten wie Bilder und Text.",
"Großes Sprachmodell": "Ein großes Sprachmodell (LLM) ist ein KI-Modell, das auf der Transformer-Architektur basiert, mit riesigen Textmengen trainiert wurde und menschliche Sprache verstehen und erzeugen kann.",
"Agent": "Ein KI-Agent ist ein System, das autonom seine Umgebung wahrnehmen, Entscheidungen treffen und Aktionen ausführen kann und typischerweise aus vier Teilen besteht: LLM, Werkzeuge, Gedächtnis und Planung.",
"Transformer": Transformer ist eine neuronale Netzarchitektur, die 2017 von Google vorgeschlagen wurde, und die Grundlage moderner LLMs, wobei der Kern der Attention-Mechanismus ist.,
"example": Example (example) wurde 2013 gegründet und ist eine Website, die sich auf Programmier-Tutorials konzentriert und Lernressourcen für mehrere Programmiersprachen bietet.,
}
# Finde das relevanteste Wissen
for key, value in knowledge_base.items():
if key in query:
return value
return fSuchergebnisse für '{query}': Dies ist ein sehr interessantes Thema, das mehrere technische Bereiche betrifft. (Simuliertes Ergebnis)
def _think(self, step: int, user_topic: str) -> Dict[str, Any]:
"""
Denke darüber nach, was als Nächstes zu tun ist
(In einem echten Projekt sollte hier ein LLM aufgerufen werden)
"""
# Einfache heuristische Regeln zur Simulation des Denkprozesses
if step == 1:
# Schritt 1: Zuerst nach dem Thema selbst suchen
return {
"thought": fIch muss zuerst die grundlegende Definition und den Hintergrund von '{user_topic}' verstehen.,
"action": "search",
"query": user_topic,
}
elif step == 2:
# Schritt 2: Nach verwandten Technologien suchen
return {
"thought": Nachdem ich nun die grundlegende Definition habe, muss ich nach verwandten Technologien und Konzepten suchen.,
"action": "search",
"query": fVerwandte Technologien für {user_topic},
}
elif step < self.max_steps:
# Zwischenschritt: Weiter tiefer gehen
return {
"thought": Lass mich nach weiteren Informationen aus mehr Dimensionen suchen, um den Bericht reichhaltiger zu machen.,
"action": "search",
"query": fAnwendungsszenarien für {user_topic},
}
else:
# Letzter Schritt: Den Bericht zusammenstellen
return {
"thought": Ich habe genügend Informationen gesammelt, und jetzt kann ich den endgültigen Bericht zusammenstellen.,
"action": "finish",
}
def _observe(self, action_result: str):
"""Beobachte die Ergebnisse, zeichne sie im Speicher auf"""
self.known_facts.append(action_result)
self.memory.append({
"role": "observation",
"content": action_result,
})
def _generate_report(self, topic: str) -> str:
"""Erzeuge einen Bericht basierend auf den gesammelten Informationen"""
report = f"# {topic} Forschungsbericht\n\n"
report += f"> Dieser Bericht wurde automatisch von example-researcher generiert\n\n"
report += "---\n\n"
report += "## Kernpunkte\n\n"
for i, fact in enumerate(self.known_facts, 1):
report += f"{i}. {fact}\n\n"
report += "---\n\n"
report += "## Zusammenfassung\n\n"
report += f"Das Obige ist die wichtigste zusammengestellte Information über '{topic}'."
report += "Wenn Sie tiefere Forschung benötigen, können Sie weiter nach relevanten akademischen Arbeiten oder technischer Dokumentation suchen."\n"
return report
def run(self, topic: str) -> str:
"""Führe Research Agent aus"""
print(f" example-researcher gestartet!")
print(f" Forschungsthema: {topic}")
print("-" * 50)
for step in range(1, self.max_steps + 1):
print(f"\nSchritt {step} / {self.max_steps} Schritte)
# 1. Gedanke
decision = self._think(step, topic)
print(f" Gedanke: {decision['thought']}")
if decision["action"] == "finish":
print(" Sammlung abgeschlossen, beginne mit der Erstellung des Berichts...")
break
# 2. Aktion
if decision["action"] == "search":
result = self._search_web(decision["query"])
print(f" Ergebnis: {result[:60]}...")
# 3. Beobachtung
self._observe(result)
# Endgültigen Bericht generieren
print("\n" + "-" * 50)
print(" Recherchebericht wird generiert...")
final_report = self._generate_report(topic)
return final_report
# ============================================
# Ausprobieren
# ============================================
agent = ResearchAgent(max_steps=4)
report = agent.run("Agent")
print("\n" + "=" * 50)
print(report)
print("=" * 50)
Obwohl dieser Agent LLM-Aufrufe vereinfacht (durch Regeln simuliert), ist der gesamte Workflow wirklich nutzbar.
Sie müssen lediglich_thinkdie Methode durch echte LLM-API-Aufrufe ersetzen, und_search_websie durch eine echte Such-API ersetzen, und schon kann es Ihnen wirklich bei der Recherche helfen.
Einschränkungen und Fehlermodi von Agenten
KI-Agenten sind leistungsstark, aber sie sind nicht allmächtig.
Das Verständnis seiner Einschränkungen hilft Ihnen, ihn in den richtigen Szenarien einzusetzen und Fallstricke zu vermeiden.
Häufige Fehlermodi
1. Falsche Werkzeugauswahl
Wenn ein Benutzer nach dem Wetter fragt, ruft der Agent eine Suche auf; wenn ein Benutzer suchen möchte, ruft der Agent einen Taschenrechner auf.
Diese Art von Fehler ist sehr häufig, besonders wenn die Tool-Definitionen nicht klar genug sind.
2. Fehler bei der Parameterübergabe
Falsches Datumsformat, fehlende erforderliche Parameter, falsche Parametertypen – all das kann dazu führen, dass Tool-Aufrufe fehlschlagen.
3. Endlosschleife
Der Agent bleibt in einer Endlosschleife hängen: "A suchen → nicht gefunden → A erneut suchen → immer noch nicht gefunden → A noch einmal suchen…"
4. Vorzeitiges Stoppen
Bevor genügend Informationen gesammelt wurden, entscheidet der Agent, dass es "genug" sei, und gibt eine unvollständige Antwort.
5. Halluzination
Der Agent erfindet möglicherweise Tools, die nicht existieren, Parameter, die nicht existieren, oder denkt sich gefälschte Suchergebnisse aus.
6. Mangel an gesundem Menschenverstand
Manchmal tut der Agent Dinge, die Menschen töricht erscheinen – zum Beispiel, wenn ein Benutzer sagt: "Buchen Sie mir einen Flug für morgen", sucht der Agent nach, was "morgen" ist, obwohl er eigentlich das heutige Datum plus einen Tag verwenden sollte.
Wie man Agenten zuverlässiger macht
Um diese Probleme anzugehen, gibt es in der Branche einige häufig verwendete Gegenmaßnahmen:
| Strategie | Welches Problem es löst | Wie man es umsetzt |
|---|---|---|
| Human-in-the-loop | Verhindern, dass der Agent auf den falschen Weg gerät | Menschen bestätigen wichtige Schritte, anstatt vollständig autonom zu sein |
| Klarere Tool-Definitionen | Falsche Werkzeugauswahl | Die Beschreibung so detailliert wie möglich gestalten und Beispiele angeben |
| Wiederholen + Fehlertoleranz | Fehlgeschlagener Tool-Aufruf | Bei Fehlschlag automatisch wiederholen oder dem LLM klares Fehlerfeedback geben |
| Ausgabeformat erzwingen | Fehler beim Parsen von Parametern | JSON-Schema-Einschränkungen verwenden oder einen Output Parser verwenden |
| Reflexionsmechanismus | Endlosschleife | Den Agenten regelmäßig prüfen lassen: "Wiederhole ich nutzlose Arbeit?" |
Weitere ErweiterungenEin praktischer Tipp: Streben Sie nicht von Anfang an vollständige Autonomie an. Beginnen Sie mit einem Human-in-the-Loop-Modus – der Agent schlägt vor, was zu tun ist, und ein Mensch bestätigt, bevor er ausführt. Wenn Sie Vertrauen gewonnen haben, übertragen Sie schrittweise mehr Befugnisse.