Как работает ИИ
Вы можете спросить: я просто хочу использовать ИИ, зачем мне понимать, как он работает?
Причина проста: если вы знаете, откуда берутся возможности ИИ, вы можете использовать его лучше.
Вы будете знать, когда ему доверять, а когда подвергать его сомнению.
-
Вы узнаете, в чём он хорош и в чём не очень.
-
Вы узнаете, откуда берутся галлюцинации и как снизить их влияние.
Интуитивное понимание нейронных сетей
Ядро современного ИИ — этонейронные сети, название которых происходит от структуры нейронов человеческого мозга.
Аналогия с нейронами мозга
В человеческом мозге около 86 миллиардов нейронов, которые взаимосвязаны и передают сигналы. Каждый нейрон получает входные сигналы от других нейронов, обрабатывает их, а затем передаёт другим нейронам. Процесс обучения — это процесс настройки силы этих связей.
Искусственные нейронные сети заимствуют эту идею, но значительно её упрощают.
Три базовых слоя
Типичная нейронная сеть делится на три слоя: входной слой, скрытый слой и выходной слой.
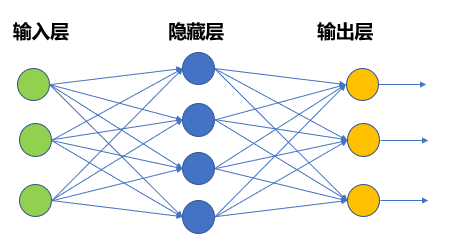
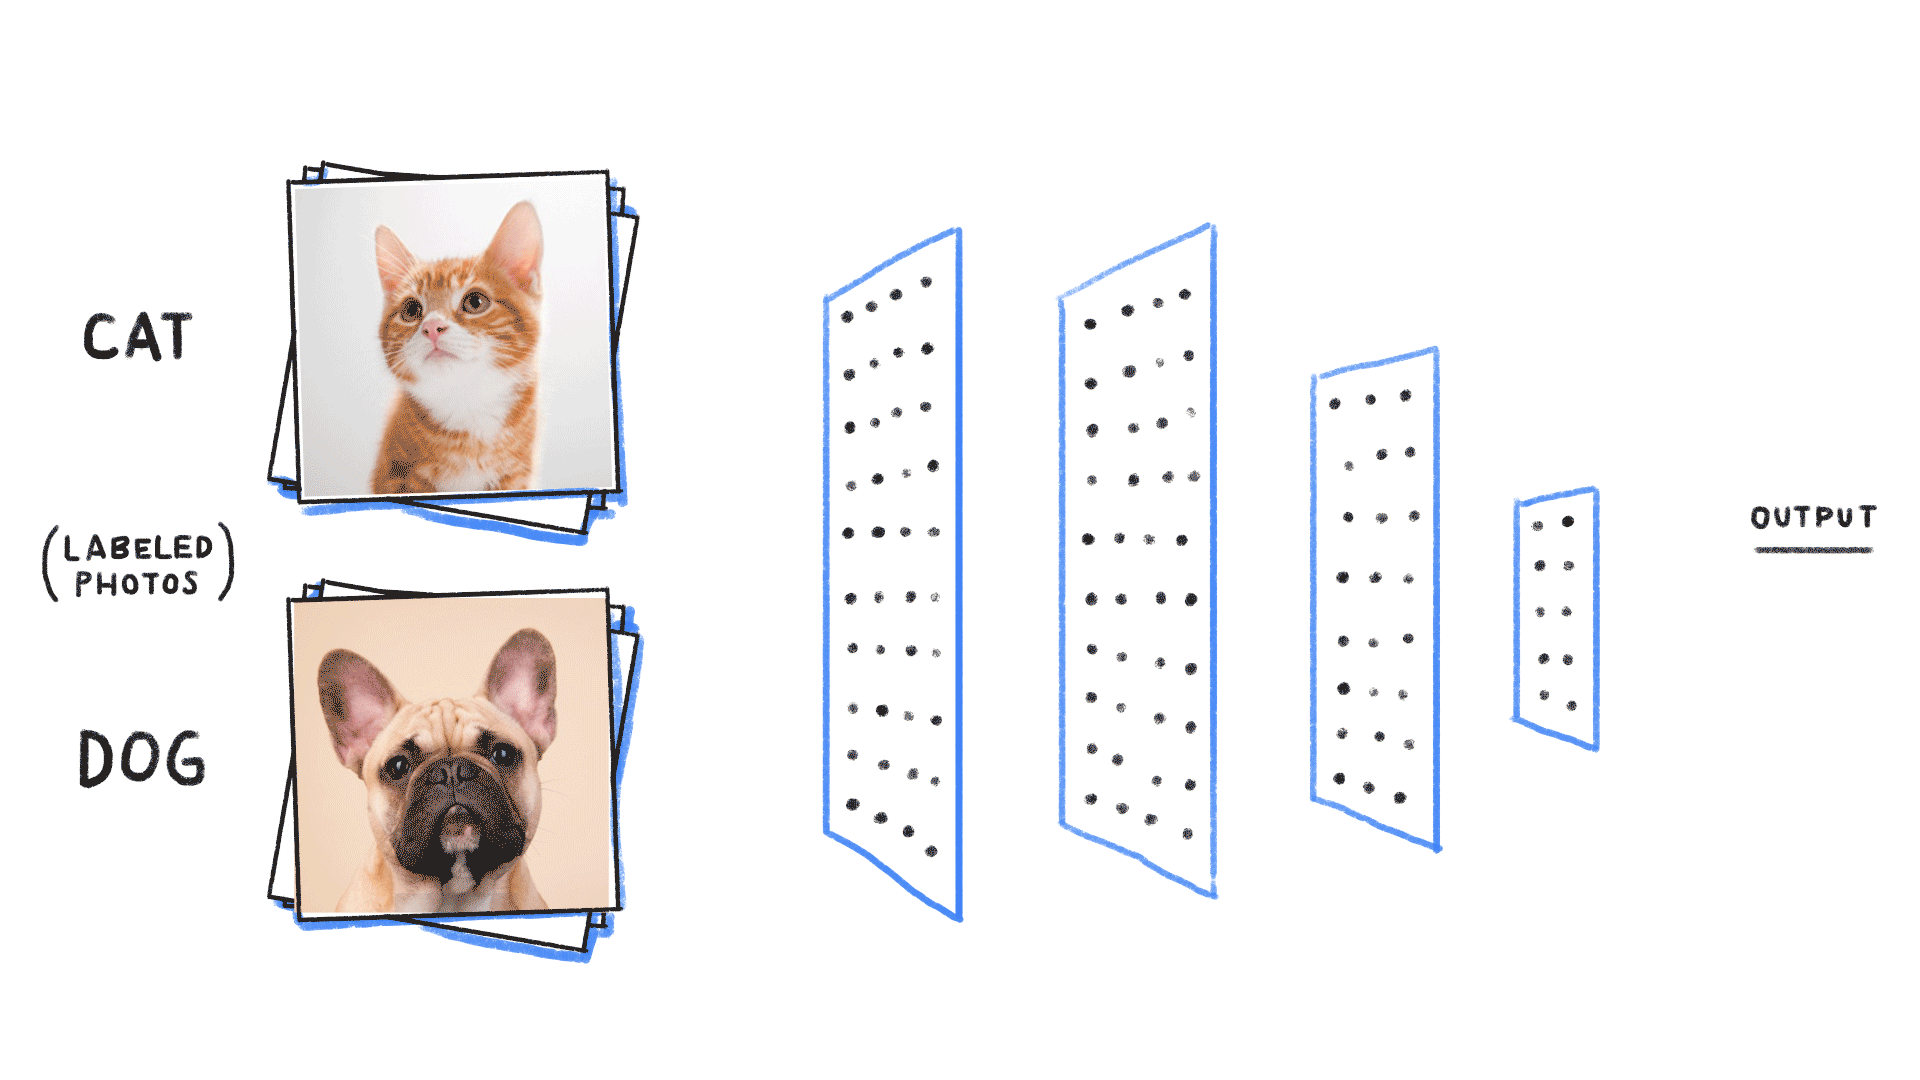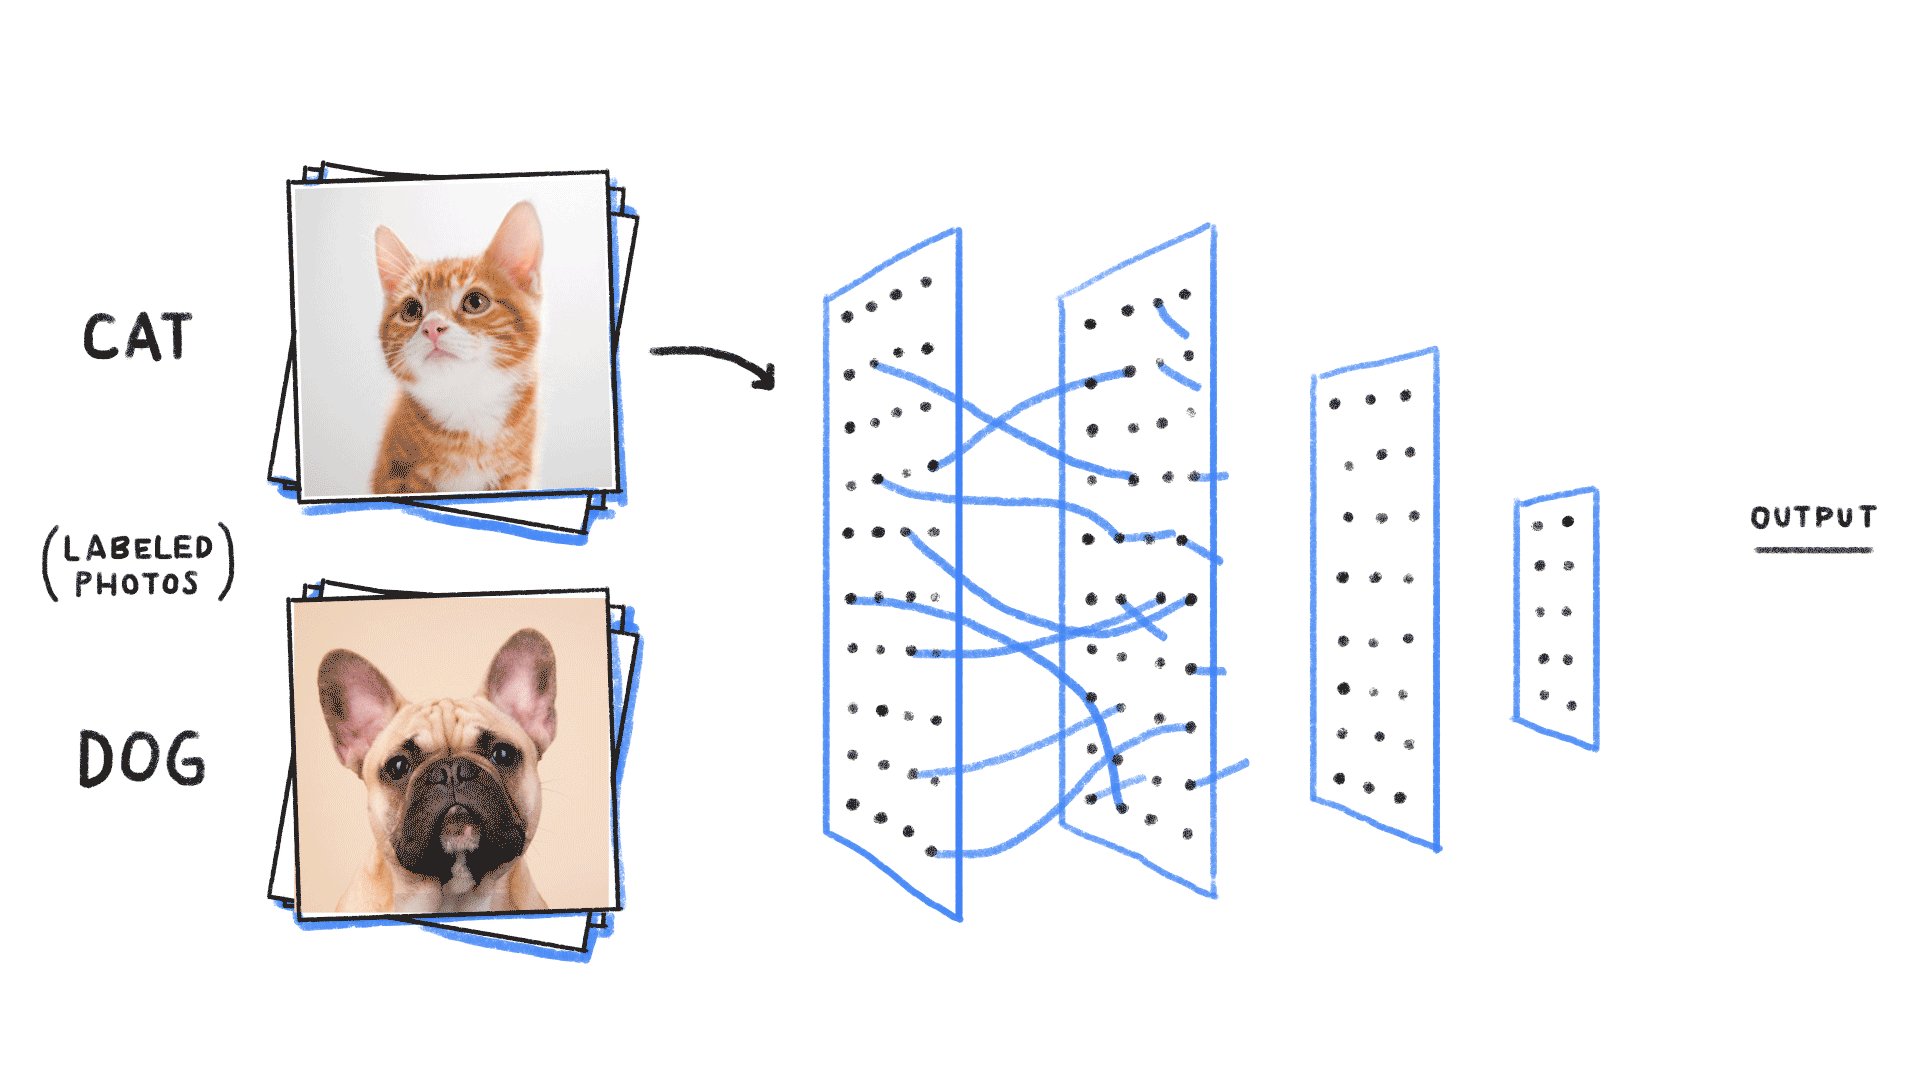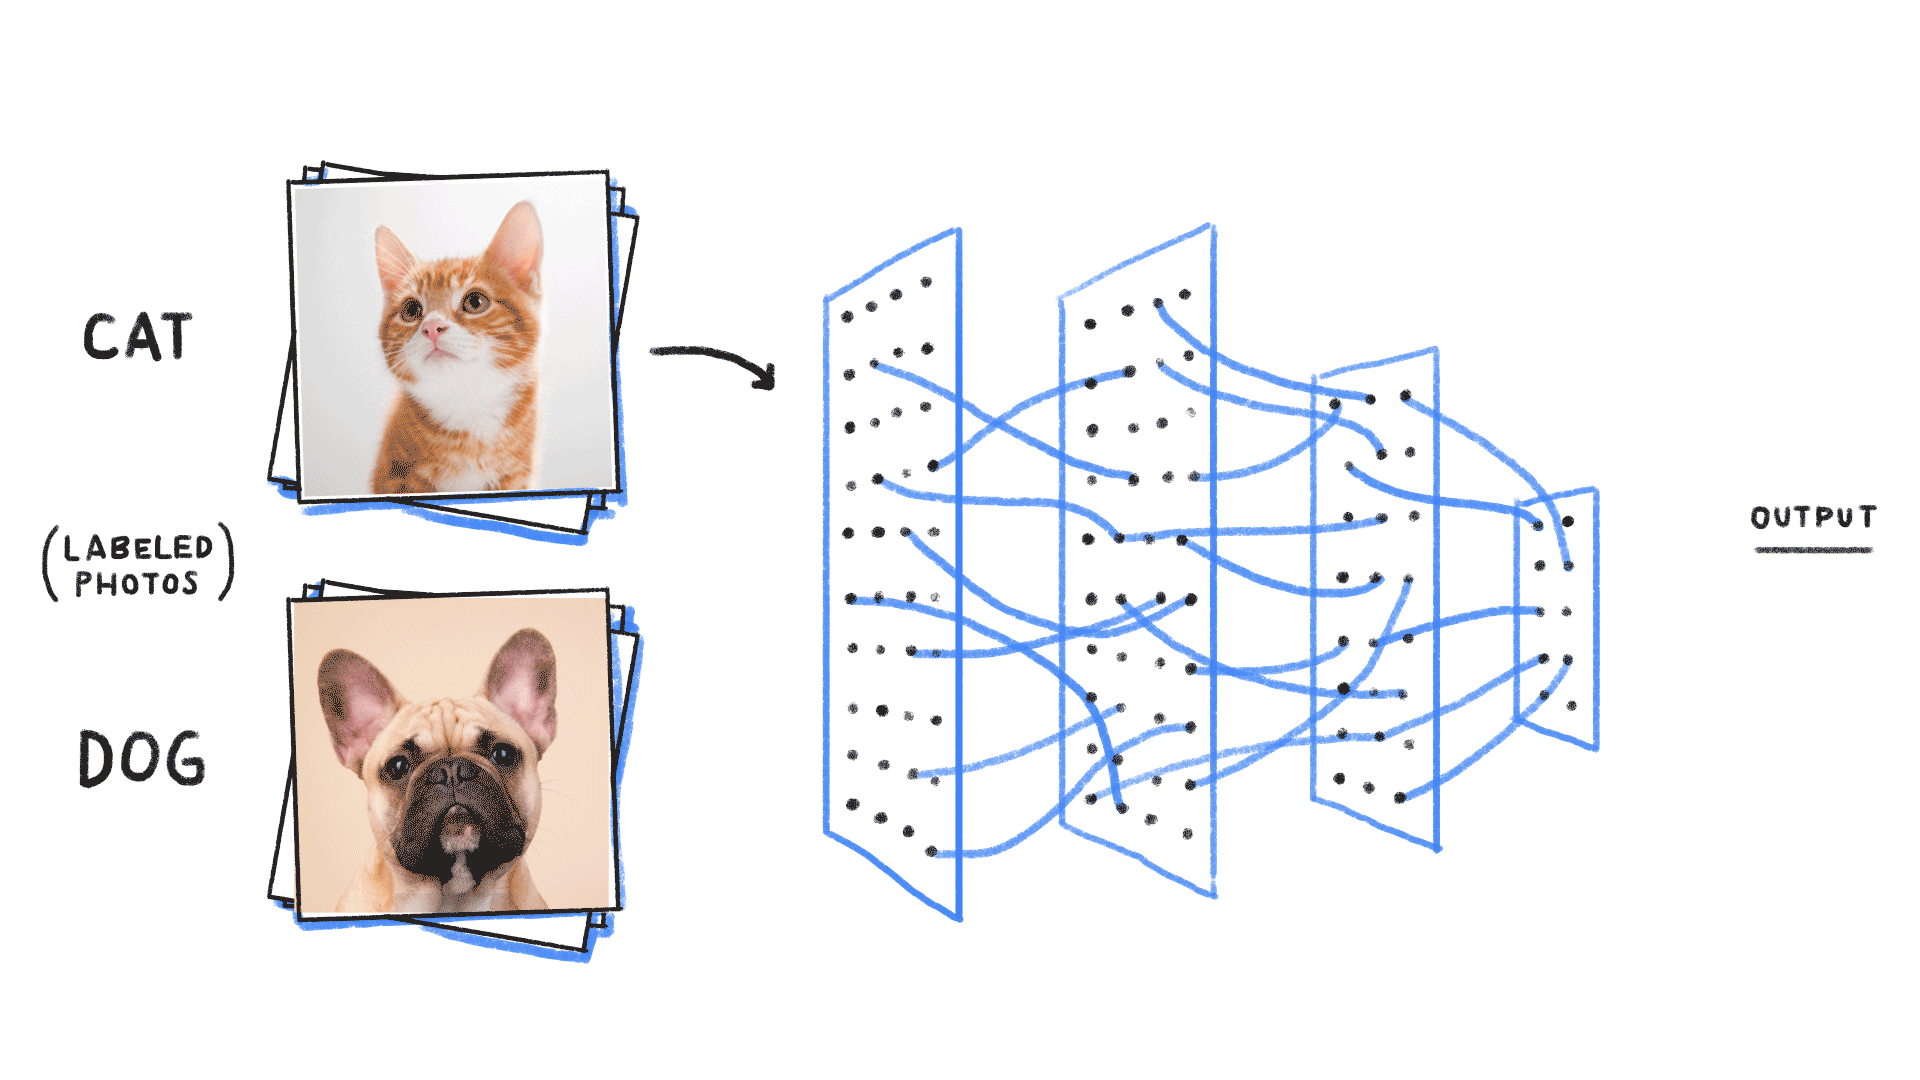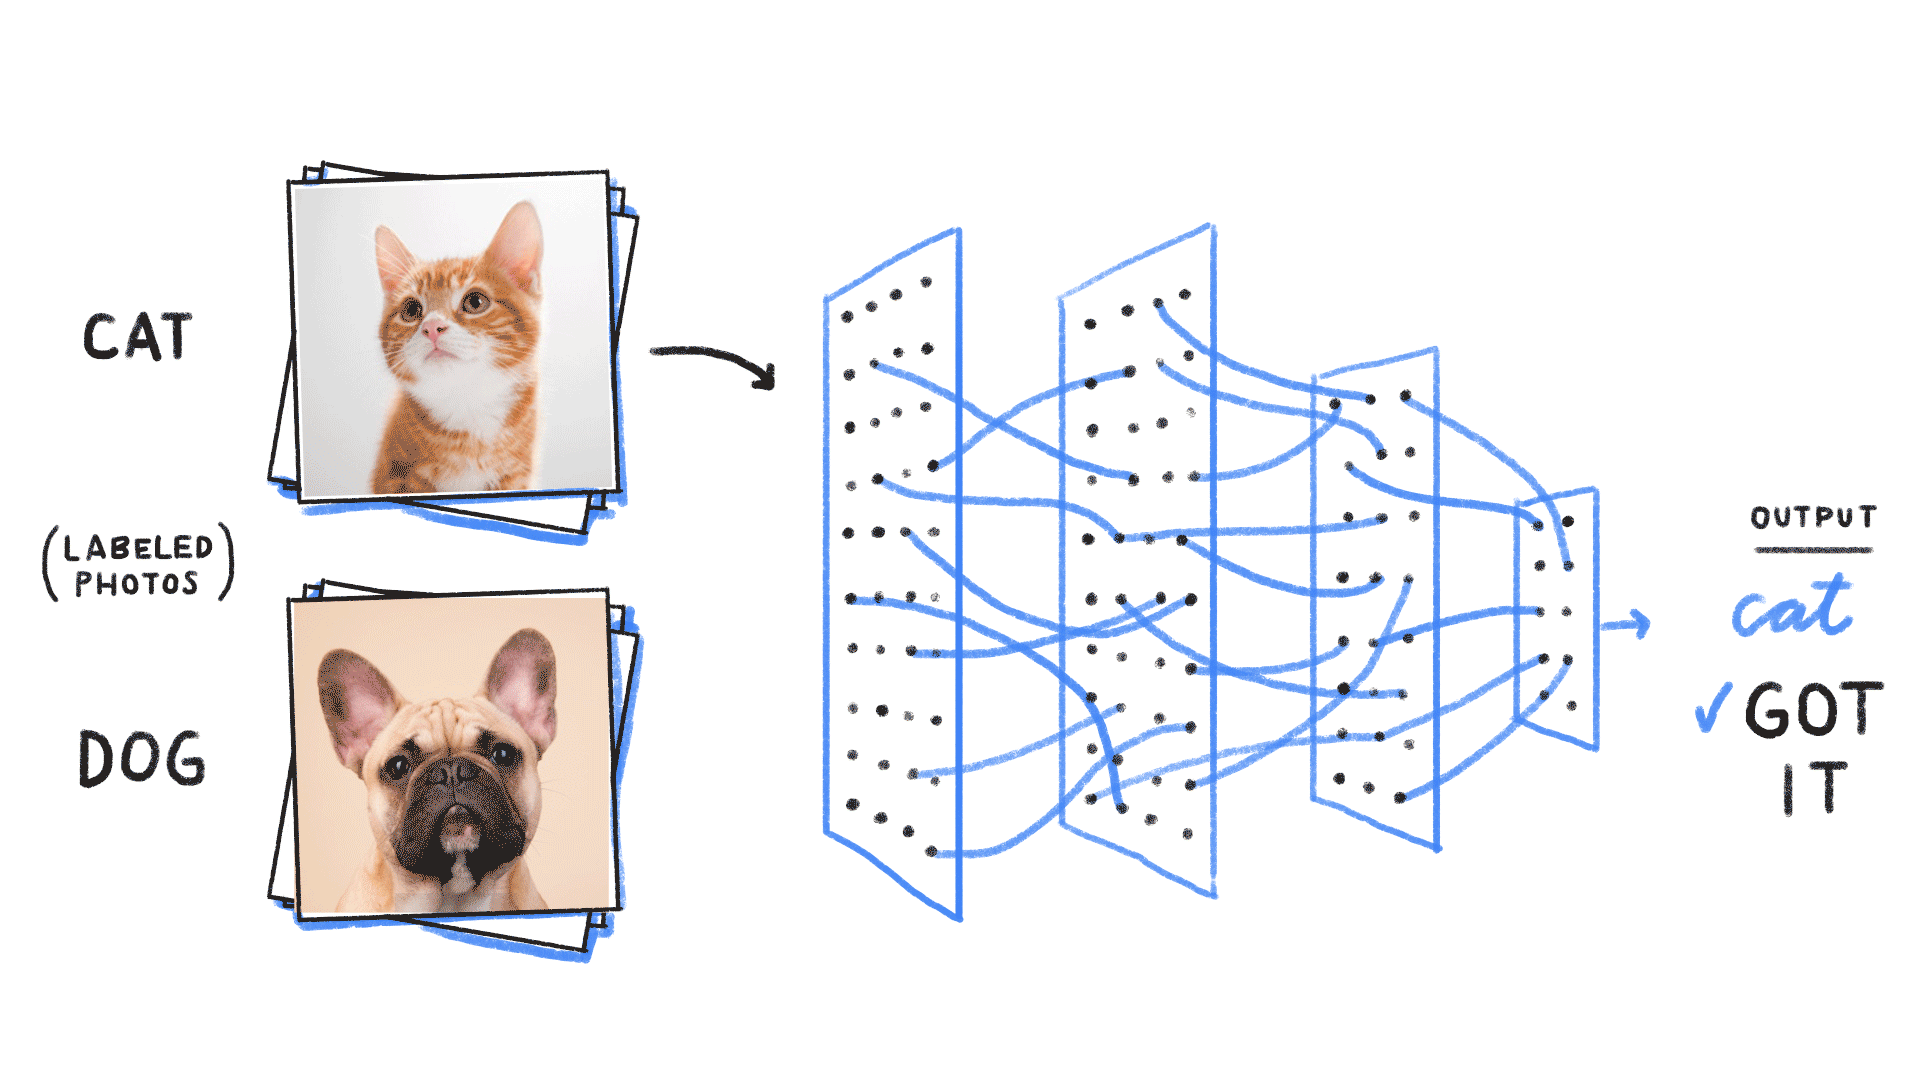
Мы используем пример распознавания: изображена ли на картинке кошка или собака:
| Слой | Функция | В этом примере |
|---|---|---|
| Входной слой | Получает исходные данные | Информация о каждом пикселе и цвете изображения |
| Скрытый слой | Извлекать признаки слой за слоем | Края → Текстуры → Органы, такие как уши и глаза |
| Выходной слой | Выдаёт окончательный результат | "вероятность 85%, что это кошка", "вероятность 15%, что это собака" |
В каждом слое много нейронов. Каждый нейрон получает выход предыдущего слоя, выполняет простое вычисление и передаёт его следующему слою.
-
Первый слой может распознать "здесь есть вертикальная линия" или "здесь есть круг".
-
Второй слой объединяет их: вертикальная линия плюс круг, возможно, — это ухо.
-
Третий слой продолжает объединять: два заострённых уха, усы, кошачьи глаза — это, весьма вероятно, кошка.
Удивительно то, что эти признаки не созданы людьми; модель изучает их из данных самостоятельно.
Простейший нейрон
Давайте с помощью нескольких строк кода на Python покажем, что делает нейрон:
Пример
# Базовая логика вычислений искусственного нейрона
# Никакой сложной математики, только взвешенная сумма + активация
# ============================================
def simple_neuron(inputs: list, weights: list, bias: float) -> float:
"""
Простейший нейрон
inputs: входные значения (от нейронов предыдущего слоя)
weights: веса (важность каждого входа, изучаемая во время обучения)
bias: смещение (порог, изучаемый во время обучения)
"""
# Шаг 1: взвешенная сумма
# Умножить каждый вход на соответствующий вес, затем сложить всё вместе
weighted_sum = 0.0
for input_value, weight in zip(inputs, weights):
weighted_sum += input_value * weight
# Добавить смещение
weighted_sum += bias
# Шаг 2: Функция активации (делает выход нелинейным)
# Здесь мы используем простейшую ReLU: отрицательные числа становятся 0, положительные остаются без изменений
output = max(0.0, weighted_sum)
return output
# Симуляция: нейрон, который определяет "это кошачье ухо"
# Вход: [заострённость, положение по высоте, есть мех]
inputs = [0.8, 0.9, 0.7] # Эти три признака все довольно очевидны
# Веса: выучены после обучения (в примере мы предполагаем, что эти значения уже хорошо выучены)
weights = [0.5, 0.4, 0.3]
# Смещение: порог
bias = -0.6
result = simple_neuron(inputs, weights, bias)
print(f"Выход нейрона: {result:.3f}")
print(f"Вердикт: {'вероятно, кошачье ухо' if result > 0 else 'маловероятно'}")
# Вывод: Выход нейрона: 0.660
# Вывод: Вердикт: вероятно, кошачье ухо
То, что делает этот нейрон, очень просто: взять взвешенную сумму входов, пропустить её через функцию активации и выдать результат.
Но когда тысячи таких нейронов соединены вместе и каждый слой изучает разные признаки, вся система порождает удивительный интеллект.
Запомните эту интуицию: нейронная сеть = множество простых вычислительных блоков, соединённых вместе, обучающихся путём настройки весов связей.
Обучение vs. инференс: два разных этапа
Жизненный цикл ИИ делится на два совершенно разных этапа: обучение и инференс.
Понимание разницы между этими двумя этапами поможет вам понять многое — например, почему обучение такое дорогое, а инференс относительно дешёвый.
Обучение: пусть ИИ учится
Обучение — это процесс: покажите модели большие объёмы данных, позвольте ей непрерывно корректировать параметры и делать прогнозы всё точнее и точнее.
Например, обучение модели распознавать кошек и собак:
-
1. Подготовьте миллионы размеченных изображений (это кошка, а то собака)
-
2. Пусть модель угадывает «что это?»; сначала она будет часто ошибаться
-
3. Скажите ей «ты ошиблась, это должна быть кошка», и позвольте ей скорректировать веса в сети
-
4. Повторяйте миллионы раз, пока модель не начнёт предсказывать всё точнее и точнее
Этап обучения требует огромных вычислительных ресурсов и данных.Большой модели могут потребоваться тысячи GPU, обучаемых в течение нескольких месяцев, что стоит миллионы долларов.
Инференс: как использовать ИИ
Инференс — это процесс: используйте обученную модель, подайте новый вход и получите выход.
Вы отправляете ChatGPT сообщение, он отвечает вам — это инференс.
Вы используете телефон, чтобы сфотографировать растение и определить его, — это тоже инференс.
Особенности инференса:
Не нужно настраивать параметры, достаточно использовать обученные веса для вычислений.
-
Обычно нужен только один GPU или даже чип телефона.
-
Стоимость намного ниже, чем при обучении.
Сравнение двух
| Измерение | Обучение | Инференс |
|---|---|---|
| Цель | Усваивает знания, настраивает веса | Применяет полученные знания, даёт ответы |
| Объём данных | Требуются огромные объёмы данных | Достаточно одного входного примера |
| Требования к вычислениям | Чрезвычайно высокие (тысячи GPU) | Относительно низкие (один GPU или телефон) |
| Стоимость | Чрезвычайно высокая (миллионы долларов) | Относительно низкие (несколько центов за раз) |
| Частота | Несколько раз или десятки раз | Миллионы раз в секунду |
| Кто это делает | Компании вроде OpenAI, Anthropic | Обычные пользователи или приложения |
По аналогии: обучение — это как «усердно учиться десять лет», а инференс — как «решать задачи на экзамене».
Учёба требует много времени и энергии, но как только вы её освоите, решение задач становится быстрым.
Когда вы используете ChatGPT, вы выполняете «инференс» — модель не «учится» и не «становится умнее» от ваших разговоров. Её знания заканчиваются в момент завершения обучения.
Введение в архитектуру Transformer
В 2017 году Google опубликовала статью под названием «Attention Is All You Need», в которой предложила архитектуру Transformer.
Эта статья изменила всю область ИИ. Сегодняшние большие языковые модели почти все основаны на Transformer.
Почему Transformer так важен?
До Transformer последовательные данные (например, предложения) обрабатывались с помощью RNN или LSTM.
Их проблема в том, что они могут обрабатывать только одно слово за раз, из-за чего трудно улавливать дальние зависимости.
Например: «Я оставил свой бумажник в кафе в Пекине. Когда я на следующий день вернулся, чтобы его поискать, ____ всё ещё был там». — вставьте «он» в пропуск. Вы знаете, что «он» относится к «бумажнику», потому что помните предыдущее содержание.
Когда старые модели обрабатывали «всё ещё там», они могли уже забыть о существовании «бумажника».
Прорыв Transformer заключается в следующем:Он может видеть всё предложение сразу и благодаря механизму внимания понимать, на каких словах сосредоточиться.
Энкодер и декодер
Полный Transformer делится на две части:
| Компонент | Функция | Типичные сценарии применения |
|---|---|---|
| Энкодер | Понимает входные данные и преобразует текст в векторные представления | Классификация текста, анализ тональности, семантический поиск |
| Декодер | Генерирует выходной текст на основе понимания | Написание текстов, перевод, генерация диалогов |
Некоторые модели используют только Encoder (например, BERT), некоторые — только Decoder (например, GPT), а некоторые — оба (например, T5).
Серия GPT, Claude и Llama используют архитектуры «Decoder-only» — их сильная сторона — генерация беглого текста.
Что такое механизм внимания?
Внимание — это ядро Transformer и ключ к его способности обрабатывать длинные тексты.
Аналогия: человеческое внимание при чтении
Когда вы читаете предложение, вы не прикладываете одинаковое усилие к каждому слову.
Например: «У него длинный хвост и треугольные уши» — когда вы видите «его», вы сосредотачиваетесь на «хвосте» и «ушах», чтобы определить, что это за животное.
Именно это и делает механизм внимания:На основе текущей обрабатываемой позиции он динамически решает, на какие слова во входных данных обращать внимание.

Демонстрация анимации:
На каждом шаге делается только одно: предсказать следующее слово на основе предыдущего контекста
Как вычисляется внимание?
Простыми словами, каждое слово генерирует три вектора:
-
Запрос:Какую информацию я ищу?
-
Ключ:Какую информацию я содержу?
-
Значение:Каково моё фактическое содержимое?
Вычислите сходство между запросом в каждой позиции и ключами во всех позициях, чтобы получить веса внимания, затем используйте эти веса для вычисления взвешенной суммы значений, что даёт выход для этой позиции.
Вам не нужно запоминать детали, просто запомните эту интуицию:Внимание = присвоение веса каждому слову в предложении, указывающего его важность для текущей позиции.
Почему внимание так важно?
Внимание даёт несколько ключевых преимуществ:
-
Во-первых, оно может улавливать дальние зависимости. Как бы далеко ни находились два слова, если они связаны, внимание может их соединить.
-
Во-вторых, оно поддерживает параллельные вычисления. В отличие от RNN, которые обрабатывают слово за словом, оно может обрабатывать всё предложение одновременно.
-
В-третьих, определённая степень интерпретируемости. Можно посмотреть на веса внимания и понять, на чём сосредоточена модель.
Например, при переводе «It has a long tail» видно, что когда модель переводит «it», внимание в основном сосредоточено на «tail».
Предобучение и тонкая настройка
Современные большие модели обычно используют двухэтапное обучение: предобучение + тонкая настройка.
Предобучение: изучение общих знаний на огромных объёмах данных
Предобучение работает так: берут большие объёмы текста из интернета (Википедия, книги, веб-страницы, код и т. д.) и заставляют модель делать одну вещь — предсказывать следующее слово.
Вы вводите «The weather today is really» и позволяете ей угадать, какое будет следующее слово.
-
Вы вводите «1 + 1 = » и позволяете ей угадать, какое будет следующее слово.
У этого процесса нет конкретной задачи; он просто позволяет модели в широком смысле изучать язык, знания, логику, код и так далее.
Предобучение — самая дорогая часть: много данных, огромные вычислительные ресурсы и большая длительность.
Тонкая настройка: оптимизация под конкретные задачи
Модель после предобучения очень эрудированна, но не обязательно послушна.
Если задать ей вопрос, она может продолжать бесконечно говорить вместо того, чтобы ответить прямо.
Если попросить её написать код, она может написать половину, а затем начать писать что-то другое.
Тонкая настройка использует высококачественные диалоговые данные для дальнейшего обучения модели, обучая её:
-
Понимать инструкции и выдавать результат так, как требуется
-
Поддерживать разговорный стиль и отказываться от вредных запросов
-
Выдавать более безопасный и полезный контент
-
Объём данных для тонкой настройки намного меньше, чем для предварительного обучения, но требования к качеству выше.
Понимание с помощью аналогии
-
Предварительное обучение похоже на чтение десяти тысяч книг — от начальной школы до университета, широко изучая всевозможные знания.
-
Тонкая настройка похожа на профессиональное обучение — после выпуска вы идёте работать в компанию и учитесь общаться с коллегами, писать электронные письма и выполнять рабочие задачи.
Предварительное обучение даёт модели знания; тонкая настройка делает модель пригодной для использования.
Именно поэтому среди больших моделей одни умны, но сложны в использовании, а другие средние, но просты в использовании — разница часто кроется в тонкой настройке.
Почему ИИ галлюцинирует?
Галлюцинация — одна из самых известных проблем ИИ: он может на полном серьёзе выдумывать несуществующие факты, имена, научные статьи и данные.
Понимание с точки зрения вероятностного предсказания
Чтобы понять галлюцинацию, сначала вернитесь к самому фундаментальному принципу работы ИИ:
Он не проверяет факты, а предсказывает наиболее вероятное следующее слово.
Вы спрашиваете: Кто изобрел телефон? — Он знает, чтоАлександр Грэм БеллЭта последовательность с наибольшей вероятностью появится.
Но вы спрашиваете: Кто изобрел пример учебного пособия? — В обучающих данных может не быть такой информации, но он выдумает правдоподобно звучащее имя на основе статистических закономерностей.
Он не знает того, чего не знает, — он знает лишь, что в этой позиции у этих слов самая высокая вероятность появления.
Распространённые причины галлюцинаций
| Причина | Объяснение | Пример |
|---|---|---|
| Недостаточно обучающих данных | Эта тема редко встречается в обучающих данных, поэтому модель плохо её усвоила | Постановка очень узкого профессионального вопроса |
| Отсечение знаний | События, произошедшие после даты отсечки обучающих данных, неизвестны модели | Запрос «Что произошло в 2025 году» (при условии, что модель обучалась в 2024 году) |
| Путаница в источниках | Смешивание информации из нескольких источников и получение ошибочного результата | «Чжан Сань написал статью A» (на самом деле её написал Ли Сы, но Чжан Сань и Ли Сы часто появляются вместе) |
| Переобучение | Запоминание шума во время обучения и принятие его за факт | Выдумывание несуществующих ссылок |
Как уменьшить влияние галлюцинаций
Как пользователь, вы можете сделать следующее:
-
Во-первых, проверяйте ключевую информацию. Когда речь идёт о медицине, праве, инвестициях, новостных фактах и т. п., обязательно проверяйте.
-
Во-вторых, попросите модель указать источники. Спросите её: «Каков источник этой информации?» «Можете дать ссылку?»
-
В-третьих, используйте генерацию с дополнением на основе поиска (RAG). Передайте модели собственные документы и заставьте её отвечать на основе этих документов, а не выдумывать.
-
В-четвёртых, используйте несколько моделей для перекрёстной проверки. Задайте один и тот же вопрос нескольким моделям; если все они говорят одно и то же, это более достоверно.
Другие расширенияПомните: как бы правдоподобно ни звучало то, что говорит ИИ, это может быть вымышлено. При принятии решений с высоким риском всегда сохраняйте скептицизм.