Cómo funciona la IA
Quizás te preguntes: solo quiero usar la IA, ¿por qué necesito entender cómo funciona?
La razón es simple: si sabes de dónde provienen las capacidades de la IA, podrás usarla mejor.
Sabrás cuándo confiar en ella y cuándo ponerla en duda.
-
Sabrás en qué es buena y en qué no.
-
Sabrás de dónde vienen las alucinaciones y cómo reducir su impacto.
Comprensión intuitiva de las redes neuronales
El núcleo de la IA moderna son lasredes neuronales, nombre que proviene de la estructura de las neuronas del cerebro humano.
Analogía con las neuronas del cerebro
El cerebro humano tiene alrededor de 86 mil millones de neuronas que se conectan entre sí y transmiten señales. Cada neurona recibe entradas de otras neuronas, las procesa y luego las envía a otras neuronas. El proceso de aprendizaje es el proceso de ajustar la fuerza de estas conexiones.
La red neuronal artificial se inspira en esta idea, pero la simplifica enormemente.
Estructura básica de tres capas
Una red neuronal típica se divide en tres capas: capa de entrada, capa oculta y capa de salida.
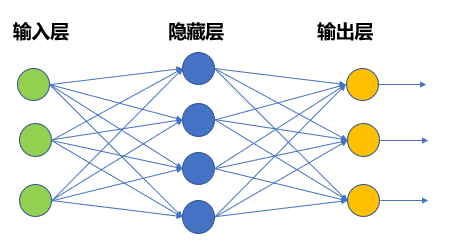
Usemos el ejemplo de reconocer si una imagen es un gato o un perro:
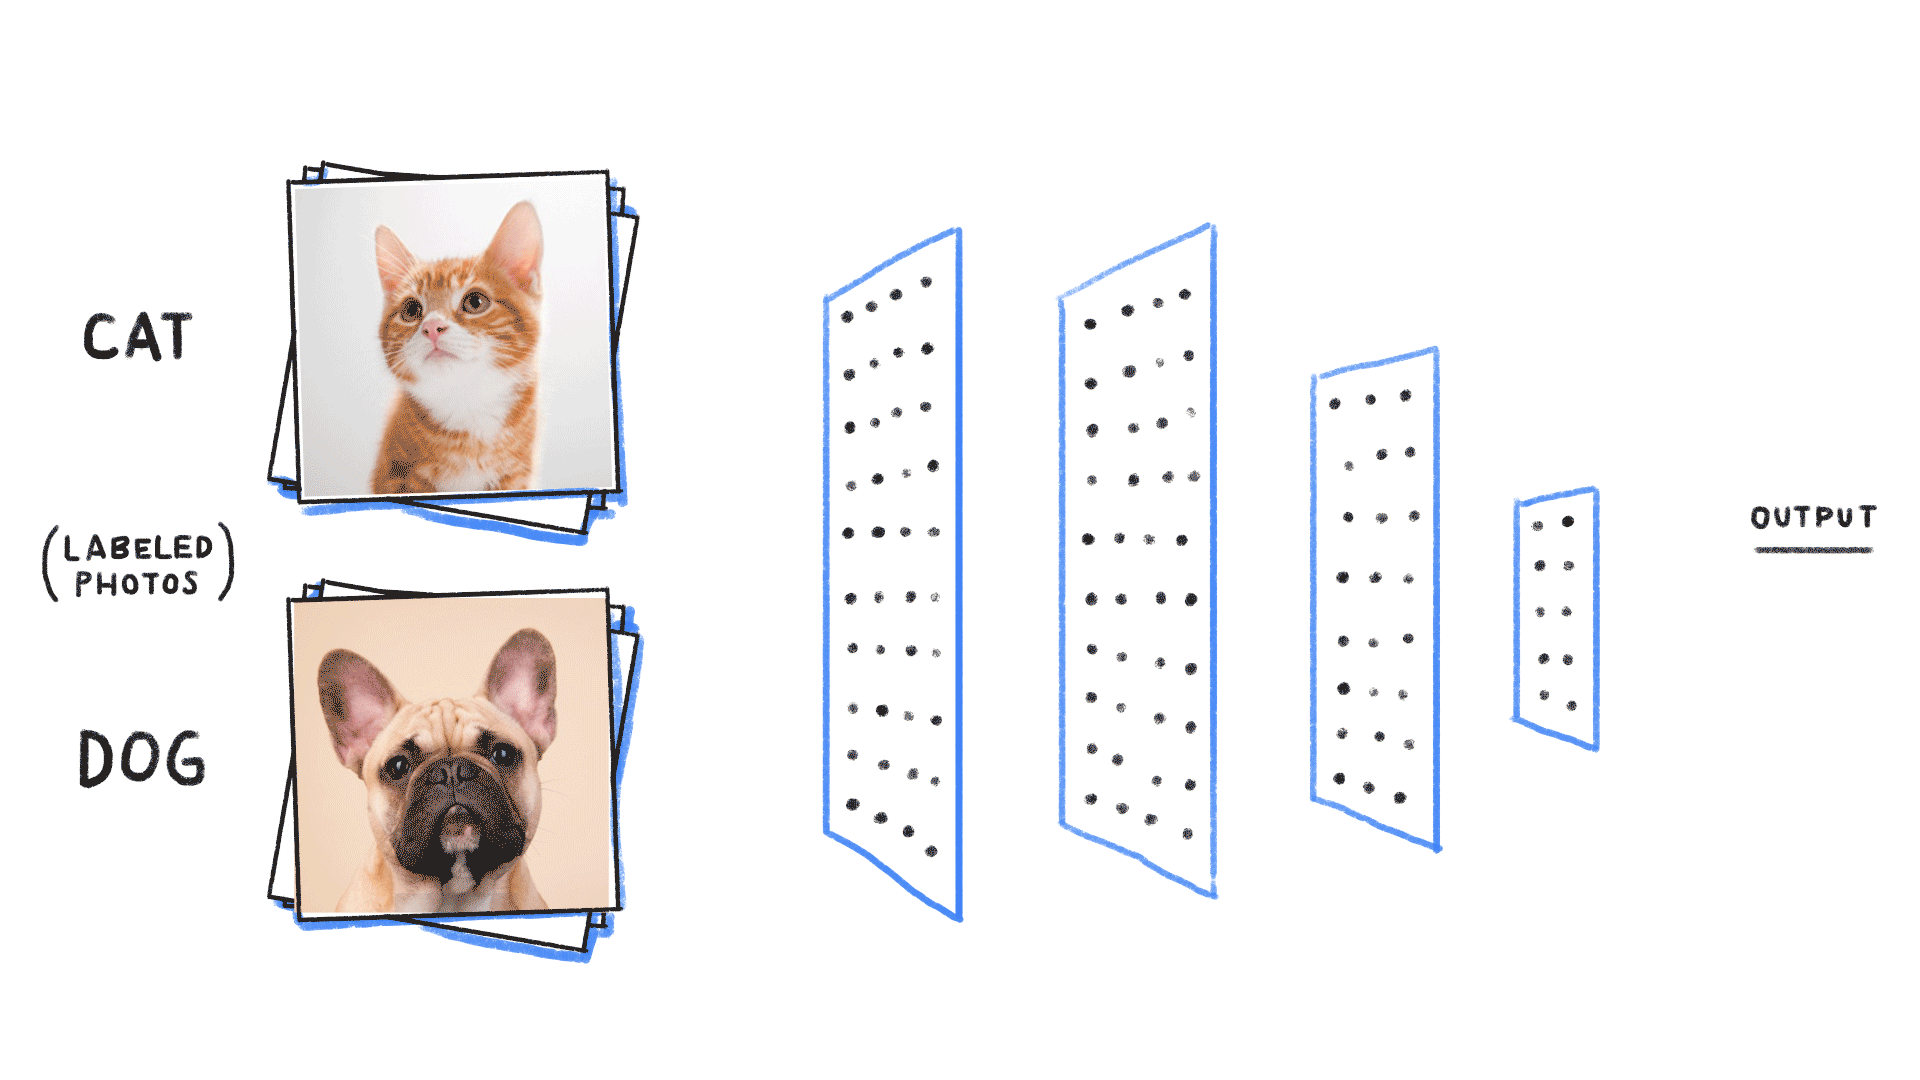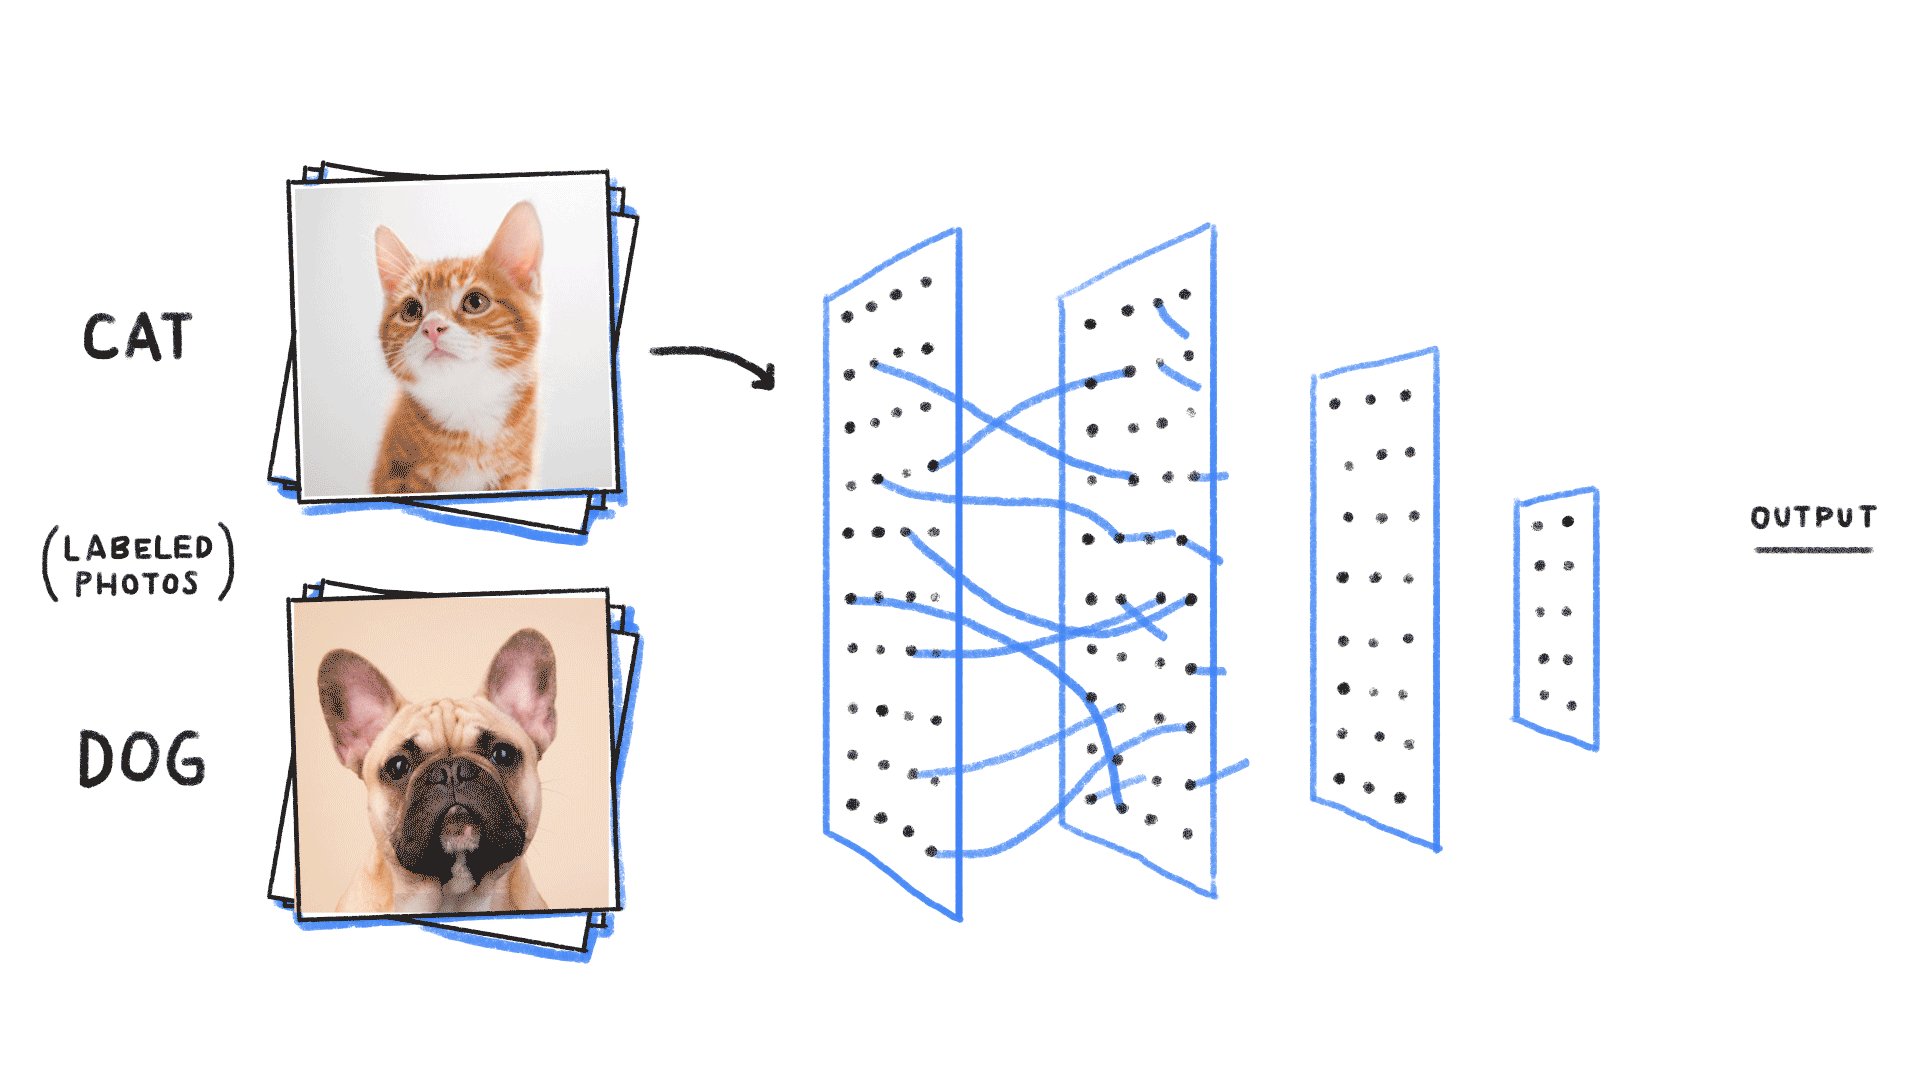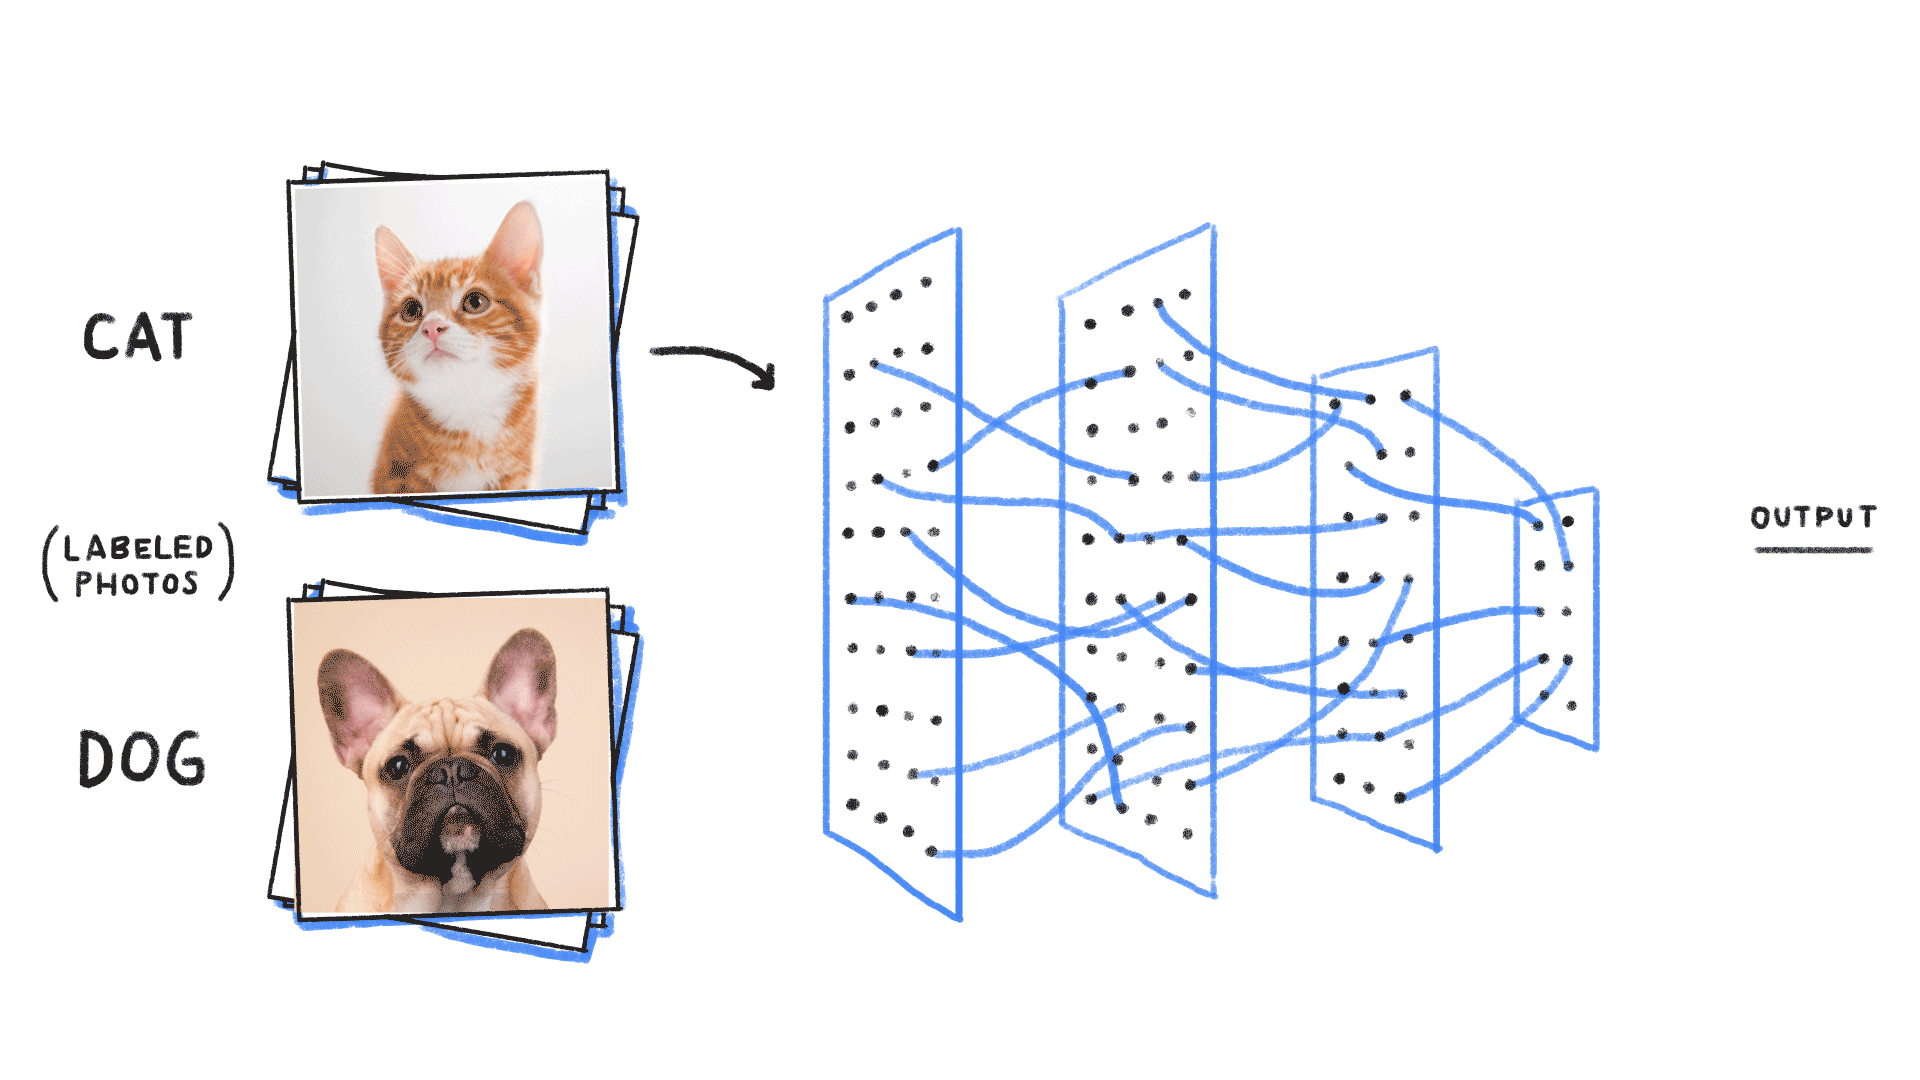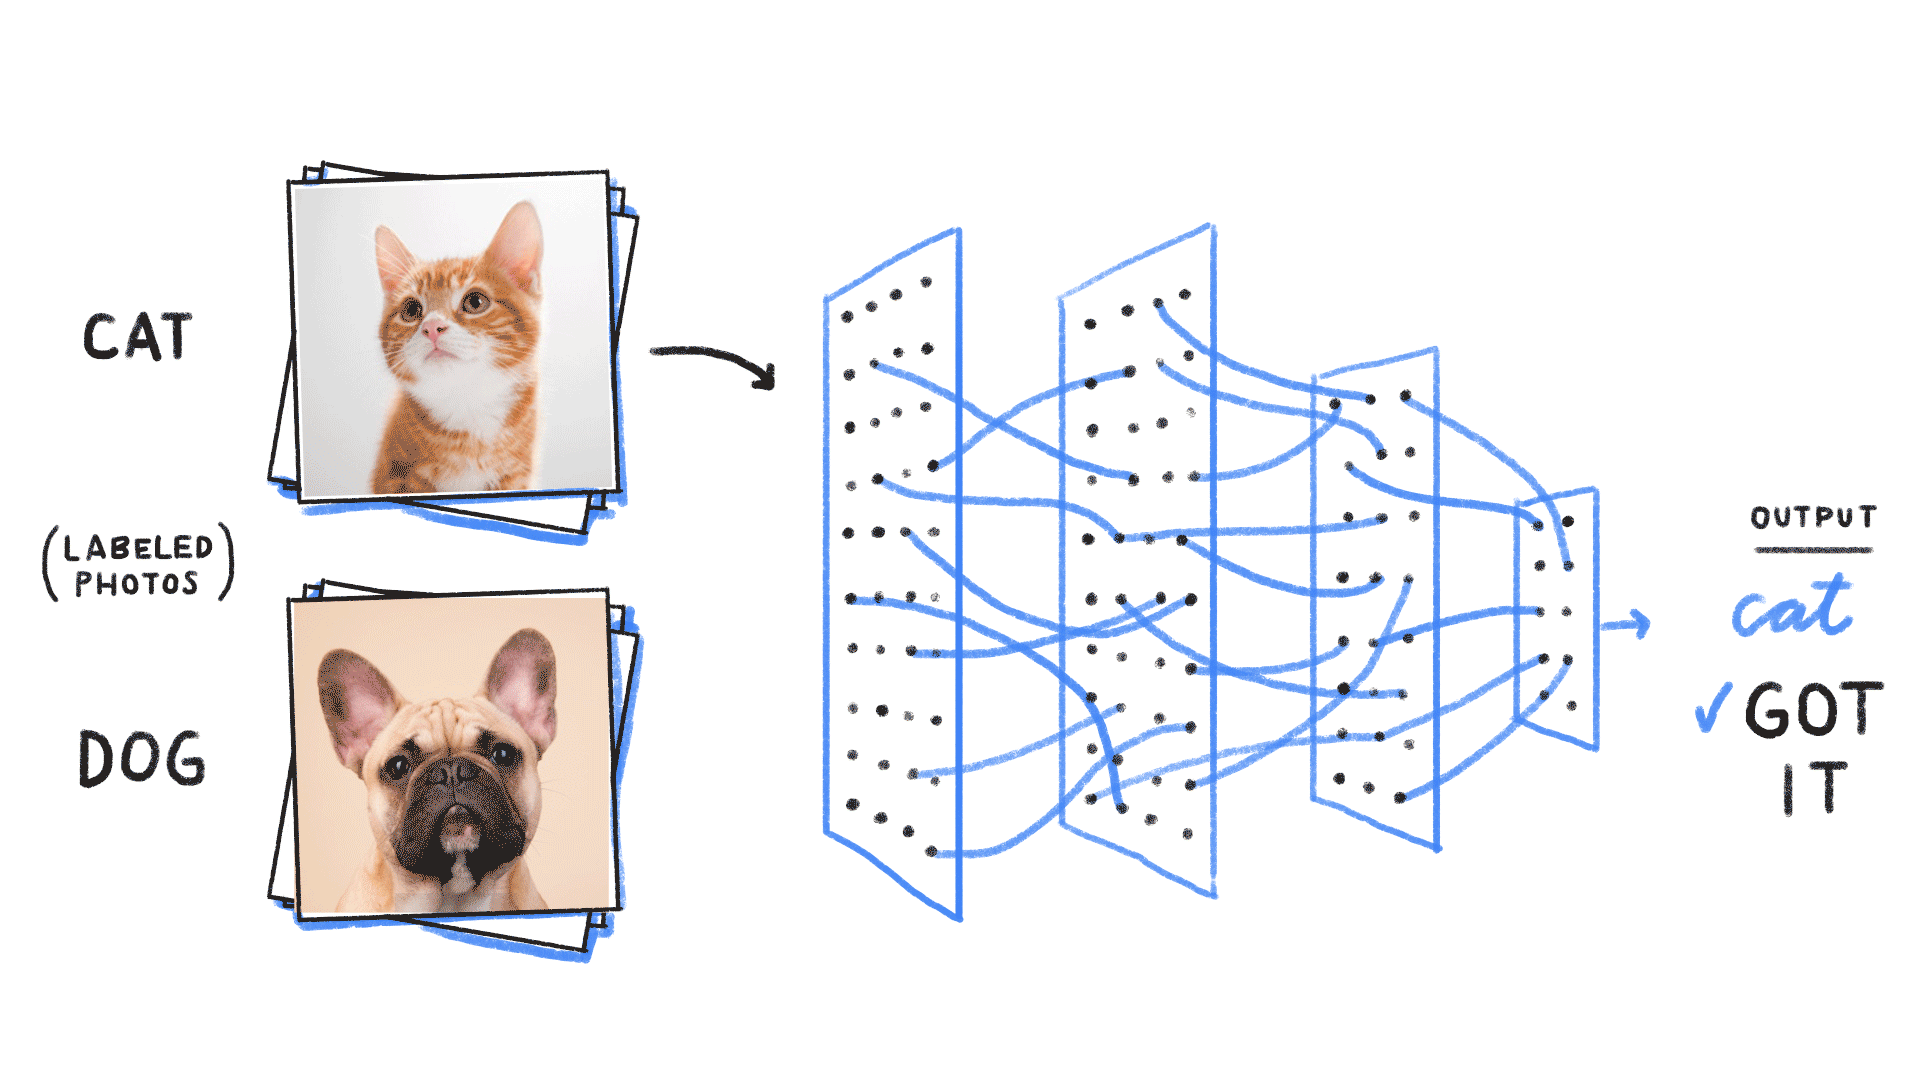
| Capa | Función | En este ejemplo |
|---|---|---|
| Capa de entrada | Recibe los datos brutos | Cada píxel de la imagen, información de color |
| Capa oculta | Extrae características capa por capa | Borde → textura → orejas, ojos y otros órganos |
| Capa de salida | Da el resultado final | "Probabilidad de ser gato: 85%", "Probabilidad de ser perro: 15%" |
Cada capa tiene muchas neuronas. Cada neurona recibe la salida de la capa anterior, hace un cálculo simple y lo transmite a la siguiente capa.
-
La primera capa puede reconocer que aquí hay una línea vertical, que aquí hay un círculo.
-
La segunda capa los combina: línea vertical + círculo, puede ser una oreja.
-
La tercera capa continúa combinando: dos orejas puntiagudas, bigotes, ojos de gato; esto probablemente sea un gato.
Lo asombroso es que estas características no son diseñadas por humanos; el modelo las aprende por sí mismo a partir de los datos.
Una neurona de lo más simple
Usemos unas pocas líneas de Python para mostrar qué hace una neurona:
Ejemplo
# Lógica básica de cálculo de una neurona artificial
# Sin matemáticas complejas, solo suma ponderada + activación
# ============================================
def simple_neuron(inputs: list, weights: list, bias: float) -> float:
"""
La neurona más simple
inputs: valores de entrada (de las neuronas de la capa anterior)
weights: pesos (importancia de cada entrada, aprendida durante el entrenamiento)
bias: sesgo (umbral, aprendido durante el entrenamiento)
"""
# Primer paso: suma ponderada
# Cada entrada se multiplica por su peso correspondiente y luego se suman
weighted_sum = 0.0
for input_value, weight in zip(inputs, weights):
weighted_sum += input_value * weight
# Añadir sesgo
weighted_sum += bias
# Segundo paso: función de activación (para que la salida sea no lineal)
# Aquí se usa la ReLU más simple: los negativos se convierten en 0, los positivos no cambian.
output = max(0.0, weighted_sum)
return output
# Simulación: una neurona que determina "si esto es o no una oreja de gato"
# Entrada: [grado de puntiagudez, altura de posición, si tiene pelo]
inputs = [0.8, 0.9, 0.7] # Estas tres características son bastante evidentes
# Pesos: aprendidos después del entrenamiento (en el ejemplo de ejemplo, suponemos que estos valores ya se han aprendido bien)
weights = [0.5, 0.4, 0.3]
# Sesgo: umbral
bias = -0.6
result = simple_neuron(inputs, weights, bias)
print(f"Salida de la neurona: {result:.3f}")
print(f"Juicio: {'podría ser orejas de gato' if result > 0 else 'no muy parecido'}")
# Salida: salida de la neurona: 0.660
# Salida: predicción: podría ser orejas de gato
Esta neurona hace algo muy simple: suma ponderada de las entradas, pasa por una función de activación y produce un resultado.
Pero cuando miles de neuronas de este tipo se conectan entre sí, y cada capa aprende características diferentes, el conjunto produce una inteligencia asombrosa.
Recuerda esta intuición: una red neuronal = muchas unidades de cálculo simples conectadas entre sí, que aprenden ajustando los pesos de las conexiones.
Entrenamiento vs. inferencia: dos etapas diferentes
El ciclo de vida de la IA se divide en dos etapas completamente diferentes: entrenamiento e inferencia.
Entender la diferencia entre estas dos etapas te ayudará a entender muchas cosas, como por qué el entrenamiento es tan caro y la inferencia es relativamente barata.
Entrenamiento: hacer que la IA aprenda
El entrenamiento es el proceso de mostrar al modelo una gran cantidad de datos para que ajuste continuamente sus parámetros y prediga cada vez con más precisión.
Por ejemplo, entrenar un modelo para reconocer gatos y perros:
-
1. Preparar millones de imágenes etiquetadas (esta es un gato, esa es un perro)
-
2. Hacer que el modelo adivine "¿qué es esto?"; al principio se equivocará mucho
-
3. Decirle "te equivocaste, debería ser un gato" y hacer que ajuste los pesos de la red
-
4. Repetir millones de veces hasta que las predicciones del modelo sean cada vez más precisas
La etapa de entrenamiento requiere una enorme capacidad de cómputo y datos.Un modelo grande puede necesitar varios miles de GPU entrenando durante meses, con un costo de millones de dólares.
Inferencia: hacer que la IA use lo aprendido
La inferencia es el proceso de usar el modelo entrenado, darle una nueva entrada y obtener una salida.
Le envías un mensaje a ChatGPT y te responde: eso es inferencia.
Usas tu teléfono para tomar una foto e identificar una planta: también es inferencia.
Las características de la inferencia son:
No necesita ajustar parámetros; solo usa los pesos entrenados para calcular.
-
Normalmente solo se necesita una GPU o incluso el chip de un teléfono para hacerlo.
-
El costo es mucho menor que el del entrenamiento.
Comparación entre ambos
| Dimensión | Entrenamiento | Inferencia |
|---|---|---|
| Objetivo | Aprender conocimiento, ajustar pesos | Aplicar el conocimiento aprendido, dar respuestas |
| Cantidad de datos | Requiere datos masivos | Basta con una sola entrada |
| Requisitos de cómputo | Extremadamente altos (miles de GPUs) | Relativamente bajos (una sola GPU o un teléfono) |
| Costo | Extremadamente alto (millones de dólares) | Relativamente bajo (fracciones de centavo por uso) |
| Frecuencia | Unas pocas o decenas de veces | Millones de veces por segundo |
| Quién lo hace | Empresas como OpenAI, Anthropic | Usuarios comunes o aplicaciones |
Una analogía: el entrenamiento es como "estudiar diez años en la adversidad", y la inferencia es como "ir al examen a resolver problemas".
Estudiar requiere mucho tiempo y esfuerzo, pero una vez que aprendes, resolver problemas es rápido.
Cuando usas ChatGPT, estás haciendo "inferencia": el modelo no "aprende" ni "se vuelve más inteligente" con tu conversación. Su conocimiento se limita al momento en que terminó el entrenamiento.
Introducción a la arquitectura Transformer
En 2017, Google publicó un artículo titulado "Attention Is All You Need", que proponía la arquitectura Transformer.
Este artículo cambió todo el campo de la IA. Hoy en día, casi todos los modelos de lenguaje grandes se basan en Transformer.
Por qué Transformer es tan importante
Antes de Transformer, para procesar datos secuenciales (como oraciones) se usaban RNN o LSTM.
Su problema era que solo podían procesar palabra por palabra, lo que dificultaba capturar relaciones de larga distancia.
Por ejemplo, esta frase: "Dejé mi billetera en una cafetería de Pekín, al día siguiente volví a buscarla, ____ todavía estaba." – En el espacio en blanco se escribe "ella", y sabes que "ella" se refiere a "billetera", porque recuerdas el contenido anterior.
Cuando el modelo antiguo procesaba "todavía estaba", quizás ya había olvidado la existencia de la "billetera".
El avance de Transformer radica en:Puede ver la frase completa a la vez y, mediante el mecanismo de atención, sabe en qué palabras debe centrarse.
Encoder y Decoder
Un Transformer completo se divide en dos partes:
| Componente | Función | Escenarios de aplicación típicos |
|---|---|---|
| Encoder (codificador) | Comprende la entrada y convierte el texto en representaciones vectoriales | Clasificación de texto, análisis de sentimientos, búsqueda semántica |
| Decoder (decodificador) | Genera texto de salida según la comprensión | Redacción, traducción, generación de diálogos |
Algunos modelos usan solo el Encoder (como BERT), otros solo el Decoder (como GPT), y algunos usan ambos (como T5).
La serie GPT, Claude y Llama son arquitecturas de "solo Decoder": su punto fuerte es generar texto fluido.
¿Qué es el mecanismo de atención?
La atención es el núcleo del Transformer y la clave para que pueda procesar textos largos.
Analogía: la atención al leer en humanos
Cuando lees una frase, no dedicas la misma atención a cada palabra.
Por ejemplo: "Tiene una cola larga y orejas triangulares": cuando ves "eso", te fijas principalmente en "cola" y "orejas" para determinar qué animal es.
Eso es exactamente lo que hace el mecanismo de atención:Según la posición que se está procesando, decide dinámicamente qué palabras de la entrada deben recibir atención.

Demostración animada:
En cada paso solo hace una cosa: según el texto anterior, adivina la siguiente palabra
Cómo se calcula la atención
En pocas palabras, cada palabra genera tres vectores:
-
Query (consulta):¿Qué información estoy buscando?
-
Key (clave):¿Qué información contengo?
-
Value (valor):¿Cuál es mi contenido real?
Se calcula la similitud entre el Query de cada posición y las Keys de todas las posiciones para obtener los pesos de atención, y luego se aplica una suma ponderada de los Values con esos pesos, obteniendo así la salida de esa posición.
No necesitas recordar los detalles, solo recuerda esta intuición:Atención = asignar un peso a cada palabra de la frase, que indica su importancia para la posición actual.
Por qué la atención es tan importante
La atención aporta varias ventajas clave:
-
Primero, puede capturar dependencias de largo alcance. No importa cuán separadas estén dos palabras, si están relacionadas, la atención puede conectarlas.
-
Segundo, es computable en paralelo. No necesita procesar palabra por palabra como las RNN; puede procesar toda la frase a la vez.
-
Tercero, ofrece cierta interpretabilidad. Puedes ver los pesos de atención y saber qué está mirando el modelo.
Por ejemplo, al traducir "Tiene una cola larga", puedes ver que cuando el modelo traduce "eso", la atención se centra principalmente en "cola".
Preentrenamiento y ajuste fino
Los grandes modelos actuales suelen usar un entrenamiento en dos fases: preentrenamiento + ajuste fino.
Preentrenamiento: aprender conocimientos generales a partir de datos masivos
El preentrenamiento funciona así: se toma una gran cantidad de texto de Internet (Wikipedia, libros, páginas web, código, etc.) y se le pide al modelo que haga una cosa: predecir la siguiente palabra.
Escribes "Hoy hace buen", y le pides que adivine cuál es la siguiente palabra.
-
Escribes "1 + 1 = ", y le pides que adivine cuál es la siguiente palabra.
Este proceso no tiene una tarea específica; simplemente permite que el modelo aprenda ampliamente lenguaje, conocimiento, lógica, código, etc.
El preentrenamiento es la parte más costosa: muchos datos, gran potencia de cálculo y mucho tiempo.
Ajuste fino: optimizar para tareas específicas
Aunque el modelo preentrenado es muy erudito, no necesariamente obedece bien.
Si le haces una pregunta, puede seguir hablando sin parar en lugar de responder directamente.
Si le pides que escriba código, puede empezar a escribir otra cosa a mitad de camino.
El ajuste fino consiste en usar datos de conversación de alta calidad para entrenar aún más el modelo y enseñarle a:
-
Comprender instrucciones y generar salidas según lo solicitado
-
Mantener el estilo conversacional y rechazar solicitudes dañinas
-
Producir contenido más seguro y útil
-
El volumen de datos del ajuste fino es mucho menor que el del preentrenamiento, pero los requisitos de calidad son más altos.
Comprenderlo con una analogía
-
El preentrenamiento es como leer miles de libros: desde la primaria hasta la universidad, aprender ampliamente todo tipo de conocimientos.
-
El ajuste fino es como la formación profesional: después de graduarte, vas a trabajar a una empresa y aprendes a comunicarte con los compañeros, escribir correos y completar tareas laborales.
El preentrenamiento da conocimiento al modelo; el ajuste fino lo hace útil.
Por eso, aunque todos son grandes modelos, algunos son inteligentes pero difíciles de usar, y otros son mediocres pero fáciles de usar: la diferencia suele estar en el ajuste fino.
Por qué la IA alucina
La alucinación (Hallucination) es uno de los problemas más conocidos de la IA: inventa con total seriedad hechos, nombres, artículos y datos que no existen.
Comprenderlo desde la perspectiva de la predicción de probabilidades
Para entender la alucinación, primero volvamos a la forma más fundamental en que trabaja la IA:
No está verificando hechos, sino prediciendo la siguiente palabra más probable.
Preguntas: ¿Quién inventó el teléfono? — Lo sabeAlexander Graham BellEsta secuencia es la más probable.
Pero preguntas: ¿Quién inventó el tutorial de ejemplo? — Es posible que esta información no esté en los datos de entrenamiento, pero según las regularidades estadísticas, inventará un nombre que suene plausible.
No sabe lo que no sabe; solo sabe que en esa posición, esas palabras tienen la mayor probabilidad de aparecer.
Causas comunes de las alucinaciones
| Causa | Explicación | Ejemplo |
|---|---|---|
| Datos de entrenamiento insuficientes | Este tema aparece muy poco en los datos de entrenamiento; el modelo no lo aprendió bien | Hacer una pregunta técnica muy de nicho |
| Fecha límite del conocimiento | Lo que ocurrió después de la fecha límite de los datos de entrenamiento, el modelo no lo sabe | Preguntar "¿Qué pasó en 2025?" (suponiendo que el modelo fue entrenado en 2024) |
| Confusión de fuentes | Mezcla información de múltiples fuentes y la combina incorrectamente | "Zhang San escribió el artículo A" (en realidad lo escribió Li Si, pero Zhang San y Li Si suelen aparecer juntos) |
| Sobreajuste | Durante el entrenamiento memorizó ruido y lo tomó como un hecho | Inventar citas que no existen |
Cómo reducir el impacto de las alucinaciones
Como usuario, puedes hacer lo siguiente:
-
Primero, verifica la información crítica. Cuando se trate de medicina, derecho, inversiones, hechos noticiosos, etc., siempre debes comprobarla.
-
Segundo, pide al modelo que proporcione fuentes. Pregúntale: "¿Cuál es la fuente de esta información?", "¿Puedes darme las referencias?"
-
Tercero, usa la generación aumentada por recuperación (RAG). Alimenta al modelo con tus propios documentos y haz que responda basándose en ellos, en lugar de inventar.
-
Cuarto, haz una validación cruzada con varios modelos. Pregunta lo mismo a varios modelos; si todos dicen lo mismo, es más confiable.
Otras extensionesRecuerda: lo que dice la IA, por muy real que suene, puede ser inventado. Ante decisiones de alto riesgo, mantén siempre la duda.