Fonctionnement de l'IA
Vous pourriez demander : je veux juste utiliser l'IA, pourquoi devrais-je comprendre comment elle fonctionne ?
La raison est simple : si vous savez d'où viennent les capacités de l'IA, vous pouvez mieux l'utiliser.
Vous saurez quand lui faire confiance et quand la remettre en question.
-
Vous saurez ce en quoi il est bon et ce en quoi il n'est pas bon.
-
Vous saurez d'où viennent les hallucinations et comment réduire leur impact.
Compréhension intuitive des réseaux de neurones
Le cœur de l'IA moderne estles réseaux de neurones, un nom qui vient de la structure neuronale du cerveau humain.
Analogie avec les neurones du cerveau
Le cerveau humain compte environ 86 milliards de neurones interconnectés qui transmettent des signaux. Chaque neurone reçoit des entrées d'autres neurones, les traite, puis émet vers d'autres neurones. Le processus d'apprentissage est le processus d'ajustement de la force de ces connexions.
Les réseaux de neurones artificiels empruntent cette idée mais la simplifient grandement.
Trois couches de base
Un réseau de neurones typique est divisé en trois couches : couche d'entrée, couche cachée et couche de sortie.
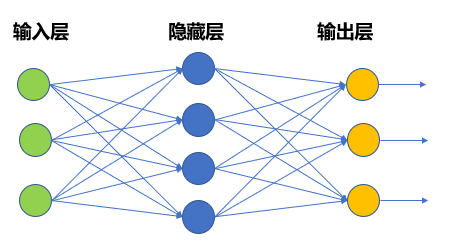
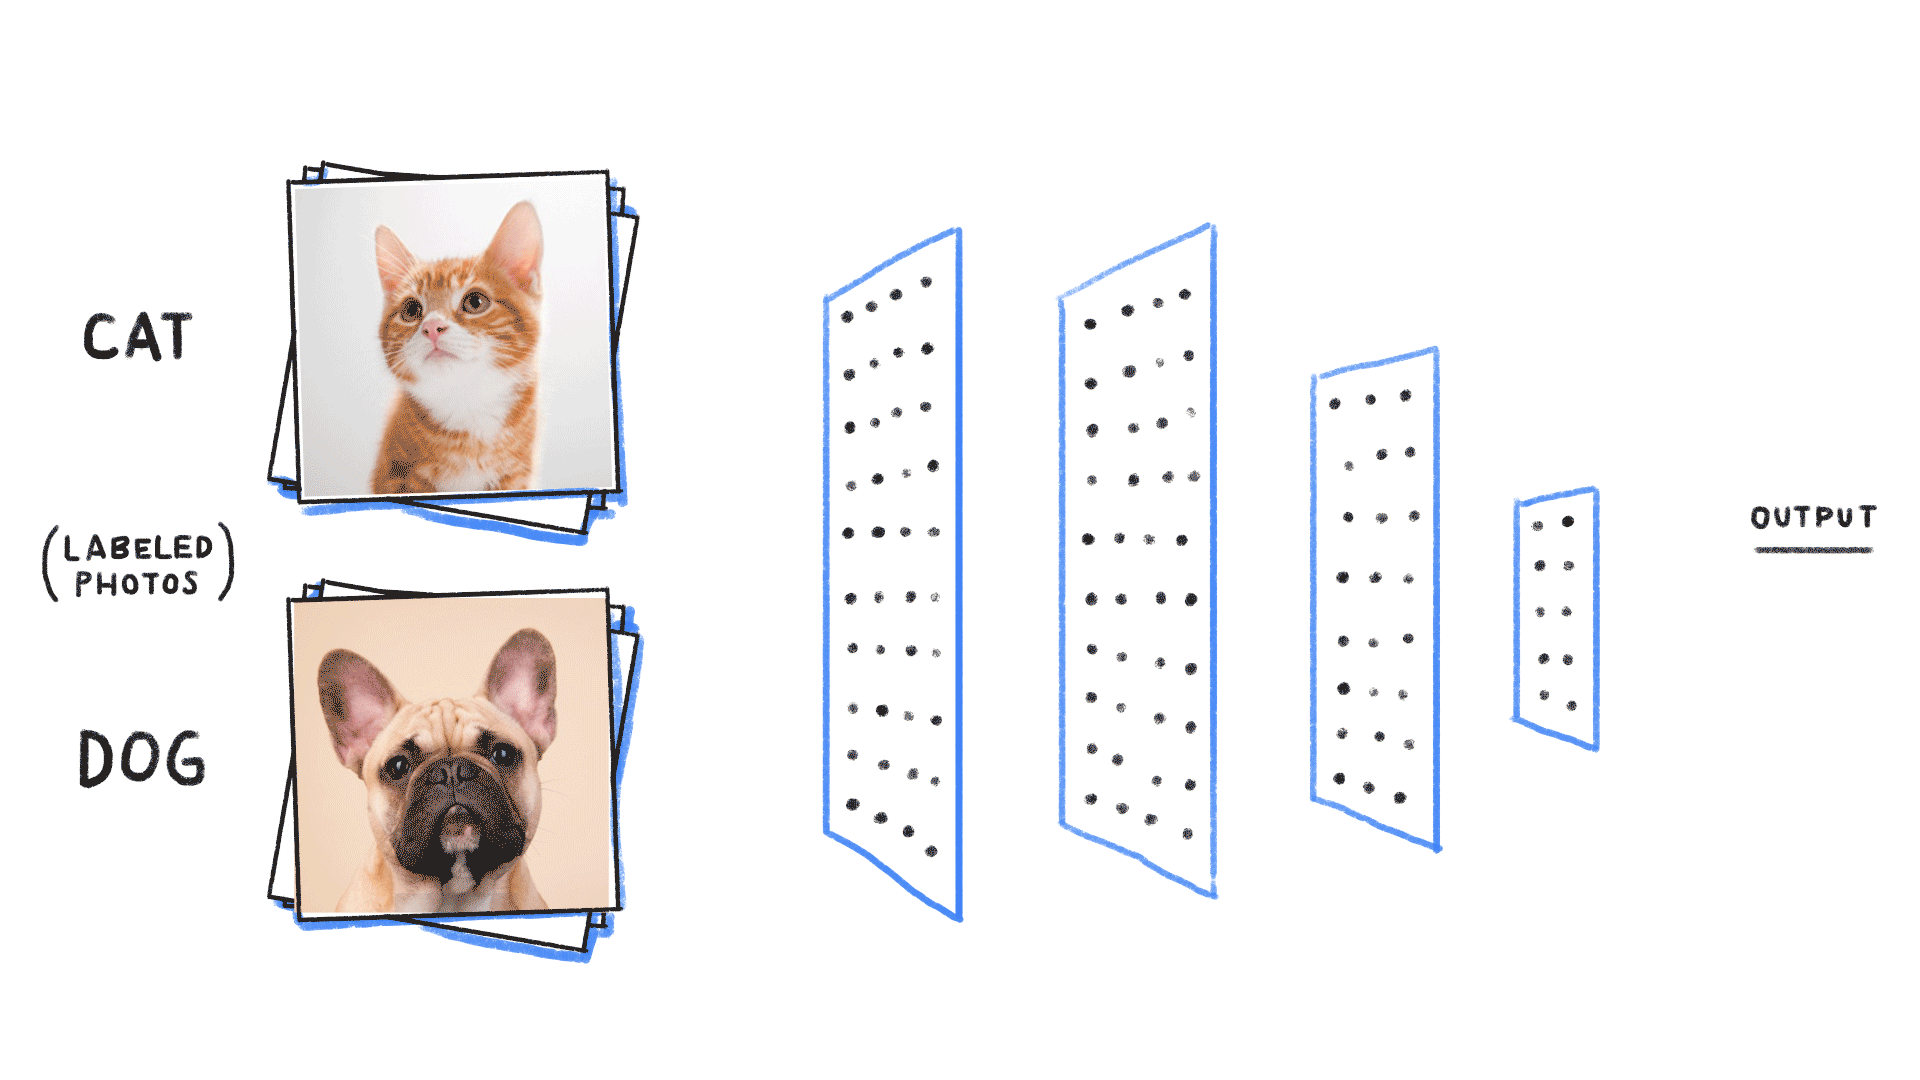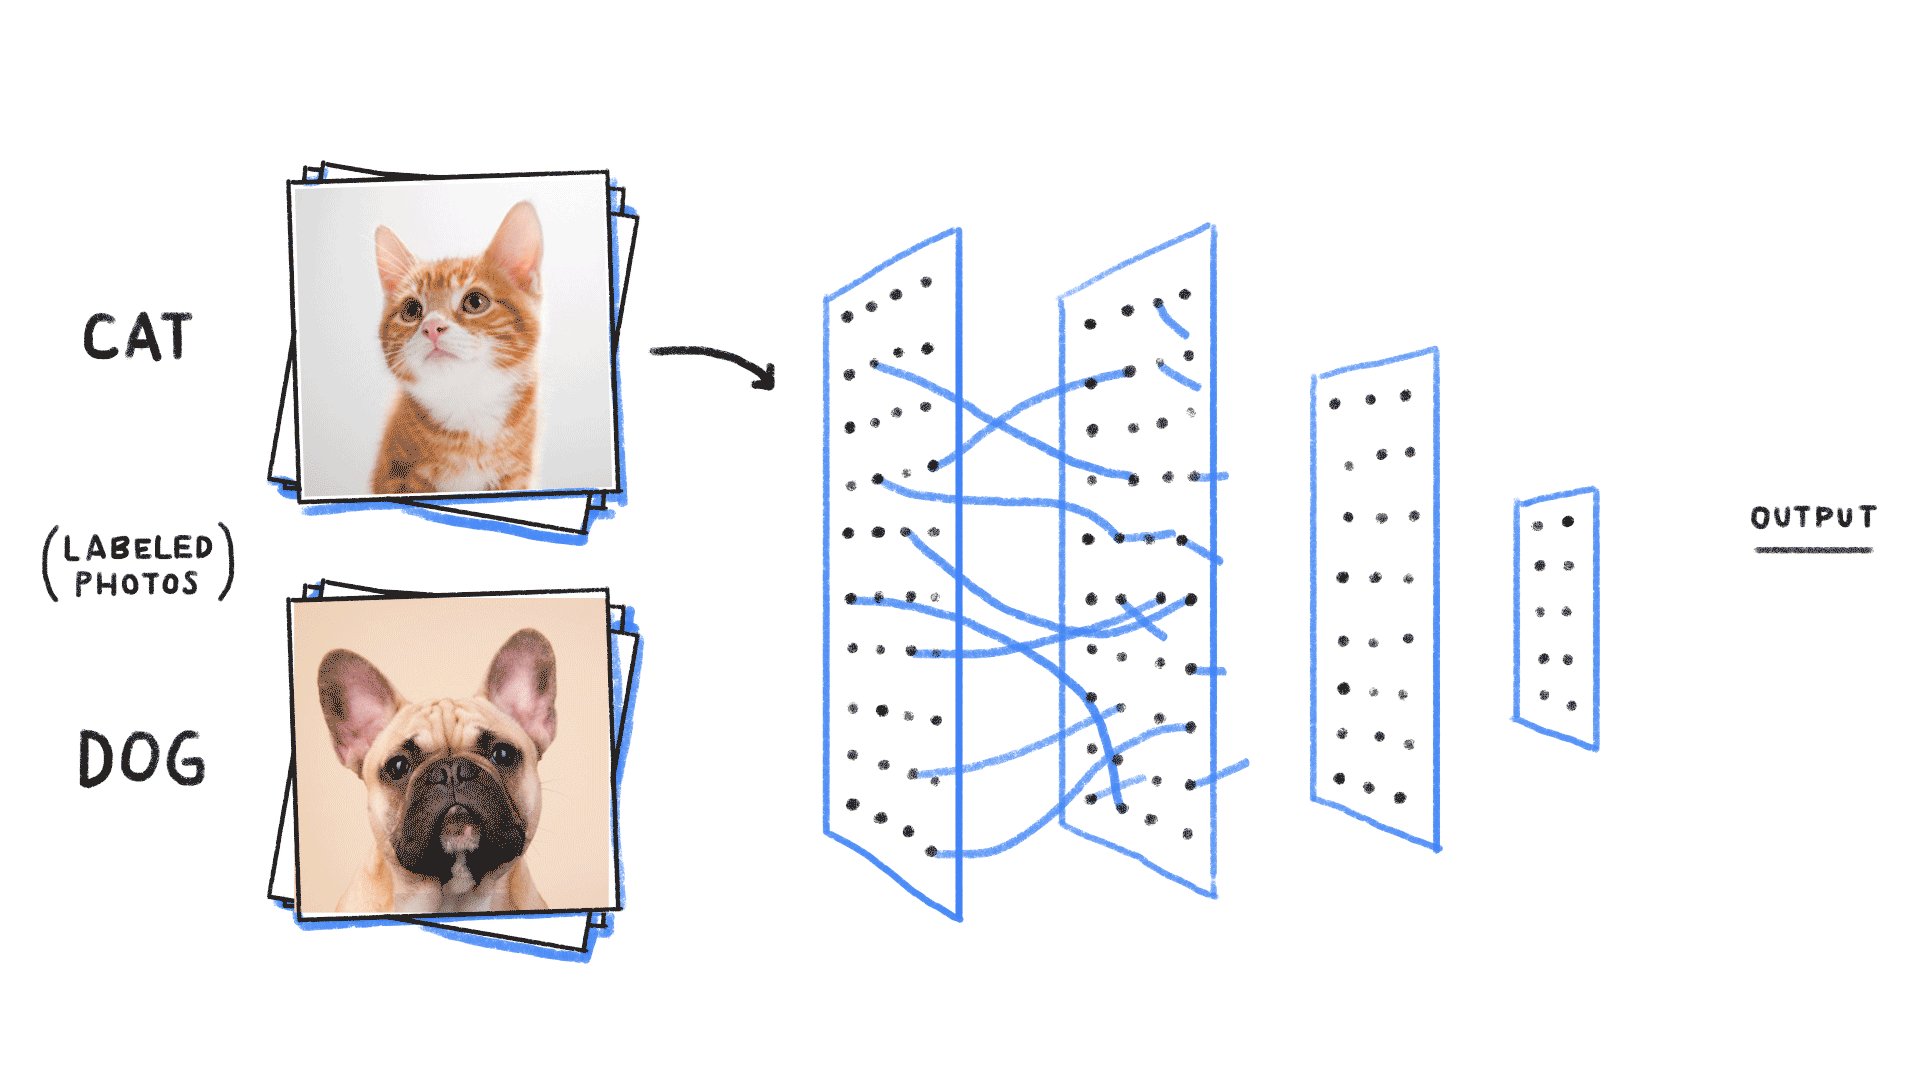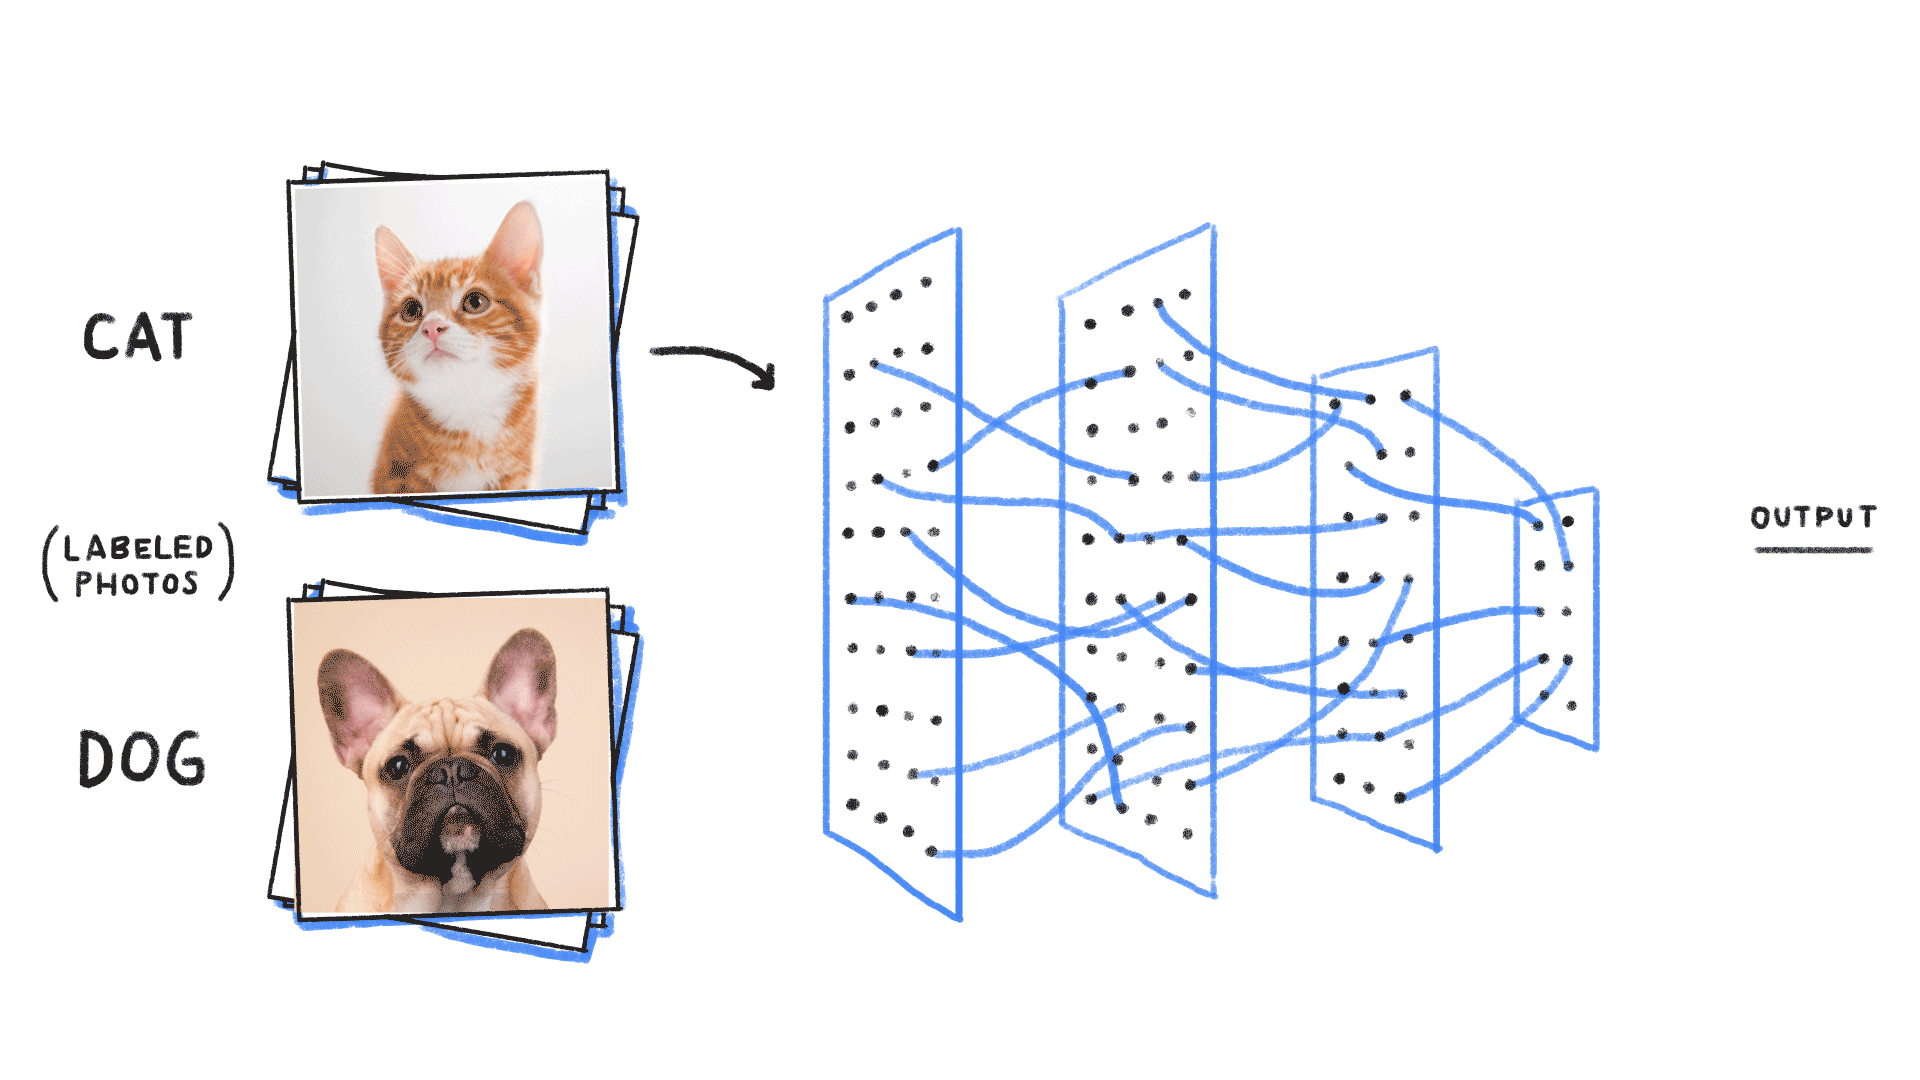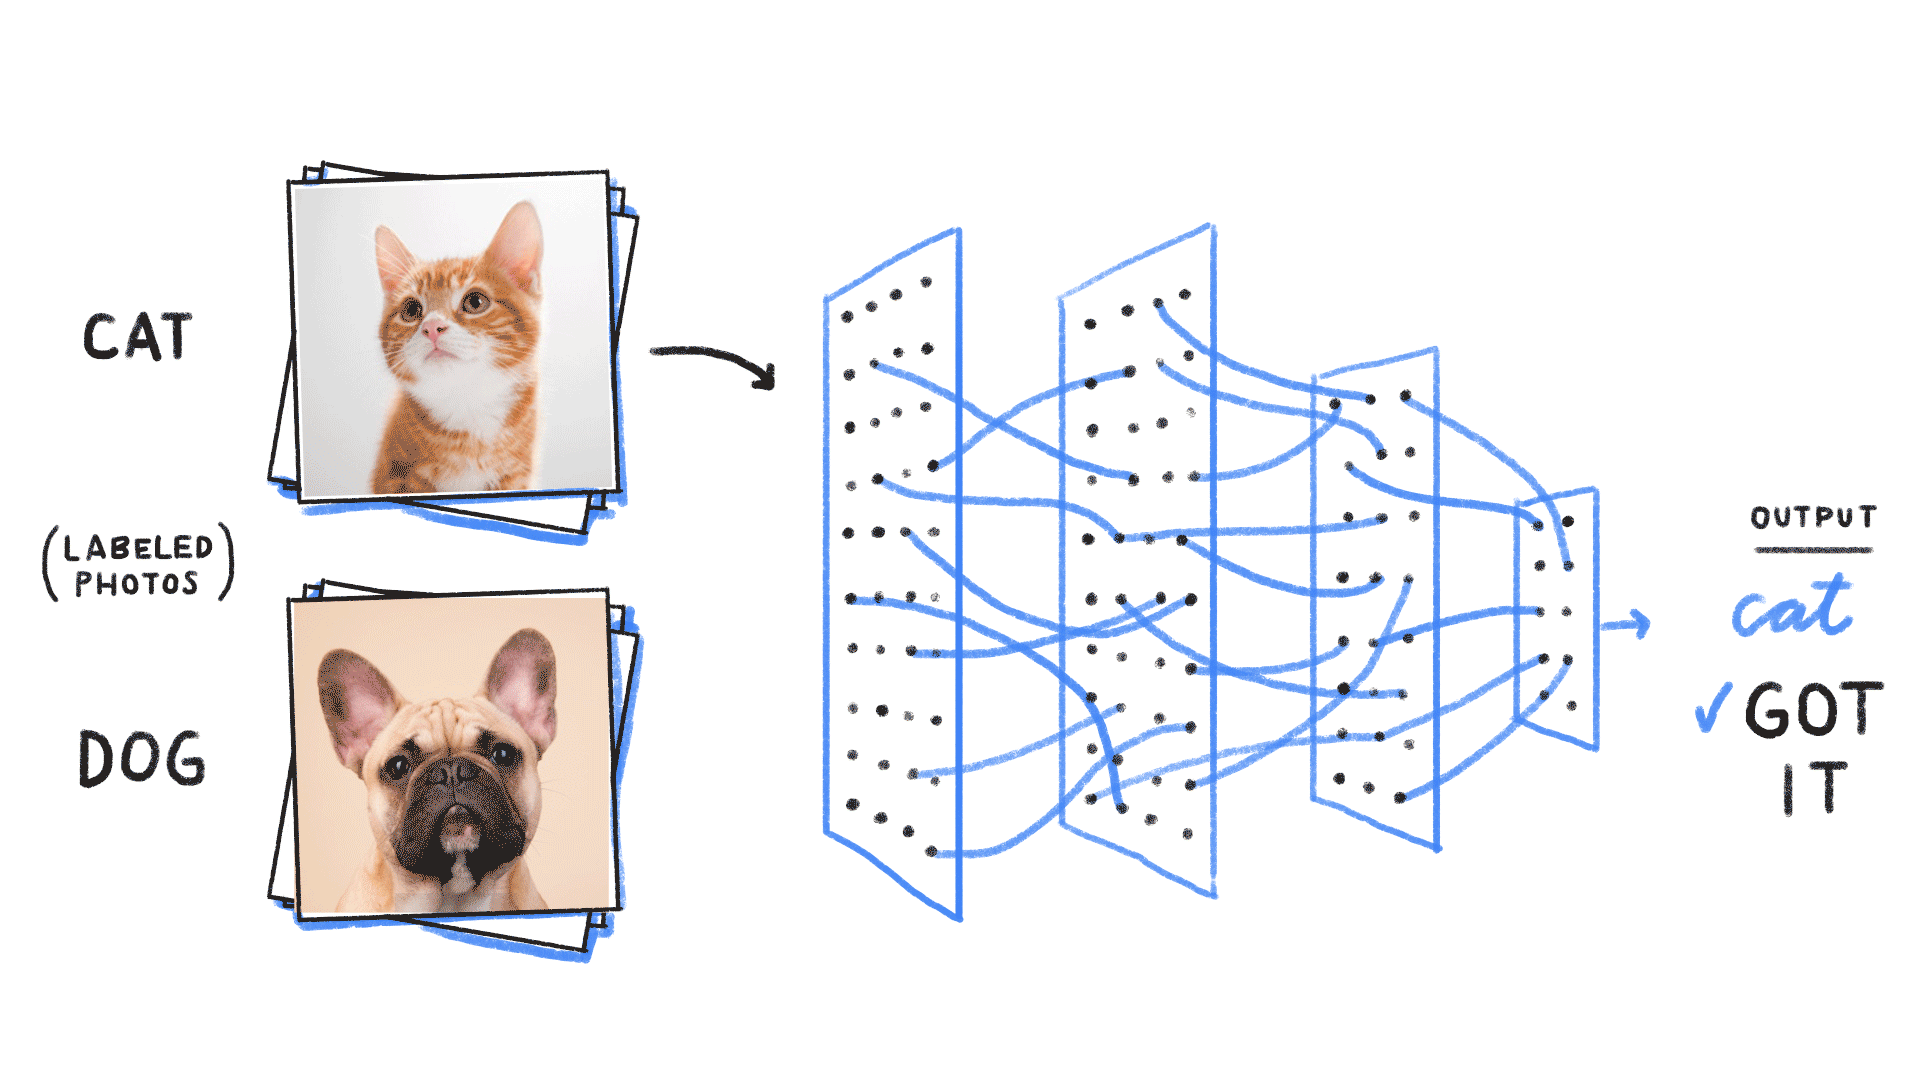
Nous utilisons l'exemple de reconnaître si une image est un chat ou un chien :
| Couche | Fonction | Dans cet exemple |
|---|---|---|
| Couche d'entrée | Reçoit des données brutes | Chaque pixel et l'information de couleur de l'image |
| Couche cachée | Extraire les caractéristiques couche par couche | Contours → Textures → Organes tels que les oreilles et les yeux |
| Couche de sortie | Donner le résultat final | « 85% de probabilité qu'il s'agisse d'un chat », « 15% de probabilité qu'il s'agisse d'un chien » |
Chaque couche possède de nombreux neurones. Chaque neurone reçoit la sortie de la couche précédente, effectue un calcul simple et la transmet à la couche suivante.
-
La première couche pourrait reconnaître « il y a une ligne verticale ici » ou « il y a un cercle ici ».
-
La deuxième couche combine ces éléments : une ligne verticale plus un cercle pourrait être une oreille.
-
La troisième couche continue de combiner : deux oreilles pointues, des moustaches, des yeux de chat — c'est très probablement un chat.
La partie étonnante est que ces caractéristiques ne sont pas conçues par des humains ; le modèle les apprend tout seul à partir des données.
Le neurone le plus simple
Utilisons quelques lignes de code Python pour montrer ce que fait un neurone :
Exemple
# Logique de calcul de base d'un neurone artificiel
# Pas de maths complexes, juste une somme pondérée + une activation
# ============================================
def simple_neuron(inputs: list, weights: list, bias: float) -> float:
"""
Le neurone le plus simple
inputs : valeurs d'entrée (issues des neurones de la couche précédente)
weights : poids (importance de chaque entrée, appris pendant l'entraînement)
bias : biais (seuil, appris pendant l'entraînement)
"""
# Étape 1 : somme pondérée
# Multiplier chaque entrée par son poids correspondant, puis additionner le tout
weighted_sum = 0.0
for input_value, weight in zip(inputs, weights):
weighted_sum += input_value * weight
# Ajouter le biais
weighted_sum += bias
# Étape 2 : Fonction d'activation (rend la sortie non linéaire)
# Ici, nous utilisons le ReLU le plus simple : les nombres négatifs deviennent 0, les nombres positifs restent inchangés
output = max(0.0, weighted_sum)
return output
# Simulation : un neurone qui détermine « est-ce une oreille de chat »
# Entrée : [caractère pointu, position en hauteur, a de la fourrure]
inputs = [0.8, 0.9, 0.7] # Ces trois caractéristiques sont toutes assez évidentes
# Poids : appris après l'entraînement (dans l'exemple, on suppose que ces valeurs sont déjà bien apprises)
weights = [0.5, 0.4, 0.3]
# Biais : seuil
bias = -0.6
result = simple_neuron(inputs, weights, bias)
print(f"Sortie du neurone : {result:.3f}")
print(f"Jugement : {'probablement une oreille de chat' if result > 0 else 'peu probable'}")
# Résultat : Sortie du neurone : 0.660
# Résultat : Jugement : probablement une oreille de chat
Ce que fait ce neurone est très simple : il effectue une somme pondérée des entrées, la fait passer par une fonction d'activation, et renvoie le résultat.
Mais lorsque des milliers de tels neurones sont connectés ensemble, chaque couche apprenant différentes caractéristiques, l'ensemble du système produit une intelligence étonnante.
Retenez cette intuition : un réseau de neurones = de nombreuses unités de calcul simples connectées ensemble, qui apprennent en ajustant les poids des connexions.
Entraînement vs. Inférence : deux étapes différentes
Le cycle de vie de l'IA se divise en deux étapes totalement distinctes : l'entraînement et l'inférence.
Comprendre la différence entre ces deux étapes peut vous aider à comprendre beaucoup de choses, comme pourquoi l'entraînement est si coûteux, alors que l'inférence est relativement bon marché.
Entraînement : faire apprendre l'IA
L'entraînement est un processus : montrer au modèle de grandes quantités de données, le laisser ajuster continuellement ses paramètres et faire des prédictions de plus en plus précises.
Par exemple, entraîner un modèle à reconnaître des chats et des chiens :
-
1. Préparer des millions d'images étiquetées (celle-ci montre un chat, celle-là montre un chien)
-
2. Laisser le modèle deviner « qu'est-ce que c'est » ; au début, il fera beaucoup d'erreurs
-
3. Dites-lui « tu t'es trompé, c'était un chat », et laissez-le ajuster les poids dans le réseau
-
4. Répéter des millions de fois jusqu'à ce que le modèle prédise de plus en plus précisément
La phase d'entraînement nécessite une puissance de calcul et des volumes de données énormes.Un grand modèle peut nécessiter des milliers de GPU pendant plusieurs mois d'entraînement, pour un coût de plusieurs millions de dollars.
Inférence : faire utiliser l'IA
L'inférence est un processus : utiliser le modèle entraîné, fournir une nouvelle entrée, obtenir une sortie.
Vous envoyez un message à ChatGPT, il vous répond—c'est de l'inférence.
Vous utilisez votre téléphone pour prendre une photo afin d'identifier une plante—c'est aussi de l'inférence.
Les caractéristiques de l'inférence :
Pas besoin d'ajuster les paramètres, il suffit d'utiliser les poids entraînés pour le calcul.
-
Généralement, un seul GPU ou même une puce de téléphone suffit.
-
Le coût est bien inférieur à celui de l'entraînement.
Comparaison des deux
| Dimension | Entraînement | Inférence |
|---|---|---|
| Objectif | Apprendre des connaissances, ajuster les poids | Appliquer les connaissances apprises, fournir des réponses |
| Volume de données | Nécessite d'énormes quantités de données | Une seule entrée suffit |
| Besoins en calcul | Extrêmement élevés (des milliers de GPU) | Relativement faibles (un seul GPU ou un téléphone) |
| Coût | Extrêmement élevé (millions de dollars) | Relativement faible (quelques centimes à chaque fois) |
| Fréquence | Quelques fois ou des dizaines de fois | Des millions de fois par seconde |
| Qui le fait | Des entreprises comme OpenAI, Anthropic | Utilisateurs ou applications ordinaires |
Par analogie : l'entraînement, c'est comme « étudier intensivement pendant dix ans », l'inférence, c'est comme « résoudre des problèmes lors d'un examen ».
Étudier demande beaucoup de temps et d'énergie, mais une fois que l'on a appris, résoudre des problèmes devient rapide.
Lorsque vous utilisez ChatGPT, vous faites de l'« inférence » — le modèle n'apprend pas et ne devient pas plus intelligent à partir de vos conversations. Ses connaissances s'arrêtent au moment où l'entraînement est terminé.
Introduction à l'architecture Transformer
En 2017, Google a publié un article intitulé « Attention Is All You Need », proposant l'architecture Transformer.
Cet article a changé tout le domaine de l'IA. Les grands modèles de langage d'aujourd'hui sont presque tous basés sur Transformer.
Pourquoi Transformer est-il si important ?
Avant Transformer, les données séquentielles (comme les phrases) étaient traitées à l'aide de RNN ou de LSTM.
Leur problème est le suivant : ils ne peuvent traiter qu'un mot à la fois, ce qui rend difficile la capture des dépendances à longue distance.
Par exemple : « J'ai laissé mon portefeuille dans un café à Pékin. Quand je suis retourné le chercher le lendemain, ____ était encore là. » — remplissez « il » dans le blanc. Vous savez que « il » fait référence à « portefeuille » parce que vous vous souvenez du contenu précédent.
Lorsque les anciens modèles traitaient « était encore là », ils avaient peut-être déjà oublié l'existence du « portefeuille ».
La percée de Transformer réside dans ceci :il peut voir toute la phrase d'un coup et, grâce au mécanisme d'attention, savoir sur quels mots se concentrer.
Encodeur et décodeur
Un Transformer complet est divisé en deux parties :
| Composant | Fonction | Scénarios d'application typiques |
|---|---|---|
| Encodeur | Comprend l'entrée et convertit le texte en représentations vectorielles | Classification de texte, analyse de sentiment, recherche sémantique |
| Décodeur | Génère un texte de sortie à partir de la compréhension | Rédaction, traduction, génération de dialogues |
Certains modèles utilisent uniquement l’encodeur (comme BERT), d’autres uniquement le décodeur (comme GPT), et d’autres encore les deux (comme T5).
La série GPT, Claude et Llama utilisent tous des architectures « Decoder-only » — leur force est de générer un texte fluide.
Qu’est-ce que le mécanisme d’attention ?
L’attention est le cœur du Transformer et la clé de sa capacité à traiter de longs textes.
Analogie : l’attention humaine pendant la lecture
Lorsque vous lisez une phrase, vous ne consacrez pas le même effort à chaque mot.
Par exemple : « Il a une longue queue et des oreilles triangulaires » — lorsque vous voyez « il », vous vous concentrez sur « queue » et « oreilles » pour déterminer de quel animal il s’agit.
Ce que fait le mécanisme d’attention est exactement ceci :En fonction de la position actuelle traitée, il décide dynamiquement sur quels mots de l’entrée se concentrer.

Démonstration animée :
Chaque étape ne fait qu’une seule chose : prédire le mot suivant en fonction du contexte précédent
Comment l'attention est-elle calculée ?
En termes simples, chaque mot génère trois vecteurs :
-
Requête :Quelles informations est-ce que je recherche ?
-
Clé :Quelles informations est-ce que je contiens ?
-
Valeur :Quel est mon contenu réel ?
Calculez la similarité entre la Requête à chaque position et les Clés à toutes les positions pour obtenir les poids d'attention, puis utilisez ces poids pour calculer une somme pondérée des Valeurs, ce qui produit la sortie pour cette position.
Vous n'avez pas besoin de retenir les détails, retenez simplement cette intuition :Attention = attribuer un poids à chaque mot de la phrase, indiquant son importance pour la position actuelle.
Pourquoi l'attention est-elle si importante ?
L'attention apporte plusieurs avantages clés :
-
Premièrement, elle peut capturer les dépendances à longue distance. Peu importe à quelle distance se trouvent deux mots, tant qu'ils sont liés, l'attention peut les connecter.
-
Deuxièmement, elle prend en charge le calcul parallèle. Contrairement aux RNNs, qui traitent mot par mot, elle peut traiter toute la phrase simultanément.
-
Troisièmement, un degré d'interprétabilité. Vous pouvez examiner les poids d'attention et savoir sur quoi le modèle se concentre.
Par exemple, lors de la traduction de « Il a une longue queue », vous pouvez voir que lorsque le modèle traduit « il », l'attention se concentre principalement sur « queue ».
Pré-entraînement et ajustement fin
Les grands modèles actuels utilisent généralement un entraînement en deux étapes : pré-entraînement + ajustement fin.
Pré-entraînement : apprentissage de connaissances générales sur des données massives
Le pré-entraînement fonctionne ainsi : prenez de grandes quantités de texte sur Internet (Wikipédia, livres, pages web, code, etc.) et demandez au modèle de faire une seule chose : prédire le mot suivant.
Vous saisissez « Le temps aujourd'hui est vraiment » et le laissez deviner quel est le mot suivant.
-
Vous saisissez « 1 + 1 = » et le laissez deviner quel est le mot suivant.
Ce processus n'a pas de tâche spécifique ; il permet simplement au modèle d'apprendre de manière générale la langue, les connaissances, la logique, le code, etc.
Le pré-entraînement est la partie la plus coûteuse : beaucoup de données, une puissance de calcul massive et une longue durée.
Ajustement fin : optimisation pour des tâches spécifiques
Le modèle après pré-entraînement est très savant, mais pas nécessairement obéissant.
Si vous lui posez une question, il risque de continuer à parler sans fin au lieu de répondre directement.
Si vous lui demandez d'écrire du code, il risque de s'arrêter à mi-chemin, puis de se mettre à écrire autre chose.
Le fine-tuning utilise des données de dialogue de haute qualité pour entraîner davantage le modèle, en lui apprenant à :
-
Comprendre les instructions et produire la sortie demandée
-
Maintenir un style conversationnel et refuser les demandes nuisibles
-
Produire un contenu plus sûr et plus utile
-
Le volume de données pour le fine-tuning est bien plus faible que pour le pré-entraînement, mais les exigences de qualité sont plus élevées.
Comprendre par analogie
-
Le pré-entraînement, c'est comme lire dix mille livres — de l'école primaire à l'université, en apprenant largement toutes sortes de connaissances.
-
Le fine-tuning, c'est comme une formation professionnelle — après l'obtention du diplôme, vous allez travailler dans une entreprise et apprenez à communiquer avec vos collègues, à écrire des e-mails et à accomplir des tâches professionnelles.
Le pré-entraînement donne des connaissances au modèle ; le fine-tuning rend le modèle utilisable.
C'est aussi pourquoi, parmi les grands modèles, certains sont intelligents mais difficiles à utiliser, tandis que d'autres sont moyens mais faciles à utiliser — la différence réside souvent dans le fine-tuning.
Pourquoi l'IA hallucine-t-elle ?
L'hallucination est l'un des problèmes les plus célèbres de l'IA : elle peut sérieusement fabriquer des faits, des noms, des articles et des données qui n'existent pas.
Comprendre du point de vue de la prédiction probabiliste
Pour comprendre l'hallucination, revenons d'abord à la façon de fonctionner la plus fondamentale de l'IA :
Il ne vérifie pas les faits, mais prédit le mot suivant le plus probable.
Vous demandez : Qui a inventé le téléphone ? — Il saitAlexander Graham BellCette séquence est la plus susceptible d'apparaître.
Mais vous demandez : Qui a inventé le tutoriel d'exemple ? — Il n'y a peut-être pas ce genre d'information dans les données d'entraînement, mais il fabriquera un nom plausible d'après des schémas statistiques.
Il ne sait pas ce qu'il ne sait pas — il sait seulement qu'à cette position, ces mots ont la plus forte probabilité d'apparaître.
Causes courantes d'hallucination
| Cause | Explication | Exemple |
|---|---|---|
| Données d'entraînement insuffisantes | Ce sujet apparaît rarement dans les données d'entraînement, donc le modèle ne l'a pas bien appris | Poser une question professionnelle très pointue |
| Coupure des connaissances | Les événements survenus après la date limite des données d'entraînement sont inconnus du modèle | Demander « Que s'est-il passé en 2025 ? » (en supposant que le modèle a été entraîné en 2024) |
| Confusion des sources | Mélanger des informations provenant de plusieurs sources et se tromper | « Zhang San a écrit Paper A » (en réalité, Li Si l'a écrit, mais Zhang San et Li Si apparaissent souvent ensemble) |
| Surapprentissage | A mémorisé du bruit pendant l'entraînement et l'a traité comme un fait | Fabriquer des citations qui n'existent pas |
Comment réduire l'impact des hallucinations
En tant qu'utilisateur, vous pouvez faire ceci :
-
Premièrement, vérifiez les informations essentielles. Lorsqu'il s'agit de médecine, de droit, d'investissement, de faits d'actualité, etc., assurez-vous de vérifier.
-
Deuxièmement, demandez au modèle de fournir des sources. Demandez-lui « Quelle est la source de cette information ? » « Pouvez-vous me donner une citation ? »
-
Troisièmement, utilisez la génération augmentée par récupération (RAG). Alimentez le modèle avec vos propres documents et faites-lui répondre en se basant sur ces documents, plutôt que d’inventer des choses.
-
Quatrièmement, utilisez plusieurs modèles pour une validation croisée. Posez la même question à plusieurs modèles ; s’ils disent tous la même chose, c’est plus crédible.
Autres extensionsRappelez-vous : peu importe à quel point ce que dit l’IA semble réel, cela peut être inventé. Pour les décisions à haut risque, restez toujours sceptique.