Web Scraping Python - BeautifulSoup
Le web scraping en Python désigne le processus d'extraction automatique d'informations depuis Internet en écrivant des programmes Python.
Le processus de base du web scraping comprend généralement l'envoi de requêtes HTTP pour récupérer le contenu des pages web, l'analyse des pages web et l'extraction des données, puis le stockage des données.
L'écosystème riche de Python en fait un langage populaire pour développer des scrapers web, en particulier en raison de son puissant support de bibliothèques.
De manière générale, le processus de web scraping peut être divisé en les étapes suivantes :
- Envoyer des requêtes HTTP: Le scraper obtient des pages HTML depuis le site web cible via des requêtes HTTP. Les bibliothèques couramment utilisées incluent
requests。 - Analyser le contenu HTML: Après avoir obtenu la page HTML, le scraper doit analyser le contenu et extraire les données. Les bibliothèques courantes incluent
BeautifulSoup、lxml、Scrapy, etc. - Extraire les données: Extraire les données requises en localisant les éléments HTML (tels que les balises, les attributs, les noms de classe, etc.).
- Stocker les données: Stocker les données extraites dans des formats tels que des bases de données, des fichiers CSV et des fichiers JSON pour une utilisation ou une analyse ultérieure.
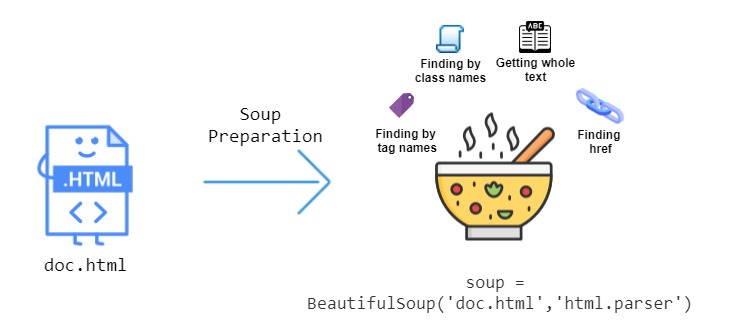
Ce chapitre présente principalement BeautifulSoup, qui est une bibliothèque Python pour analyser des documents HTML et XML. Elle peut extraire des données de pages web et est couramment utilisée pour le scraping web et l'exploration de données.
BeautifulSoup
BeautifulSoup est une bibliothèque Python permettant d'extraire des données de pages web, particulièrement adaptée à l'analyse de fichiers HTML et XML.
BeautifulSoup peut extraire et manipuler le contenu de pages web en fournissant une API simple, ce qui la rend très adaptée aux tâches de scraping web et d'extraction de données.
Installation de BeautifulSoup
Pour utiliser BeautifulSoup, vous devez installer beautifulsoup4 et lxml ou html.parser (un analyseur HTML).
Nous pouvons utiliser pip pour installer ces dépendances :
pip install beautifulsoup4
pip install lxml  # 推荐使用 lxml 作为解析器(速度更快)
Si vous n'avez pas lxml, vous pouvez utiliser html.parser intégré à Python comme analyseur.
Utilisation de base
BeautifulSoup est utilisé pour analyser des données HTML ou XML et fournit des méthodes pour parcourir, rechercher et modifier l'arbre d'analyse.
Les opérations courantes de BeautifulSoup incluent la recherche de balises, l'obtention d'attributs de balises, l'extraction de texte, etc.
Pour utiliser BeautifulSoup, vous devez d'abord importer BeautifulSoup et charger la page HTML dans un objet BeautifulSoup.
Habituellement, vous utiliserez d'abord une bibliothèque de web scraping (telle querequests) pour obtenir le contenu de la page web :
Exemple
import requests
# Utiliser requests pour obtenir le contenu de la page web
url = 'https://cn.bing.com/' # Extraire le contenu de la page web du moteur de recherche Bing
response = requests.get(url)
# Utiliser BeautifulSoup pour analyser la page web
soup = BeautifulSoup(response.text, 'lxml') # Utiliser l'analyseur lxml
# Analyser le contenu de la page web avec l'analyseur html.parser
# soup = BeautifulSoup(response.text, 'html.parser')
Obtenir le titre de la page web :
Exemple
import requests
# Spécifiez l'URL dont vous voulez obtenir le titre
url = 'https://cn.bing.com/' # Extraire le contenu de la page web du moteur de recherche Bing
# Envoyer une requête HTTP pour obtenir la page web
response = requests.get(url)
# Problème de texte chinois illisible
response.encoding = 'utf-8'
# S'assurer que la requête a réussi
if response.status_code == 200:
# Utiliser BeautifulSoup pour analyser le contenu de la page web
soup = BeautifulSoup(response.text, 'lxml')
# Trouver la balise <title>
title_tag = soup.find('title')
# Afficher le texte du titre
if title_tag:
print(title_tag.get_text())
else:
print("La balise <title> n'a pas été trouvée")
else:
print("Échec de la requête, code d'état :", response.status_code)
Après avoir exécuté le code ci-dessus, le titre de sortie est :
搜索 - Microsoft 必应
Problème de texte chinois mal affiché
Lorsque vous utilisez la bibliothèque requests pour extraire des pages web chinoises, des problèmes d'encodage peuvent survenir, empêchant le contenu chinois de s'afficher correctement. Pour garantir que les pages web chinoises sont correctement extraites et affichées, vous devez généralement gérer l'encodage des caractères de la page web.
Détection automatique de l'encodage : requests déduit généralement automatiquement l'encodage de la page web à partir du Content-Type dans les en-têtes de réponse, mais cela peut parfois être inexact. Dans ce cas, vous pouvez utiliser chardet pour détecter automatiquement l'encodage.
Exemple
url = 'https://cn.bing.com/'
response = requests.get(url)
# Utiliser chardet pour détecter automatiquement l'encodage
import chardet
encoding = chardet.detect(response.content)['encoding']
print(encoding)
response.encoding = encoding
Après avoir exécuté le code ci-dessus, la sortie est :
utf-8
Si vous connaissez l'encodage de la page web (par exemple, utf-8 ou gbk), vous pouvez définir directementresponse.encoding:
response.encoding = 'utf-8' # 或者 'gbk',根据实际情况选择
Recherche de balises
BeautifulSoup fournit plusieurs méthodes pour trouver des balises dans une page web. Les plus couramment utilisées incluentfind()etfind_all()。
find()Renvoie la première balise correspondantefind_all()Renvoie toutes les balises correspondantes
Exemple
import requests
# Spécifiez l'URL dont vous voulez obtenir le titre
url = 'https://www.baidu.com/' # Récupérer le contenu de la page web du moteur de recherche Bing
# Envoyer une requête HTTP pour obtenir la page web
response = requests.get(url)
# Problème de texte chinois illisible
response.encoding = 'utf-8'
soup = BeautifulSoup(response.text, 'lxml')
# Trouver la première balise <a>
first_link = soup.find('a')
print(first_link)
print("----------------------------")
# Obtenir l'attribut href de la première balise <a>
first_link_url = first_link.get('href')
print(first_link_url)
print("----------------------------")
# Trouver toutes les balises <a>
all_links = soup.find_all('a')
print(all_links)
Le résultat de sortie est similaire à ce qui suit :
<a class="mnav" href="http://news.baidu.com" name="tj_trnews">新闻</a>
----------------------------
http://news.baidu.com
----------------------------
[<a class="mnav" href="http://news.baidu.com" name="tj_trnews">新闻</a>, <a class="mnav" href="https://www.hao123.com" name="tj_trhao123">hao123</a>, <a class="mnav" href="http://map.baidu.com" name="tj_trmap">地图</a>, <a class="mnav" href="http://v.baidu.com" name="tj_trvideo">视频</a>,
Obtenir le texte d'une balise
Grâce à la méthodeget_text(), vous pouvez extraire le contenu textuel à l'intérieur d'une balise :
Exemple
import requests
# Spécifiez l'URL dont vous voulez obtenir le titre
url = 'https://www.baidu.com/' # Récupérer le contenu de la page web du moteur de recherche Bing
# Envoyer une requête HTTP pour obtenir la page web
response = requests.get(url)
# Problème de texte chinois illisible
response.encoding = 'utf-8'
soup = BeautifulSoup(response.text, 'lxml')
# Obtenir le contenu textuel de la première balise <p>
paragraph_text = soup.find('p').get_text()
# Obtenir tout le contenu textuel de la page
all_text = soup.get_text()
print(all_text)
Le résultat de sortie est similaire à ce qui suit :
Baidu it, and you'll know.
Trouver les balises enfant et parent
Vous pouvez utiliser les propriétésparentetchildrenpour accéder aux balises parent et enfant d'une balise :# 获取当前标签的父标签 parent_tag = first_link.parent # 获取当前标签的所有子标签 children = first_link.children
Exemple
import requests
# Spécifiez l'URL dont vous voulez obtenir le titre
url = 'https://www.baidu.com/' # Récupérer le contenu de la page web du moteur de recherche Bing
# Envoyer une requête HTTP pour obtenir la page web
response = requests.get(url)
# Problème de texte chinois illisible
response.encoding = 'utf-8'
soup = BeautifulSoup(response.text, 'lxml')
# Trouver la première balise <a>
first_link = soup.find('a')
print(first_link)
print("----------------------------")
# Obtenir la balise parente de la balise actuelle
parent_tag = first_link.parent
print(parent_tag.get_text())
Le résultat de sortie est similaire à ce qui suit :
<a class="mnav" href="http://news.baidu.com" name="tj_trnews">新闻</a>
----------------------------
 新闻 hao123 地图 视频 贴吧  登录   更多产品
Recherche de balises avec des attributs spécifiques
Vous pouvez trouver des balises avec des attributs spécifiques en passant des paramètres d'attributs.
Par exemple, trouvez toutes les balises div avec le nom de classe example-class :
# 查找所有 class="example-class" 的 <div> 标签
divs_with_class = soup.find_all('div', class_='example-class')

# 查找具有 id="unique-id" 的 <p> 标签
unique_paragraph = soup.find('p', id='unique-id')
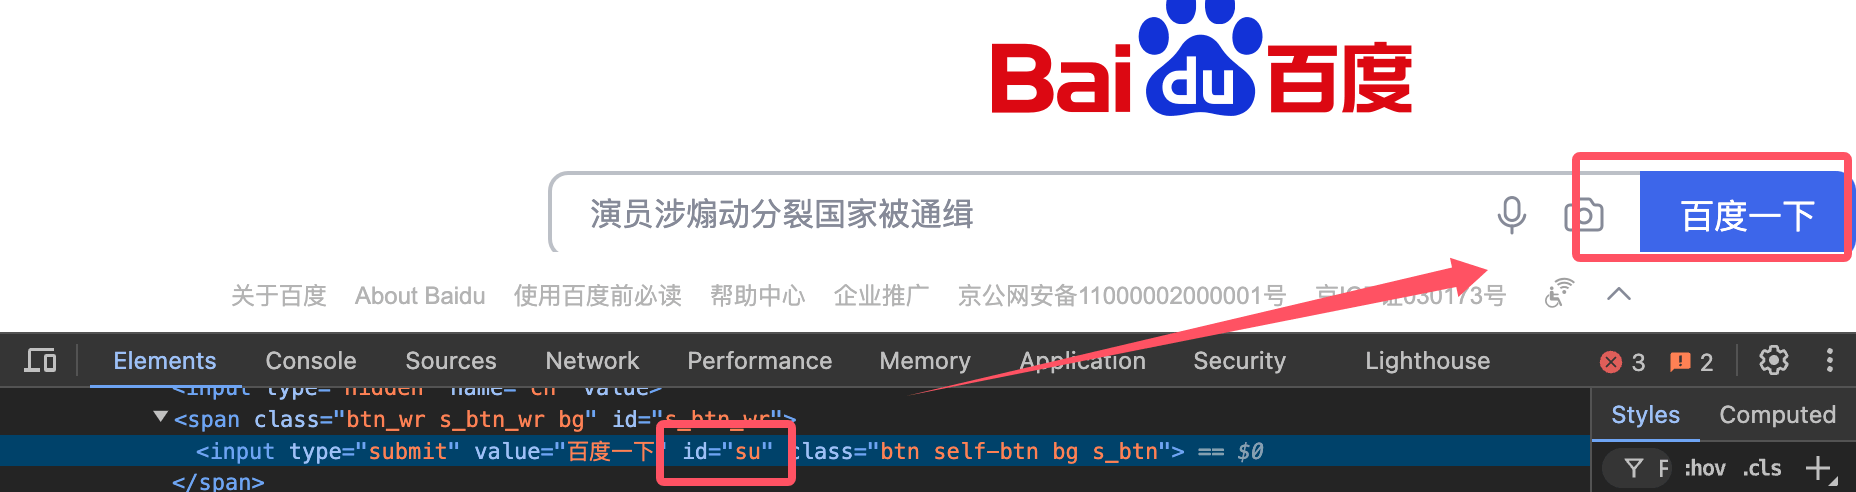
Obtenez le bouton de recherche avec l'id su :
Exemple
import requests
# Spécifiez l'URL dont vous voulez obtenir le titre
url = 'https://www.baidu.com/' # Récupérer le contenu de la page web du moteur de recherche Bing
# Envoyer une requête HTTP pour obtenir la page web
response = requests.get(url)
# Problème de texte chinois illisible
response.encoding = 'utf-8'
soup = BeautifulSoup(response.text, 'lxml')
# Trouver la balise <input> avec id="unique-id"
unique_input = soup.find('input', id='su')
input_value = unique_input['value'] # Obtenir la valeur du champ de saisie
print(input_value)
Le résultat de sortie est:
Baidu it.
Utilisation avancée
Sélecteurs CSS
BeautifulSoup prend également en charge la recherche de balises à l'aide de sélecteurs CSS.
La méthode select() permet d'utiliser une syntaxe de sélecteur de type jQuery pour trouver des balises :
# 使用 CSS 选择器查找所有 class 为 'example' 的 <div> 标签
example_divs = soup.select('div.example')

# 查找所有 <a> 标签中的 href 属性
links = soup.select('a[href]')
Gestion des balises imbriquées
BeautifulSoup prend en charge les structures HTML profondément imbriquées. Vous pouvez gérer ces structures en recherchant récursivement les balises enfants :
# 查找嵌套的 <div> 标签
nested_divs = soup.find_all('div', class_='nested')
for div in nested_divs:
    print(div.get_text())
Modification du contenu d'une page web
BeautifulSoup vous permet de modifier le contenu HTML.
Nous pouvons modifier les attributs des balises, le texte ou supprimer des balises :
Exemple
first_link['href'] = 'http://new-url.com'
# Modifier le contenu textuel de la première balise <p>
first_paragraph = soup.find('p')
first_paragraph.string = 'Updated content'
# Supprimer une balise
first_paragraph.decompose()
Conversion en chaîne
Vous pouvez reconvertir l'objet BeautifulSoup analysé en une chaîne HTML :
# 转换为字符串
html_str = str(soup)
Attributs et méthodes de BeautifulSoup
Voici les attributs et méthodes couramment utilisés dans BeautifulSoup :
| Méthode/Attribut | Description | Exemple |
|---|---|---|
BeautifulSoup() | Utilisé pour analyser des documents HTML ou XML et renvoyer un objet BeautifulSoup. | soup = BeautifulSoup(html_doc, 'html.parser') |
.prettify() | Formate et embellit le contenu du document, générant une chaîne structurée. | print(soup.prettify()) |
.find() | Trouve la première balise correspondante. | tag = soup.find('a') |
.find_all() | Trouve toutes les balises correspondantes et renvoie une liste. | tags = soup.find_all('a') |
.find_all_next() | Trouve toutes les balises qui correspondent aux conditions après la balise actuelle. | tags = soup.find('div').find_all_next('p') |
.find_all_previous() | Trouve toutes les balises qui correspondent aux conditions avant la balise actuelle. | tags = soup.find('div').find_all_previous('p') |
.find_parent() | Renvoie la balise parente de la balise actuelle. | parent = tag.find_parent() |
.find_all_parents() | Trouver toutes les balises parentes de la balise actuelle. | parents = tag.find_all_parents() |
.find_next_sibling() | Trouver la balise sœur suivante de la balise actuelle. | next_sibling = tag.find_next_sibling() |
.find_previous_sibling() | Trouver la balise sœur précédente de la balise actuelle. | prev_sibling = tag.find_previous_sibling() |
.parent | Obtenir la balise parente de la balise actuelle. | parent = tag.parent |
.next_sibling | Obtenir la balise sœur suivante de la balise actuelle. | next_sibling = tag.next_sibling |
.previous_sibling | Obtenir la balise sœur précédente de la balise actuelle. | prev_sibling = tag.previous_sibling |
.get_text() | Extraire le contenu textuel à l'intérieur de la balise, en ignorant toutes les balises HTML. | text = tag.get_text() |
.attrs | Retourner tous les attributs de la balise, représentés sous forme de dictionnaire. | href = tag.attrs['href'] |
.string | Obtenir le contenu de type chaîne à l'intérieur de la balise. | string_content = tag.string |
.name | Retourner le nom de la balise. | tag_name = tag.name |
.contents | Retourner tous les éléments enfants de la balise, sous forme de liste. | children = tag.contents |
.descendants | Retourner tous les éléments descendants de la balise, sous forme de générateur. | for child in tag.descendants: print(child) |
.parent | Obtenir la balise parente de la balise actuelle. | parent = tag.parent |
.previous_element | Obtenir l'élément précédent de la balise actuelle (en excluant le texte). | prev_elem = tag.previous_element |
.next_element | Obtenir l'élément suivant de la balise actuelle (en excluant le texte). | next_elem = tag.next_element |
.decompose() | Supprimer la balise actuelle et son contenu de l'arbre. | tag.decompose() |
.unwrap() | Supprimer la balise elle-même, en conservant uniquement son contenu enfant. | tag.unwrap() |
.insert() | Insérer une nouvelle balise ou du texte dans la balise. | tag.insert(0, new_tag) |
.insert_before() | Insérer une nouvelle balise avant la balise actuelle. | tag.insert_before(new_tag) |
.insert_after() | Insérer une nouvelle balise après la balise actuelle. | tag.insert_after(new_tag) |
.extract() | Supprimer la balise et renvoyer la balise. | extracted_tag = tag.extract() |
.replace_with() | Remplacer la balise actuelle et son contenu. | tag.replace_with(new_tag) |
.has_attr() | Vérifier si la balise possède l'attribut spécifié. | if tag.has_attr('href'): |
.get() | Obtenir la valeur de l'attribut spécifié. | href = tag.get('href') |
.clear() | Effacer tout le contenu de la balise. | tag.clear() |
.encode() | Encoder le contenu de la balise sous forme de flux d'octets. | encoded = tag.encode() |
.is_empty_element | Vérifier si la balise est un élément vide (par exemple<br>、<img>etc.). | if tag.is_empty_element: |
.is_ancestor_of() | Vérifier si la balise actuelle est un ancêtre de la balise spécifiée. | if tag.is_ancestor_of(another_tag): |
.is_descendant_of() | Vérifier si la balise actuelle est un descendant de la balise spécifiée. | if tag.is_descendant_of(another_tag): |
Autres attributs
| Méthode/Attribut | Description | Exemple |
|---|---|---|
.style | Obtenir le style en ligne de la balise. | style = tag['style'] |
.id | Obtenir le ... de la baliseidattribut. | id = tag['id'] |
.class_ | Obtenir le ... de la baliseclassattribut. | class_name = tag['class'] |
.string | Obtenir le contenu de type chaîne à l'intérieur de la balise, en ignorant les autres balises. | content = tag.string |
.parent | Obtenir l'élément parent de la balise. | parent = tag.parent |
Autre
| Méthode/Attribut | Description | Exemple |
|---|---|---|
find_all(string) | Utiliser une chaîne pour trouver les balises correspondantes. | tag = soup.find_all('div', class_='container') |
find_all(id) | Trouver le ... spécifiéidbalise. | tag = soup.find_all(id='main') |
find_all(attrs) | Trouver les balises avec les attributs spécifiés. | tag = soup.find_all(attrs={"href": "http://example.com"}) |