Scrapy est un framework d'application écrit en Python pour parcourir les données de sites web et extraire des données structurées.
Scrapy est souvent utilisé dans une série de programmes incluant la fouille de données, le traitement d'informations ou le stockage de données historiques.
Habituellement, nous pouvons facilement implémenter un crawler via le framework Scrapy pour récupérer le contenu ou les images d'un site web spécifié.
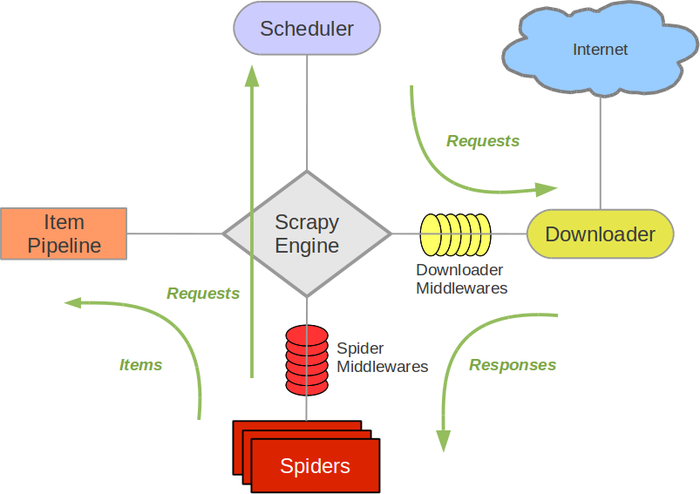
Diagramme d'architecture de Scrapy (les lignes vertes indiquent le flux de données)
-
Scrapy Engine: Responsable de la communication, des signaux, du transfert de données, etc., entre Spider, ItemPipeline, Downloader et Scheduler.
-
Scheduler: Il est responsable d'accepter les requêtes Request envoyées par le moteur, de les organiser et de les agencer d'une certaine manière, de les mettre en file d'attente et de les renvoyer au moteur lorsque celui-ci en a besoin.
-
Downloader: Il est responsable de télécharger toutes les Requests envoyées par le Scrapy Engine, et de renvoyer les Responses obtenues au Scrapy Engine, qui les transmet ensuite au Spider pour traitement.
-
Spider: Il est responsable de traiter toutes les Responses, d'analyser et d'extraire les données qu'elles contiennent, d'obtenir les données requises pour les champs Item, et de soumettre au moteur les URLs qui doivent être suivies, lesquelles entrent ensuite à nouveau dans le Scheduler.
-
Item Pipeline: Il est responsable du traitement des Items obtenus auprès du Spider, et c'est l'endroit du post-traitement (analyse détaillée, filtrage, stockage, etc.).
-
Downloader Middlewares: Vous pouvez le considérer comme un composant qui permet une extension personnalisée de la fonctionnalité de téléchargement.
-
Spider Middlewares: Vous pouvez le comprendre comme un composant fonctionnel qui permet une extension et une manipulation personnalisées de la communication entre le moteur et le Spider (comme les Responses entrant dans le Spider ; et les Requests sortant du Spider).
Processus de fonctionnement de Scrapy
Une fois le code écrit, le programme commence à s'exécuter...
- 1 Moteur : Salut ! Spider, quel site web veux-tu traiter ?
- 2 Spider : Le patron veut que je m'occupe de xxxx.com.
- 3 Moteur : Donne-moi la première URL à traiter.
- 4 Spider : Voilà, la première URL est xxxxxxx.com.
- 5 Moteur : Salut ! Planificateur, j'ai une requête ici, merci de la trier et de la mettre en file d'attente pour moi.
- 6 Planificateur : D'accord, je la traite, attends un instant.
- 7 Moteur : Salut ! Planificateur, donne-moi la requête traitée.
- 8 Planificateur : Voilà, voici la requête traitée.
- 9 Moteur : Salut ! Téléchargeur, merci de télécharger cette requête selon les paramètres du middleware de téléchargement du patron.
- 10 Téléchargeur : D'accord ! Voilà, c'est le contenu téléchargé. (En cas d'échec : désolé, cette requête n'a pas pu être téléchargée. Ensuite, le moteur dit au planificateur que cette requête n'a pas pu être téléchargée, de l'enregistrer, et nous la téléchargerons à nouveau plus tard.)
- 11 Engine : Salut ! Spider, voici le contenu téléchargé, et il a déjà été traité selon le middleware de téléchargement du patron. À toi de le gérer. (Remarque ! Ici, la réponse est par défaut remise à la fonction def parse() pour traitement.)
- 12 Spider : (Après avoir traité les données, pour les URL qui doivent être suivies), Salut ! Engine, j'ai deux résultats ici. Voici l'URL que je dois suivre, et voici les données Item que j'ai obtenues.
- 13 Engine : Salut ! Pipeline, j'ai un item ici, veuillez le traiter pour moi ! Scheduler ! Voici l'URL qui doit être suivie, veuillez la traiter pour moi. Ensuite, bouclez à partir de l'étape 4 jusqu'à ce que toutes les informations dont le patron a besoin soient obtenues.
- 14 Pipeline et Scheduler : D'accord, nous allons le faire tout de suite !
Remarque ! L'ensemble du programme ne s'arrêtera que lorsqu'il n'y aura plus de requêtes dans le planificateur. (C'est-à-dire que, pour les URL dont le téléchargement a échoué, Scrapy les téléchargera aussi à nouveau.)
La création d'un crawler Scrapy nécessite au total 4 étapes :
- Créer un nouveau projet (scrapy startproject xxx) : Créer un nouveau projet de crawler.
- Définir la cible (écrire items.py) : Définir la cible que vous souhaitez crawler.
- Créer le crawler (spiders/xxspider.py) : Créer un crawler pour commencer à crawler des pages web.
- Stocker le contenu (pipelines.py) : Concevoir des pipelines pour stocker le contenu crawlé.
Installation
Méthode d'installation sous Windows
Mettre à jour la version de pip :
pip install --upgrade pip
Installez le framework Scrapy via pip :
pip install Scrapy
Méthode d'installation sur Ubuntu
Installez les dépendances non-Python :
sudo apt-get install python-dev python-pip libxml2-dev libxslt1-dev zlib1g-dev libffi-dev libssl-dev
Installez le framework Scrapy via pip :
sudo pip install scrapy
Méthode d'installation sur Mac OS
Pour le système Mac OS, comme le système lui-même fait référence à ses bibliothèques python2.x intégrées, les paquets installés par défaut ne peuvent pas être supprimés. Cependant, installer Scrapy avec python2.x produira une erreur, et installer avec python3.x produira également une erreur. Finalement, je n'ai pas trouvé de moyen d'installer Scrapy directement, donc je vais utiliser une autre méthode d'installation pour expliquer les étapes d'installation. La solution consiste à utiliser virtualenv pour l'installation.
$ sudo pip install virtualenv
$ virtualenv scrapyenv
$ cd scrapyenv
$ source bin/activate
$ pip install Scrapy
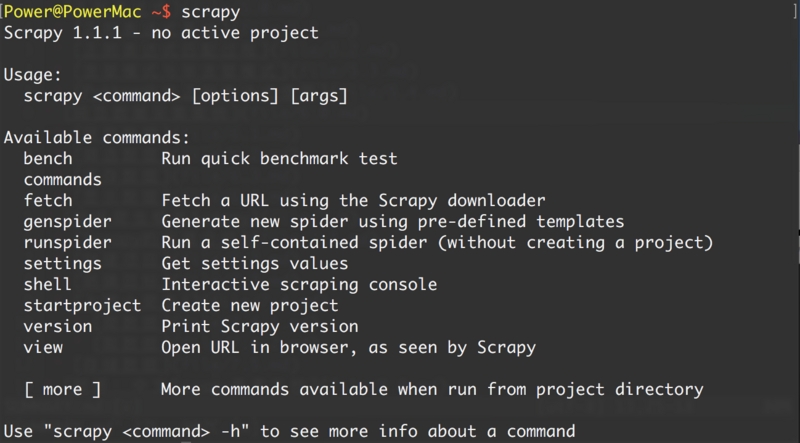
Après l'installation, tapez simplement scrapy dans le terminal de commande, et si un résultat semblable à ce qui suit s'affiche, cela signifie que l'installation a réussi.
Exemple de prise en main
Objectifs d'apprentissage
- Créer un projet Scrapy
- Définir les données structurées (Item) à extraire
- Écrire un Spider pour parcourir le site web et extraire les données structurées (Item)
- Écrire des Item Pipelines pour stocker les Items extraits (c'est-à-dire les données structurées)
1. Créer un nouveau projet (scrapy startproject)
Avant de commencer à crawler, vous devez créer un nouveau projet Scrapy. Entrez dans le répertoire de projet personnalisé et exécutez la commande suivante :
scrapy startproject mySpider
Ici, mySpider est le nom du projet. Vous verrez qu'un dossier mySpider est créé, et la structure des répertoires est à peu près la suivante :
Présentons brièvement le rôle de chaque fichier principal :
mySpider/
    scrapy.cfg
    mySpider/
        __init__.py
        items.py
        pipelines.py
        settings.py
        spiders/
            __init__.py
            ...
Ces fichiers sont :
- scrapy.cfg : Le fichier de configuration du projet.
- mySpider/ : Le module Python du projet, à partir duquel le code sera référencé.
- mySpider/items.py : Le fichier cible du projet.
- mySpider/pipelines.py : Le fichier de pipeline du projet.
- mySpider/settings.py : Le fichier de paramètres du projet.
- mySpider/spiders/ : Le répertoire qui stocke le code du crawler.
2. Définir la cible (mySpider/items.py)
Nous prévoyons de crawlerhttp://www.itcast.cn/channel/teacher.shtmlles noms, les titres et les informations personnelles de tous les formateurs du site Web.
Ouvrez items.py dans le répertoire mySpider.
Item définit des champs de données structurés, utilisés pour enregistrer les données crawlees. Il est un peu comme un dict en Python, mais offre une protection supplémentaire pour réduire les erreurs.
Vous pouvez définir un Item en créant une classe scrapy.Item et en définissant des attributs de classe de type scrapy.Field (ce qui peut être compris comme similaire à une relation de mappage ORM).
Ensuite, créez une classe ItcastItem et construisez le modèle d'Item.
import scrapy

class ItcastItem(scrapy.Item):
   name = scrapy.Field()
   title = scrapy.Field()
   info = scrapy.Field()
3. Créez le crawler (spiders/itcastSpider.py)
La fonctionnalité du crawler doit être divisée en deux étapes :
1. Récupérer les données
Entrez la commande dans le répertoire courant ; elle créera un crawler nommé itcast dans le répertoire mySpider/spider et spécifiera l'étendue du domaine de crawl :
scrapy genspider itcast "itcast.cn"
Ouvrez itcast.py dans le répertoire mySpider/spider. Le code suivant est ajouté par défaut :
import scrapy

class ItcastSpider(scrapy.Spider):
    name = "itcast"
    allowed_domains = ["itcast.cn"]
    start_urls = (
        'http://www.itcast.cn/',
    )

    def parse(self, response):
        pass
En fait, nous pouvons aussi créer itcast.py nous-mêmes et écrire le code ci-dessus, mais utiliser la commande évite le souci d'écrire du code passe-partout fixe.
Pour créer un Spider, vous devez créer une sous-classe à l'aide de la classe scrapy.Spider et définir trois attributs requis et une méthode.
name = "" : le nom d'identification de ce spider. Il doit être unique ; différents spiders doivent définir des noms différents.
allow_domains = [] est la portée du domaine de recherche, c'est-à-dire la zone restreinte du spider. Il spécifie que le spider n'explore que les pages sous ce domaine, et les URL inexistantes seront ignorées.
start_urls = () : le tuple/liste d'URL à explorer. Le spider commence à récupérer les données à partir d'ici, donc les premières données téléchargées partiront de ces URL. Les autres sous-URL seront générées par héritage à partir de ces URL de départ.
parse(self, response) : la méthode d'analyse. Elle sera appelée après le téléchargement de chaque URL initiale. Lorsqu'elle est appelée, elle prend comme seul paramètre l'objet Response renvoyé par chaque URL. Ses principales fonctions sont les suivantes :
Responsable de l'analyse des données de la page web renvoyée (response.body) et de l'extraction des données structurées (génération d'items).
Générer des requêtes URL pour la page suivante.
Modifier la valeur de start_urls par la première URL qui doit être explorée.
start_urls = ("http://www.itcast.cn/channel/teacher.shtml",)
Modifier la méthode parse().
def parse(self, response):
    filename = "teacher.html"
    open(filename, 'w').write(response.body)
Ensuite, lancez-le pour voir. Exécutez dans le répertoire mySpider :
scrapy crawl itcast
Oui, c'est itcast. En regardant le code ci-dessus, il s'agit de l'attribut name de la classe ItcastSpider, qui est le nom unique du spider lors de l'utilisation de la commande scrapy genspider.
Après l'exécution, si le journal imprimé affiche [scrapy] INFO: Spider closed (finished), cela signifie que l'exécution est terminée. Après cela, un fichier teacher.html apparaît dans le dossier courant, qui contient toutes les informations de code source de la page web que nous venons d'explorer.
Remarque :L'environnement d'encodage par défaut de Python2.x est ASCII. Lorsqu'il ne correspond pas au format d'encodage des données récupérées, du texte illisible peut apparaître ; nous pouvons spécifier le format d'encodage du contenu sauvegardé. Généralement, nous pouvons ajouter en haut du code :
import sys
reload(sys)
sys.setdefaultencoding("utf-8")
Ces trois lignes de code sont la clé universelle pour résoudre les problèmes d'encodage chinois dans Python2.x. Après toutes ces années de plaintes, Python3 a retenu la leçon et son encodage par défaut est Unicode... (Nous espérons que vous adopterez tous Python3 bientôt)
2. Extraire les données
Après avoir exploré toute la page web, l'étape suivante est le processus d'extraction. Observez d'abord le code source de la page :
<div class="li_txt">
    <h3>  xxx  </h3>
    <h4> xxxxx </h4>
    <p> xxxxxxxx </p>
N'est-ce pas évident au premier coup d'œil ? Utilisez directement XPath pour commencer l'extraction des données.
Pour la méthode xpath, il suffit de saisir les règles xpath pour localiser les nœuds de balise html correspondants. Pour plus de détails, vous pouvez consulter :tutoriel xpath。
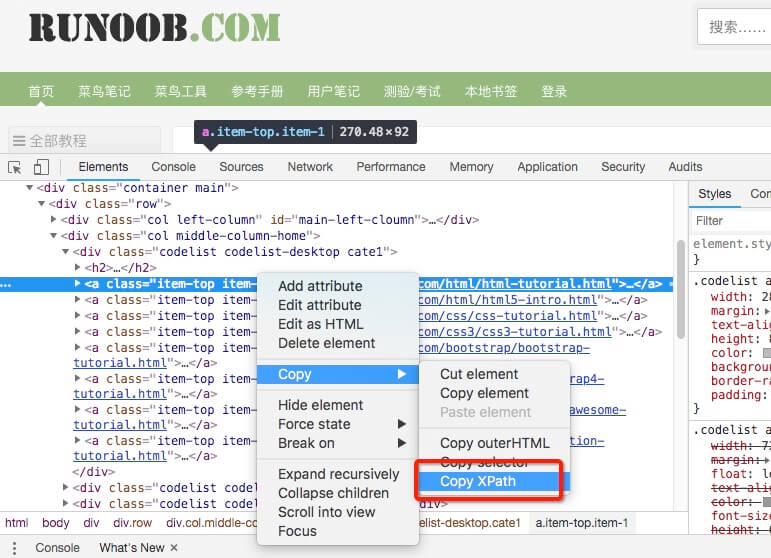
Peu importe si vous ne connaissez pas la syntaxe xpath. Chrome nous fournit un moyen en un clic pour obtenir l'adresse xpath (Right-click -> Inspect -> Copy -> Copy XPath), comme indiqué ci-dessous :
Voici quelques exemples d'expressions XPath et de leurs significations correspondantes :
/html/head/title: Sélectionner dans le document HTML<head>la balise à l'intérieur<title>élément/html/head/title/text(): Sélectionner ce qui est mentionné ci-dessus<title>texte de l'élément//td: Sélectionner tout<td>éléments//div[@class="mine"]: Sélectionner tout avecclass="mine"attributdivéléments
Par exemple, nous lisons le titre du site Webhttp://www.itcast.cn/. Modifiez le code du fichier itcast.py comme suit :
# -*- coding: utf-8 -*-
import scrapy

# 以下三行是在 Python2.x版本中解决乱码问题,Python3.x 版本的可以去掉
import sys
reload(sys)
sys.setdefaultencoding("utf-8")

class Opp2Spider(scrapy.Spider):
    name = 'itcast'
    allowed_domains = ['itcast.com']
    start_urls = ['http://www.itcast.cn/']

    def parse(self, response):
        # 获取网站标题
        context = response.xpath('/html/head/title/text()')

        # 提取网站标题
        title = context.extract_first()
        print(title)
        pass
Exécutez la commande suivante :
$ scrapy crawl itcast
...
...
传智播客官网-好口碑IT培训机构,一样的教育,不一样的品质
...
...
Nous avons précédemment défini une classe ItcastItem dans mySpider/items.py. Ici, nous l'importons :
from mySpider.items import ItcastItem
Ensuite, encapsulez les données que nous avons obtenues dans un objet ItcastItem, qui peut enregistrer les attributs de chaque enseignant :
from mySpider.items import ItcastItem

def parse(self, response):
    #open("teacher.html","wb").write(response.body).close()

    # 存放老师信息的集合
    items = []

    for each in response.xpath("//div[@class='li_txt']"):
        # 将我们得到的数据封装到一个 `ItcastItem` 对象
        item = ItcastItem()
        #extract()方法返回的都是unicode字符串
        name = each.xpath("h3/text()").extract()
        title = each.xpath("h4/text()").extract()
        info = each.xpath("p/text()").extract()

        #xpath返回的是包含一个元素的列表
        item['name'] = name[0]
        item['title'] = title[0]
        item['info'] = info[0]

        items.append(item)

    # 直接返回最后数据
    return items
Nous n'aborderons pas le pipeline pour l'instant ; nous le présenterons en détail plus tard.
Enregistrer les données
Les méthodes les plus simples pour que scrapy enregistre des informations comprennent principalement quatre types. -o produit des fichiers dans le format spécifié, avec les commandes suivantes :
scrapy crawl itcast -o teachers.json
format json lines, l'encodage par défaut est Unicode
scrapy crawl itcast -o teachers.jsonl
format csv séparé par des virgules, peut être ouvert avec Excel
scrapy crawl itcast -o teachers.csv
format xml
scrapy crawl itcast -o teachers.xml
Réflexion
Si vous modifiez le code sous la forme suivante, le résultat est exactement le même.
Veuillez réfléchir au rôle de yield ici (Brève analyse de l'utilisation de yield en Python):
# -*- coding: utf-8 -*-
import scrapy
from mySpider.items import ItcastItem

# 以下三行是在 Python2.x版本中解决乱码问题,Python3.x 版本的可以去掉
import sys
reload(sys)
sys.setdefaultencoding("utf-8")

class Opp2Spider(scrapy.Spider):
    name = 'itcast'
    allowed_domains = ['itcast.com']
    start_urls = ("http://www.itcast.cn/channel/teacher.shtml",)

    def parse(self, response):
        #open("teacher.html","wb").write(response.body).close()

        # 存放老师信息的集合
        items = []

        for each in response.xpath("//div[@class='li_txt']"):
            # 将我们得到的数据封装到一个 `ItcastItem` 对象
            item = ItcastItem()
            #extract()方法返回的都是unicode字符串
            name = each.xpath("h3/text()").extract()
            title = each.xpath("h4/text()").extract()
            info = each.xpath("p/text()").extract()

            #xpath返回的是包含一个元素的列表
            item['name'] = name[0]
            item['title'] = title[0]
            item['info'] = info[0]

            items.append(item)

        # 直接返回最后数据
        return items
Lien original : https://segmentfault.com/a/1190000013178839