Sklearn-Einführung
Sklearn, dessen vollständiger NameSklearnlautet, ist eine Open-Source-Bibliothek für maschinelles Lernen, die auf Python basiert.
Sklearn ist eine leistungsstarke und benutzerfreundliche Bibliothek für maschinelles Lernen, die einen vollständigen Satz von Werkzeugen von der Datenvorverarbeitung bis zur Modellbewertung bietet.
Sklearn baut auf NumPy und SciPy auf und kann daher numerische Berechnungen und Array-Operationen effizient verarbeiten.
Sklearn eignet sich für verschiedene Aufgaben des maschinellen Lernens wie Klassifikation, Regression, Clustering, Dimensionsreduktion usw.
Mit seiner prägnanten und konsistenten API ist Sklearn zu einem der unverzichtbaren Werkzeuge für Enthusiasten und Experten des maschinellen Lernens geworden.
Wie Sklearn funktioniert
In Sklearn folgt der Prozess des maschinellen Lernens einem bestimmten Muster: Datenladen, Datenvorverarbeitung, Modelltraining, Modellbewertung und Modelloptimierung.
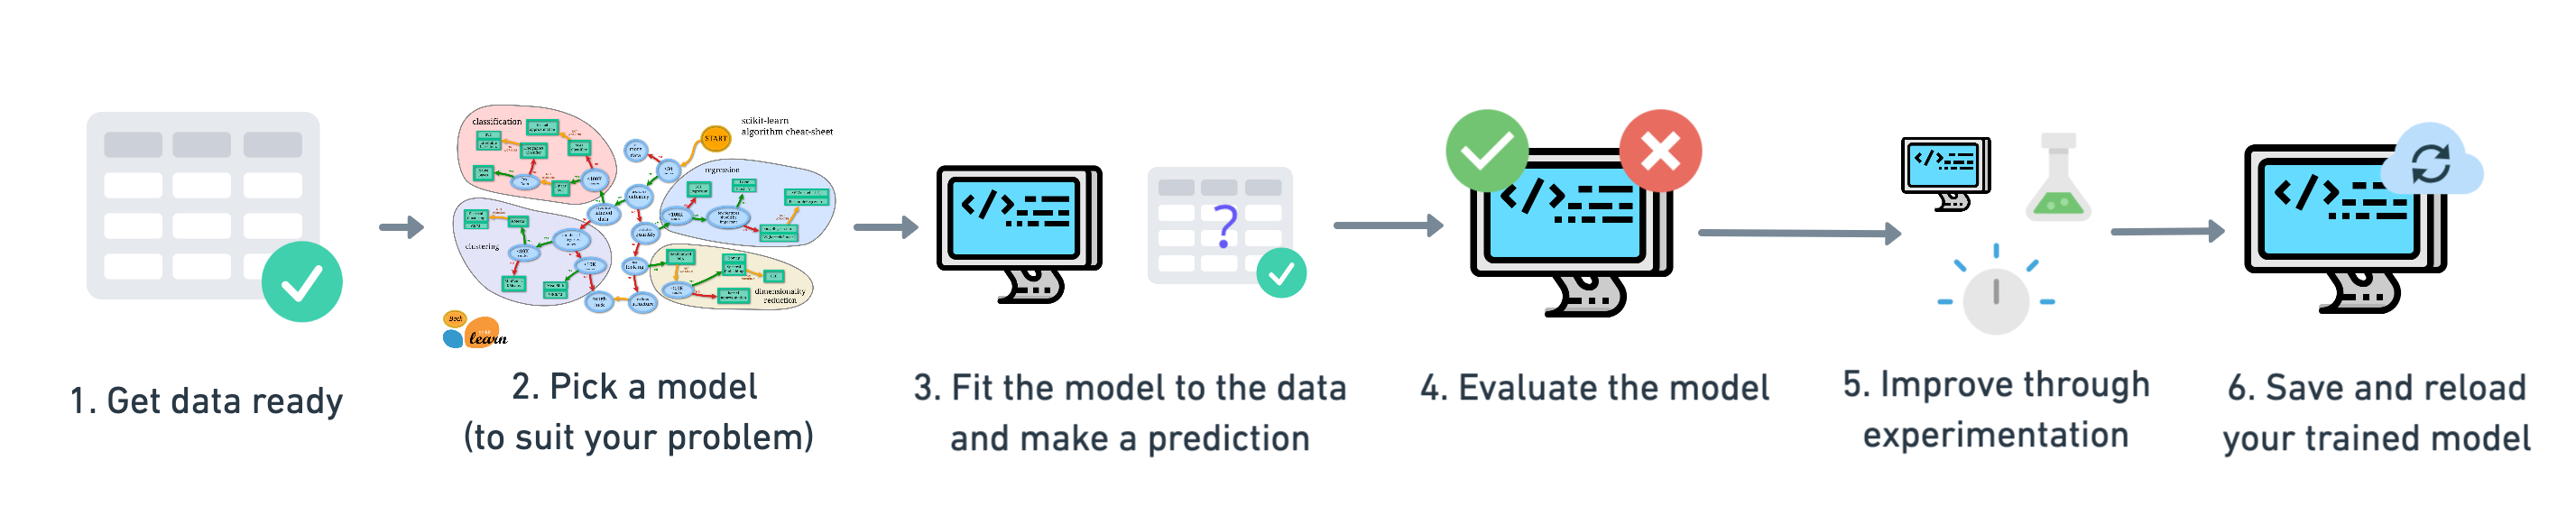
Der spezifische Workflow sieht wie folgt aus:
- Datenladen: Laden Sie den Datensatz mit Sklearn oder anderen Bibliotheken, zum Beispiel über
datasets.load_iris()laden Sie den klassischen Iris-Datensatz oder verwenden Sietrain_test_split()teilen Sie die Daten auf. - Datenvorverarbeitung: Je nach Datentyp können Operationen wie Standardisierung, Rauschunterdrückung und Imputation fehlender Werte erforderlich sein.
- Algorithmus auswählen und Modell trainieren: Wählen Sie einen geeigneten Algorithmus (wie logistische Regression, Support-Vektor-Maschine usw.) und verwenden Sie
.fit()Methode, um das Modell zu trainieren. - Modellbewertung: Verwenden Sie Kreuzvalidierung oder eine einzelne Trainings-/Testaufteilung, um Leistungskennzahlen wie Genauigkeit, Recall und F1-Score zu bewerten.
- Modelloptimierung: Verwenden Sie Grid Search (
GridSearchCV) oder Random Search (RandomizedSearchCV), um eine Hyperparameter-Optimierung am Modell durchzuführen und die Modellleistung zu verbessern.
Eigenschaften von Sklearn
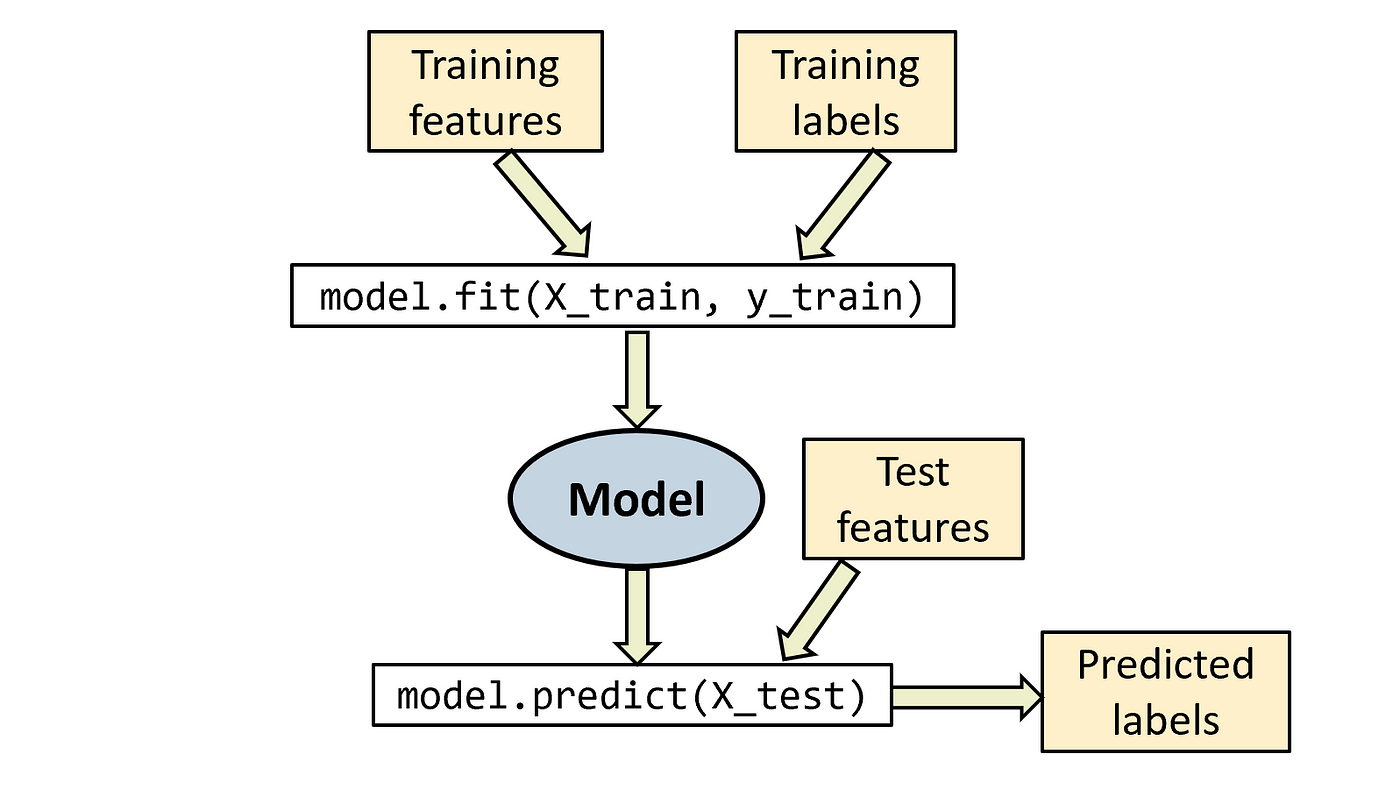
- Benutzerfreundlichkeit: Das API-Design von Sklearn ist prägnant und konsistent, wodurch die Lernkurve relativ flach ausfällt. Durch einfache
fit、predict、scoreMethoden wie ... können Sie Machine-Learning-Aufgaben schnell umsetzen. - Effizienz: Obwohl Sklearn in reinem Python geschrieben ist, basieren die meisten seiner zugrunde liegenden Implementierungen auf Cython und NumPy, was es bei der Ausführung von Machine-Learning-Algorithmen sehr schnell macht.
- Umfangreiche Funktionalität: Sklearn bietet eine große Anzahl klassischer Machine-Learning-Algorithmen, darunter:
- Klassifikationsalgorithmen: wie logistische Regression, Support Vector Machine (SVM), K-Nearest-Neighbors (KNN), Random Forest usw.
- Regressionsalgorithmen: wie lineare Regression, Ridge-Regression, Lasso-Regression usw.
- Clustering-Algorithmen: wie K-Means, hierarchisches Clustering, DBSCAN usw.
- Algorithmen zur Dimensionsreduktion: wie Hauptkomponentenanalyse (PCA), t-SNE usw.
- Modellauswahl und -bewertung: Kreuzvalidierung, Gittersuche, Modellbewertungsmetriken, usw.
- Gute Kompatibilität: Sklearn ist gut kompatibel mit Python-Datenverarbeitungsbibliotheken wie NumPy, SciPy und Pandas und unterstützt mehrere Datenformate (wie NumPy-Arrays und Pandas-DataFrames) für Ein- und Ausgabe.
Von Sklearn unterstützte Machine-Learning-Aufgaben
Sklearn bietet eine Vielzahl von Werkzeugen und unterstützt die folgenden Arten von Machine-Learning-Aufgaben:
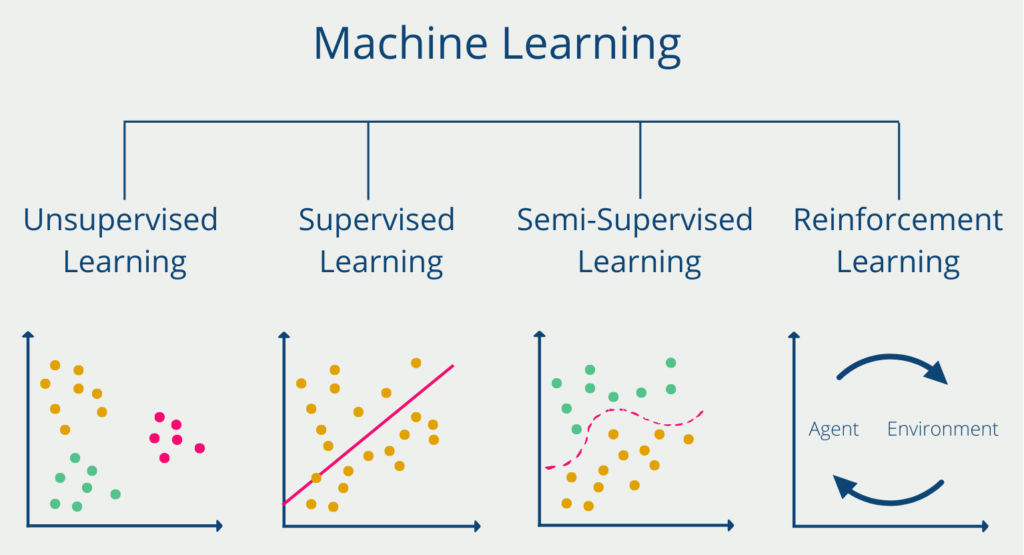
- Überwachtes Lernen:
- Klassifikationsprobleme: Die Kategorie von Daten vorhersagen (z. B. E-Mail-Spam-Klassifikation, Bildklassifikation, Krankheitsvorhersage usw.).
- Regressionsprobleme: Kontinuierliche Werte vorhersagen (z. B. Hauspreisvorhersage, Aktienkursvorhersage usw.).
- Unüberwachtes Lernen:
- Clustering-Probleme: Daten in verschiedene Cluster gruppieren (z. B. Kundensegmentierung, Dokumentenclustering usw.).
- Dimensionsreduktionsprobleme: Hochdimensionale Daten in einen niedrigdimensionalen Raum projizieren, um die Visualisierung zu erleichtern oder die Rechenkomplexität zu reduzieren (z. B. PCA, t-SNE).
- Semi-supervised Learning: Einige Daten sind beschriftet, andere unbeschriftet, und das Modell versucht, Informationen aus diesen Daten zu extrahieren.
- Reinforcement Learning: Obwohl Sklearn hauptsächlich auf überwachtes und unüberwachtes Lernen ausgerichtet ist, verfügt es auch über einige verwandte Werkzeuge, die zur Behandlung von Reinforcement-Learning-Problemen verwendet werden können.
Häufige Module und Klassen in Sklearn
- Klassifikation
sklearn.linear_model.LogisticRegression: Logistische Regressionsklearn.svm.SVC: Support-Vektor-Maschinen-Klassifikationsklearn.neighbors.KNeighborsClassifier: K-Nächste-Nachbarn-Klassifikationsklearn.ensemble.RandomForestClassifier: Random-Forest-Klassifikation
- Regression
sklearn.linear_model.LinearRegression: Lineare Regressionsklearn.linear_model.Ridge: Ridge-Regressionsklearn.ensemble.RandomForestRegressor: Random-Forest-Regression
- Clustering
sklearn.cluster.KMeans: K-Means-Clusteringsklearn.cluster.DBSCAN: Dichtebasiertes räumliches Clustering
- Dimensionsreduktion
sklearn.decomposition.PCA: Hauptkomponentenanalyse (PCA)sklearn.decomposition.NMF: Nichtnegative Matrixfaktorisierung
- Modellauswahl
sklearn.model_selection.train_test_split: Datensatz in Trainings- und Testsets aufteilensklearn.model_selection.GridSearchCV: Grid Search zur Suche nach den besten Hyperparametern
- Datenvorverarbeitung
sklearn.preprocessing.StandardScaler: Standardisierungsklearn.preprocessing.MinMaxScaler: Min-Max-Standardisierungsklearn.preprocessing.OneHotEncoder: One-Hot-Encoding
Häufige Begriffe erklärt
- Fit: Bezieht sich auf das Anwenden des Modells auf Trainingsdaten und das Anpassen der Modellparameter durch Training.
model.fit(X_train, y_train) - Predict: Vorhersage unbekannter Daten basierend auf dem trainierten Modell.
model.predict(X_test) - Evaluation (Score): Bewertet die Leistung des Modells und gibt üblicherweise eine Bewertungsmetrik wie Genauigkeit zurück.
model.score(X_test, y_test) - Cross-validation: Teilt den Datensatz in mehrere Teilmengen auf und bewertet die Stabilität und Generalisierungsfähigkeit des Modells durch mehrere Runden von Training und Validierung.
Beziehung zwischen Sklearn und anderen Bibliotheken
- Beziehung zu NumPy und SciPy: Sklearn baut auf NumPy und SciPy auf, sodass es numerische Berechnungen und Array-Operationen effizient verarbeiten kann.
- Beziehung zu Pandas: Pandas bietet leistungsstarke Datenverarbeitungsfunktionen, während Sklearn das direkte Extrahieren von Daten aus Pandas DataFrames für Modelltraining und Vorhersage unterstützt.
- Beziehung zu TensorFlow und PyTorch: Sklearn konzentriert sich hauptsächlich auf traditionelle Machine-Learning-Methoden, während TensorFlow und PyTorch sich stärker auf Deep-Learning-Modelle konzentrieren. Dennoch kann Sklearn in Kombination mit diesen Bibliotheken verwendet werden, um einige vorbereitende Feature-Engineering-Aufgaben zu erledigen oder als Basismodelle für den Vergleich mit Deep Learning zu dienen.