Introducción a Sklearn
Sklearn, cuyo nombre completo esSklearn, es una biblioteca de aprendizaje automático de código abierto basada en Python.
Sklearn es una biblioteca de aprendizaje automático potente y fácil de usar que proporciona un conjunto completo de herramientas desde el preprocesamiento de datos hasta la evaluación de modelos.
Sklearn está construido sobre NumPy y SciPy, por lo que puede manejar eficientemente cálculos numéricos y operaciones con matrices.
Sklearn es adecuado para diversos tipos de tareas de aprendizaje automático, como clasificación, regresión, agrupamiento, reducción de dimensionalidad, etc.
Gracias a su API simple y consistente, Sklearn se ha convertido en una de las herramientas imprescindibles para entusiastas y expertos del aprendizaje automático.
Cómo funciona Sklearn
En Sklearn, el flujo de aprendizaje automático sigue un patrón: carga de datos, preprocesamiento de datos, entrenamiento del modelo, evaluación del modelo y optimización del modelo.
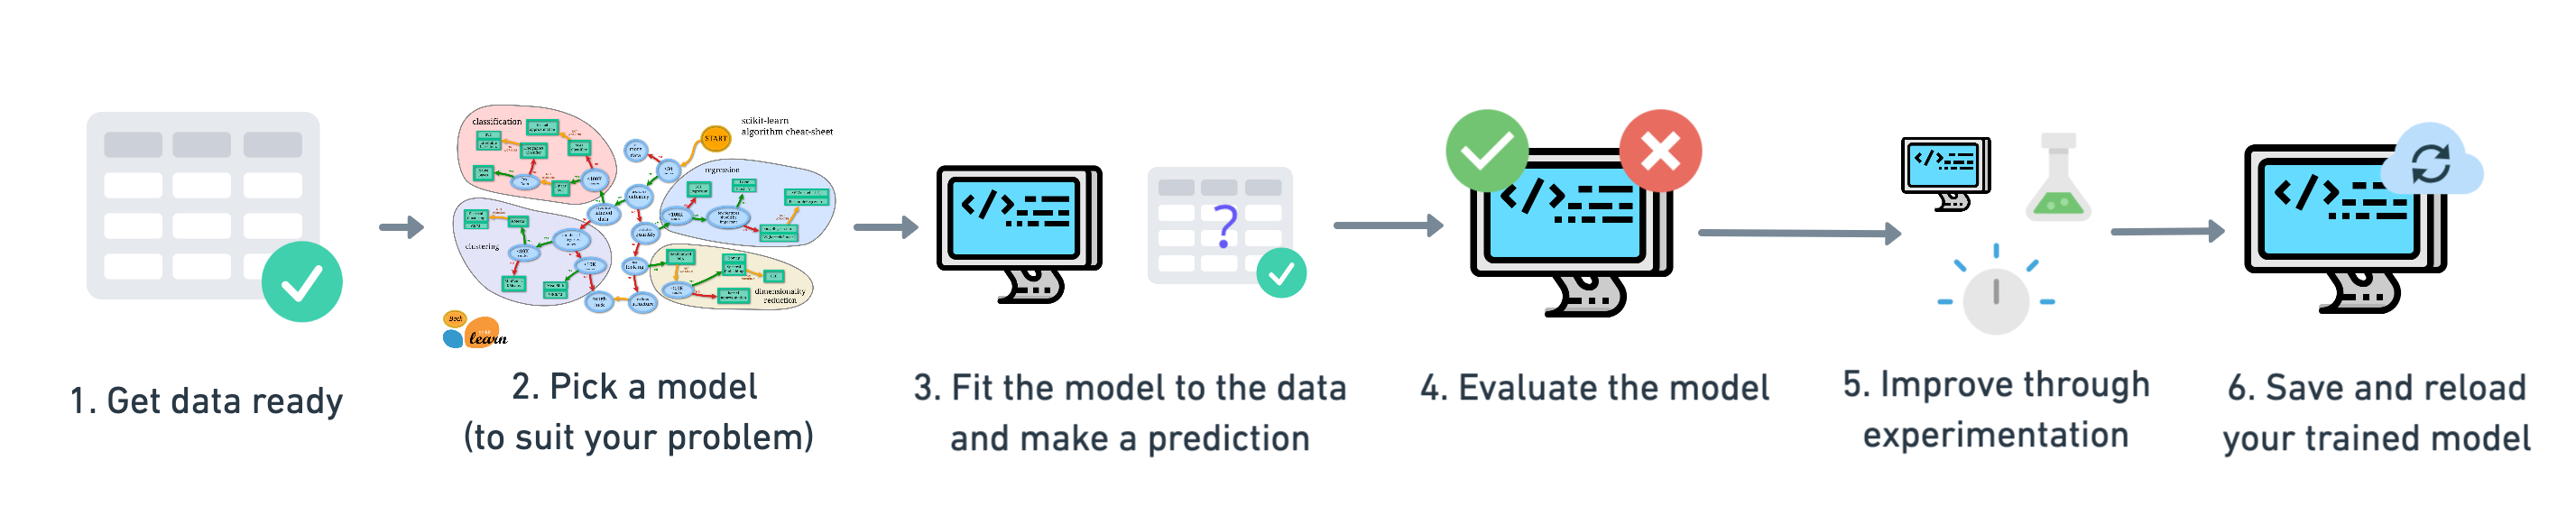
El flujo de trabajo específico es el siguiente:
- Carga de datos: use Sklearn u otras bibliotecas para cargar conjuntos de datos, por ejemplo mediante
datasets.load_iris()cargar el clásico conjunto de datos Iris, o usartrain_test_split()dividir los datos. - Preprocesamiento de datos: según el tipo de datos, pueden ser necesarias operaciones como estandarización, eliminación de ruido, imputación de valores faltantes, etc.
- Seleccionar el algoritmo y entrenar el modelo: elija el algoritmo adecuado (como regresión logística, máquinas de soporte vectorial, etc.), use
.fit()método para entrenar el modelo. - Evaluación del modelo: use validación cruzada o un único conjunto de entrenamiento/prueba para evaluar métricas de rendimiento como precisión, recuperación, puntuación F1, etc.
- Optimización del modelo: use la búsqueda en cuadrícula (
GridSearchCV) o búsqueda aleatoria (RandomizedSearchCV) para optimizar los hiperparámetros del modelo y mejorar su rendimiento.
Características de Sklearn
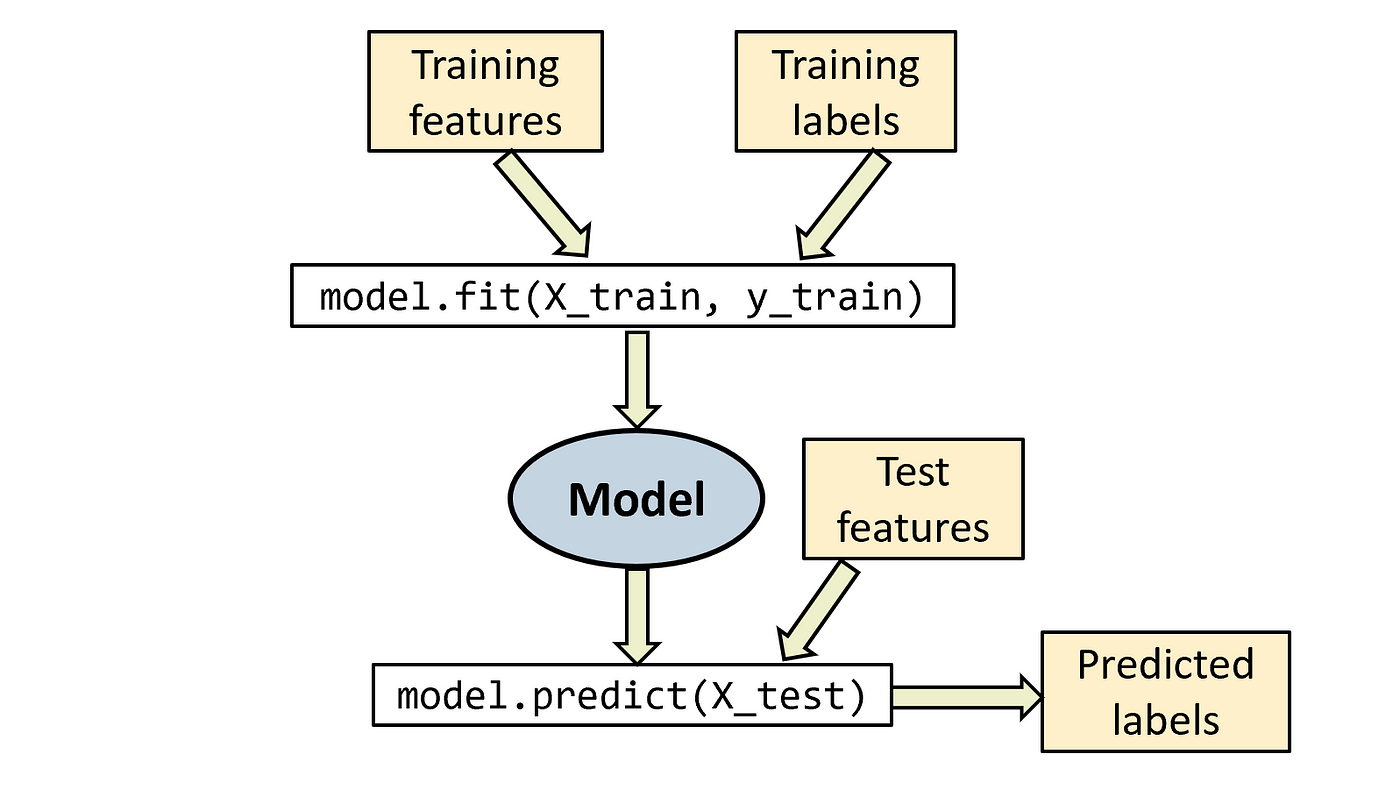
- Facilidad de uso: el diseño de la API de Sklearn es simple y consistente, lo que hace que la curva de aprendizaje sea relativamente suave. Con simples
fit、predict、scoremétodos como estos, se pueden implementar rápidamente tareas de aprendizaje automático. - Eficiencia: aunque Sklearn está escrito en Python puro, la mayoría de sus implementaciones subyacentes dependen de Cython y NumPy, lo que lo hace muy rápido al ejecutar algoritmos de aprendizaje automático.
- Amplia funcionalidad: Sklearn proporciona una gran cantidad de algoritmos clásicos de aprendizaje automático, incluyendo:
- Algoritmos de clasificación: como regresión logística, máquinas de soporte vectorial (SVM), K vecinos más cercanos (KNN), bosques aleatorios, etc.
- Algoritmos de regresión: como regresión lineal, regresión ridge, regresión Lasso, etc.
- Algoritmos de agrupamiento: como K-means, agrupamiento jerárquico, DBSCAN, etc.
- Algoritmos de reducción de dimensionalidad: como análisis de componentes principales (PCA), t-SNE, etc.
- Selección y evaluación de modelos: validación cruzada, búsqueda en cuadrícula, métricas de evaluación de modelos, etc.
- Buena compatibilidad: Sklearn es altamente compatible con bibliotecas de procesamiento de datos de Python como NumPy, SciPy, Pandas, y admite múltiples formatos de datos (como matrices NumPy, DataFrames de Pandas) para entrada y salida.
Tareas de aprendizaje automático compatibles con Sklearn
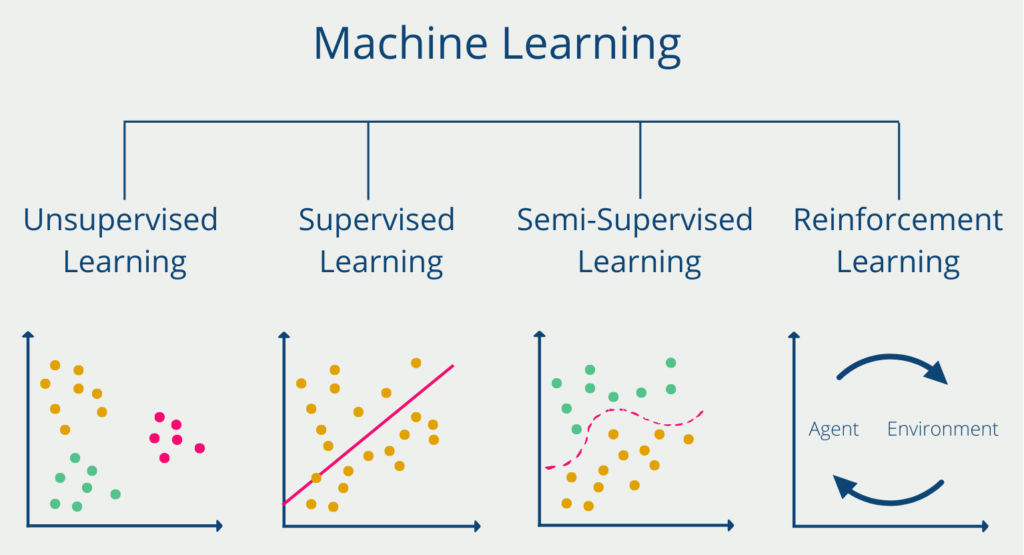
Sklearn proporciona herramientas ricas y compatibles con los siguientes tipos de tareas de aprendizaje automático:
- Aprendizaje supervisado:
- Problemas de clasificación: predecir la categoría de los datos (por ejemplo, clasificación de correos electrónicos no deseados, clasificación de imágenes, predicción de enfermedades, etc.).
- Problemas de regresión: predecir valores continuos (por ejemplo, predicción de precios de viviendas, predicción del precio de acciones, etc.).
- Aprendizaje no supervisado:
- Problemas de agrupamiento: agrupar datos en diferentes clústeres (por ejemplo, segmentación de clientes, agrupamiento de documentos, etc.).
- Problemas de reducción de dimensionalidad: proyectar datos de alta dimensión a un espacio de baja dimensión para facilitar la visualización o reducir la complejidad computacional (por ejemplo, PCA, t-SNE).
- Aprendizaje semisupervisado: algunos datos están etiquetados y otros no, y el modelo intenta extraer información de estos datos.
- Aprendizaje por refuerzo: aunque Sklearn se centra principalmente en el aprendizaje supervisado y no supervisado, también cuenta con algunas herramientas relacionadas que pueden utilizarse para abordar problemas de aprendizaje por refuerzo.
Módulos y clases comunes en Sklearn
- Clasificación
sklearn.linear_model.LogisticRegression: regresión logísticasklearn.svm.SVC: clasificación con máquinas de soporte vectorialsklearn.neighbors.KNeighborsClassifier: clasificación por K vecinos más cercanossklearn.ensemble.RandomForestClassifier: clasificación con bosques aleatorios
- Regresión
sklearn.linear_model.LinearRegression: regresión linealsklearn.linear_model.Ridge: regresión ridgesklearn.ensemble.RandomForestRegressor: regresión con bosques aleatorios
- Agrupamiento (Clustering)
sklearn.cluster.KMeans: agrupamiento por K-meanssklearn.cluster.DBSCAN: agrupamiento espacial basado en densidad
- Reducción de dimensionalidad
sklearn.decomposition.PCA: análisis de componentes principales (PCA)sklearn.decomposition.NMF: factorización de matrices no negativas
- Selección de modelos
sklearn.model_selection.train_test_split: dividir el conjunto de datos en conjunto de entrenamiento y pruebasklearn.model_selection.GridSearchCV: búsqueda en cuadrícula para encontrar los mejores hiperparámetros
- Preprocesamiento de datos
sklearn.preprocessing.StandardScaler: estandarizaciónsklearn.preprocessing.MinMaxScaler: normalización mínima-máxima (min-max)sklearn.preprocessing.OneHotEncoder: codificación one-hot
Explicación de términos comunes
- Ajuste (Fit): se refiere a aplicar el modelo a los datos de entrenamiento y ajustar sus parámetros mediante el entrenamiento.
model.fit(X_train, y_train) - Predicción (Predict): predecir datos desconocidos basándose en el modelo entrenado.
model.predict(X_test) - Evaluación (Score): evalúa el rendimiento del modelo y normalmente devuelve una métrica de puntuación, como la exactitud.
model.score(X_test, y_test) - Validación cruzada: divide el conjunto de datos en varios subconjuntos y evalúa la estabilidad y la capacidad de generalización del modelo mediante múltiples entrenamientos y validaciones.
Relación de Sklearn con otras bibliotecas
- Relación con NumPy y SciPy: Sklearn está construido sobre NumPy y SciPy, por lo que puede manejar eficientemente cálculos numéricos y operaciones con matrices.
- Relación con Pandas: Pandas proporciona potentes capacidades de procesamiento de datos, mientras que Sklearn admite la extracción directa de datos de los DataFrames de Pandas para el entrenamiento de modelos y la predicción.
- Relación con TensorFlow y PyTorch: Sklearn se centra principalmente en métodos tradicionales de aprendizaje automático, mientras que TensorFlow y PyTorch se enfocan más en modelos de aprendizaje profundo. No obstante, Sklearn puede combinarse con estas bibliotecas para realizar tareas preliminares de ingeniería de características, o servir como modelo base para comparar con el aprendizaje profundo.