Введение в Sklearn
Sklearn, полное название которого —Sklearn, — это библиотека машинного обучения с открытым исходным кодом, основанная на Python.
Sklearn — мощная и простая в использовании библиотека машинного обучения, предоставляющая полный набор инструментов от предобработки данных до модели.
Sklearn построена на основе NumPy и SciPy, поэтому она может эффективно выполнять численные вычисления и операции с массивами.
Sklearn подходит для различных задач машинного обучения, таких как классификация, регрессия, кластеризация, снижение размерности и т. д.
Благодаря своему лаконичному и согласованному API, Sklearn стал одним из основных инструментов для энтузиастов и экспертов в области машинного обучения.
Как работает Sklearn
В Skink процесс машинного обучения следует определённой схеме: загрузка данных, предобработка данных, обучение модели, оценка модели и настройка модели.
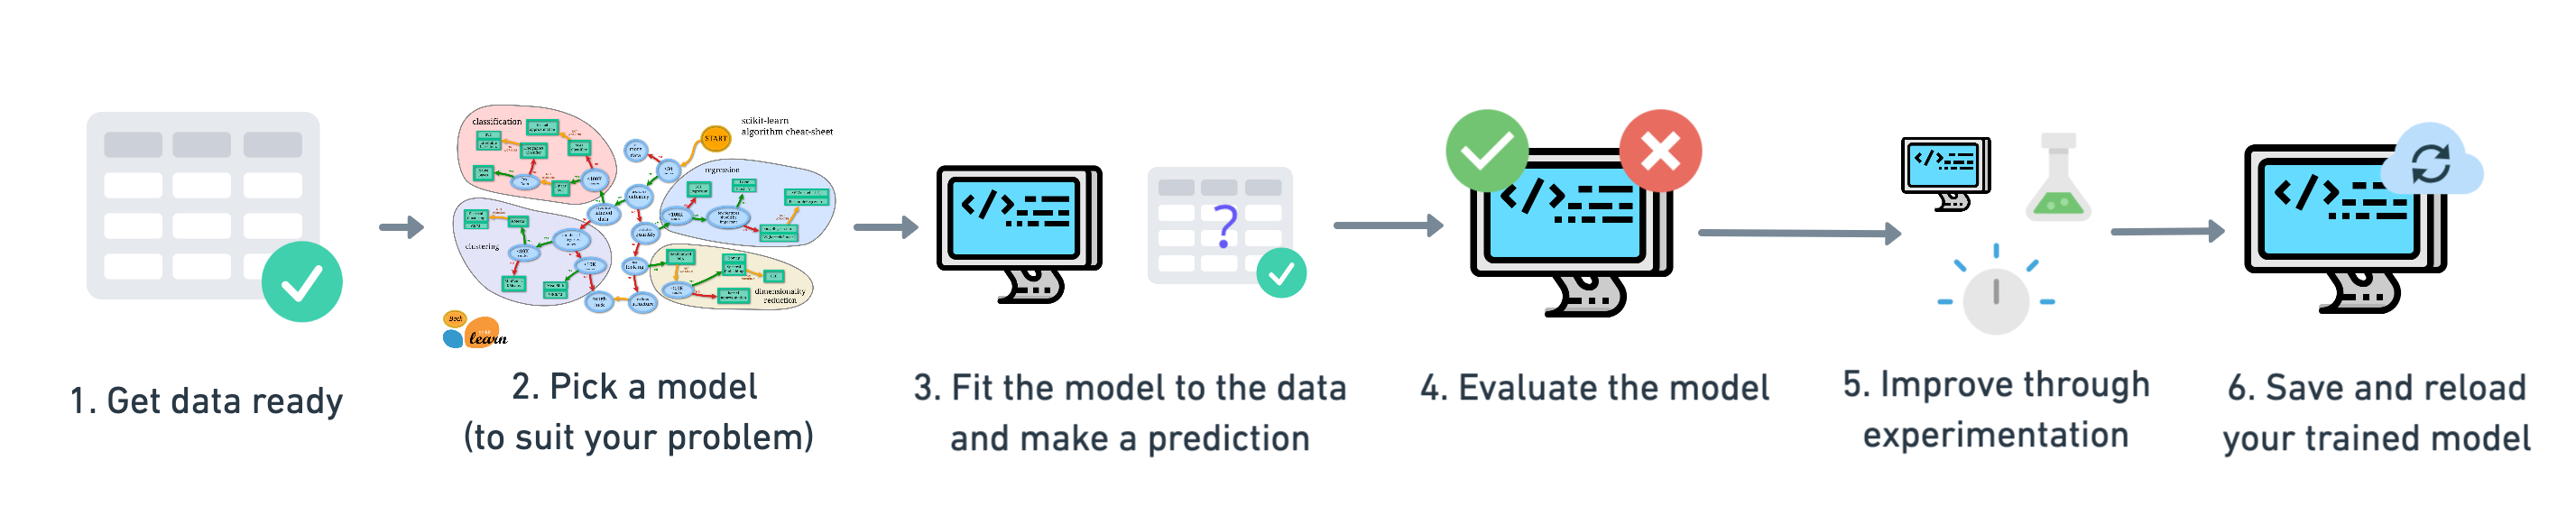
Конкретный рабочий процесс выглядит следующим образом:
- Загрузка данных: загрузите набор данных с помощью Sklearn или других библиотек, например через
datasets.load_iris()загрузить классический набор данных Iris или использоватьtrain_test_split()разделить данные. - Предобработка данных: в зависимости от типа данных могут потребоваться такие операции, как стандартизация, удаление шума и заполнение пропущенных значений.
- Выбор алгоритма и обучение модели: выберите подходящий алгоритм (например, логистическая регрессия, метод опорных векторов и т. д.) и используйте
.fit()метод для обучения модели. - Оценка модели: используйте кросс-валидацию или единый обучающий/тестовый набор для оценки таких метрик производительности, как точность и F1-мера.
- Оптимизация модели: Используйте поиск по сетке (
GridSearchCV) или случайный поиск (RandomizedSearchCV) для выполнения оптимизации гиперпараметров модели, что улучшает производительность модели.
Возможности Sklearn
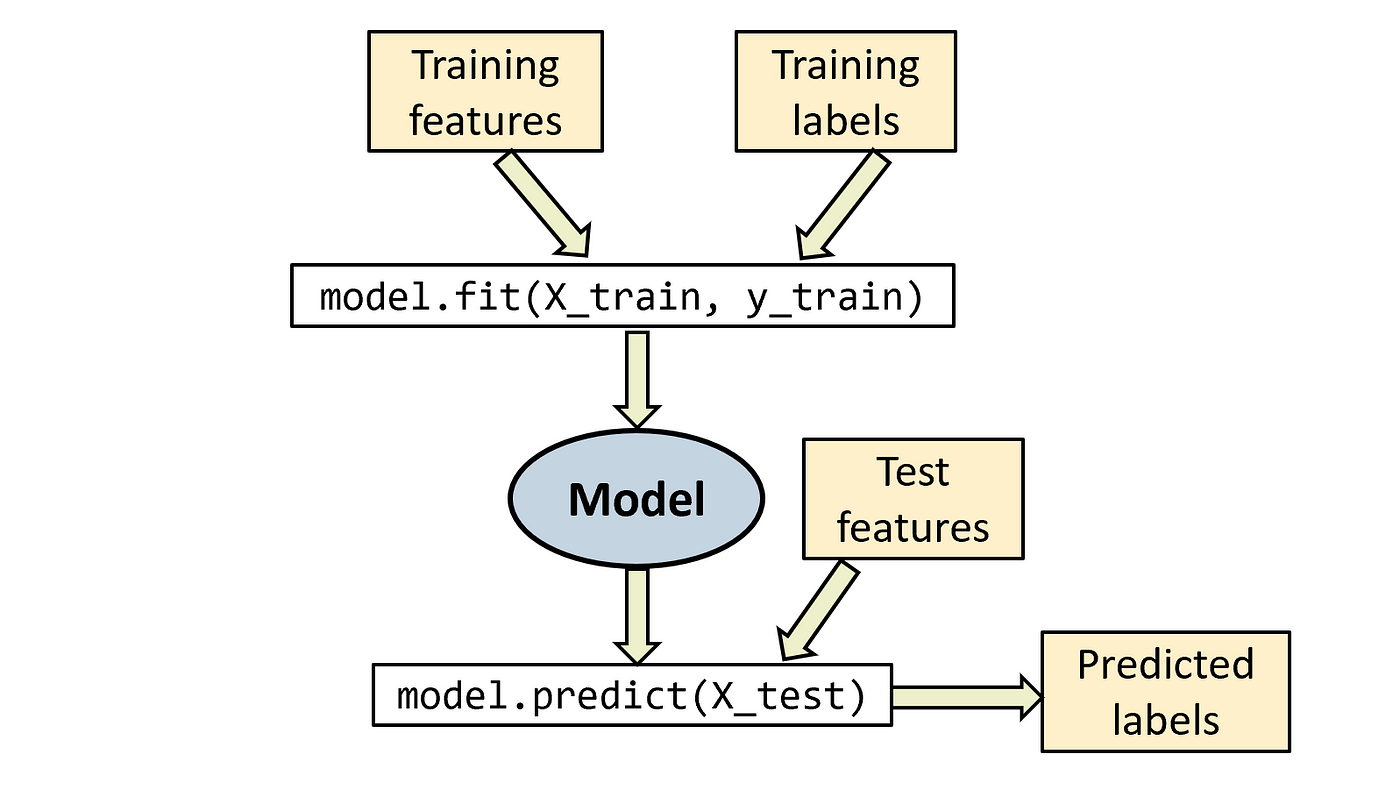
- Простота использования: Дизайн API Sklearn краток и последователен, что делает кривую обучения относительно пологой. С помощью простых
fit、predict、scoreметодов, таких как ..., можно быстро реализовать задачи машинного обучения. - Эффективность: Хотя Sklearn написан на чистом Python, большинство его низкоуровневых реализаций полагаются на Cython и NumPy, что делает его очень быстрым при выполнении алгоритмов машинного обучения.
- Богатая функциональность: Sklearn предоставляет большое количество классических алгоритмов машинного обучения, включая:
- Алгоритмы классификации: такие как логистическая регрессия, метод опорных векторов (SVM), K-ближайших соседей (KNN), случайный лес и т. д.
- Алгоритмы регрессии: такие как линейная регрессия, гребневая регрессия, Lasso-регрессия и т. д.
- Алгоритмы кластеризации: такие как K-means, иерархическая кластеризация, DBSCAN и т. д.
- Алгоритмы снижения размерности: такие как метод главных компонент (PCA), t-SNE и т. д.
- Выбор и оценка модели: кросс-валидация, поиск по сетке, метрики оценки модели и т. д.
- Хорошая совместимость: Sklearn хорошо совместим с библиотеками обработки данных Python, такими как NumPy, SciPy и Pandas, и поддерживает множество форматов данных (например, массивы NumPy и Pandas DataFrames) для ввода и вывода.
Задачи машинного обучения, поддерживаемые Sklearn
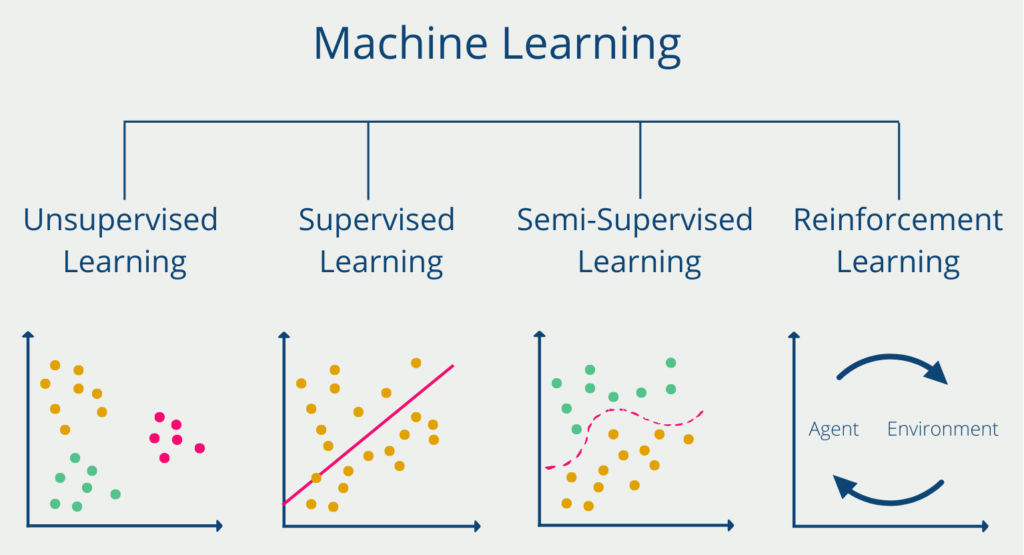
Sklearn предоставляет богатый набор инструментов и поддерживает следующие типы задач машинного обучения:
- Обучение с учителем:
- Задачи классификации: Предсказание категории данных (например, классификация спама в электронной почте, классификация изображений, прогнозирование заболеваний и т. д.).
- Задачи регрессии: Предсказание непрерывных значений (например, прогнозирование цен на жильё, прогнозирование цен на акции и т. д.).
- Обучение без учителя:
- Задачи кластеризации: Группировка данных в разные кластеры (например, сегментация клиентов, кластеризация документов и т. д.).
- Задачи снижения размерности: Проецирование высокоразмерных данных в низкоразмерное пространство для облегчения визуализации или снижения вычислительной сложности (например, PCA, t-SNE).
- Частичное обучение с учителем: Часть данных размечена, часть — не размечена, и модель пытается извлечь информацию из этих данных.
- Обучение с подкреплением: Хотя Sklearn в основном ориентирован на обучение с учителем и без учителя, у него также есть некоторые связанные инструменты, которые можно использовать для решения задач обучения с подкреплением.
Общие модули и классы в Sklearn
- Классификация
sklearn.linear_model.LogisticRegression: Логистическая регрессияsklearn.svm.SVC: Классификация методом опорных векторовsklearn.neighbors.KNeighborsClassifier: Классификация методом K-ближайших соседейsklearn.ensemble.RandomForestClassifier: Классификация методом случайного леса
- Регрессия
sklearn.linear_model.LinearRegression: Линейная регрессияsklearn.linear_model.Ridge: Гребневая регрессияsklearn.ensemble.RandomForestRegressor: Регрессия методом случайного леса
- Кластеризация
sklearn.cluster.KMeans: Кластеризация методом K-среднихsklearn.cluster.DBSCAN: Пространственная кластеризация на основе плотности
- Снижение размерности
sklearn.decomposition.PCA: Анализ главных компонент (PCA)sklearn.decomposition.NMF: Неотрицательная матричная факторизация
- Выбор модели
sklearn.model_selection.train_test_split: Разделение набора данных на обучающую и тестовую выборкиsklearn.model_selection.GridSearchCV: Поиск по сетке для нахождения лучших гиперпараметров
- Предобработка данных
sklearn.preprocessing.StandardScaler: Стандартизацияsklearn.preprocessing.MinMaxScaler: Стандартизация Min-maxsklearn.preprocessing.OneHotEncoder: One-hot-кодирование
Объяснение общих терминов
- Fit: Относится к применению модели к обучающим данным и настройке параметров модели в процессе обучения.
model.fit(X_train, y_train) - Predict: Предсказание неизвестных данных на основе обученной модели.
model.predict(X_test) - Оценка (Score): Оценивает производительность модели, обычно возвращая метрику оценки, такую как accuracy.
model.score(X_test, y_test) - Кросс-валидация: Разделяет набор данных на несколько подмножеств и оценивает стабильность и способность модели к обобщению посредством нескольких раундов обучения и валидации.
Связь между Sklearn и другими библиотеками
- Связь с NumPy и SciPy: Sklearn построена на основе NumPy и SciPy, поэтому она может эффективно выполнять численные вычисления и операции с массивами.
- Связь с Pandas: Pandas предоставляет мощные возможности обработки данных, а Sklearn поддерживает извлечение данных непосредственно из Pandas DataFrame для обучения и предсказания модели.
- Связь с TensorFlow и PyTorch: Sklearn в основном ориентирован на традиционные методы машинного обучения, тогда как TensorFlow и PyTorch больше сосредоточены на моделях глубокого обучения. Тем не менее, Sklearn можно использовать в сочетании с этими библиотеками для выполнения некоторых предварительных задач по конструированию признаков или в качестве базовых моделей для сравнения с глубоким обучением.