Introduction à Sklearn
Sklearn, dont le nom complet estSklearn, est une bibliothèque d'apprentissage automatique open source basée sur Python.
Sklearn est une bibliothèque d'apprentissage automatique puissante et facile à utiliser, offrant un ensemble complet d'outils allant du prétraitement des données à l'évaluation des modèles.
Sklearn est construit au-dessus de NumPy et SciPy, il peut donc gérer efficacement les calculs numériques et les opérations sur les tableaux.
Sklearn convient à diverses tâches d'apprentissage automatique, telles que la classification, la régression, le clustering, la réduction de dimensionnalité, etc.
Avec son API concise et cohérente, Sklearn est devenu l'un des outils essentiels pour les passionnés et les experts en apprentissage automatique.
Comment fonctionne Sklearn
Dans Sklearn, le processus d'apprentissage automatique suit un certain schéma : chargement des données, prétraitement des données, entraînement du modèle, évaluation du modèle et réglage du modèle.
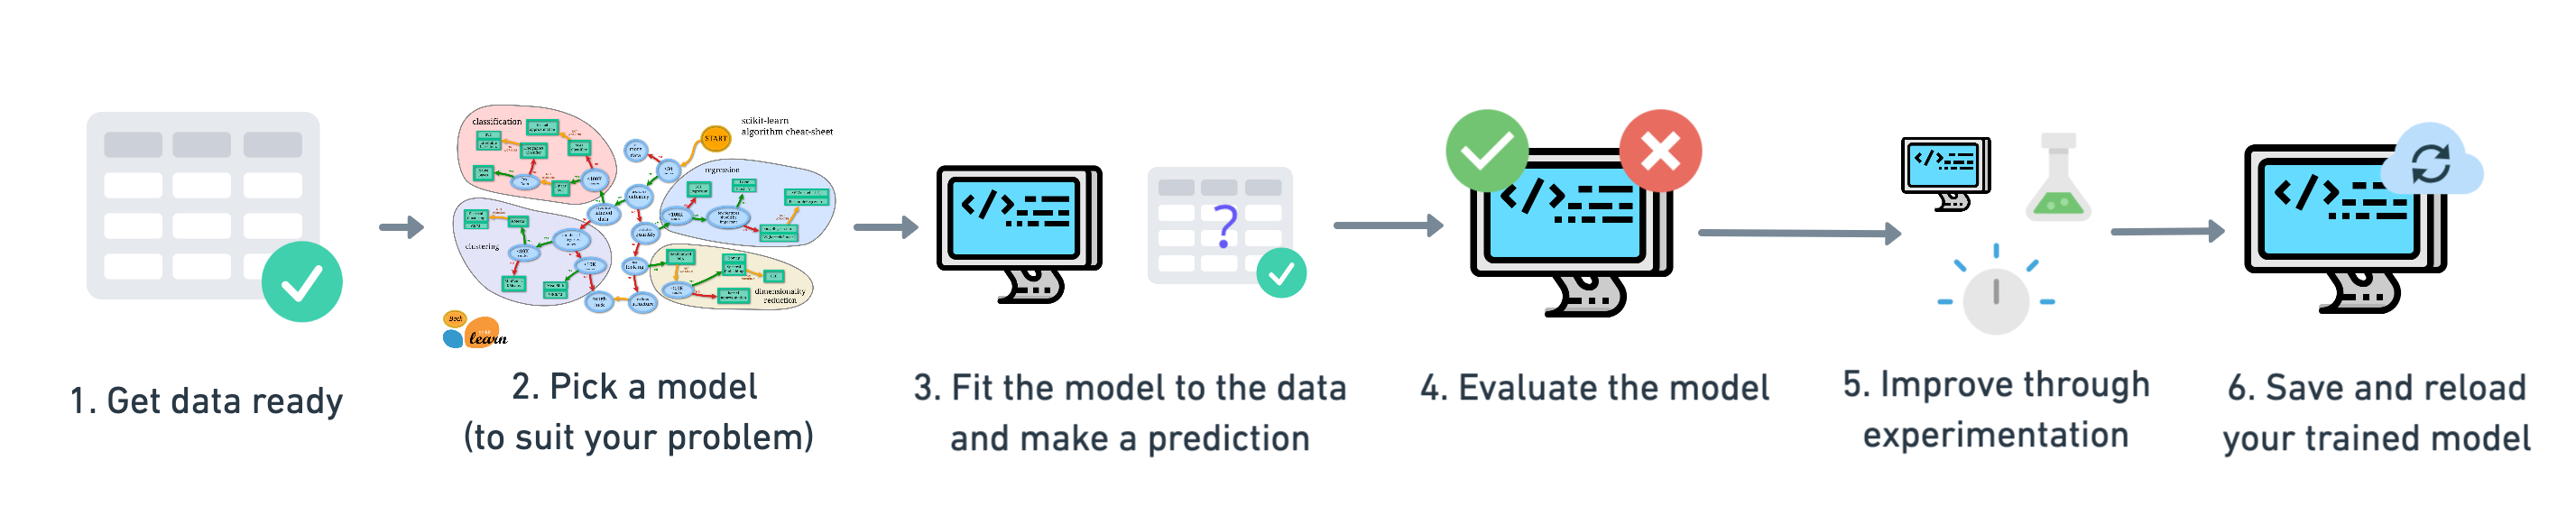
Le flux de travail spécifique est le suivant :
- Chargement des données: Chargez le jeu de données à l'aide de Sklearn ou d'autres bibliothèques, par exemple via
datasets.load_iris()chargez le jeu de données Iris classique, ou utiliseztrain_test_split()diviser les données. - Prétraitement des données: Selon le type de données, des opérations telles que la standardisation, le débruitage et l'imputation des valeurs manquantes peuvent être nécessaires.
- Sélectionner un algorithme et entraîner le modèle: Sélectionnez un algorithme approprié (tel que la régression logistique, la machine à vecteurs de support, etc.), et utilisez
.fit()méthode pour entraîner le modèle. - Évaluation du modèle: Utilisez la validation croisée ou un seul ensemble d'entraînement/de test pour évaluer des métriques de performance telles que la précision, le rappel et le score F1.
- Optimisation du modèle: Utilisez la recherche par grille (
GridSearchCV) ou la recherche aléatoire (RandomizedSearchCV) pour effectuer une optimisation des hyperparamètres sur le modèle, améliorant les performances du modèle.
Caractéristiques de Sklearn
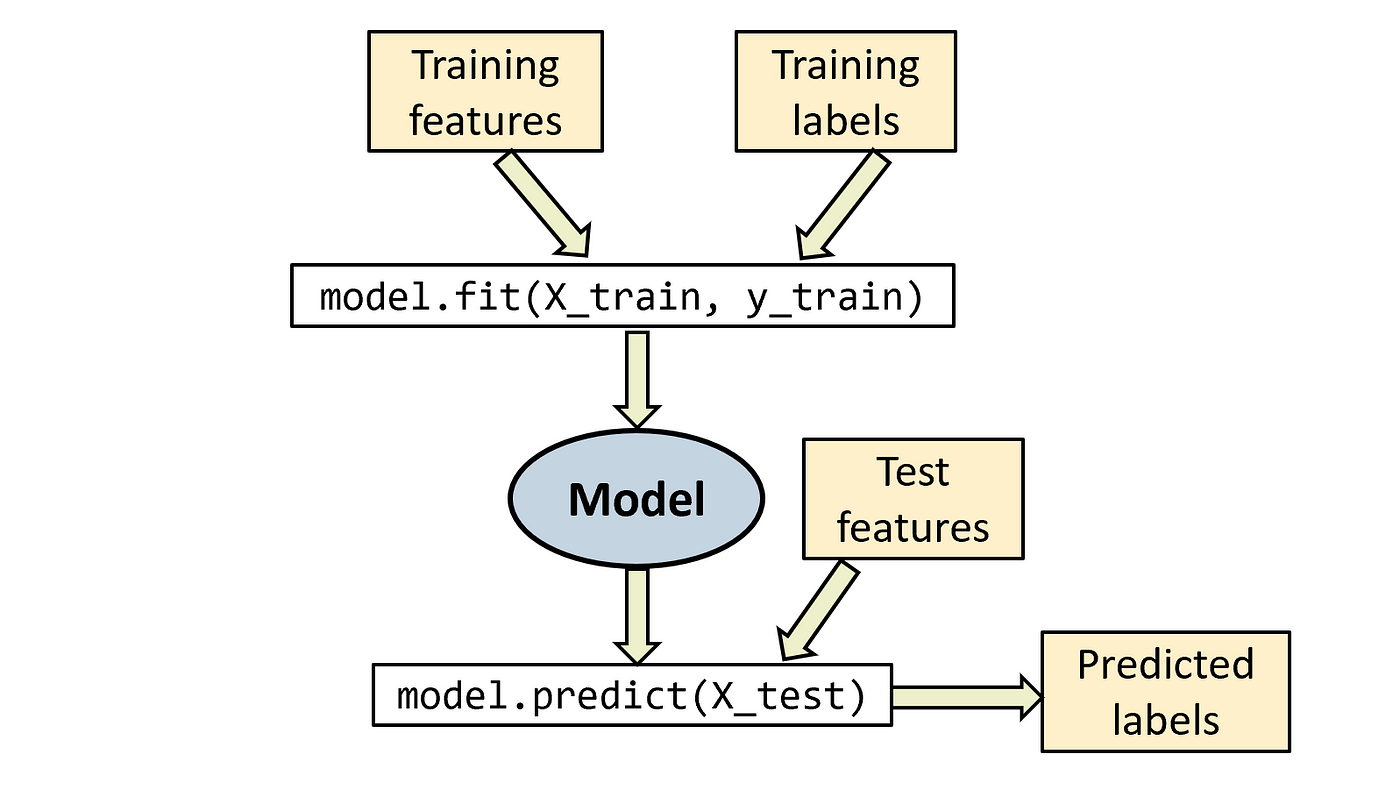
- Facilité d'utilisation: La conception de l'API de Sklearn est concise et cohérente, ce qui rend la courbe d'apprentissage relativement douce. Grâce à de simples
fit、predict、scoreméthodes telles que ..., vous pouvez rapidement mettre en œuvre des tâches d'apprentissage automatique. - Efficacité: Bien que Sklearn soit écrit en Python pur, la plupart de ses implémentations sous-jacentes reposent sur Cython et NumPy, ce qui le rend très rapide lors de l'exécution d'algorithmes d'apprentissage automatique.
- Fonctionnalités riches: Sklearn fournit un grand nombre d'algorithmes classiques d'apprentissage automatique, notamment :
- Algorithmes de classification: tels que la régression logistique, la machine à vecteurs de support (SVM), les K plus proches voisins (KNN), la forêt aléatoire, etc.
- Algorithmes de régression: tels que la régression linéaire, la régression ridge, la régression Lasso, etc.
- Algorithmes de clustering: tels que K-means, la classification hiérarchique, DBSCAN, etc.
- Algorithmes de réduction de dimensionnalité: tels que l'analyse en composantes principales (PCA), t-SNE, etc.
- Sélection et évaluation de modèles: validation croisée, recherche en grille, métriques d'évaluation de modèle, etc.
- Bonne compatibilité: Sklearn est bien compatible avec les bibliothèques de traitement de données Python telles que NumPy, SciPy et Pandas, et prend en charge plusieurs formats de données (tels que les tableaux NumPy et les DataFrames Pandas) pour l'entrée et la sortie.
Tâches d'apprentissage automatique prises en charge par Sklearn
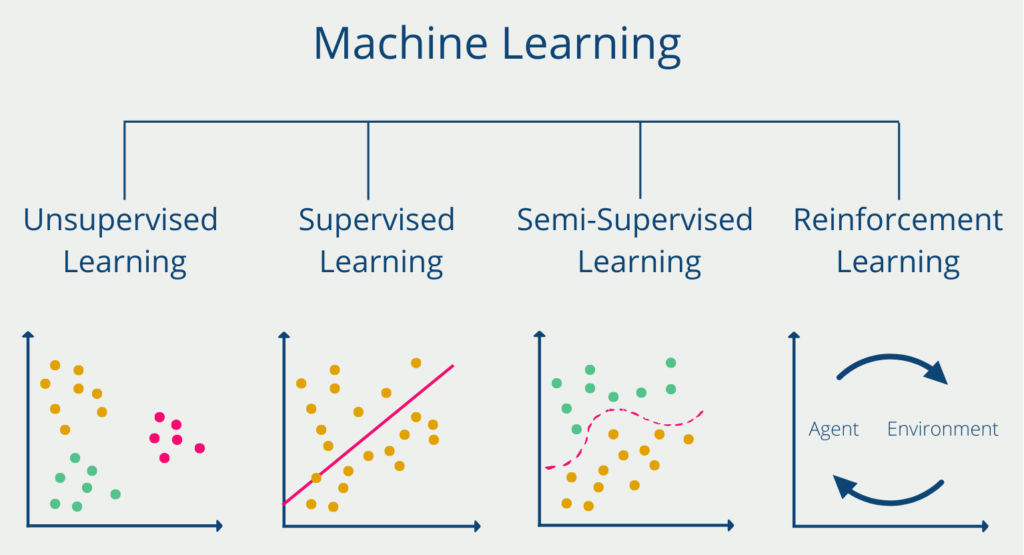
Sklearn fournit un ensemble riche d'outils et prend en charge les types suivants de tâches d'apprentissage automatique :
- Apprentissage supervisé:
- Problèmes de classification: Prédire la catégorie des données (par exemple, classification de spams, classification d'images, prédiction de maladies, etc.).
- Problèmes de régression: Prédire des valeurs continues (par exemple, prédiction du prix des maisons, prédiction du cours des actions, etc.).
- Apprentissage non supervisé:
- Problèmes de clustering: Regrouper les données en différents clusters (par exemple, segmentation de la clientèle, clustering de documents, etc.).
- Problèmes de réduction de dimensionnalité: Projeter des données de grande dimension dans un espace de faible dimension pour faciliter la visualisation ou réduire la complexité de calcul (par exemple, PCA, t-SNE).
- Apprentissage semi-supervisé: Certaines données sont étiquetées, d'autres ne le sont pas, et le modèle tente d'extraire des informations de ces données.
- Apprentissage par renforcement: Bien que Sklearn se concentre principalement sur l'apprentissage supervisé et non supervisé, il dispose également de certains outils associés qui peuvent être utilisés pour traiter des problèmes d'apprentissage par renforcement.
Modules et classes courants dans Sklearn
- Classification
sklearn.linear_model.LogisticRegression: Régression logistiquesklearn.svm.SVC: Classification par machine à vecteurs de supportsklearn.neighbors.KNeighborsClassifier: Classification par k plus proches voisinssklearn.ensemble.RandomForestClassifier: Classification par forêt aléatoire
- Régression
sklearn.linear_model.LinearRegression: Régression linéairesklearn.linear_model.Ridge: Régression ridgesklearn.ensemble.RandomForestRegressor: Régression par forêt aléatoire
- Clustering
sklearn.cluster.KMeans: Regroupement K-meanssklearn.cluster.DBSCAN: Regroupement spatial basé sur la densité
- Réduction de dimensionnalité
sklearn.decomposition.PCA: Analyse en composantes principales (ACP)sklearn.decomposition.NMF: Factorisation matricielle non négative
- Sélection du modèle
sklearn.model_selection.train_test_split: Diviser le jeu de données en ensembles d'entraînement et de testsklearn.model_selection.GridSearchCV: Recherche par grille pour trouver les meilleurs hyperparamètres
- Prétraitement des données
sklearn.preprocessing.StandardScaler: Standardisationsklearn.preprocessing.MinMaxScaler: Standardisation min-maxsklearn.preprocessing.OneHotEncoder: Encodage one-hot
Termes courants expliqués
- Fit: Fait référence à l'application du modèle aux données d'entraînement et à l'ajustement des paramètres du modèle via l'entraînement.
model.fit(X_train, y_train) - Predict: Prédire des données inconnues à partir du modèle entraîné.
model.predict(X_test) - Évaluation (Score): Évaluer les performances du modèle, en renvoyant généralement une métrique de score telle que l'exactitude.
model.score(X_test, y_test) - Validation croisée: Diviser le jeu de données en plusieurs sous-ensembles, puis évaluer la stabilité et la capacité de généralisation du modèle au moyen de plusieurs cycles d'entraînement et de validation.
Relation entre Sklearn et les autres bibliothèques
- Relation avec NumPy et SciPy: Sklearn est construit au-dessus de NumPy et SciPy, ce qui lui permet de gérer efficacement les calculs numériques et les opérations sur les tableaux.
- Relation avec Pandas: Pandas offre de puissantes capacités de traitement des données, tandis que Sklearn permet d'extraire directement des données depuis des DataFrames Pandas pour l'entraînement et la prédiction du modèle.
- Relation avec TensorFlow et PyTorch: Sklearn se concentre principalement sur les méthodes traditionnelles d'apprentissage automatique, tandis que TensorFlow et PyTorch se concentrent davantage sur les modèles d'apprentissage profond. Néanmoins, Sklearn peut être utilisé en combinaison avec ces bibliothèques pour traiter certaines tâches préliminaires d'ingénierie des caractéristiques, ou pour servir de modèles de référence à des fins de comparaison avec l'apprentissage profond.