Sklearn-Machine-Learning-Modelle
Modelle für maschinelles Lernen sind zentrale Werkzeuge für automatisierte Datenanalyse, Mustererkennung und Vorhersage.
Je nach Aufgabentyp lassen sich Modelle für maschinelles Lernen allgemein unterteilen in:
- Klassifikationsmodelle:Diskrete Kategorien vorhersagen
- Regressionsmodelle:Kontinuierliche Werte vorhersagen
- Clustering-Modelle:Daten automatisch gruppieren
Dieses Kapitel stellt diese gängigen Machine-Learning-Modelle ausführlich vor und erklärt, wie man sie bewertet und optimiert.
1. Klassifikationsmodelle
Die Klassifikation ist eines der häufigsten Probleme des maschinellen Lernens; das Ziel ist es, Eingabedaten diskreten Klassenlabels zuzuordnen.
Gängige Klassifikationsmodelle sind:
- Logistische Regression
- K-Nächste-Nachbarn (KNN)
- Support-Vektor-Maschine (SVM)
- Entscheidungsbaum
- Random Forest
Logistische Regression
Obwohl die logistische Regression „Regression“ im Namen trägt, ist sie im Wesentlichenein probabilistisches Klassifikationsmodell, das häufig für binäre Klassifikationsprobleme verwendet wird.
Ihre Kernidee ist:
- Zuerst wird eine lineare gewichtete Summe durchgeführt
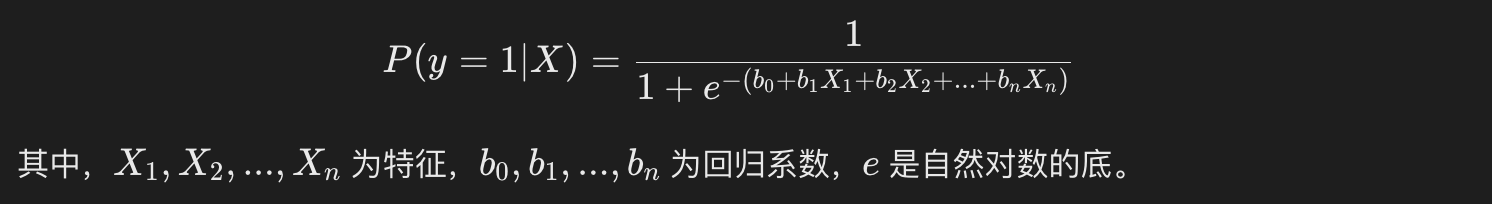
- Dann wird die Sigmoid-Funktion verwendet, um das Ergebnis als Wahrscheinlichkeit auf einen Wert zwischen 0 und 1 abzubilden
Es kann ausgedrückt werden als:
Die Kernformel der logistischen Regression lautet:
scikit-learn-Implementierung:
Beispiel
from sklearn.model_selection import train_test_split
# Angenommen, X ist die Merkmalsmatrix, y ist das Label
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.3, random_state=42)
model = LogisticRegression()
model.fit(X_train, y_train)
# Vorhersagen
y_pred = model.predict(X_test)
K-Nächste-Nachbarn (KNN)
K-Nearest Neighbors (KNN) ist eine instanzbasierte Lernmethode. Bei der Vorhersage berechnet es die Distanzen zwischen der vorherzusagenden Probe und allen Proben im Trainingsdatensatz, wählt die K nächsten Nachbarn aus und trifft anhand der Labels dieser Nachbarn Vorhersagen.
Hauptparameter:
- K: Anzahl der auszuwählenden Nachbarn.
- Distanzmetrik: Üblicherweise wird die euklidische Distanz verwendet; Manhattan-Distanz, Minkowski-Distanz usw. können ebenfalls verwendet werden.
scikit-learn-Implementierung:
Beispiel
from sklearn.model_selection import train_test_split
# Angenommen, X ist die Merkmalsmatrix, y ist das Label
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.3, random_state=42)
model = KNeighborsClassifier(n_neighbors=3)
model.fit(X_train, y_train)
# Vorhersagen
y_pred = model.predict(X_test)
Support-Vektor-Maschine (SVM)
Support Vector Machine ist ein leistungsstarkes Klassifikationsmodell, besonders geeignet für hochdimensionale Daten.
Die Grundidee von SVM besteht darin, eine Hyperebene zu finden, die den Rand zwischen Probenpunkten verschiedener Klassen maximiert. Für nichtlinear trennbare Daten verwendet SVM den Kernel-Trick, um die Daten in einen höherdimensionalen Raum abzubilden und eine trennende Hyperebene zu finden.
Kernelfunktionen:
- Linearer Kernel: Geeignet für linear trennbare Daten.
- Gaußscher Radial-Basis-Funktions-Kernel (RBF): Geeignet für nichtlineare Daten.
- Polynomialer Kernel: Geeignet für Daten mit polynomialen Beziehungen.
scikit-learn-Implementierung:
Beispiel
from sklearn.model_selection import train_test_split
# Angenommen, X ist die Merkmalsmatrix, y ist das Label
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.3, random_state=42)
model = SVC(kernel='linear') # Linearen Kernel verwenden
model.fit(X_train, y_train)
# Vorhersagen
y_pred = model.predict(X_test)
Entscheidungsbaum & Random Forest
Der Entscheidungsbaum ist ein baumstrukturiertes Klassifikationsmodell, das Daten aufteilt und sie letztlich in verschiedene Klassen einteilt. Random Forest hingegen erstellt mehrere Entscheidungsbäume und bestimmt die endgültige Vorhersage durch Abstimmung oder Mittelwertbildung.
EntscheidungsbaumEr teilt Daten auf, indem er optimale Merkmale auswählt. Die Auswahlkriterien sind üblicherweiseInformationsgewinnoderGini-Koeffizient。
Random ForestEr reduziert Overfitting und verbessert die Modellgenauigkeit durch das Ensemble mehrerer Entscheidungsbäume. Er erhöht die Modellvielfalt, indem er Zufälligkeit einführt (z. B. zufällige Auswahl von Merkmalen, zufällige Auswahl von Datenuntermengen).
scikit-learn-Implementierung:
Beispiel
from sklearn.ensemble import RandomForestClassifier
from sklearn.model_selection import train_test_split
# Angenommen, X ist die Merkmalsmatrix, y ist das Label
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.3, random_state=42)
# Entscheidungsbaum
dt_model = DecisionTreeClassifier()
dt_model.fit(X_train, y_train)
# Random Forest
rf_model = RandomForestClassifier(n_estimators=100)
rf_model.fit(X_train, y_train)
# Vorhersagen
dt_pred = dt_model.predict(X_test)
rf_pred = rf_model.predict(X_test)
2. Regressionsmodelle
Das Ziel von Regressionsproblemen ist die Vorhersage einer kontinuierlichen Ausgabevariable. Zu den gängigen Regressionsmodellen gehören Lineare Regression, Ridge-Regression und Lasso-Regression.
Lineare Regression
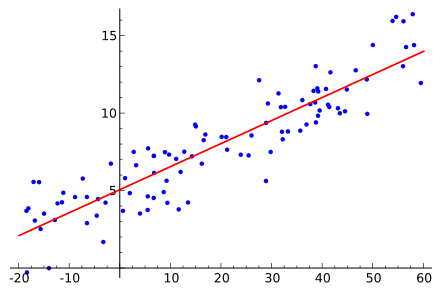
Die lineare Regression sagt die Zielvariable voraus, indem sie eine Gerade anpasst. Ihre Kernannahme ist, dass eine lineare Beziehung zwischen den Merkmalen und der Zielvariablen besteht.
Für ein einfaches lineares Regressionsproblem kann das Modell ausgedrückt werden als:
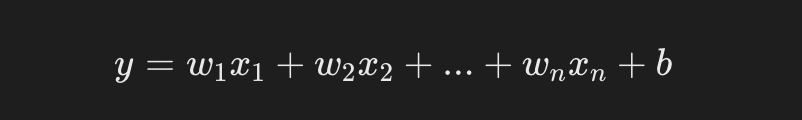
- y ist der vorhergesagte Wert (Zielwert).
- x1,x2,xnist das Eingabemerkmal.
- w1,w2,wnsind die zu lernenden Gewichte (Modellparameter).
- b ist der Bias-Term.
scikit-learn-Implementierung:
Beispiel
from sklearn.model_selection import train_test_split
# Angenommen, X ist die Merkmalsmatrix, y ist die Zielvariable
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.3, random_state=42)
model = LinearRegression()
model.fit(X_train, y_train)
# Vorhersagen
y_pred = model.predict(X_test)
Ridge-Regression
Ridge-Regression ist eine Variante der linearen Regression, dieL2-Regularisierungverwendet, um die Komplexität des Modells zu begrenzen und Overfitting zu vermeiden.
Durch die Bestrafung der Größe der Regressionskoeffizienten kann die Ridge-Regression Multikollinearitätsprobleme besser bewältigen.
Beispiel
model = Ridge(alpha=1.0) Beispiel
model.fit(X_train, y_train)
# alpha ist der Regularisierungsparameter
y_pred = model.predict(X_test)
Lasso-Regression
Lasso-RegressionLasso-Regression ist auch eine Form der linearen Regression; sie verwendetL1-Regularisierung
um die Regressionskoeffizienten zu bestrafen.
Beispiel
model = Lasso(alpha=0.1) scikit-learn-Implementierung:
model.fit(X_train, y_train)
Beispiel
y_pred = model.predict(X_test)
3. Clustering-Modelle
# Vorhersagen
K-Means
Clustering ist eine Methode des unüberwachten Lernens, deren Ziel es ist, Objekte in einem Datensatz in verschiedene Gruppen (oder Cluster) aufzuteilen, sodass Objekte innerhalb desselben Clusters so ähnlich wie möglich und Objekte in verschiedenen Clustern so unterschiedlich wie möglich sind.
K-Means
Beispiel
scikit-learn-Implementierung:
model = KMeans(n_clusters=3)
model.fit(X)
Beispiel
labels = model.predict(X)
DBSCAN (dichtebasiertes Clustering)
# Cluster-Labels abrufen
DBSCAN (dichtebasiertes Clustering)
Beispiel
scikit-learn-Implementierung:
model = DBSCAN(eps=0.5, min_samples=5)
model.fit(X)
# Cluster-Labels abrufen
labels = model.labels_
Hierarchisches Clustering
Hierarchisches Clustering ist eine Methode des Clusterings, bei der Cluster rekursiv zusammengeführt oder aufgeteilt werden. Häufig verwendete Methoden des hierarchischen Clusterings sindagglomeratives Clustering(Agglomerative) unddivisives Clustering(Divisive)。
scikit-learn-Implementierung:
Beispiel
# Angenommen, X ist die Merkmalsmatrix
model = AgglomerativeClustering(n_clusters=3)
labels = model.fit_predict(X)
4. Modellbewertung und -auswahl
Beim maschinellen Lernen ist nach Abschluss des Modelltrainings die Generalisierungsfähigkeit des Modells durch geeignete Bewertungsmethoden zu bewerten und das Modell mit der besten Leistung auszuwählen.
Gängige Evaluierungsmethoden umfassen:
- Bewertung von Klassifikationsmetriken
- Kreuzvalidierung
- Hyperparameter-Tuning
Metriken zur Bewertung der Klassifikation
Zu den häufig verwendeten Bewertungsmetriken bei Klassifikationsproblemen gehören:
- Genauigkeit
- Precision
- Trefferquote
- F1-Score
Sie spiegeln die Modellleistung aus verschiedenen Perspektiven wider.
Erklärung der Bedeutung jeder Metrik:
Genauigkeit-- Der Anteil korrekt vorhergesagter Beispiele an allen Beispielen: geeignet für Fälle mit relativ ausgewogener Klassenverteilung
-
Präzision-- Unter den als positiv vorhergesagten Beispielen der Anteil derjenigen, die tatsächlich positiv sind: legt den Schwerpunkt darauf, "ob die positive Vorhersage zuverlässig ist"
-
Trefferquote-- Von allen tatsächlich positiven Beispielen der Anteil, der vom Modell korrekt erkannt wurde: legt den Schwerpunkt darauf, "ob positive Beispiele übersehen werden"
F1-Score
Das harmonische Mittel von Präzision und Recall:
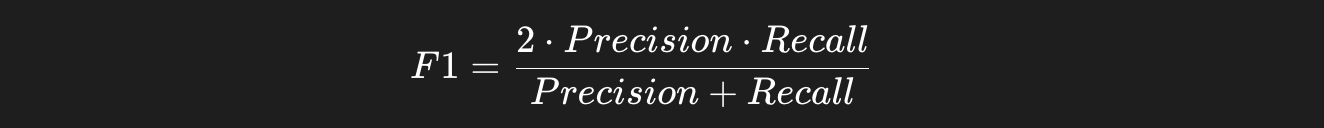
Wird verwendet, um ein Gleichgewicht zwischen Präzision und Recall zu erreichen.
scikit-learn-Implementierung:
Beispiel
accuracy = accuracy_score(y_test, y_pred)
precision = precision_score(y_test, y_pred)
recall = recall_score(y_test, y_pred)
f1 = f1_score(y_test, y_pred)
print(f"Genauigkeit: {accuracy}")
print(f"Präzision: {precision}")
print(f"Recall: {recall}")
print(f"F1-Score: {f1}")
Hold-out-Evaluierung (Aufteilung in Trainings-/Testsatz)
Die gebräuchlichste und intuitivste Evaluierungsmethode besteht darin, den Datensatz aufzuteilen in:
- Trainingsset: wird für das Lernen des Modells verwendet
- Testset: wird zur Leistungsbewertung verwendet
Diese Methode ist einfach und effizient und eignet sich, um die Modellleistung in der Einführungsphase zu verstehen.
Kreuzvalidierung
Die Kreuzvalidierung teilt den Datensatz mehrfach für Training und Test auf und erhält dadurch stabilere und zuverlässigere Ergebnisse bei der Bewertung der Modellleistung.
Eine übliche Vorgehensweise istdie K-fache Kreuzvalidierung:
- Der Datensatz wird in K Folds unterteilt
- Jedes Mal wird ein Fold als Validierungsset verwendet
- Der Rest als Trainingsset
- K-mal wiederholen und das durchschnittliche Ergebnis nehmen
Beispiel
from sklearn.linear_model import LogisticRegression
model = LogisticRegression()
scores = cross_val_score(model, X, y, cv=5)
print("Kreuzvalidierungs-Scores:", scores)
print("Mittlerer Score:", scores.mean())
In realen Projekten wird üblicherweise entweder die Holdout-Methode oder die Kreuzvalidierung verwendet; es ist nicht nötig, beide gleichzeitig zu mischen.
Grid-Search-Tuning (GridSearchCV)
Die Modellleistung wird oft erheblich durch Hyperparameter-Einstellungen beeinflusst.
Grid Search findet automatisch die optimale Konfiguration, indem Parameterkombinationen durchlaufen werden.
In Kombination mit der Kreuzvalidierung werden die Ergebnisse des Hyperparameter-Tunings robuster.
Beispiel
from sklearn.svm import SVC
parameters = {
'kernel': ['linear', 'rbf'],
'C': [1, 10, 100]
}
model = SVC()
grid_search = GridSearchCV(
model,
parameters,
cv=5
)
grid_search.fit(X, y)
print("Beste Parameter:", grid_search.best_params_)
print("Bester Score:", grid_search.best_score_)