Sklearn-Anwendungsbeispiele
Der Iris-Datensatz ist einer der klassischsten Einführungsdatensätze im maschinellen Lernen.
Der Iris-Datensatz enthält drei Iris-Arten (Setosa, Versicolor, Virginica) und 4 Merkmale für jede Blume: Kelchblattlänge, Kelchblattbreite, Blütenblattlänge und Blütenblattbreite.
Als Nächstes besteht unsere Aufgabe darin, die Iris-Art anhand dieser Merkmale vorherzusagen.
Das Fallbeispiel in diesem Kapitel behandelt Schritte wie Datenladen, Visualisierung, Merkmalsauswahl, Datenvorverarbeitung, Erstellen eines Klassifikationsmodells, Modellbewertung und Optimierung.
1. Datenladen und Visualisierung
Datenladen
Laden Sie zuerst den Iris-Datensatz. scikit-learn bietet eine Schnittstelle, um den Iris-Datensatz direkt zu laden.
Beispiel
import pandas as pd
# Laden des Iris-Datensatzes
data = load_iris()
# In DataFrame konvertieren zur einfachen Ansicht
df = pd.DataFrame(data.data, columns=data.feature_names)
df['target'] = data.target
df['species'] = df['target'].apply(lambda x: data.target_names[x])
# Die ersten Zeilen der Daten anzeigen
print(df.head())
Ausgabe:
   sepal length (cm)  sepal width (cm)  petal length (cm)  petal width (cm)  target species
0                 5.1               3.5                1.4               0.2       0   setosa
1                 4.9               3.0                1.4               0.2       0   setosa
2                 4.7               3.2                1.3               0.2       0   setosa
3                 4.6               3.1                1.5               0.2       0   setosa
4                 5.0               3.6                1.4               0.2       0   setosa
An diesem Punkt wurden die Daten erfolgreich geladen, und wir können die Merkmale und die entsprechenden Blumenarten für jeden Datensatz sehen.
Datenvisualisierung
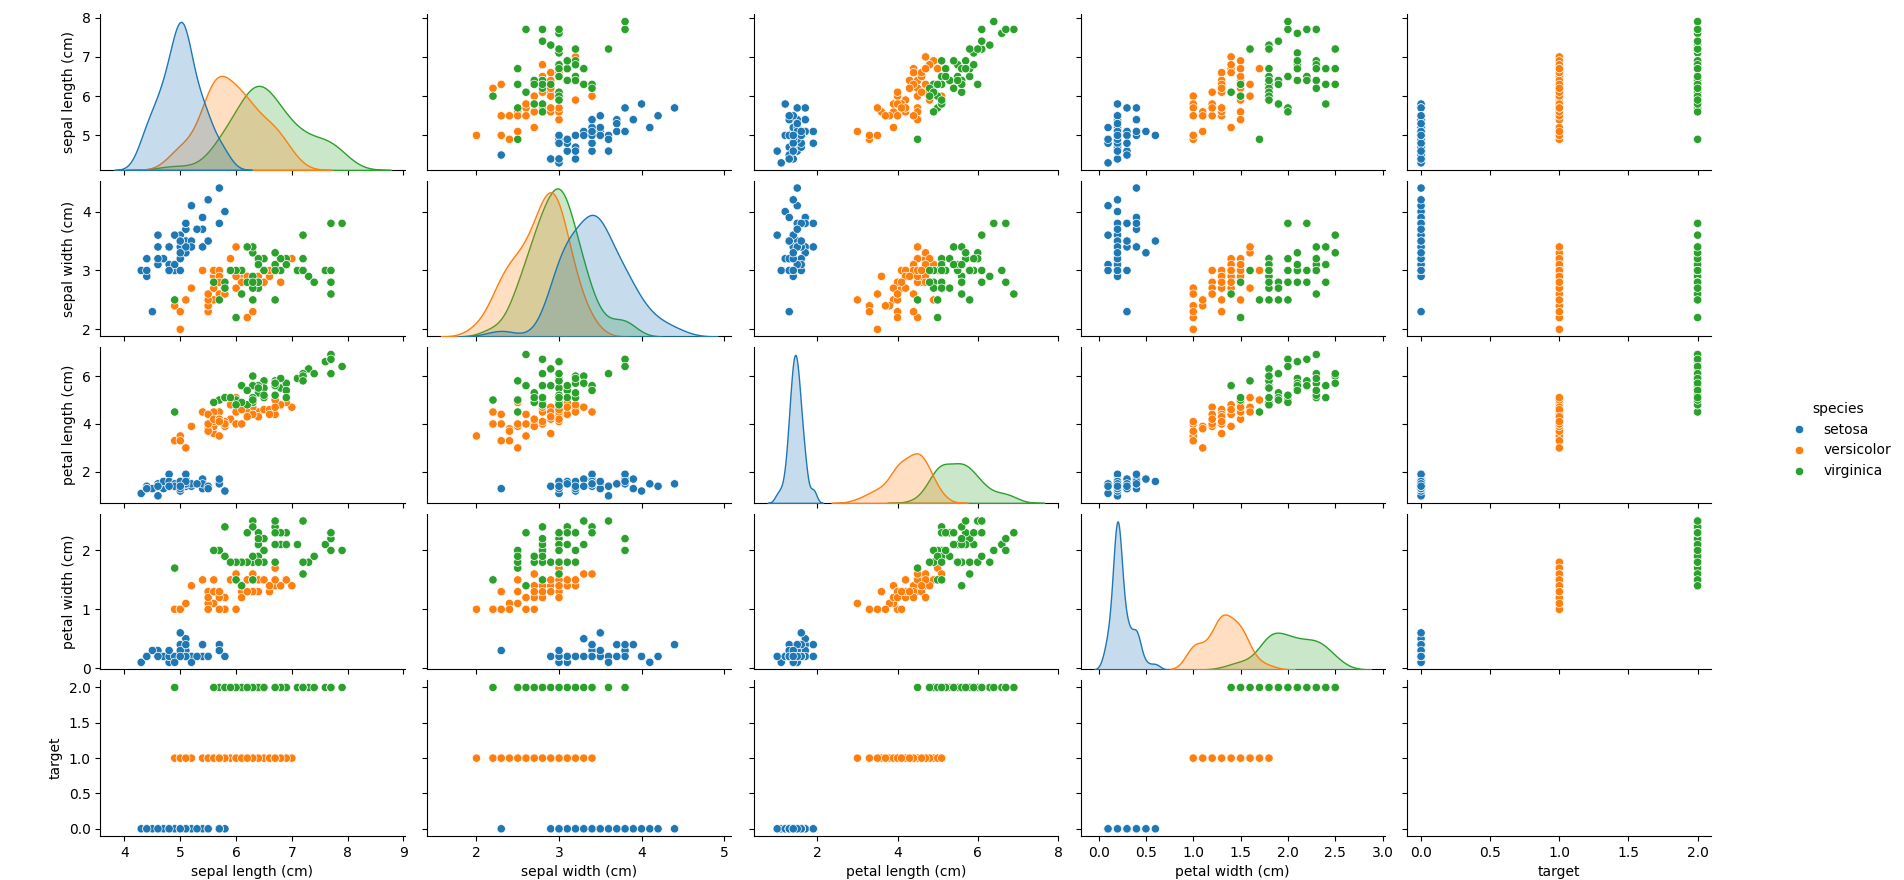
Um die Daten besser zu verstehen, können wir die Beziehungen zwischen verschiedenen Merkmalen visualisieren. Dazu können wir die Bibliotheken matplotlib und seaborn zur Visualisierung verwenden.
Beispiel
import pandas as pd
import seaborn as sns
import matplotlib.pyplot as plt
# Laden des Iris-Datensatzes
data = load_iris()
# In DataFrame konvertieren zur einfachen Ansicht
df = pd.DataFrame(data.data, columns=data.feature_names)
df['target'] = data.target
df['species'] = df['target'].apply(lambda x: data.target_names[x])
# Beziehungen zwischen Merkmalen darstellen
sns.pairplot(df, hue="species")
plt.show()
pairplot zeichnet eine Streudiagramm-Matrix zwischen Merkmalen und verwendet verschiedene Farben, um verschiedene Irisarten zu kennzeichnen. Dies hilft uns, die Verteilung jedes Merkmals und die Beziehungen zwischen ihnen zu verstehen.
Die angezeigte Abbildung sieht wie folgt aus:
Heatmap zur Visualisierung von Korrelationen zwischen Merkmalen
Mithilfe der Heatmap können wir die Korrelationen zwischen den Merkmalen betrachten. Stärkere Korrelationen können uns helfen, bei der Modellierung bessere Entscheidungen zu treffen.
Beispiel
import pandas as pd
import seaborn as sns
import matplotlib.pyplot as plt
# Laden des Iris-Datensatzes
data = load_iris()
# In DataFrame konvertieren zur einfachen Ansicht
df = pd.DataFrame(data.data, columns=data.feature_names)
df['target'] = data.target
df['species'] = df['target'].apply(lambda x: data.target_names[x])
# Beziehungen zwischen Merkmalen darstellen
correlation_matrix = df.drop(columns=['target', 'species']).corr()
sns.heatmap(correlation_matrix, annot=True, cmap="coolwarm", fmt=".2f")
plt.title("Korrelations-Heatmap")
plt.show()
Die angezeigte Abbildung sieht wie folgt aus:

2. Merkmalsauswahl und Datenvorverarbeitung
Datenvorverarbeitung
Beim maschinellen Lernen ist die Datenvorverarbeitung ein sehr wichtiger Schritt.
Für den Iris-Datensatz sind die Merkmalswerte bereits numerisch, daher ist nicht viel Vorverarbeitung erforderlich. Wir können die Daten jedoch standardisieren, um den Effekt des Modelltrainings zu verbessern.
Beispiel
# Merkmale und Labels extrahieren
X = df.drop(columns=['target', 'species'])
y = df['target']
# Merkmale standardisieren
scaler = StandardScaler()
X_scaled = scaler.fit_transform(X)
Der Zweck der Standardisierung besteht darin, jedes Merkmal auf einen Mittelwert von 0 und eine Varianz von 1 zu bringen, was für einige distanzbasierte Modelle wie KNN und SVM sehr wichtig ist.
Merkmalsauswahl
Obwohl die Merkmale des Iris-Datensatzes relativ einfach sind, müssen wir in realen Problemen manchmal die Merkmalsdimensionen durch Merkmalsauswahl reduzieren, um die Modellleistung zu verbessern.
Wir können Methoden wie SelectKBest oder Recursive Feature Elimination (RFE) verwenden.
Verwenden Sie beispielsweise SelectKBest, um die 2 Merkmale auszuwählen, die für die Labels am relevantesten sind:
Beispiel
# Chi-Quadrat-Test verwenden, um die 2 relevantesten Merkmale auszuwählen
selector = SelectKBest(f_classif, k=2)
X_new = selector.fit_transform(X_scaled, y)
# Die ausgewählten Merkmale ausgeben
selected_features = selector.get_support(indices=True)
print("Ausgewählte Merkmale:", X.columns[selected_features])
Dies wählt die 2 Merkmale mit der höchsten Korrelation zu den Ziel-Labels aus.
3. Ein Klassifikationsmodell erstellen: Entscheidungsbaum oder SVM zur Klassifikation verwenden
Verwendung des Entscheidungsbaum-Klassifikators
Wir werden zunächst versuchen, ein Entscheidungsbaum-Modell für die Klassifikation zu verwenden.
Beispiel
from sklearn.tree import DecisionTreeClassifier
from sklearn.metrics import accuracy_score
# Aufteilen des Datensatzes
X_train, X_test, y_train, y_test = train_test_split(X_scaled, y, test_size=0.2, random_state=42)
# Initialisieren des Entscheidungsbaum-Klassifikators
model_dt = DecisionTreeClassifier(random_state=42)
# Modell trainieren
model_dt.fit(X_train, y_train)
# Vorhersagen
y_pred_dt = model_dt.predict(X_test)
# Modell bewerten
accuracy_dt = accuracy_score(y_test, y_pred_dt)
print(f"Genauigkeit des Entscheidungsbaums: {accuracy_dt:.4f}")
Klassifikation mit Support Vector Machine (SVM)
Als Nächstes können wir die Support Vector Machine (SVM) für die Klassifikation ausprobieren.
Beispiel
# SVM-Klassifikator initialisieren
model_svm = SVC(kernel='linear', random_state=42)
# Modell trainieren
model_svm.fit(X_train, y_train)
# Vorhersagen
y_pred_svm = model_svm.predict(X_test)
# Modell bewerten
accuracy_svm = accuracy_score(y_test, y_pred_svm)
print(f"SVM-Genauigkeit: {accuracy_svm:.4f}")
4. Modell bewerten und optimieren
Modellbewertung
Zusätzlich zur Genauigkeit können wir auch andere Evaluationsmetriken wie Konfusionsmatrix, Präzision, Recall und F1-Score verwenden.
Beispiel
# Konfusionsmatrix
cm = confusion_matrix(y_test, y_pred_dt)
print("Konfusionsmatrix (Entscheidungsbaum):")
print(cm)
# Präzision, Recall, F1-Score
report = classification_report(y_test, y_pred_dt)
print("Klassifikationsbericht (Entscheidungsbaum):")
print(report)
Rastersuche-Tuning
Um das Modell zu optimieren, können wir die Rastersuche (GridSearchCV) verwenden, um die Modellhyperparameter abzustimmen und die beste Parameterkombination zu finden.
Beispiel
# Parameterraster für den Entscheidungsbaum definieren
param_grid = {
'max_depth': [3, 5, 10, None],
'min_samples_split': [2, 5, 10],
'min_samples_leaf': [1, 2, 4]
}
# GridSearchCV initialisieren
grid_search = GridSearchCV(estimator=DecisionTreeClassifier(random_state=42), param_grid=param_grid, cv=5)
# Rastersuche trainieren
grid_search.fit(X_train, y_train)
# Beste Parameter und bestes Modell abrufen
print("Beste Parameter:", grid_search.best_params_)
best_model = grid_search.best_estimator_
# Vorhersagen und bewerten
y_pred_optimized = best_model.predict(X_test)
accuracy_optimized = accuracy_score(y_test, y_pred_optimized)
print(f"Genauigkeit des optimierten Entscheidungsbaums: {accuracy_optimized:.4f}")
Durch die Rastersuche können wir die Parameter des Entscheidungsbaums finden, die am besten zu den aktuellen Daten passen, und die Vorhersagegenauigkeit des Modells verbessern.
Kreuzvalidierung
Um die Stabilität des Modells weiter zu bewerten, können wir eine Kreuzvalidierung verwenden, um seine Leistung zu beurteilen.
Beispiel
# Führe eine 5-fache Kreuzvalidierung durch
cross_val_scores = cross_val_score(best_model, X_scaled, y, cv=5)
print(f"Kreuzvalidierungs-Scores: {cross_val_scores}")
print(f"Mittlere CV-Genauigkeit: {cross_val_scores.mean():.4f}")
Die Kreuzvalidierung hilft uns, die Leistung des Modells auf verschiedenen Daten-Teilmengen zu bewerten und Overfitting zu vermeiden.
5. Vollständiger Code
Das Folgende ist ein vollständiges Codebeispiel, das Schritte wie das Laden des Iris-Datensatzes, die Datenvorverarbeitung, die Merkmalsauswahl, den Aufbau von Klassifikationsmodellen, die Modellbewertung und die Optimierung abdeckt. Wir verwenden Entscheidungsbaum- und SVM-Klassifikatoren und optimieren die Hyperparameter des Modells durch Rastersuche.Beispiel
import numpy as np
import pandas as pd
import seaborn as sns
import matplotlib.pyplot as plt
from sklearn.datasets import load_iris
from sklearn.model_selection import train_test_split, GridSearchCV, cross_val_score
from sklearn.preprocessing import StandardScaler
from sklearn.tree import DecisionTreeClassifier
from sklearn.svm import SVC
from sklearn.metrics import accuracy_score, classification_report, confusion_matrix
# 1. Daten laden
# Laden des Iris-Datensatzes
data = load_iris()
# In DataFrame konvertieren zur einfachen Ansicht
df = pd.DataFrame(data.data, columns=data.feature_names)
df['target'] = data.target
df['species'] = df['target'].apply(lambda x: data.target_names[x])
# Die ersten Zeilen der Daten anzeigen
print("Datenvorschau:")
print(df.head())
# 2. Datenvisualisierung
# Beziehungen zwischen Merkmalen darstellen
sns.pairplot(df, hue="species")
plt.show()
# Erstelle eine Heatmap, um Korrelationen zwischen Merkmalen anzuzeigen
correlation_matrix = df.drop(columns=['target', 'species']).corr()
sns.heatmap(correlation_matrix, annot=True, cmap="coolwarm", fmt=".2f")
plt.title("Korrelations-Heatmap")
plt.show()
# 3. Merkmalsauswahl und Datenvorverarbeitung
# Merkmale und Labels extrahieren
X = df.drop(columns=['target', 'species'])
y = df['target']
⟦⟧# Daten standardisieren
scaler = StandardScaler()
X_scaled = scaler.fit_transform(X)
# 4. Klassifikationsmodelle erstellen
# Aufteilen des Datensatzes
X_train, X_test, y_train, y_test = train_test_split(X_scaled, y, test_size=0.2, random_state=42)
# Entscheidungsbaum-Klassifikator verwenden
model_dt = DecisionTreeClassifier(random_state=42)
model_dt.fit(X_train, y_train)
# Vorhersagen
y_pred_dt = model_dt.predict(X_test)
# Genauigkeit des Entscheidungsbaums ausgeben
accuracy_dt = accuracy_score(y_test, y_pred_dt)
print(f"Genauigkeit des Entscheidungsbaums: {accuracy_dt:.4f}")
# Support Vector Machine (SVM)-Klassifikator verwenden
model_svm = SVC(kernel='linear', random_state=42)
model_svm.fit(X_train, y_train)
# Vorhersagen
y_pred_svm = model_svm.predict(X_test)
# Genauigkeit von SVM ausgeben
accuracy_svm = accuracy_score(y_test, y_pred_svm)
print(f"SVM-Genauigkeit: {accuracy_svm:.4f}")
# 5. Modellbewertung
# Bewertung des Entscheidungsbaum-Modells
print("\nKlassifikationsbericht des Entscheidungsbaums:")
print(classification_report(y_test, y_pred_dt))
print("\nKonfusionsmatrix des Entscheidungsbaums:")
print(confusion_matrix(y_test, y_pred_dt))
# SVM-Modellbewertung
print("\nSVM-Klassifikationsbericht:")
print(classification_report(y_test, y_pred_svm))
print("\nSVM-Konfusionsmatrix:")
print(confusion_matrix(y_test, y_pred_svm))
# 6. Grid-Suche-Tuning
# Parameterraster für den Entscheidungsbaum definieren
param_grid = {
'max_depth': [3, 5, 10, None],
'min_samples_split': [2, 5, 10],
'min_samples_leaf': [1, 2, 4]
}
# GridSearchCV initialisieren
grid_search = GridSearchCV(estimator=DecisionTreeClassifier(random_state=42), param_grid=param_grid, cv=5)
grid_search.fit(X_train, y_train)
# Beste Parameter und bestes Modell abrufen
print("\nBeste Parameter von GridSearchCV (Entscheidungsbaum):")
print(grid_search.best_params_)
# Verwende das beste Modell für die Vorhersage
best_model = grid_search.best_estimator_
y_pred_optimized = best_model.predict(X_test)
# Genauigkeit des optimierten Entscheidungsbaums ausgeben
accuracy_optimized = accuracy_score(y_test, y_pred_optimized)
print(f"Genauigkeit des optimierten Entscheidungsbaums: {accuracy_optimized:.4f}")
# 7. Kreuzvalidierung
# Führe eine 5-fache Kreuzvalidierung durch
cross_val_scores = cross_val_score(best_model, X_scaled, y, cv=5)
print("\nKreuzvalidierungs-Scores (Optimierter Entscheidungsbaum):")
print(cross_val_scores)
print(f"Mittlere CV-Genauigkeit: {cross_val_scores.mean():.4f}")
Code-Erklärung:
Datenladen:
- Verwenden Sie
load_iris()Lade den Iris-Datensatz und konvertiere die Daten inDataFrameFormat zur Ansicht und Analyse.
- Verwenden Sie
Datenvisualisierung:
- Verwenden Sie
seabornvonpairplotum die Streudiagrammmatrix zwischen Merkmalen zu zeichnen, und verwenden Sieheatmapum die Korrelations-Heatmap zwischen Merkmalen zu zeichnen.
- Verwenden Sie
Merkmalsauswahl und Datenvorverarbeitung:
- Merkmale extrahieren (
X) und Labels (y) und standardisieren Sie die Merkmalsdaten, sodass jedes Merkmal einen Mittelwert von 0 und eine Varianz von 1 hat.
- Merkmale extrahieren (
Klassifikationsmodell erstellen:
- Verwenden Sie
DecisionTreeClassifierundSVCTrainieren Sie jeweils einen Entscheidungsbaum-Klassifikator und einen Support-Vector-Machine-Klassifikator und bewerten Sie deren Genauigkeit auf dem Testset.
- Verwenden Sie
Modellbewertung:
- Verwenden Sie
classification_reportundconfusion_matrixDetaillierte Bewertungsmetriken des Modells ausgeben, einschließlich Präzision, Recall, F1-Score und Konfusionsmatrix.
- Verwenden Sie
Grid-Search-Tuning:
- Verwenden Sie
GridSearchCVFühren Sie eine Hyperparameter-Optimierung am Entscheidungsbaummodell durch, finden Sie die beste Hyperparameter-Kombination und geben Sie die Genauigkeit des optimierten Modells aus.
- Verwenden Sie
Kreuzvalidierung:
- Verwenden Sie
cross_val_scoreFühren Sie eine 5-fache Kreuzvalidierung durch, um die Stabilität und Leistung des optimierten Entscheidungsbaummodells zu bewerten.
- Verwenden Sie
Die Ausgabe sieht wie folgt aus:
数据预览:
   sepal length (cm)  sepal width (cm)  petal length (cm)  petal width (cm)  target species
0                 5.1               3.5                1.4               0.2       0   setosa
1                 4.9               3.0                1.4               0.2       0   setosa
2                 4.7               3.2                1.3               0.2       0   setosa
3                 4.6               3.1                1.5               0.2       0   setosa
4                 5.0               3.6                1.4               0.2       0   setosa

Decision Tree Accuracy: 1.0000
SVM Accuracy: 1.0000

Decision Tree Classification Report:
              precision    recall  f1-score   support

           0       1.00      1.00      1.00         9
           1       1.00      1.00      1.00         8
           2       1.00      1.00      1.00         8

    accuracy                           1.00        25
   macro avg       1.00      1.00      1.00        25
weighted avg       1.00      1.00      1.00        25

Decision Tree Confusion Matrix:
[[9 0 0]
 [0 8 0]
 [0 0 8]]

SVM Classification Report:
              precision    recall  f1-score   support

           0       1.00      1.00      1.00         9
           1       1.00      1.00      1.00         8
           2       1.00      1.00      1.00         8

    accuracy                           1.00        25
   macro avg       1.00      1.00      1.00        25
weighted avg       1.00      1.00      1.00        25

SVM Confusion Matrix:
[[9 0 0]
 [0 8 0]
 [0 0 8]]

Best Parameters from GridSearchCV (Decision Tree):
{'max_depth': 5, 'min_samples_leaf': 1, 'min_samples_split': 2}

Optimized Decision Tree Accuracy: 1.0000

Cross-validation Scores (Optimized Decision Tree):
[1.         1.         1.         1.         1.        ]
Mean CV Accuracy: 1.0000
Weitere Erweiterungen