Sklearn 入門
Sklearn、正式名称はSklearn、Python ベースのオープンソース機械学習ライブラリです。
Sklearn は、強力で使いやすい機械学習ライブラリであり、データ前処理からモデル評価までの一連のツールを提供します。
Sklearn は NumPy と SciPy の上に構築されているため、数値計算や配列操作を効率的に処理できます。
Sklearn は、分類、回帰、クラスタリング、次元削減などのさまざまな機械学習タスクに対応しています。
Sklearn は、その簡潔で一貫性のある API により、機械学習愛好家や専門家にとって必須のツールの一つとなっています。
Sklearn の仕組み
Sklearn では、機械学習のプロセスは一定のパターンに従います:データの読み込み、データの前処理、モデルのトレーニング、モデルの評価、モデルのチューニングです。
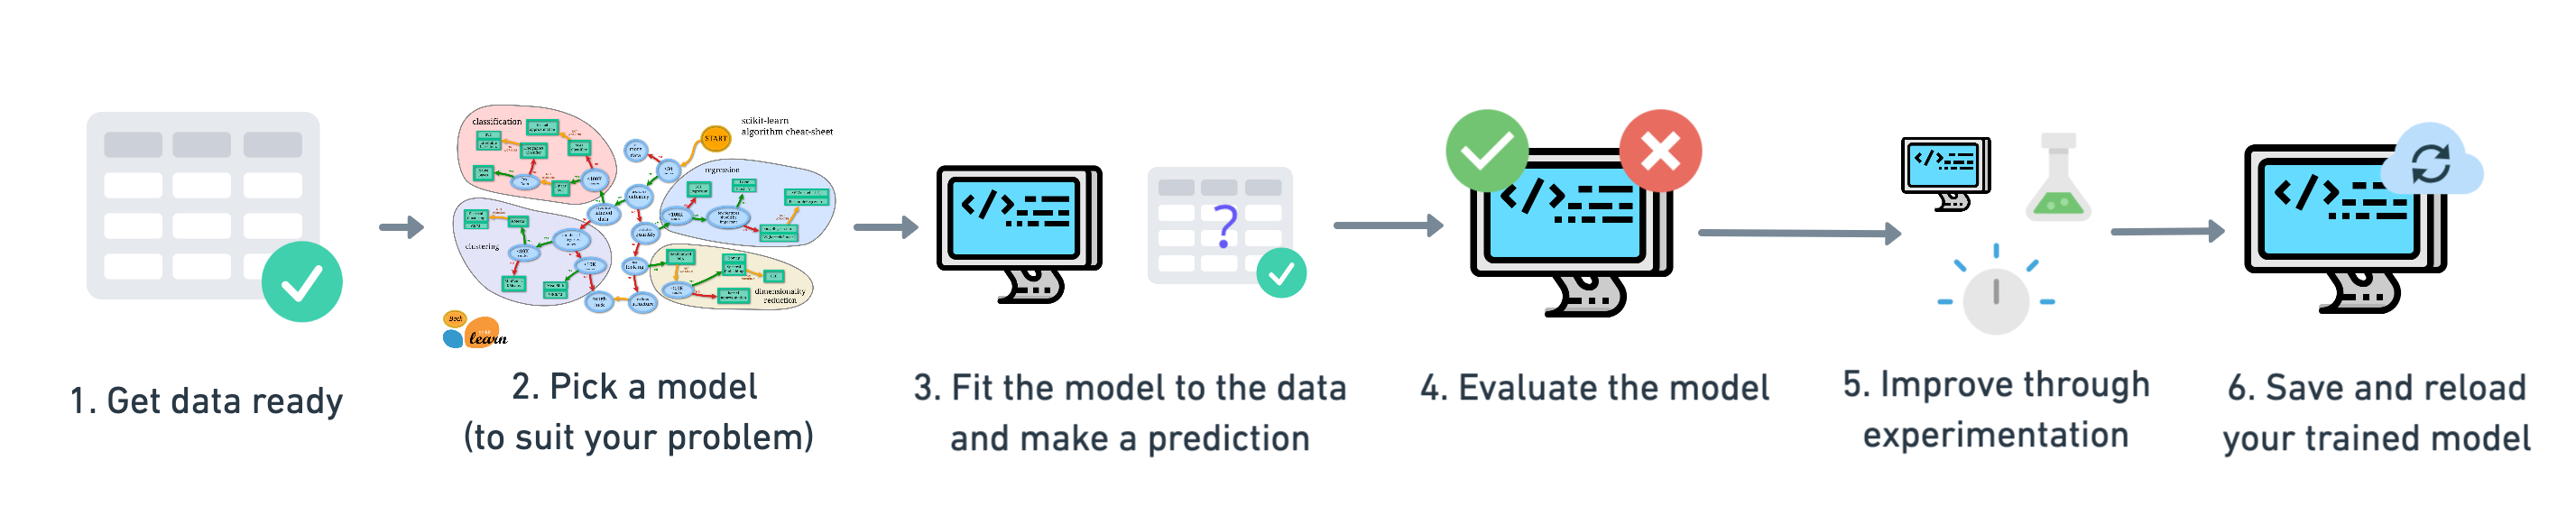
具体的なワークフローは次のとおりです:
- データの読み込み:Sklearn や他のライブラリを使用してデータセットを読み込みます。例えば、
datasets.load_iris()古典的なアヤメ(Iris)データセットを読み込んだり、またはtrain_test_split()を使用してデータを分割します。 - データの前処理:データの種類に応じて、標準化、ノイズ除去、欠損値の補完などの操作が必要になる場合があります。
- アルゴリズムの選択とモデルのトレーニング:適切なアルゴリズム(ロジスティック回帰、サポートベクターマシンなど)を選択し、
.fit()メソッドを使用してモデルをトレーニングします。 - モデルの評価:交差検証または単一のトレーニング/テストセットを使用して、モデルの正確性、再現率、F1スコアなどの性能指標を評価します。
- モデルの最適化:グリッドサーチ(
GridSearchCV)またはランダムサーチ(RandomizedSearchCV)を使用してモデルのハイパーパラメータを最適化し、モデルの性能を向上させます。
Sklearn の特徴
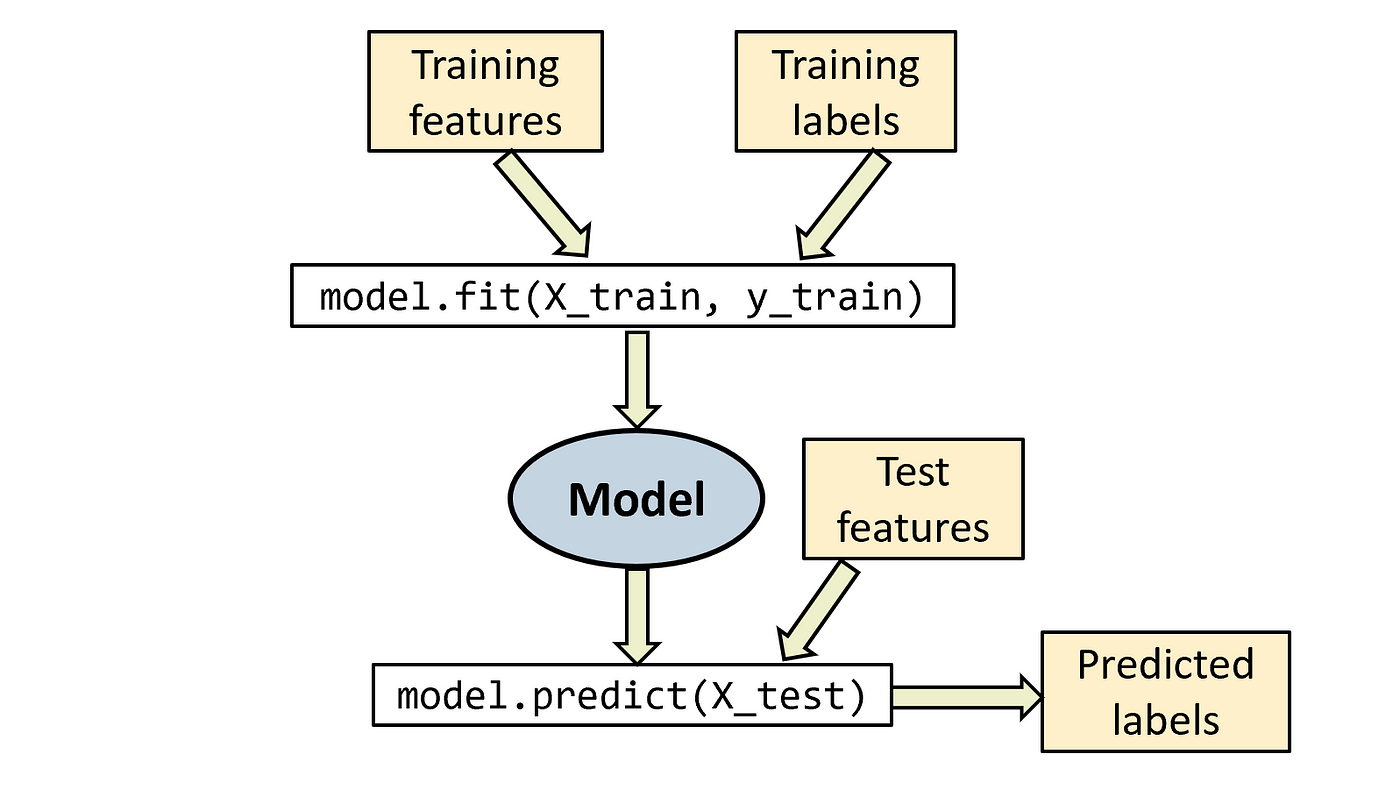
- 使いやすさ:Sklearn の API は簡潔で一貫性のある設計のため、学習曲線が比較的緩やかです。シンプルな
fit、predict、scoreなどのメソッドを使用することで、機械学習タスクを迅速に実装できます。 - 効率性:Sklearn は純粋な Python で書かれていますが、その基盤となる実装のほとんどは Cython と NumPy に依存しており、機械学習アルゴリズムの実行速度が非常に高速です。
- 豊富な機能:Sklearn は、以下のような数多くの古典的な機械学習アルゴリズムを提供しています:
- 分類アルゴリズム:ロジスティック回帰、サポートベクターマシン(SVM)、K近傍法(KNN)、ランダムフォレストなど
- 回帰アルゴリズム:線形回帰、リッジ回帰、ラッソ回帰など
- クラスタリングアルゴリズム:K平均法、階層的クラスタリング、DBSCAN など
- 次元削減アルゴリズム:主成分分析(PCA)、t-SNE など
- モデルの選択と評価:交差検証、グリッドサーチ、モデル評価指標など
- 互換性の高さ:Sklearn は NumPy、SciPy、Pandas などの Python データ処理ライブラリと良好に連携でき、NumPy 配列や Pandas DataFrame など複数のデータ形式での入力と出力に対応しています。
Sklearn が対応する機械学習タスク
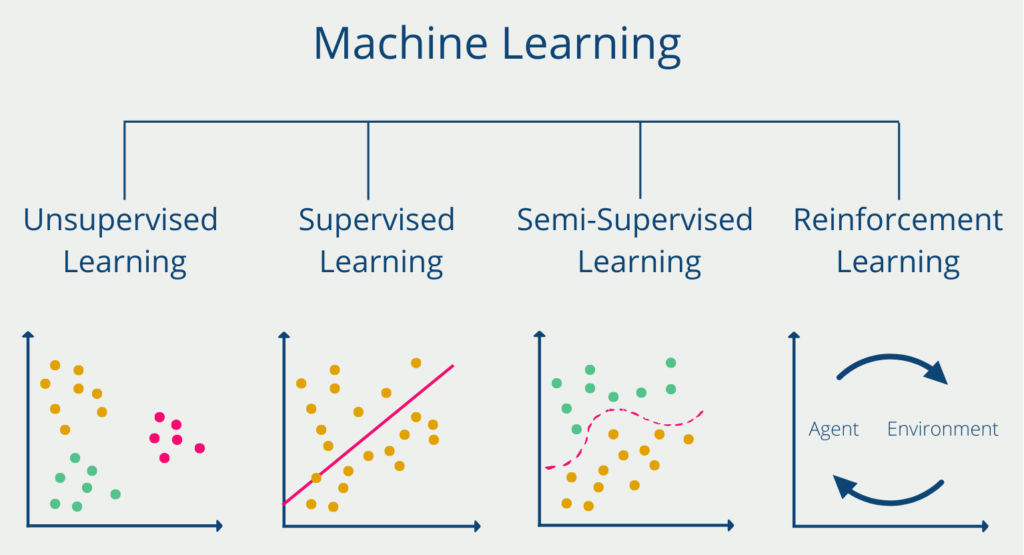
Sklearn は豊富なツールを提供しており、以下の種類の機械学習タスクに対応しています:
- 教師あり学習(Supervised Learning):
- 分類問題:データのカテゴリを予測します(例:メールのスパム分類、画像分類、病気の予測など)。
- 回帰問題:連続値を予測します(例:住宅価格の予測、株価の予測など)。
- 教師なし学習(Unsupervised Learning):
- クラスタリング問題:データを異なるグループに分類します(例:顧客のセグメンテーション、ドキュメントのクラスタリングなど)。
- 次元削減問題:高次元データを低次元空間に射影し、可視化を容易にしたり計算の複雑さを軽減します(例:PCA、t-SNE)。
- 半教師あり学習(Semi-supervised Learning):一部のデータはラベル付き、一部のデータはラベルなしであり、モデルはこれらのデータから情報を抽出しようとします。
- 強化学習(Reinforcement Learning):Sklearn は主に教師あり学習と教師なし学習に焦点を当てていますが、強化学習の問題を処理するための関連ツールもいくつかあります。
Sklearn の一般的なモジュールとクラス
- 分類(Classification)
sklearn.linear_model.LogisticRegression:ロジスティック回帰sklearn.svm.SVC:サポートベクターマシン分類sklearn.neighbors.KNeighborsClassifier:K近傍法分類sklearn.ensemble.RandomForestClassifier:ランダムフォレスト分類
- 回帰(Regression)
sklearn.linear_model.LinearRegression:線形回帰sklearn.linear_model.Ridge:リッジ回帰sklearn.ensemble.RandomForestRegressor:ランダムフォレスト回帰
- クラスタリング(Clustering)
sklearn.cluster.KMeans:K平均法クラスタリングsklearn.cluster.DBSCAN:密度ベースの空間クラスタリング
- 次元削減(Dimensionality Reduction)
sklearn.decomposition.PCA:主成分分析(PCA)sklearn.decomposition.NMF:非負値行列因子分解
- モデル選択(Model Selection)
sklearn.model_selection.train_test_split:データセットをトレーニングセットとテストセットに分割するsklearn.model_selection.GridSearchCV:グリッドサーチで最適なハイパーパラメータを探す
- データ前処理(Preprocessing)
sklearn.preprocessing.StandardScaler:標準化sklearn.preprocessing.MinMaxScaler:最小-最大正規化(Min-Max スケーリング)sklearn.preprocessing.OneHotEncoder:ワンホットエンコーディング
よく使われる用語の説明
- フィッティング(Fit):モデルをトレーニングデータに適用し、トレーニングを通じてモデルのパラメータを調整することを指します。
model.fit(X_train, y_train) - 予測(Predict):トレーニング済みのモデルに基づいて、未知のデータを予測します。
model.predict(X_test) - 評価(Score):モデルの性能を評価し、通常は正解率などのスコア指標を返します。
model.score(X_test, y_test) - 交差検証(Cross-validation):データセットを複数のサブセットに分割し、複数回のトレーニングと検証を通じて、モデルの安定性と汎化能力を評価します。
Sklearn と他のライブラリとの関係
- NumPy および SciPy との関係:Sklearn は NumPy と SciPy の上に構築されているため、数値計算や配列操作を効率的に処理できます。
- Pandas との関係:Pandas は強力なデータ処理機能を提供し、Sklearn は Pandas の DataFrame から直接データを抽出してモデルのトレーニングと予測を行うことをサポートしています。
- TensorFlow および PyTorch との関係:Sklearn は主に従来の機械学習手法に焦点を当てていますが、TensorFlow と PyTorch はディープラーニングモデルに重点を置いています。それでも、Sklearn はこれらのライブラリと組み合わせて使用でき、初期の特徴量エンジニアリングタスクを処理したり、ディープラーニングと比較するためのベースラインモデルとして使用できます。