Fundamentos de PyTorch
PyTorch es un framework de aprendizaje profundo de código abierto, muy popular por su flexibilidad y su gráfico computacional dinámico.
PyTorch tiene principalmente los siguientes conceptos básicos: Tensor, Autograd, módulo de red neuronal (nn.Module), optimizadores (optim), etc.
- Tensor: Es la estructura de datos central de PyTorch, admite arreglos multidimensionales y puede realizar cálculos acelerados en CPU o GPU.
- Diferenciación automática (Autograd): PyTorch proporciona diferenciación automática para calcular fácilmente los gradientes del modelo, facilitando la retropropagación y la optimización.
- Redes neuronales (nn.Module): PyTorch ofrece una API simple y potente para construir modelos de redes neuronales, permitiendo realizar fácilmente la propagación hacia adelante y la definición del modelo.
- Optimizadores (Optimizers): Se utilizan optimizadores (como Adam, SGD, etc.) para actualizar los parámetros del modelo y minimizar la pérdida.
- Dispositivo (Device): Se pueden mover el modelo y los tensores a la GPU para acelerar el cálculo.
Descripción general de la arquitectura de PyTorch
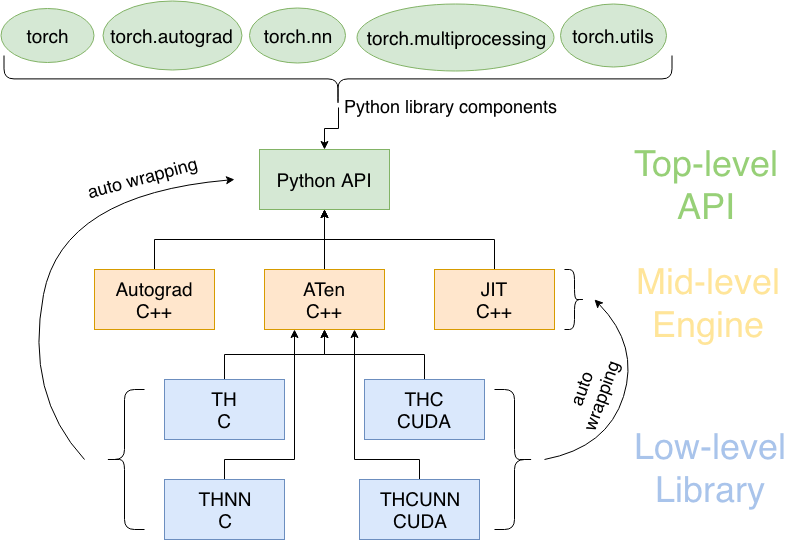
PyTorch adopta un diseño modular, compuesto por múltiples componentes centrales que colaboran entre sí. Comprender las funciones y las relaciones de estos componentes es clave para dominar PyTorch.
Diagrama de arquitectura de PyTorch
┌─────────────────────────────────────────────────────────────┐
│                    PyTorch 生态系统                          │
├─────────────────────────────────────────────────────────────┤
│  torchvision  │  torchtext  │  torchaudio  │  其他专业库     │
├─────────────────────────────────────────────────────────────┤
│                     PyTorch 核心                            │
├───────────────┬─────────────────┬───────────────────────────┤
│   torch.nn    │   torch.optim   │      torch.utils          │
│   (神经网络)   │   (优化器)      │      (工具函数)           │
├───────────────┼─────────────────┼───────────────────────────┤
│               │                 │   torch.utils.data        │
│  torch 核心   │  autograd       │   (数据加载)              │
│  (张量计算)   │  (自动微分)     │                           │
└───────────────┴─────────────────┴───────────────────────────┘
PyTorch adoptaarquitectura en capasdiseño, de arriba hacia abajo es la siguiente:
1. API de Python (capa superior)
torch: Cálculo central de tensores (similar a NumPy, compatible con GPU).torch.nn: Capas de redes neuronales, funciones de pérdida, etc.torch.autograd: Diferenciación automática (retropropagación).- Interfaz llamada directamente por los desarrolladores, simple y fácil de usar.
2. Núcleo de C++ (capa intermedia)
- ATen: Biblioteca central de operaciones con tensores (más de 400 operaciones).
- JIT: Compilación just-in-time (JIT) para optimizar modelos.
- Motor de Autograd: Implementación de bajo nivel de la diferenciación automática.
- Computación de alto rendimiento que conecta Python con el hardware subyacente.
3. Biblioteca base (capa inferior)
- TH/THNN: Operaciones básicas de tensores y redes neuronales implementadas en C.
- THC/THCUNN: Versión correspondiente para CUDA (GPU).
- Opera directamente sobre el hardware (CPU/GPU) para optimizar la velocidad al máximo.
Flujo de ejecución:
Código Python → Cálculo central en C++ → Aceleración con bibliotecas CUDA/C de bajo nivel → Retorno del resultado.
Mantiene tanto la facilidad de uso como el alto rendimiento.
Tensor
El tensor (Tensor) es la estructura de datos central de PyTorch, utilizada para almacenar y manipular arreglos multidimensionales.
Un tensor puede considerarse como un arreglo multidimensional que admite operaciones de cálculo acelerado.
En PyTorch, el concepto de tensor es similar al de los arreglos de NumPy, pero los tensores de PyTorch pueden ejecutarse en diferentes dispositivos, como CPU y GPU, lo que los hace muy adecuados para el cálculo paralelo a gran escala, especialmente en el campo del aprendizaje profundo.
-
Dimensionalidad: La dimensionalidad de un tensor se refiere a la estructura de arreglo multidimensional de los datos. Por ejemplo, un escalar (tensor de 0 dimensiones) es un solo número, un vector (tensor de 1 dimensión) es un arreglo unidimensional, una matriz (tensor de 2 dimensiones) es un arreglo bidimensional, y así sucesivamente.
-
Forma (Shape): La forma de un tensor se refiere al tamaño en cada dimensión. Por ejemplo, un tensor con forma
(3, 4)significa que tiene 3 filas y 4 columnas. -
Tipo de datos (Dtype): El tipo de datos en un tensor define el tamaño de memoria necesario para almacenar cada elemento y la forma de interpretarlo. PyTorch admite varios tipos de datos, incluyendo enteros (como
torch.int8、torch.int32), flotantes (comotorch.float32、torch.float64) y booleanos (torch.bool)。
Creación de tensores:
Ejemplo
# Crear un tensor de 2x3 todo ceros
a = torch.zeros(2, 3)
print(a)
# Crear un tensor de 2x3 todo unos
b = torch.ones(2, 3)
print(b)
# Crear un tensor de 2x3 con números aleatorios
c = torch.randn(2, 3)
print(c)
# Crear un tensor a partir de un arreglo de NumPy
import numpy as np
numpy_array = np.array([[1, 2], [3, 4]])
tensor_from_numpy = torch.from_numpy(numpy_array)
print(tensor_from_numpy)
# Crear un tensor en un dispositivo específico (CPU/GPU)
device = torch.device("cuda" if torch.cuda.is_available() else "cpu")
d = torch.randn(2, 3, device=device)
print(d)
La salida será similar a lo siguiente:
tensor([[0., 0., 0.],
        [0., 0., 0.]])
tensor([[1., 1., 1.],
        [1., 1., 1.]])
tensor([[ 1.0189, -0.5718, -1.2814],
        [-0.5865,  1.0855,  1.1727]])
tensor([[1, 2],
        [3, 4]])
tensor([[-0.3360,  0.2203,  1.3463],
        [-0.5982, -0.2704,  0.5429]])
Operaciones comunes con tensores:
Ejemplo
e = torch.randn(2, 3)
f = torch.randn(2, 3)
print(e + f)
# Multiplicación elemento a elemento
print(e * f)
# Transposición de tensores
g = torch.randn(3, 2)
print(g.t()) # o g.transpose(0, 1)
# Forma del tensor
print(g.shape) # Devuelve la forma
Tensores y dispositivos
Los tensores de PyTorch pueden existir en diferentes dispositivos, incluyendo CPU y GPU. Puedes mover tensores a la GPU para acelerar los cálculos:
if torch.cuda.is_available():
    tensor_gpu = tensor_from_list.to('cuda')  # 将张量移动到GPU
Gradientes y diferenciación automática
Los tensores de PyTorch admiten diferenciación automática, una característica clave en el aprendizaje profundo. Cuando creas un tensor que requiere gradiente, PyTorch puede calcular automáticamente su gradiente:
Ejemplo
tensor_requires_grad = torch.tensor([1.0], requires_grad=True)
# Realizar algunas operaciones
tensor_result = tensor_requires_grad * 2
# Calcular el gradiente
tensor_result.backward()
print(tensor_requires_grad.grad) # Mostrar el gradiente
Memoria y rendimiento
Los tensores de PyTorch también ofrecen algunas funciones de gestión de memoria, como los métodos .clone(), .detach() y .to(), que pueden ayudarte a optimizar el uso de memoria y mejorar el rendimiento.
Diferenciación automática (Autograd)
La diferenciación automática (Automatic Differentiation, abreviado Autograd) es una característica central de los frameworks de aprendizaje profundo que permite a las computadoras calcular automáticamente las derivadas de funciones matemáticas.
En el aprendizaje profundo, la diferenciación automática se utiliza principalmente para dos aspectos:Primero, calcular gradientes durante el entrenamiento de redes neuronales.,Segundo, implementar el algoritmo de retropropagación.。
La diferenciación automática se basa en la regla de la cadena (Chain Rule), una regla matemática para calcular derivadas de funciones complejas. La regla de la cadena establece que la derivada de una función compuesta es el producto de las derivadas de sus componentes. En el aprendizaje profundo, los modelos suelen ser funciones complejas compuestas por muchas capas, y la diferenciación automática puede calcular eficientemente los gradientes de estas capas.
Gráfico dinámico vs. gráfico estático:
-
Gráfico dinámico (Dynamic Graph): En un gráfico dinámico, el gráfico computacional se construye dinámicamente en tiempo de ejecución. Cada vez que se ejecuta una operación, el gráfico computacional se actualiza, lo que facilita la depuración y modificación de modelos. PyTorch utiliza gráficos dinámicos.
-
Gráfico estático (Static Graph): En un gráfico estático, el gráfico computacional se construye antes de comenzar la ejecución y no cambia. TensorFlow inicialmente usaba gráficos estáticos, pero luego también admitió gráficos dinámicos.
PyTorch proporciona diferenciación automática a través del módulo autograd para calcular gradientes automáticamente.
El objeto torch.Tensor tiene un atributo requires_grad que indica si es necesario calcular el gradiente de ese tensor.
Cuando creas un tensor con requires_grad=True, PyTorch rastrea automáticamente todas las operaciones sobre él para calcular el gradiente más adelante.
Crear un tensor que requiere gradiente:
Ejemplo
x = torch.randn(2, 2, requires_grad=True)
print(x)
# Realizar algunas operaciones
y = x + 2
z = y * y * 3
out = z.mean()
print(out)
La salida será similar a lo siguiente:
tensor([[0., 0., 0.],
        [0., 0., 0.]])
tensor([[1., 1., 1.],
        [1., 1., 1.]])
tensor([[ 1.0189, -0.5718, -1.2814],
        [-0.5865,  1.0855,  1.1727]])
tensor([[1, 2],
        [3, 4]])
tensor([[-0.3360,  0.2203,  1.3463],
        [-0.5982, -0.2704,  0.5429]])
tianqixin@Mac-mini ejemplo-test % python3 test.py
tensor([[-0.1908,  0.2811],
        [ 0.8068,  0.8002]], requires_grad=True)
tensor(18.1469, grad_fn=<MeanBackward0>)
Retropropagación (Backpropagation)
Una vez definido el gráfico computacional, se utiliza el.backward()método para calcular el gradiente.
Ejemplo
out.backward()
# Ver el gradiente de x
print(x.grad)
En el entrenamiento de redes neuronales, la diferenciación automática se utiliza principalmente para implementar el algoritmo de retropropagación.
La retropropagación es un método para entrenar redes neuronales calculando el gradiente de la función de pérdida con respecto a los parámetros de la red. En cada iteración, la propagación hacia adelante de la red calcula la salida y la pérdida, luego la retropropagación calcula el gradiente de la pérdida con respecto a cada parámetro y utiliza estos gradientes para actualizar los parámetros.
Detener el cálculo de gradientes
Si no deseas que se calculen los gradientes de ciertos tensores (por ejemplo, cuando no necesitas retropropagación), puedes usartorch.no_grad()o establecerrequires_grad=False。
Ejemplo
with torch.no_grad():
y = x * 2
Redes neuronales (nn.Module)
Una red neuronal es un modelo computacional que imita las conexiones de las neuronas del cerebro humano, compuesto por múltiples capas de nodos (neuronas), utilizado para aprender patrones y relaciones complejas entre los datos.
Las redes neuronales optimizan los resultados de predicción ajustando los pesos de las conexiones entre neuronas; este proceso implica propagación hacia adelante, cálculo de pérdida, retropropagación y actualización de parámetros.
Los tipos de redes neuronales incluyen redes neuronales feedforward, redes neuronales convolucionales (CNN), redes neuronales recurrentes (RNN) y redes de memoria a largo corto plazo (LSTM), que tienen amplias aplicaciones en campos como el reconocimiento de imágenes, el procesamiento del habla y el procesamiento del lenguaje natural.
PyTorch proporciona una interfaz muy conveniente para construir modelos de redes neuronales, es decir,torch.nn.Module。
Podemos heredar la clase nn.Module y definir nuestras propias capas de red.
Crear una red neuronal simple:
Ejemplo
import torch.optim as optim
# Definir una red neuronal totalmente conectada simple
class SimpleNN(nn.Module):
def __init__(self):
super(SimpleNN, self).__init__()
self.fc1 = nn.Linear(2, 2) # De la capa de entrada a la capa oculta
self.fc2 = nn.Linear(2, 1) # De la capa oculta a la capa de salida
def forward(self, x):
x = torch.relu(self.fc1(x)) # Función de activación ReLU
x = self.fc2(x)
return x
# Crear una instancia de la red
model = SimpleNN()
# Imprimir la estructura del modelo
print(model)
Resultado de salida:
SimpleNN(
  (fc1): Linear(in_features=2, out_features=2, bias=True)
  (fc2): Linear(in_features=2, out_features=1, bias=True)
)
Proceso de entrenamiento:
-
Propagación hacia adelante (Forward Propagation): En la etapa de propagación hacia adelante, los datos de entrada pasan a través de las capas de la red, cada capa aplica pesos y funciones de activación, hasta producir la salida.
-
Cálculo de pérdida (Calculate Loss): Según la salida de la red y las etiquetas reales, se calcula el valor de la función de pérdida.
-
Retropropagación (Backpropagation): La retropropagación utiliza técnicas de diferenciación automática para calcular el gradiente de la función de pérdida con respecto a cada parámetro.
-
Actualización de parámetros (Parameter Update): Utilizar el optimizador para actualizar los pesos y sesgos de la red según los gradientes.
-
Iteración (Iteration): Repetir el proceso anterior hasta que el rendimiento del modelo en los datos de entrenamiento alcance un nivel satisfactorio.
Propagación hacia adelante y cálculo de pérdida
Ejemplo
x = torch.randn(1, 2)
# Propagación hacia adelante
output = model(x)
print(output)
# Definir la función de pérdida (por ejemplo, error cuadrático medio MSE)
criterion = nn.MSELoss()
# Suponer que el valor objetivo es 1
target = torch.randn(1, 1)
# Calcular la pérdida
loss = criterion(output, target)
print(loss)
Optimizadores (Optimizers)
Los optimizadores actualizan los parámetros de la red neuronal durante el entrenamiento para reducir el valor de la función de pérdida.
PyTorch ofrece varios optimizadores, como SGD, Adam, etc.
Usar un optimizador para actualizar parámetros:
Ejemplo
optimizer = optim.Adam(model.parameters(), lr=0.001)
# Pasos de entrenamiento
optimizer.zero_grad() # Vaciar los gradientes
loss.backward() # Retropropagación
optimizer.step() # Actualizar parámetros
Entrenamiento del modelo
Entrenar un modelo es el proceso central en el aprendizaje automático y el aprendizaje profundo, cuyo objetivo es aprender los parámetros del modelo a partir de una gran cantidad de datos, de modo que el modelo pueda realizar predicciones precisas sobre datos nuevos y no vistos.
Entrenar un modelo generalmente incluye los siguientes pasos:
-
Preparación de datos:
- Recopilar y procesar datos, incluyendo limpieza, estandarización y normalización.
- Dividir los datos en conjuntos de entrenamiento, validación y prueba.
-
Definir el modelo:
- Seleccionar la arquitectura del modelo, como árboles de decisión, redes neuronales, etc.
- Inicializar los parámetros del modelo (pesos y sesgos).
-
Seleccionar la función de pérdida:
- Elegir una función de pérdida adecuada según el tipo de tarea (como clasificación, regresión).
-
Seleccionar el optimizador:
- Elegir un algoritmo de optimización, como SGD, Adam, etc., para actualizar los parámetros del modelo.
-
Propagación hacia adelante:
- En cada iteración, pasar los datos de entrada a través del modelo y calcular la salida predicha.
-
Calcular la pérdida:
- Usar la función de pérdida para evaluar la diferencia entre la salida predicha y las etiquetas reales.
-
Retropropagación:
- Utilizar la diferenciación automática para calcular el gradiente de la pérdida con respecto a los parámetros del modelo.
-
Actualización de parámetros:
- Actualizar los parámetros del modelo según los gradientes calculados y la estrategia del optimizador.
-
Optimización iterativa:
- Repetir los pasos 5-8 hasta que el rendimiento del modelo en el conjunto de validación deje de mejorar o se alcance el número predeterminado de iteraciones.
-
Evaluación y prueba:
- Usar el conjunto de prueba para evaluar el rendimiento final del modelo, asegurando que el modelo no esté sobreajustado.
-
Ajuste del modelo:
- Ajustar los hiperparámetros según el rendimiento del modelo en el conjunto de prueba, como cambiar la tasa de aprendizaje, añadir regularización, etc.
-
Desplegar el modelo:
- Desplegar el modelo entrenado en un entorno de producción para tareas de predicción reales.
Ejemplo
import torch.nn as nn
import torch.optim as optim
# 1. Definir un modelo de red neuronal simple
class SimpleNN(nn.Module):
def __init__(self):
super(SimpleNN, self).__init__()
self.fc1 = nn.Linear(2, 2) # De la capa de entrada a la capa oculta
self.fc2 = nn.Linear(2, 1) # De la capa oculta a la capa de salida
def forward(self, x):
x = torch.relu(self.fc1(x)) # Función de activación ReLU
x = self.fc2(x)
return x
# 2. Crear una instancia del modelo
model = SimpleNN()
# 3. Definir la función de pérdida y el optimizador
criterion = nn.MSELoss() # Función de pérdida de error cuadrático medio
optimizer = optim.Adam(model.parameters(), lr=0.001) # Optimizador Adam
# 4. Supongamos que tenemos datos de entrenamiento X e Y
X = torch.randn(10, 2) # 10 muestras, 2 características
Y = torch.randn(10, 1) # 10 valores objetivo
# 5. Bucle de entrenamiento
for epoch in range(100): # Entrenar durante 100 épocas
optimizer.zero_grad() # Vaciar los gradientes anteriores
output = model(X) # Propagación hacia adelante
loss = criterion(output, Y) # Calcular la pérdida
loss.backward() # Retropropagación
optimizer.step() # Actualizar parámetros
# Imprimir la pérdida cada 10 épocas
if (epoch+1) % 10 == 0:
print(f'Epoch [{epoch+1}/100], Loss: {loss.item():.4f}')
El resultado de salida es el siguiente:
Epoch [10/100], Loss: 1.7180
Epoch [20/100], Loss: 1.6352
Epoch [30/100], Loss: 1.5590
Epoch [40/100], Loss: 1.4896
Epoch [50/100], Loss: 1.4268
Epoch [60/100], Loss: 1.3704
Epoch [70/100], Loss: 1.3198
Epoch [80/100], Loss: 1.2747
Epoch [90/100], Loss: 1.2346
Epoch [100/100], Loss: 1.1991
Cada 10 épocas, el programa imprime el valor actual de la pérdida, lo que nos ayuda a seguir el progreso del entrenamiento del modelo. A medida que avanza el entrenamiento, el valor de la pérdida debería disminuir gradualmente, lo que indica que el modelo está aprendiendo y optimizando sus parámetros continuamente.
Entrenar un modelo es un proceso iterativo que requiere ajustes y optimización continuos hasta alcanzar un rendimiento satisfactorio. Este proceso involucra una gran cantidad de experimentos y ajustes, con el objetivo de que el modelo tenga una buena capacidad de generalización también en datos nuevos y no vistos.
Dispositivo (Device)
PyTorch te permite mover el modelo y los datos a la GPU para acelerar el proceso.
Usartorch.devicepara especificar el dispositivo de cálculo.
Mover el modelo y los datos a la GPU:
Ejemplo
# Mover el modelo al dispositivo
model.to(device)
# Mover los datos al dispositivo
X = X.to(device)
Y = Y.to(device)
Durante el entrenamiento, todos los tensores y el modelo deben moverse al mismo dispositivo (ya sea todos en la CPU o todos en la GPU).
Otras extensiones