Pandas-Datenstrukturen - Series
Series ist eine Kern-Datenstruktur in Pandas, ähnlich einem eindimensionalen Array, mit Daten und Index.
Series kann jeden Datentyp speichern (Ganzzahlen, Gleitkommazahlen, Zeichenketten usw.) und auf Elemente über Labels (Indizes) zugreifen.
Die Datenstruktur von Series ist sehr nützlich, da sie verschiedene Datentypen verarbeiten kann und gleichzeitig effiziente Datenmanipulationsfähigkeiten beibehält, wie z. B. den schnellen Zugriff auf und die Manipulation von Daten über Labels.
Series-Merkmale:
Eindimensionales Array:Jedes Element in einer Series hat einen entsprechenden Indexwert.
Index:Auf jedes Datenelement kann über ein Label (Index) zugegriffen werden. Standardmäßig ist der Index eine Ganzzahl, die bei 0 beginnt, aber Sie können den Index auch anpassen.
Datentypen:
SeriesKann Elemente verschiedener Datentypen aufnehmen, einschließlich Ganzzahlen, Gleitkommazahlen, Strings, Python-Objekte usw.Größenunveränderlichkeit:Die Größe einer Series ist nach der Erstellung festgelegt, kann aber durch bestimmte Operationen (wie append oder delete) geändert werden.
Operationen:Series unterstützt verschiedene Operationen, wie mathematische Operationen, statistische Analyse, String-Verarbeitung usw.
Fehlende Daten:Series kann fehlende Daten enthalten. Pandas verwendet NaN (Not a Number), um fehlende Werte oder das Fehlen eines Werts darzustellen.
Automatische Ausrichtung:Beim Ausführen von Operationen auf mehreren Series richtet Pandas die Daten automatisch anhand des Index aus, was die Datenverarbeitung effizienter macht.
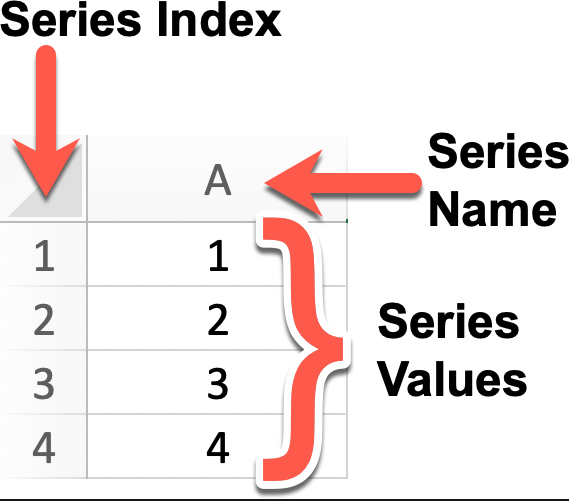
Beispiel
# Erstelle ein Series-Objekt mit dem Namen 'A' und den Werten 1, 2, 3, 4
# Standardindex ist 0, 1, 2, 3
series = pd.Series([1, 2, 3, 4], name='A')
# Zeige das Series-Objekt an
print(series)
# Wenn du den Index explizit festlegen möchtest, kannst du es so machen:
custom_index = [1, 2, 3, 4] # Benutzerdefinierter Index
series_with_index = pd.Series([1, 2, 3, 4], index=custom_index, name='A')
# Series-Objekt mit einem benutzerdefinierten Index anzeigen
print(series_with_index)
Das Ausgabeergebnis ist:
0    1
1    2
2    3
3    4
Name: A, dtype: int64
1    1
2    2
3    3
4    4
Name: A, dtype: int64
Series ist eine grundlegende Datenstruktur in Pandas, ähnlich einem eindimensionalen Array oder einer Liste, aber mit Beschriftungen (Indizes), was die Daten bei der Verarbeitung und Analyse flexibler macht.
Das Folgende ist eine ausführliche Einführung in Series in Pandas.
Eine Series erstellen
Sie können den Konstruktor pd.Series() verwenden, um ein Series-Objekt zu erstellen, indem Sie ein Datenarray (das eine Liste, ein NumPy-Array usw. sein kann) und ein optionales Index-Array übergeben.
pandas.Series(data=None, index=None, dtype=None, name=None, copy=False, fastpath=False)
Parameter description:
data: Der Datenteil der Series kann eine Liste, ein Array, ein Wörterbuch, ein Skalarwert usw. sein. Wenn dieser Parameter nicht angegeben wird, wird eine leere Series erstellt.index: Der Index-Teil der Series, der zum Beschriften der Daten verwendet wird. Kann eine Liste, ein Array, ein Index-Objekt usw. sein. Wenn dieser Parameter nicht angegeben wird, wird ein Standard-Integer-Index erstellt.dtype: Geben Sie den Datentyp der Series an. Kann ein NumPy-Datentyp sein, wie z. B.np.int64、np.float64usw. Wenn dieser Parameter nicht angegeben wird, wird der Datentyp automatisch aus den Daten abgeleitet.name: Der Name der Series, der zur Identifizierung des Series-Objekts verwendet wird. Wenn dieser Parameter angegeben wird, erhält das Series-Objekt den angegebenen Namen.copy: Ob Daten kopiert werden sollen. Standardwert ist False, was bedeutet, dass keine Daten kopiert werden. Wenn auf True gesetzt, werden die Eingabedaten kopiert.fastpath: Ob der schnelle Pfad aktiviert werden soll. Standardwert ist False. Das Aktivieren des schnellen Pfads kann in einigen Fällen die Leistung verbessern.
Ein einfaches Series-Beispiel erstellen:
Beispiel
a = [1, 2, 3]
myvar = pd.Series(a)
print(myvar)
Das Ausgabeergebnis ist wie folgt:
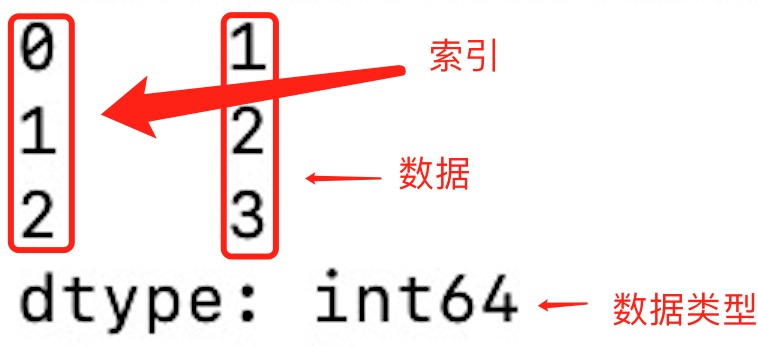
Aus der obigen Abbildung geht hervor, dass die Indexwerte bei 0 beginnen, wenn kein Index angegeben ist. Wir können Daten anhand des Indexwerts lesen:
Beispiel
a = [1, 2, 3]
myvar = pd.Series(a)
print(myvar[1])
Das Ausgabeergebnis ist wie folgt:
2
Wir können die Indexwerte angeben, wie im folgenden Beispiel:
Beispiel
a = ["Google", "Example", "Wiki"]
myvar = pd.Series(a, index = ["x", "y", "z"])
print(myvar)
Das Ausgabeergebnis ist wie folgt:
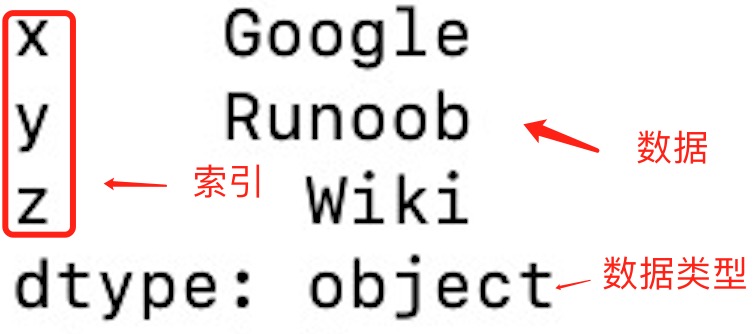
Daten anhand des Indexwerts lesen:
Beispiel
a = ["Google", "Example", "Wiki"]
myvar = pd.Series(a, index = ["x", "y", "z"])
print(myvar["y"])
Das Ausgabeergebnis ist wie folgt:
Example
Wir können auch Schlüssel-Wert-Objekte verwenden, ähnlich wie Dictionaries, um eine Series zu erstellen:
Beispiel
sites = {1: "Google", 2: "Example", 3: "Wiki"}
myvar = pd.Series(sites)
print(myvar)
Das Ausgabeergebnis ist wie folgt:
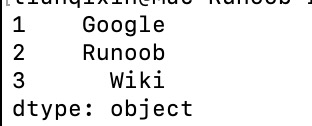
Aus der obigen Abbildung werden die Schlüssel des Wörterbuchs zu den Indexwerten.
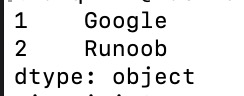
Wenn wir nur einen Teil der Daten aus dem Wörterbuch benötigen, müssen wir nur den Index der benötigten Daten angeben, wie im folgenden Beispiel:
Beispiel
sites = {1: "Google", 2: "Example", 3: "Wiki"}
myvar = pd.Series(sites, index = [1, 2])
print(myvar)
Das Ausgabeergebnis ist wie folgt:
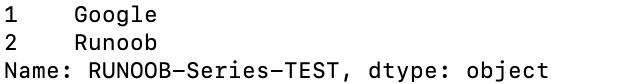
Legen Sie den Parameter name der Series fest:
Beispiel
sites = {1: "Google", 2: "Example", 3: "Wiki"}
myvar = pd.Series(sites, index = [1, 2], name="EXAMPLE-Series-TEST" )
print(myvar)
Series-Methoden
Im Folgenden finden Sie einige häufig verwendete Methoden in Series:
| Methodenname | Funktionsbeschreibung |
|---|---|
index | Den Index der Series abrufen |
values | Den Datenteil der Series abrufen (gibt ein NumPy-Array zurück) |
head(n) | Gibt die ersten n Zeilen der Series zurück (Standard ist 5) |
tail(n) | Gibt die letzten n Zeilen der Series zurück (Standard ist 5) |
dtype | Gibt den Datentyp der Series zurück |
shape | Gibt die Form der Series zurück (Anzahl der Zeilen) |
describe() | Gibt die statistische Beschreibung der Series zurück (wie Mittelwert, Standardabweichung, Minimum usw.) |
isnull() | Gibt eine boolesche Series zurück, die angibt, ob jedes Element NaN ist |
notnull() | Gibt eine boolesche Series zurück, die angibt, ob jedes Element nicht NaN ist |
unique() | Gibt die eindeutigen Werte in der Series zurück (Deduplizierung) |
value_counts() | Gibt die Anzahl des Vorkommens jedes eindeutigen Werts in der Series zurück |
map(func) | Wendet die angegebene Funktion auf jedes Element in der Series an |
apply(func) | Wendet die angegebene Funktion auf jedes Element in der Series an, wird häufig für benutzerdefinierte Operationen verwendet |
astype(dtype) | Konvertiert die Series in einen angegebenen Typ |
sort_values() | Sortiert die Elemente in der Series (nach Wert sortieren) |
sort_index() | Sortiere den Index der Series |
dropna() | Entferne fehlende Werte (NaN) aus der Series |
fillna(value) | Fülle fehlende Werte (NaN) in der Series |
replace(to_replace, value) | Ersetze angegebene Werte in der Series |
cumsum() | Gib die kumulative Summe der Series zurück |
cumprod() | Gib das kumulative Produkt der Series zurück |
shift(periods) | Verschiebe die Elemente in der Series um eine angegebene Anzahl von Schritten |
rank() | Gib die Ränge der Elemente in der Series zurück |
corr(other) | Berechne die Korrelation zwischen einer Series und einer anderen Series (Pearson-Korrelationskoeffizient) |
cov(other) | Berechne die Kovarianz zwischen einer Series und einer anderen Series |
to_list() | Konvertiere die Series in eine Python-Liste |
to_frame() | Konvertiere die Series in ein DataFrame |
iloc[] | Daten anhand des Positionsindex auswählen |
loc[] | Daten nach Label-Index auswählen |
Beispiel
# Eine Series erstellen
data = [1, 2, 3, 4, 5, 6]
index = ['a', 'b', 'c', 'd', 'e', 'f']
s = pd.Series(data, index=index)
# Grundlegende Informationen anzeigen
print("Index:", s.index)
print("Daten:", s.values)
print("Datentyp:", s.dtype)
print("Erste zwei Zeilen der Daten:", s.head(2))
# Verwende die map-Funktion, um jedes Element zu verdoppeln
s_doubled = s.map(lambda x: x * 2)
print("Nach dem Verdoppeln der Elemente:", s_doubled)
# Kumulative Summe berechnen
cumsum_s = s.cumsum()
print("Kumulative Summe:", cumsum_s)
# Fehlende Werte finden (hier gibt es keine fehlenden Werte, daher werden alle als False zurückgegeben)
print("Prüfung auf fehlende Werte:", s.isnull())
# Sortieren
sorted_s = s.sort_values()
print("Sortierte Series:", sorted_s)
Das Ausgabeergebnis ist:
索引: Index(['a', 'b', 'c', 'd', 'e', 'f'], dtype='object')
数据: [1 2 3 4 5 6]
数据类型: int64
前两行数据: a    1
b    2
dtype: int64
元素加倍后: a     2
b     4
c     6
d     8
e    10
f    12
dtype: int64
累计求和: a     1
b     3
c     6
d    10
e    15
f    21
dtype: int64
缺失值判断: a    False
b    False
c    False
d    False
e    False
f    False
dtype: bool
排序后的 Series: a    1
b    2
c    3
d    4
e    5
f    6
dtype: int64
Mehr über Series
Verwenden Sie eine Liste, ein Wörterbuch oder ein Array, um eine Series mit einem Standardindex zu erstellen.
# 使用列表创建 Series
s = pd.Series([1, 2, 3, 4])

# 使用 NumPy 数组创建 Series
s = pd.Series(np.array([1, 2, 3, 4]))

# 使用字典创建 Series
s = pd.Series({'a': 1, 'b': 2, 'c': 3, 'd': 4})
Grundlegende Operationen:
# 指定索引创建 Series
s = pd.Series([1, 2, 3, 4], index=['a', 'b', 'c', 'd'])

# 获取值
value = s[2]  # 获取索引为2的值
print(s['a'])  # 返回索引标签 'a' 对应的元素

# 获取多个值
subset = s[1:4]  # 获取索引为1到3的值

# 使用自定义索引
value = s['b']  # 获取索引为'b'的值

# 索引和值的对应关系
for index, value in s.items():
    print(f"Index: {index}, Value: {value}")


# 使用切片语法来访问 Series 的一部分
print(s['a':'c'])  # 返回索引标签 'a' 到 'c' 之间的元素
print(s[:3])  # 返回前三个元素

# 为特定的索引标签赋值
s['a'] = 10  # 将索引标签 'a' 对应的元素修改为 10

# 通过赋值给新的索引标签来添加元素
s['e'] = 5  # 在 Series 中添加一个新的元素,索引标签为 'e'

# 使用 del 删除指定索引标签的元素。
del s['a']  # 删除索引标签 'a' 对应的元素

# 使用 drop 方法删除一个或多个索引标签,并返回一个新的 Series.
s_dropped = s.drop(['b'])  # 返回一个删除了索引标签 'b' 的新 Series
Grundlegende Arithmetik:
# 算术运算
result = series * 2  # 所有元素乘以2

# 过滤
filtered_series = series[series > 2]  # 选择大于2的元素

# 数学函数
import numpy as np
result = np.sqrt(series)  # 对每个元素取平方根
Statistische Daten berechnen: Verwenden Sie Series-Methoden, um deskriptive Statistiken zu berechnen.
print(s.sum())  # 输出 Series 的总和
print(s.mean())  # 输出 Series 的平均值
print(s.max())  # 输出 Series 的最大值
print(s.min())  # 输出 Series 的最小值
print(s.std())  # 输出 Series 的标准差
Attribute und Methoden:
# 获取索引
index = s.index

# 获取值数组
values = s.values

# 获取描述统计信息
stats = s.describe()

# 获取最大值和最小值的索引
max_index = s.idxmax()
min_index = s.idxmin()

# 其他属性和方法
print(s.dtype)   # 数据类型
print(s.shape)   # 形状
print(s.size)    # 元素个数
print(s.head())  # 前几个元素,默认是前 5 个
print(s.tail())  # 后几个元素,默认是后 5 个
print(s.sum())   # 求和
print(s.mean())  # 平均值
print(s.std())   # 标准差
print(s.min())   # 最小值
print(s.max())   # 最大值
Verwenden Sie boolesche Ausdrücke: Filtern Sie eine Series basierend auf Bedingungen.
print(s > 2) # 返回一个布尔 Series,其中的元素值大于 2
Datentypen anzeigen: Verwenden Sie das dtype-Attribut, um den Datentyp einer Series anzuzeigen.
print(s.dtype) # 输出 Series 的数据类型
Datentypen konvertieren: Verwenden Sie die astype-Methode, um eine Series in einen anderen Datentyp zu konvertieren.
s = s.astype('float64') # 将 Series 中的所有元素转换为 float64 类型
Notizen:
SeriesDie darin enthaltenen Daten sind geordnet.- Sie können
Serieses als ein eindimensionales Array mit einem Index betrachten. - Der Index kann eindeutig sein, muss es aber nicht.
- Die Daten können Skalare, Listen, NumPy-Arrays usw. sein.