Estructura de datos de Pandas - Series
Series es una estructura de datos central en Pandas, similar a un array unidimensional, con datos e índices.
Series puede almacenar cualquier tipo de dato (enteros, flotantes, cadenas, etc.) y acceder a los elementos mediante etiquetas (índices).
La estructura de datos de Series es muy útil porque puede manejar varios tipos de datos, manteniendo una capacidad eficiente de operación de datos, por ejemplo, se puede acceder y manipular datos rápidamente mediante etiquetas.
Características de Series:
Array unidimensional:Cada elemento en Series tiene un valor de índice correspondiente.
Índice:Cada elemento de datos se puede acceder mediante una etiqueta (índice); por defecto, el índice es un entero que comienza en 0, pero también puedes personalizar el índice.
Tipo de dato:
SeriesPuede contener elementos de diferentes tipos de datos, incluyendo enteros, flotantes, cadenas, objetos de Python, etc.Inmutabilidad de tamaño:El tamaño de Series es fijo después de su creación, pero se puede cambiar mediante ciertas operaciones (como append o delete).
Operaciones:Series admite varias operaciones, como operaciones matemáticas, análisis estadístico, procesamiento de cadenas, etc.
Datos faltantes:Series puede contener datos faltantes; Pandas usa NaN (Not a Number) para representar valores faltantes o vacíos.
Alineación automática:Cuando se realizan operaciones con múltiples Series, Pandas alinea automáticamente los datos según el índice, lo que hace que el procesamiento de datos sea más eficiente.
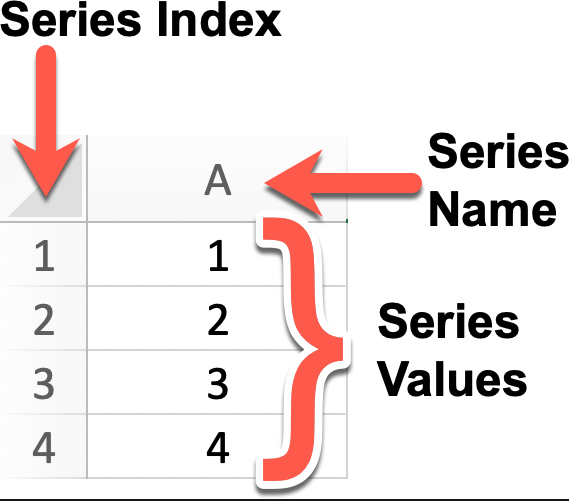
Ejemplo
# Crear un objeto Series, especificar el nombre como 'A', y los valores como 1, 2, 3, 4
# El índice predeterminado es 0, 1, 2, 3
series = pd.Series([1, 2, 3, 4], name='A')
# Mostrar el objeto Series
print(series)
# Si deseas establecer el índice explícitamente, puedes hacerlo así:
custom_index = [1, 2, 3, 4] # Índice personalizado
series_with_index = pd.Series([1, 2, 3, 4], index=custom_index, name='A')
# Mostrar el objeto Series con índice personalizado
print(series_with_index)
El resultado de salida es:
0    1
1    2
2    3
3    4
Name: A, dtype: int64
1    1
2    2
3    3
4    4
Name: A, dtype: int64
Series es una estructura de datos básica en Pandas, similar a un array unidimensional o lista, pero con etiquetas (índices), lo que brinda mayor flexibilidad al procesar y analizar datos.
A continuación se presenta una introducción detallada sobre Series en Pandas.
Crear Series
Se puede usar el constructor pd.Series() para crear un objeto Series, pasando un array de datos (puede ser una lista, un array de NumPy, etc.) y un array de índices opcional.
pandas.Series(data=None, index=None, dtype=None, name=None, copy=False, fastpath=False)
Descripción de parámetros:
data: La parte de datos de Series, puede ser una lista, array, diccionario, valor escalar, etc. Si no se proporciona este parámetro, se crea un Series vacío.index: La parte de índice de Series, se usa para etiquetar los datos. Puede ser una lista, array, objeto de índice, etc. Si no se proporciona este parámetro, se crea un índice entero predeterminado.dtype: Especifica el tipo de dato de Series. Puede ser un tipo de dato de NumPy, por ejemplonp.int64、np.float64etc. Si no se proporciona este parámetro, el tipo de dato se infiere automáticamente según los datos.name: El nombre de Series, se usa para identificar el objeto Series. Si se proporciona este parámetro, el objeto Series creado tendrá el nombre especificado.copy: Si copiar los datos. El valor predeterminado es False, lo que significa que no se copian los datos. Si se establece en True, se copian los datos de entrada.fastpath: Si habilitar la ruta rápida. El valor predeterminado es False. Habilitar la ruta rápida puede mejorar el rendimiento en algunos casos.
Crear un ejemplo simple de Series:
Ejemplo
a = [1, 2, 3]
myvar = pd.Series(a)
print(myvar)
El resultado de salida es el siguiente:
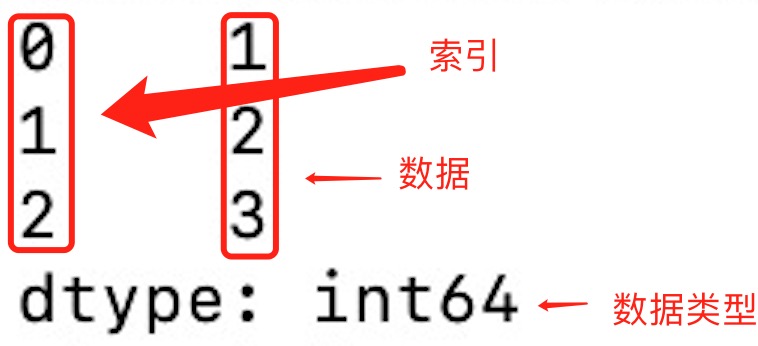
De la figura anterior se puede ver que si no se especifica un índice, el valor del índice comienza en 0, y podemos leer los datos según el valor del índice:
Ejemplo
a = [1, 2, 3]
myvar = pd.Series(a)
print(myvar[1])
El resultado de salida es el siguiente:
2
Podemos especificar el valor del índice, como en el siguiente ejemplo:
Ejemplo
a = ["Google", "Ejemplo", "Wiki"]
myvar = pd.Series(a, index = ["x", "y", "z"])
print(myvar)
El resultado de salida es el siguiente:
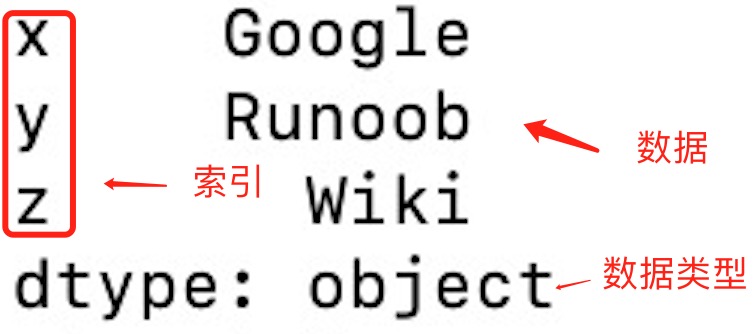
Leer datos según el valor del índice:
Ejemplo
a = ["Google", "Ejemplo", "Wiki"]
myvar = pd.Series(a, index = ["x", "y", "z"])
print(myvar["y"])
El resultado de salida es el siguiente:
Ejemplo
También podemos usar un objeto key/value, similar a un diccionario, para crear Series:
Ejemplo
sites = {1: "Google", 2: "Ejemplo", 3: "Wiki"}
myvar = pd.Series(sites)
print(myvar)
El resultado de salida es el siguiente:
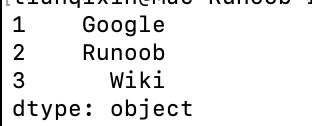
De la figura anterior se puede ver que la clave del diccionario se convierte en el valor del índice.
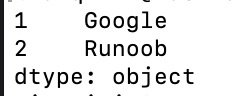
Si solo necesitamos una parte de los datos del diccionario, solo debemos especificar el índice de los datos deseados, como en el siguiente ejemplo:
Ejemplo
sites = {1: "Google", 2: "Ejemplo", 3: "Wiki"}
myvar = pd.Series(sites, index = [1, 2])
print(myvar)
El resultado de salida es el siguiente:
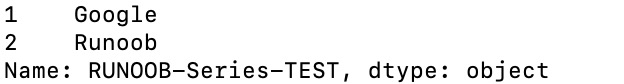
Configurar el parámetro de nombre de Series:
Ejemplo
sites = {1: "Google", 2: "Ejemplo", 3: "Wiki"}
myvar = pd.Series(sites, index = [1, 2], name="EJEMPLO-Series-TEST" )
print(myvar)
Métodos de Series
A continuación se presentan algunos métodos comunes en Series:
| Nombre del método | Descripción de la función |
|---|---|
index | Obtener el índice de Series |
values | Obtener la parte de datos de Series (devuelve un array de NumPy) |
head(n) | Devuelve las primeras n filas de Series (por defecto 5) |
tail(n) | Devuelve las últimas n filas de Series (por defecto 5) |
dtype | Devuelve el tipo de dato de Series |
shape | Devuelve la forma de Series (número de filas) |
describe() | Devuelve la descripción estadística de Series (como media, desviación estándar, mínimo, etc.) |
isnull() | Devuelve un Series booleano que indica si cada elemento es NaN |
notnull() | Devuelve un Series booleano que indica si cada elemento no es NaN |
unique() | Devuelve los valores únicos de Series (sin duplicados) |
value_counts() | Devuelve el número de apariciones de cada valor único en Series |
map(func) | Aplica la función especificada a cada elemento de Series |
apply(func) | Aplica la función especificada a cada elemento de Series, a menudo se usa para operaciones personalizadas |
astype(dtype) | Convierte Series al tipo especificado |
sort_values() | Ordena los elementos de Series (ordenar por valor) |
sort_index() | Ordena el índice de Series |
dropna() | Elimina los valores faltantes (NaN) de Series |
fillna(value) | Rellena los valores faltantes (NaN) en Series |
replace(to_replace, value) | Reemplaza los valores especificados en Series |
cumsum() | Devuelve la suma acumulada de Series |
cumprod() | Devuelve el producto acumulado de Series |
shift(periods) | Desplaza los elementos de Series según el número de pasos especificado |
rank() | Devuelve la clasificación (ranking) de los elementos en Series |
corr(other) | Calcula la correlación entre Series y otra Series (coeficiente de correlación de Pearson) |
cov(other) | Calcula la covarianza entre Series y otra Series |
to_list() | Convierte Series a una lista de Python |
to_frame() | Convierte Series a DataFrame |
iloc[] | Seleccionar datos mediante índice posicional |
loc[] | Seleccionar datos mediante índice de etiqueta |
Ejemplo
# Crear Series
data = [1, 2, 3, 4, 5, 6]
index = ['a', 'b', 'c', 'd', 'e', 'f']
s = pd.Series(data, index=index)
# Ver información básica
print("Índice:", s.index)
print("Datos:", s.values)
print("Tipo de dato:", s.dtype)
print("Primeras dos filas de datos:", s.head(2))
# Usar la función map para duplicar cada elemento
s_doubled = s.map(lambda x: x * 2)
print("Después de duplicar los elementos:", s_doubled)
# Calcular la suma acumulada
cumsum_s = s.cumsum()
print("Suma acumulada:", cumsum_s)
# Buscar valores faltantes (aquí no hay valores faltantes, por lo que todos devuelven False)
print("Detección de valores faltantes:", s.isnull())
# Ordenar
sorted_s = s.sort_values()
print("Series ordenado:", sorted_s)
El resultado de salida es:
索引: Index(['a', 'b', 'c', 'd', 'e', 'f'], dtype='object')
数据: [1 2 3 4 5 6]
数据类型: int64
前两行数据: a    1
b    2
dtype: int64
元素加倍后: a     2
b     4
c     6
d     8
e    10
f    12
dtype: int64
累计求和: a     1
b     3
c     6
d    10
e    15
f    21
dtype: int64
缺失值判断: a    False
b    False
c    False
d    False
e    False
f    False
dtype: bool
排序后的 Series: a    1
b    2
c    3
d    4
e    5
f    6
dtype: int64
Más explicaciones sobre Series
Crear un Series con índice predeterminado usando una lista, diccionario o array.
# 使用列表创建 Series
s = pd.Series([1, 2, 3, 4])

# 使用 NumPy 数组创建 Series
s = pd.Series(np.array([1, 2, 3, 4]))

# 使用字典创建 Series
s = pd.Series({'a': 1, 'b': 2, 'c': 3, 'd': 4})
Operaciones básicas:
# 指定索引创建 Series
s = pd.Series([1, 2, 3, 4], index=['a', 'b', 'c', 'd'])

# 获取值
value = s[2]  # 获取索引为2的值
print(s['a'])  # 返回索引标签 'a' 对应的元素

# 获取多个值
subset = s[1:4]  # 获取索引为1到3的值

# 使用自定义索引
value = s['b']  # 获取索引为'b'的值

# 索引和值的对应关系
for index, value in s.items():
    print(f"Index: {index}, Value: {value}")


# 使用切片语法来访问 Series 的一部分
print(s['a':'c'])  # 返回索引标签 'a' 到 'c' 之间的元素
print(s[:3])  # 返回前三个元素

# 为特定的索引标签赋值
s['a'] = 10  # 将索引标签 'a' 对应的元素修改为 10

# 通过赋值给新的索引标签来添加元素
s['e'] = 5  # 在 Series 中添加一个新的元素,索引标签为 'e'

# 使用 del 删除指定索引标签的元素。
del s['a']  # 删除索引标签 'a' 对应的元素

# 使用 drop 方法删除一个或多个索引标签,并返回一个新的 Series.
s_dropped = s.drop(['b'])  # 返回一个删除了索引标签 'b' 的新 Series
Operaciones fundamentales:
# 算术运算
result = series * 2  # 所有元素乘以2

# 过滤
filtered_series = series[series > 2]  # 选择大于2的元素

# 数学函数
import numpy as np
result = np.sqrt(series)  # 对每个元素取平方根
Calcular estadísticas: usar los métodos de Series para calcular estadísticas descriptivas.
print(s.sum())  # 输出 Series 的总和
print(s.mean())  # 输出 Series 的平均值
print(s.max())  # 输出 Series 的最大值
print(s.min())  # 输出 Series 的最小值
print(s.std())  # 输出 Series 的标准差
Atributos y métodos:
# 获取索引
index = s.index

# 获取值数组
values = s.values

# 获取描述统计信息
stats = s.describe()

# 获取最大值和最小值的索引
max_index = s.idxmax()
min_index = s.idxmin()

# 其他属性和方法
print(s.dtype)   # 数据类型
print(s.shape)   # 形状
print(s.size)    # 元素个数
print(s.head())  # 前几个元素,默认是前 5 个
print(s.tail())  # 后几个元素,默认是后 5 个
print(s.sum())   # 求和
print(s.mean())  # 平均值
print(s.std())   # 标准差
print(s.min())   # 最小值
print(s.max())   # 最大值
Usar expresiones booleanas: filtrar Series según condiciones.
print(s > 2) # 返回一个布尔 Series,其中的元素值大于 2
Ver el tipo de datos: use el atributo dtype para ver el tipo de datos de la Series.
print(s.dtype) # 输出 Series 的数据类型
Convertir el tipo de datos: use el método astype para convertir la Series a otro tipo de datos.
s = s.astype('float64') # 将 Series 中的所有元素转换为 float64 类型
Notas:
SeriesLos datos en ella están ordenados.- Se puede
Seriesconsiderar como un arreglo unidimensional con índices. - Los índices pueden ser únicos, pero no es obligatorio.
- Los datos pueden ser escalares, listas, arreglos de NumPy, etc.