Pandas Korrelationsanalyse
Die Korrelationsanalyse ist ein gängiger und wichtiger Schritt in der Datenanalyse; sie hilft uns, die Beziehungen zwischen verschiedenen Variablen in Daten zu verstehen.
In Pandas wird die Datenkorrelationsanalyse durch die Berechnung der Korrelationskoeffizienten zwischen verschiedenen Variablen durchgeführt, um ihre Beziehungen zu verstehen.
In Pandas ist die Datenkorrelation eine wichtige Analyseaufgabe, die uns hilft, die Beziehungen zwischen verschiedenen Variablen in Daten zu verstehen.
Pandas bietet mehrere Methoden zur Berechnung und Analyse der Datenkorrelation. Gängige Korrelationsmethoden umfassen den Pearson-Korrelationskoeffizienten (Pearson), den Spearman-Rangkorrelationskoeffizienten (Spearman) und den Kendall-Rangkorrelationskoeffizienten (Kendall).
Die folgenden Korrelationsmethoden können uns helfen, lineare, nichtlineare oder monotone Beziehungen zwischen Variablen aufzudecken:
- Pearson-Korrelationskoeffizient: Misst die lineare Beziehung zwischen Variablen, geeignet für numerische Variablen.
- Spearman-Rangkorrelationskoeffizient: Misst die monotone Beziehung zwischen Variablen, geeignet für numerische und ordinale Variablen.
- Kendall-Rangkorrelationskoeffizient: Misst die Rangbeziehung zwischen Variablen, geeignet für Daten mit kleinem Stichprobenumfang.
- Korrelationsmatrix: Wird verwendet, um die Korrelationen zwischen Variablen anzuzeigen.
- Heatmap: Eine effektive Visualisierungsmethode, die uns hilft, die Korrelationen zwischen Variablen intuitiv zu erkennen.
Was ist Korrelation?
Korrelation repräsentiert die Stärke und Richtung der Beziehung zwischen zwei oder mehr Variablen. Anhand des Korrelationswerts kann die Beziehung zwischen Variablen bestimmt werden.
- Positive Korrelation: Wenn eine Variable zunimmt, nimmt auch die andere Variable zu. Zum Beispiel können Körpergröße und Gewicht eine positive Korrelation aufweisen.
- Negative Korrelation: Wenn eine Variable zunimmt, nimmt die andere Variable ab. Zum Beispiel können Temperatur und Heizungsnutzung eine negative Korrelation aufweisen.
- Keine Korrelation: Es gibt keine klare Beziehung zwischen den beiden Variablen.
Der Wert der Korrelation liegt typischerweise zwischen -1 und 1:
- 1: Perfekte positive Korrelation
- -1: Perfekte negative Korrelation
- 0: Keine lineare Korrelation
- Nahe bei 1 oder -1: Zeigt eine starke Korrelation an
- Nahe bei 0: Zeigt eine schwache Korrelation an
Methoden zur Berechnung der Korrelation in Pandas
Pandas bietet dieDataFrame.corr()undDataFrame.cov()Methode zur Berechnung von Korrelation und Kovarianz.
Pandas verwendet diecorr()Methode, um die Beziehungen zwischen jeder Spalte in einem Datensatz zu berechnen.
df.corr(method='pearson', min_periods=1)
Parameter description:
- method(Optional): String-Typ; wird verwendet, um die Methode zur Berechnung des Korrelationskoeffizienten anzugeben. Standard ist 'pearson'; Sie können auch 'kendall' (Kendall-Tau-Korrelationskoeffizient) oder 'spearman' (Spearman-Rangkorrelationskoeffizient) wählen.
- min_periods(Optional): Gibt die Mindestanzahl an Beobachtungen an, die bei der Berechnung des Korrelationskoeffizienten erforderlich sind. Der Standardwert ist 1, was bedeutet, dass die Berechnung durchgeführt wird, solange mindestens ein Nicht-Null-Wert vorhanden ist. Wenn angegeben
min_periods, und die Anzahl der Nicht-Null-Werte in einigen Spalten kleiner als dieser Wert ist, wird der Korrelationskoeffizient für diese Spalten auf NaN gesetzt.
df.corr()Die Methode gibt eine Korrelationskoeffizientenmatrix zurück. Die Zeilen und Spalten der Matrix entsprechen den Spaltennamen des DataFrame, und die Matrixelemente sind die Korrelationskoeffizienten zwischen den entsprechenden Spalten.
Zu den gebräuchlichen Korrelationskoeffizienten gehören der Pearson-Korrelationskoeffizient und der Spearman-Rangkorrelationskoeffizient:
Pearson-Korrelationskoeffizient
Pearson, genauer der Pearson-Korrelationskoeffizient, wird verwendet, um die Stärke und Richtung des linearen Zusammenhangs zwischen zwei Variablen zu messen. Sein Wert reicht von -1 bis 1, wobei -1 eine perfekte negative Korrelation angibt, 1 eine perfekte positive Korrelation und 0 keine lineare Korrelation.
Der Pearson-Korrelationskoeffizient wird verwendet, um die lineare Beziehung zwischen zwei Variablen zu messen. Die Berechnungsformel lautet:
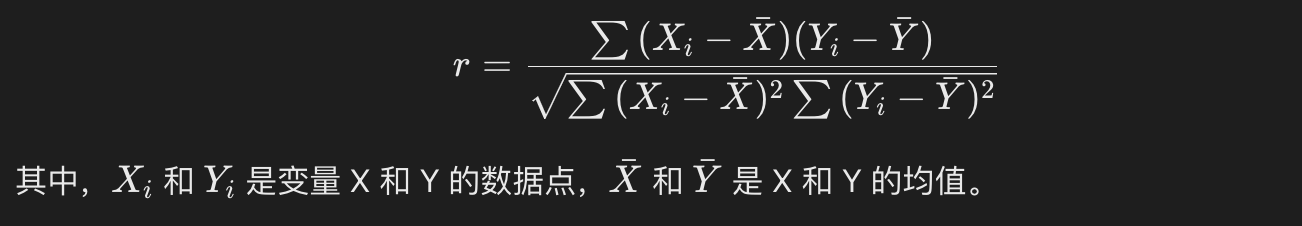
Pandas kann diecorr()Methode verwenden, um den Pearson-Korrelationskoeffizienten zwischen Spalten in einem DataFrame zu berechnen.
Pearson-Korrelationskoeffizient
Beispiel
# Beispieldaten
data = {
'Height': [150, 160, 170, 180, 190],
'Weight': [45, 55, 65, 75, 85],
'Age': [20, 25, 30, 35, 40]
}
df = pd.DataFrame(data)
# Berechne den Pearson-Korrelationskoeffizienten
correlation = df.corr(method='pearson')
print(correlation)
Ausgabe:
        Height  Weight  Age
Height     1.0     1.0  1.0
Weight     1.0     1.0  1.0
Age        1.0     1.0  1.0
Erklärung:
corr()Die Methode berechnete den Pearson-Korrelationskoeffizienten zwischen jedem Paar von Variablen.method='pearson'ist die Standardmethode, was die Berechnung des Pearson-Korrelationskoeffizienten anzeigt.- Es ist zu erkennen, dass
HeightundWeightundAgealle eine starke positive Korrelation haben.
Spearman-Rangkorrelationskoeffizient (Spearman-Korrelation)
Der Spearman-Korrelationskoeffizient misst die monotone Beziehung zwischen zwei Variablen (ob linear oder nichtlinear) und wird auf der Grundlage der Ränge der Variablen berechnet. Der Spearman-Korrelationskoeffizient hat denselben Wertebereich wie der Pearson-Korrelationskoeffizient: -1 bis 1.
Beispiel
# Beispieldaten
data = {
'Height': [150, 160, 170, 180, 190],
'Weight': [45, 55, 65, 75, 85],
'Age': [20, 25, 30, 35, 40]
}
df = pd.DataFrame(data)
# Berechne den Spearman-Rangkorrelationskoeffizienten
spearman_correlation = df.corr(method='spearman')
print(spearman_correlation)
Ausgabe:
        Height  Weight  Age
Height     1.0     1.0  1.0
Weight     1.0     1.0  1.0
Age        1.0     1.0  1.0
Erklärung:method='spearman' berechnet den Spearman-Rangkorrelationskoeffizienten. In diesem Beispiel, weil die Daten linear wachsen, ist der Spearman-Korrelationskoeffizient derselbe wie der Pearson-Korrelationskoeffizient.
Kendall-Rangkorrelationskoeffizient (Kendall-Korrelation)
Der Kendall-Rangkorrelationskoeffizient wird ebenfalls verwendet, um die monotone Beziehung zwischen Variablen zu messen. Er ergibt sich aus der Berechnung der Konkordanz zwischen den Rangfolgen zweier Variablen.
Der Kendall-Korrelationskoeffizient ist komplexer zu berechnen und eignet sich für kleinere Datensätze.
Beispiel
# Beispieldaten
data = {
'Height': [150, 160, 170, 180, 190],
'Weight': [45, 55, 65, 75, 85],
'Age': [20, 25, 30, 35, 40]
}
df = pd.DataFrame(data)
# Kendall-Rangkorrelationskoeffizienten berechnen
kendall_correlation = df.corr(method='kendall')
print(kendall_correlation)
Ausgabe:
        Height  Weight  Age
Height     1.0     1.0  1.0
Weight     1.0     1.0  1.0
Age        1.0     1.0  1.0
Erklärung:method='kendall' berechnet den Kendall-Rangkorrelationskoeffizienten. In diesem Fall ändern sich die Daten monoton, daher ist das Berechnungsergebnis dasselbe wie bei Pearson und Spearman.
Korrelationsmatrix
Eine Korrelationsmatrix ist eine symmetrische Matrix, wobei jeder Wert in der Matrix den Korrelationskoeffizienten zwischen zwei Variablen darstellt.
Sie können die Methode corr() verwenden, um die Korrelationsmatrix aller Variablen in einem DataFrame direkt zu berechnen.
Beispiel
# Beispieldaten
data = {
'Height': [150, 160, 170, 180, 190],
'Weight': [45, 55, 65, 75, 85],
'Age': [20, 25, 30, 35, 40]
}
df = pd.DataFrame(data)
# Korrelationsmatrix berechnen
correlation_matrix = df.corr()
print(correlation_matrix)
Ausgabe:
        Height  Weight  Age
Height     1.0     1.0  1.0
Weight     1.0     1.0  1.0
Age 1.0 1.0 1.0Erklärung:Die Korrelationsmatrix hilft uns schnell zu erkennen, welche Variablen starke lineare oder monotone Beziehungen haben. In der praktischen Analyse ist die Korrelationsmatrix sehr hilfreich für Merkmalsauswahl und Dimensionsreduktion.
Korrelations-Heatmap (Correlation Heatmap)
Um die Korrelationsmatrix intuitiver darzustellen, kann eine Heatmap verwendet werden, um die Korrelationen zwischen Variablen zu visualisieren.
Die Verwendung der seaborn-Bibliothek zum Zeichnen einer Korrelations-Heatmap ist eine gängige Praxis.
Beispiel
import matplotlib.pyplot as plt
import pandas as pd
# Beispieldaten
data = {
'Height': [150, 160, 170, 180, 190],
'Weight': [45, 55, 65, 75, 85],
'Age': [20, 25, 30, 35, 40]
}
df = pd.DataFrame(data)
# Korrelations-Heatmap zeichnen
plt.figure(figsize=(8, 6))
sns.heatmap(df.corr(), annot=True, cmap='coolwarm', fmt='.2f', vmin=-1, vmax=1)
plt.title('Correlation Heatmap')
plt.show()
Wird folgendermaßen angezeigt:
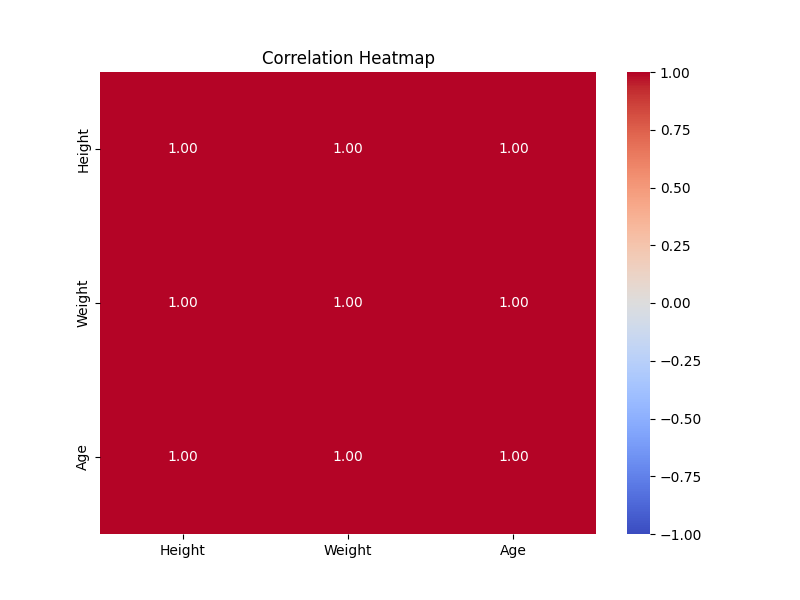
Erklärung:sns.heatmap() zeichnet die Korrelations-Heatmap. annot=True zeigt die Werte auf der Heatmap an, cmap='coolwarm' legt den Farbbereich fest, und vmin=-1, vmax=1 begrenzt den Farbbereich auf -1 bis 1.
Korrelation visualisieren
Hier verwenden wir Pythons Seaborn-Bibliothek. Seaborn ist eine Datenvisualisierungsbibliothek auf Basis von Matplotlib, die sich auf statistische Grafiken konzentriert und den Prozess der Datenvisualisierung vereinfachen soll.
Seaborn bietet einige einfache High-Level-Schnittstellen, die es leicht machen, verschiedene statistische Diagramme zu zeichnen, darunter Streudiagramme, Liniendiagramme, Balkendiagramme, Heatmaps usw., und es hat eine gute ästhetische Wirkung.
Seaborn installieren:
pip install seaborn
Beispiel
import matplotlib.pyplot as plt
import pandas as pd
# Beispiel-DataFrame erstellen
data = {'A': [1, 2, 3, 4, 5], 'B': [5, 4, 3, 2, 1]}
df = pd.DataFrame(data)
# Berechne den Pearson-Korrelationskoeffizienten
correlation_matrix = df.corr()
# Pearson-Korrelationskoeffizienten mit einer Heatmap visualisieren
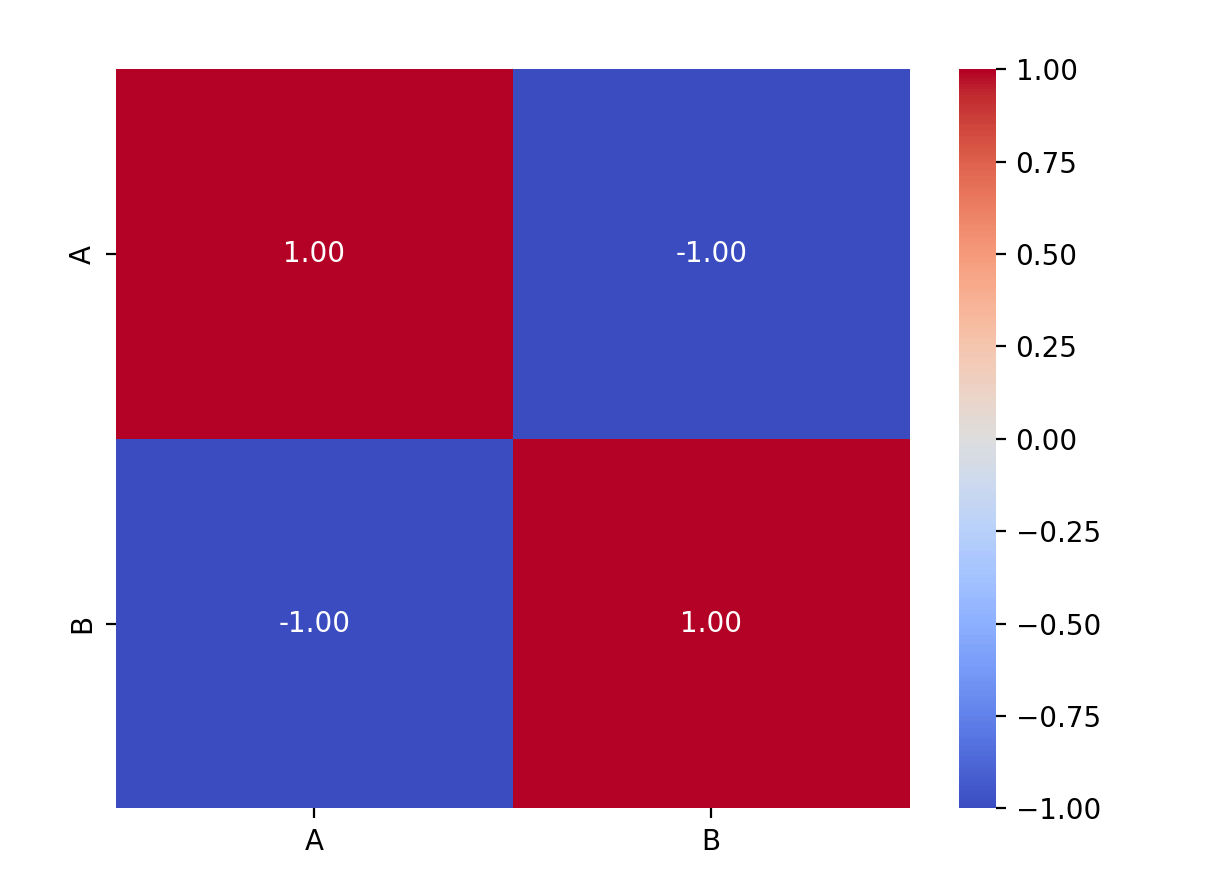
sns.heatmap(correlation_matrix, annot=True, cmap='coolwarm', fmt=".2f")
plt.show()
Erklärung:Dieser Code erzeugt eine Heatmap, die Farben verwendet, um die Stärke der Korrelationskoeffizienten darzustellen, wobei positive Korrelationen in warmen Tönen und negative Korrelationen in kühlen Tönen dargestellt werden.annot=TrueDer Parameter zeigt die spezifischen Werte auf der Heatmap an.
Anwendungen der Korrelationsanalyse
1. Merkmalsauswahl
Beim Modellieren mit maschinellem Lernen wird die Korrelationsanalyse häufig zur Merkmalsauswahl eingesetzt. Durch die Analyse der Korrelation zwischen verschiedenen Merkmalen hilft sie uns, die für die Zielvariable relevantesten Merkmale auszuwählen und redundante Merkmale zu entfernen, die stark mit anderen Merkmalen korrelieren, wodurch die Modellleistung und -effizienz verbessert werden.
2. Umgang mit Multikollinearität
Wenn die Korrelation zwischen zwei oder mehr Merkmalen sehr hoch ist (nahe bei 1 oder -1), dann besteht bei diesen Merkmalen ein Multikollinearitätsproblem. In der Regressionsanalyse kann Multikollinearität zu Modellinstabilität und ungenauen Vorhersagen führen. Dieses Problem kann durch Löschen oder Zusammenführen von Merkmalen mit hoher Korrelation gelöst werden.
Weitere Erweiterungen