Структуры данных Pandas - Series
Series — это основная структура данных в Pandas, аналогичная одномерному массиву, с данными и индексом.
Series может хранить любой тип данных (целые числа, числа с плавающей точкой, строки и т. д.) и предоставлять доступ к элементам через метки (индексы).
Структура данных Series очень полезна, поскольку она может обрабатывать различные типы данных, сохраняя при этом эффективные возможности манипулирования данными, например быстрый доступ к данным и работу с ними через метки.
Особенности Series:
Одномерный массив:Каждый элемент в Series имеет соответствующее значение индекса.
Индекс:Доступ к каждому элементу данных можно получить через метку (индекс). По умолчанию индекс — это целое число, начиная с 0, но также можно настроить индекс.
Типы данных:
SeriesМожет содержать элементы разных типов данных, включая целые числа, числа с плавающей точкой, строки, объекты Python и т. д.Неизменяемость размера:Размер Series фиксирован после создания, но его можно изменить с помощью определённых операций (таких как append или delete).
Операции:Series поддерживает различные операции, такие как математические операции, статистический анализ, обработка строк и т. д.
Пропущенные данные:Series может содержать пропущенные данные. Pandas использует NaN (не число) для представления пропущенного или отсутствующего значения.
Автоматическое выравнивание:При выполнении операций с несколькими Series Pandas автоматически выравнивает данные по индексу, что делает обработку данных более эффективной.
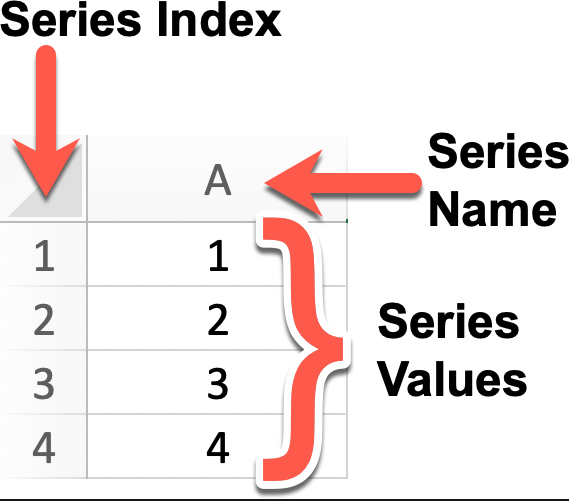
Пример
# Создаем объект Series с именем 'A' и значениями 1, 2, 3, 4
# Индекс по умолчанию — 0, 1, 2, 3
series = pd.Series([1, 2, 3, 4], name='A')
# Отображаем объект Series
print(series)
# Если вы хотите явно задать индекс, это можно сделать так:
custom_index = [1, 2, 3, 4] # Пользовательский индекс
series_with_index = pd.Series([1, 2, 3, 4], index=custom_index, name='A')
# Отобразить объект Series с пользовательским индексом
print(series_with_index)
Результат вывода:
0    1
1    2
2    3
3    4
Name: A, dtype: int64
1    1
2    2
3    3
4    4
Name: A, dtype: int64
Series — это базовая структура данных в Pandas, похожая на одномерный массив или список, но с метками (индексами), что делает данные более гибкими при обработке и анализе.
Далее приводится подробное введение в Series в Pandas.
Создание Series
Вы можете использовать конструктор pd.Series() для создания объекта Series, передав массив данных (который может быть списком, массивом NumPy и т. д.) и необязательный массив индексов.
pandas.Series(data=None, index=None, dtype=None, name=None, copy=False, fastpath=False)
Описание параметра:
data: Часть данных Series, может быть списком, массивом, словарём, скалярным значением и т. д. Если этот параметр не указан, создаётся пустой Series.index: Часть индекса Series, используемая для маркировки данных. Может быть списком, массивом, объектом индекса и т. д. Если этот параметр не указан, создаётся целочисленный индекс по умолчанию.dtype: Указывает тип данных Series. Может быть типом данных NumPy, напримерnp.int64、np.float64и т. д. Если этот параметр не указан, тип данных автоматически выводится из данных.name: Имя Series, используемое для идентификации объекта Series. Если этот параметр указан, созданный объект Series будет иметь указанное имя.copy: Копировать ли данные. По умолчанию False, что означает, что данные не копируются. Если установлено True, входные данные копируются.fastpath: Включить ли быстрый путь. По умолчанию False. Включение быстрого пути может повысить производительность в некоторых случаях.
Создайте простой пример Series:
Пример
a = [1, 2, 3]
myvar = pd.Series(a)
print(myvar)
Результат вывода следующий:
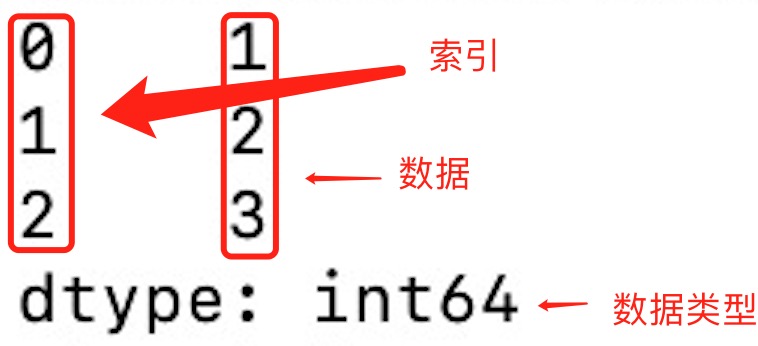
Из рисунка выше видно, что если индекс не указан, значения индекса начинаются с 0. Мы можем читать данные по значению индекса:
Пример
a = [1, 2, 3]
myvar = pd.Series(a)
print(myvar[1])
Результат вывода следующий:
2
Мы можем указать значения индекса, как в следующем примере:
Пример
a = ["Google", "Example", "Wiki"]
myvar = pd.Series(a, index = ["x", "y", "z"])
print(myvar)
Результат вывода следующий:
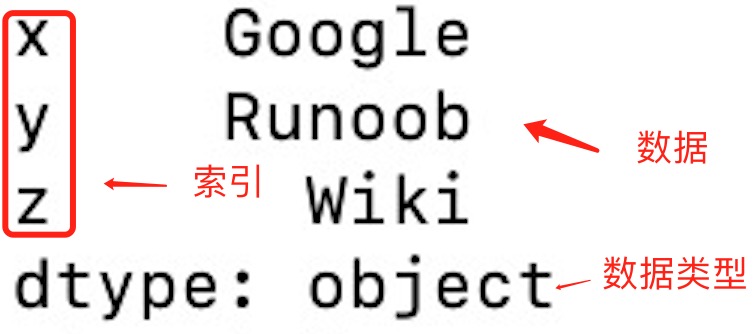
Чтение данных по значению индекса:
Пример
a = ["Google", "Example", "Wiki"]
myvar = pd.Series(a, index = ["x", "y", "z"])
print(myvar["y"])
Результат вывода следующий:
Example
Мы также можем использовать объекты ключ/значение, подобные словарям, для создания Series:
Пример
sites = {1: "Google", 2: "Example", 3: "Wiki"}
myvar = pd.Series(sites)
print(myvar)
Результат вывода следующий:
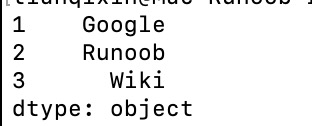
На рисунке выше ключи словаря становятся значениями индекса.
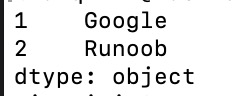
Если нам нужна только часть данных из словаря, достаточно указать индекс нужных данных, как в следующем примере:
Пример
sites = {1: "Google", 2: "Example", 3: "Wiki"}
myvar = pd.Series(sites, index = [1, 2])
print(myvar)
Результат вывода следующий:
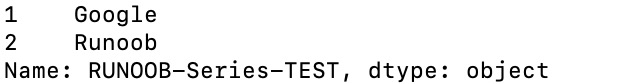
Задайте параметр name для Series:
Пример
sites = {1: "Google", 2: "Example", 3: "Wiki"}
myvar = pd.Series(sites, index = [1, 2], name="EXAMPLE-Series-TEST" )
print(myvar)
Методы Series
Ниже приведены некоторые часто используемые методы в Series:
| Название метода | Описание функций |
|---|---|
index | Получить индекс Series |
values | Получить часть данных Series (возвращает массив NumPy) |
head(n) | Вернуть первые n строк Series (по умолчанию 5) |
tail(n) | Возвращает последние n строк Series (по умолчанию — 5) |
dtype | Возвращает тип данных Series |
shape | Возвращает форму Series (количество строк) |
describe() | Возвращает статистическое описание Series (например, среднее, стандартное отклонение, минимум и т. д.) |
isnull() | Возвращает логическую Series, указывающую, является ли каждый элемент NaN |
notnull() | Возвращает логическую Series, показывающую, является ли каждый элемент отличным от NaN |
unique() | Возвращает уникальные значения в Series (удаление дубликатов) |
value_counts() | Возвращает количество вхождений каждого уникального значения в Series |
map(func) | Применяет указанную функцию к каждому элементу Series |
apply(func) | Применяет указанную функцию к каждому элементу Series, часто используется для пользовательских операций |
astype(dtype) | Преобразует Series в указанный тип |
sort_values() | Сортирует элементы в Series (сортировка по значению) |
sort_index() | Отсортировать индекс Series |
dropna() | Удалить пропущенные значения (NaN) из Series |
fillna(value) | Заполнить пропущенные значения (NaN) в Series |
replace(to_replace, value) | Заменить указанные значения в Series |
cumsum() | Вернуть накопленную сумму Series |
cumprod() | Вернуть накопленное произведение Series |
shift(periods) | Сдвинуть элементы в Series на указанное число шагов |
rank() | Вернуть ранги элементов в Series |
corr(other) | Вычислить корреляцию между Series и другой Series (коэффициент корреляции Пирсона) |
cov(other) | Вычислить ковариацию между Series и другой Series |
to_list() | Преобразовать Series в список Python |
to_frame() | Преобразовать Series в DataFrame |
iloc[] | Выбор данных по позиционному индексу |
loc[] | Выбрать данные по метке индекса |
Пример
# Создать Series
data = [1, 2, 3, 4, 5, 6]
index = ['a', 'b', 'c', 'd', 'e', 'f']
s = pd.Series(data, index=index)
# Просмотр основной информации
print("Индекс:", s.index)
print("Данные:", s.values)
print("Тип данных:", s.dtype)
print("Первые две строки данных:", s.head(2))
# Используйте функцию map, чтобы удвоить каждый элемент
s_doubled = s.map(lambda x: x * 2)
print("После удвоения элементов:", s_doubled)
# Вычислить сумму нарастающим итогом
cumsum_s = s.cumsum()
print("Сумма нарастающим итогом:", cumsum_s)
# Поиск пропущенных значений (здесь нет пропущенных значений, поэтому все возвращённые значения — False)
print("Проверка пропущенных значений:", s.isnull())
# Сортировка
sorted_s = s.sort_values()
print("Отсортированный Series:", sorted_s)
Результат вывода:
索引: Index(['a', 'b', 'c', 'd', 'e', 'f'], dtype='object')
数据: [1 2 3 4 5 6]
数据类型: int64
前两行数据: a    1
b    2
dtype: int64
元素加倍后: a     2
b     4
c     6
d     8
e    10
f    12
dtype: int64
累计求和: a     1
b     3
c     6
d    10
e    15
f    21
dtype: int64
缺失值判断: a    False
b    False
c    False
d    False
e    False
f    False
dtype: bool
排序后的 Series: a    1
b    2
c    3
d    4
e    5
f    6
dtype: int64
Подробнее о Series
Используйте список, словарь или массив, чтобы создать Series с индексом по умолчанию.
# 使用列表创建 Series
s = pd.Series([1, 2, 3, 4])

# 使用 NumPy 数组创建 Series
s = pd.Series(np.array([1, 2, 3, 4]))

# 使用字典创建 Series
s = pd.Series({'a': 1, 'b': 2, 'c': 3, 'd': 4})
Базовые операции:
# 指定索引创建 Series
s = pd.Series([1, 2, 3, 4], index=['a', 'b', 'c', 'd'])

# 获取值
value = s[2]  # 获取索引为2的值
print(s['a'])  # 返回索引标签 'a' 对应的元素

# 获取多个值
subset = s[1:4]  # 获取索引为1到3的值

# 使用自定义索引
value = s['b']  # 获取索引为'b'的值

# 索引和值的对应关系
for index, value in s.items():
    print(f"Index: {index}, Value: {value}")


# 使用切片语法来访问 Series 的一部分
print(s['a':'c'])  # 返回索引标签 'a' 到 'c' 之间的元素
print(s[:3])  # 返回前三个元素

# 为特定的索引标签赋值
s['a'] = 10  # 将索引标签 'a' 对应的元素修改为 10

# 通过赋值给新的索引标签来添加元素
s['e'] = 5  # 在 Series 中添加一个新的元素,索引标签为 'e'

# 使用 del 删除指定索引标签的元素。
del s['a']  # 删除索引标签 'a' 对应的元素

# 使用 drop 方法删除一个或多个索引标签,并返回一个新的 Series.
s_dropped = s.drop(['b'])  # 返回一个删除了索引标签 'b' 的新 Series
Базовая арифметика:
# 算术运算
result = series * 2  # 所有元素乘以2

# 过滤
filtered_series = series[series > 2]  # 选择大于2的元素

# 数学函数
import numpy as np
result = np.sqrt(series)  # 对每个元素取平方根
Вычисление статистических данных: используйте методы Series для вычисления описательных статистик.
print(s.sum())  # 输出 Series 的总和
print(s.mean())  # 输出 Series 的平均值
print(s.max())  # 输出 Series 的最大值
print(s.min())  # 输出 Series 的最小值
print(s.std())  # 输出 Series 的标准差
Атрибуты и методы:
# 获取索引
index = s.index

# 获取值数组
values = s.values

# 获取描述统计信息
stats = s.describe()

# 获取最大值和最小值的索引
max_index = s.idxmax()
min_index = s.idxmin()

# 其他属性和方法
print(s.dtype)   # 数据类型
print(s.shape)   # 形状
print(s.size)    # 元素个数
print(s.head())  # 前几个元素,默认是前 5 个
print(s.tail())  # 后几个元素,默认是后 5 个
print(s.sum())   # 求和
print(s.mean())  # 平均值
print(s.std())   # 标准差
print(s.min())   # 最小值
print(s.max())   # 最大值
Используйте логические выражения: фильтруйте Series по условиям.
print(s > 2) # 返回一个布尔 Series,其中的元素值大于 2
Просмотр типов данных: используйте атрибут dtype для просмотра типа данных Series.
print(s.dtype) # 输出 Series 的数据类型
Преобразование типов данных: используйте метод astype для преобразования Series в другой тип данных.
s = s.astype('float64') # 将 Series 中的所有元素转换为 float64 类型
Примечания:
SeriesДанные в нём упорядочены.- Вы можете рассматривать
Seriesего как одномерный массив с индексом. - Индекс может быть уникальным, но это не обязательно.
- Данные могут быть скалярами, списками, массивами NumPy и т. д.