Structures de données Pandas - Series
Series est une structure de données centrale dans Pandas, semblable à un tableau unidimensionnel, avec des données et un index.
Series peut stocker n'importe quel type de données (entiers, flottants, chaînes de caractères, etc.) et accéder aux éléments par des étiquettes (index).
La structure de données de Series est très utile car elle peut gérer divers types de données tout en conservant des capacités efficaces de manipulation des données, telles que l'accès et la manipulation rapides des données via des étiquettes.
Caractéristiques de Series :
Tableau unidimensionnel :Chaque élément d'une Series a une valeur d'index correspondante.
Index :Chaque élément de données est accessible via une étiquette (index). Par défaut, l'index est un entier commençant à 0, mais vous pouvez également personnaliser l'index.
Types de données :
SeriesPeut contenir des éléments de différents types de données, notamment des entiers, des nombres à virgule flottante, des chaînes de caractères, des objets Python, etc.Immuabilité de la taille :La taille d'une Series est fixe après sa création, mais elle peut être modifiée via certaines opérations (comme append ou delete).
Opérations :Series prend en charge diverses opérations, telles que les opérations mathématiques, l'analyse statistique, le traitement des chaînes de caractères, etc.
Données manquantes :Series peut contenir des données manquantes. Pandas utilise NaN (Not a Number) pour représenter une valeur manquante ou inexistante.
Alignement automatique :Lors de l'exécution d'opérations sur plusieurs Series, Pandas aligne automatiquement les données en fonction de l'index, ce qui rend le traitement des données plus efficace.
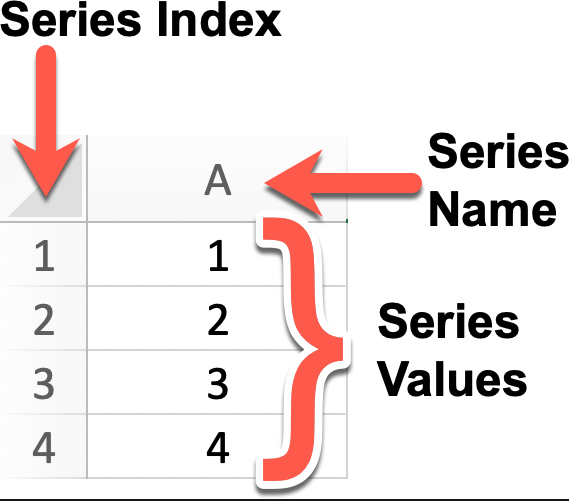
Exemple
# Créer un objet Series avec le nom 'A' et les valeurs 1, 2, 3, 4
# L'index par défaut est 0, 1, 2, 3
series = pd.Series([1, 2, 3, 4], name='A')
# Afficher l'objet Series
print(series)
# Si vous souhaitez définir explicitement l'index, vous pouvez procéder comme ceci :
custom_index = [1, 2, 3, 4] # Index personnalisé
series_with_index = pd.Series([1, 2, 3, 4], index=custom_index, name='A')
# Afficher l'objet Series avec un index personnalisé
print(series_with_index)
Le résultat de sortie est:
0    1
1    2
2    3
3    4
Name: A, dtype: int64
1    1
2    2
3    3
4    4
Name: A, dtype: int64
Series est une structure de données de base dans Pandas, similaire à un tableau ou une liste à une dimension, mais avec des étiquettes (index), ce qui rend les données plus flexibles lors du traitement et de l'analyse.
Voici une introduction détaillée à Series dans Pandas.
Créer une Series
Vous pouvez utiliser le constructeur pd.Series() pour créer un objet Series en passant un tableau de données (qui peut être une liste, un tableau NumPy, etc.) et un tableau d'index facultatif.
pandas.Series(data=None, index=None, dtype=None, name=None, copy=False, fastpath=False)
Description du paramètre :
data: La partie données de la Series, peut être une liste, un tableau, un dictionnaire, une valeur scalaire, etc. Si ce paramètre n'est pas fourni, une Series vide est créée.index: La partie index de la Series, utilisée pour étiqueter les données. Peut être une liste, un tableau, un objet index, etc. Si ce paramètre n'est pas fourni, un index entier par défaut est créé.dtype: Spécifie le type de données de la Series. Peut être un type de données NumPy, tel quenp.int64、np.float64etc. Si ce paramètre n'est pas fourni, le type de données est déduit automatiquement à partir des données.name: Le nom de la Series, utilisé pour identifier l'objet Series. Si ce paramètre est fourni, l'objet Series créé aura le nom spécifié.copy: Indique s'il faut copier les données. La valeur par défaut est False, ce qui signifie qu'aucune donnée n'est copiée. Si la valeur est True, les données d'entrée sont copiées.fastpath: Indique s'il faut activer le chemin rapide. La valeur par défaut est False. L'activation du chemin rapide peut améliorer les performances dans certains cas.
Créer un exemple simple de Series :
Exemple
a = [1, 2, 3]
myvar = pd.Series(a)
print(myvar)
Le résultat de sortie est le suivant :
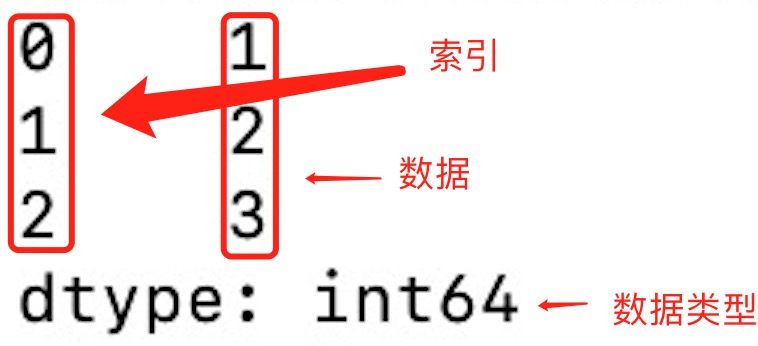
D'après la figure ci-dessus, si aucun index n'est spécifié, les valeurs d'index commencent à 0. Nous pouvons lire les données en fonction de la valeur d'index :
Exemple
a = [1, 2, 3]
myvar = pd.Series(a)
print(myvar[1])
Le résultat de sortie est le suivant :
2
Nous pouvons spécifier les valeurs d'index, comme dans l'exemple suivant :
Exemple
a = ["Google", "Example", "Wiki"]
myvar = pd.Series(a, index = ["x", "y", "z"])
print(myvar)
Le résultat de sortie est le suivant :
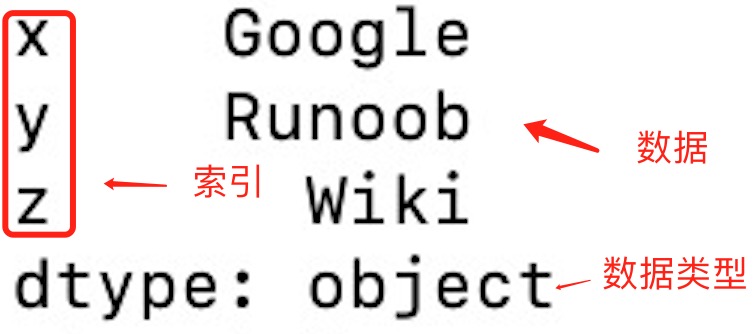
Lire les données par valeur d'index :
Exemple
a = ["Google", "Example", "Wiki"]
myvar = pd.Series(a, index = ["x", "y", "z"])
print(myvar["y"])
Le résultat de sortie est le suivant :
Example
Nous pouvons également utiliser des objets clé/valeur, similaires aux dictionnaires, pour créer une Series :
Exemple
sites = {1: "Google", 2: "Example", 3: "Wiki"}
myvar = pd.Series(sites)
print(myvar)
Le résultat de sortie est le suivant :
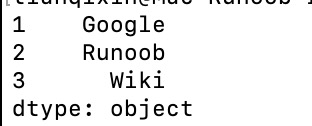
D'après la figure ci-dessus, les clés du dictionnaire deviennent les valeurs de l'index.
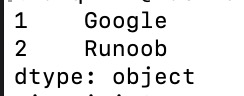
Si nous n'avons besoin que d'une partie des données du dictionnaire, il nous suffit de spécifier l'index des données requises, comme dans l'exemple suivant :
Exemple
sites = {1: "Google", 2: "Example", 3: "Wiki"}
myvar = pd.Series(sites, index = [1, 2])
print(myvar)
Le résultat de sortie est le suivant :
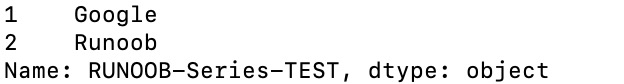
Définir le paramètre name de la Series :
Exemple
sites = {1: "Google", 2: "Example", 3: "Wiki"}
myvar = pd.Series(sites, index = [1, 2], name="EXAMPLE-Series-TEST" )
print(myvar)
Méthodes des Series
Voici quelques méthodes couramment utilisées dans les Series :
| Nom de la méthode | Description de la fonction |
|---|---|
index | Obtenir l'index de la Series |
values | Obtenir la partie de données de la Series (renvoie un tableau NumPy) |
head(n) | Retourne les n premières lignes de la Series (par défaut : 5) |
tail(n) | Renvoie les n dernières lignes de la Series (par défaut : 5) |
dtype | Renvoie le type de données de la Series |
shape | Renvoie la forme de la Series (nombre de lignes) |
describe() | Renvoie une description statistique de la Series (telle que la moyenne, l'écart-type, le minimum, etc.) |
isnull() | Renvoie une Series booléenne indiquant si chaque élément est NaN |
notnull() | Renvoie une Series booléenne indiquant si chaque élément n'est pas NaN |
unique() | Renvoie les valeurs uniques de la Series (dédoublonnage) |
value_counts() | Renvoie le nombre d'occurrences de chaque valeur unique de la Series |
map(func) | Applique la fonction spécifiée à chaque élément de la Series |
apply(func) | Applique la fonction spécifiée à chaque élément de la Series, souvent utilisée pour des opérations personnalisées |
astype(dtype) | Convertit la Series en un type spécifié |
sort_values() | Trie les éléments de la Series (tri par valeur) |
sort_index() | Trier l'index de la Series |
dropna() | Supprimer les valeurs manquantes (NaN) de la Series |
fillna(value) | Remplir les valeurs manquantes (NaN) dans la Series |
replace(to_replace, value) | Remplacer les valeurs spécifiées dans la Series |
cumsum() | Retourner la somme cumulée de la Series |
cumprod() | Retourner le produit cumulé de la Series |
shift(periods) | Décaler les éléments de la Series d'un nombre spécifié de pas |
rank() | Retourner les rangs des éléments de la Series |
corr(other) | Calculer la corrélation entre une Series et une autre Series (coefficient de corrélation de Pearson) |
cov(other) | Calculer la covariance entre une Series et une autre Series |
to_list() | Convertir la Series en une liste Python |
to_frame() | Convertir la Series en un DataFrame |
iloc[] | Sélectionner les données par index positionnel |
loc[] | Sélectionner des données par index d'étiquette |
Exemple
# Créer une Series
data = [1, 2, 3, 4, 5, 6]
index = ['a', 'b', 'c', 'd', 'e', 'f']
s = pd.Series(data, index=index)
# Afficher les informations de base
print("Index :", s.index)
print("Données :", s.values)
print("Type de données :", s.dtype)
print("Deux premières lignes de données :", s.head(2))
# Utiliser la fonction map pour doubler chaque élément
s_doubled = s.map(lambda x: x * 2)
print("Après avoir doublé les éléments :", s_doubled)
# Calculer la somme cumulative
cumsum_s = s.cumsum()
print("Somme cumulative :", cumsum_s)
# Rechercher les valeurs manquantes (il n'y a pas de valeurs manquantes ici, donc toutes les valeurs retournées sont False)
print("Vérification des valeurs manquantes :", s.isnull())
# Trier
sorted_s = s.sort_values()
print("Series triée :", sorted_s)
Le résultat de sortie est:
索引: Index(['a', 'b', 'c', 'd', 'e', 'f'], dtype='object')
数据: [1 2 3 4 5 6]
数据类型: int64
前两行数据: a    1
b    2
dtype: int64
元素加倍后: a     2
b     4
c     6
d     8
e    10
f    12
dtype: int64
累计求和: a     1
b     3
c     6
d    10
e    15
f    21
dtype: int64
缺失值判断: a    False
b    False
c    False
d    False
e    False
f    False
dtype: bool
排序后的 Series: a    1
b    2
c    3
d    4
e    5
f    6
dtype: int64
En savoir plus sur Series
Utilisez une liste, un dictionnaire ou un tableau pour créer une Series avec un index par défaut.
# 使用列表创建 Series
s = pd.Series([1, 2, 3, 4])

# 使用 NumPy 数组创建 Series
s = pd.Series(np.array([1, 2, 3, 4]))

# 使用字典创建 Series
s = pd.Series({'a': 1, 'b': 2, 'c': 3, 'd': 4})
Opérations de base :
# 指定索引创建 Series
s = pd.Series([1, 2, 3, 4], index=['a', 'b', 'c', 'd'])

# 获取值
value = s[2]  # 获取索引为2的值
print(s['a'])  # 返回索引标签 'a' 对应的元素

# 获取多个值
subset = s[1:4]  # 获取索引为1到3的值

# 使用自定义索引
value = s['b']  # 获取索引为'b'的值

# 索引和值的对应关系
for index, value in s.items():
    print(f"Index: {index}, Value: {value}")


# 使用切片语法来访问 Series 的一部分
print(s['a':'c'])  # 返回索引标签 'a' 到 'c' 之间的元素
print(s[:3])  # 返回前三个元素

# 为特定的索引标签赋值
s['a'] = 10  # 将索引标签 'a' 对应的元素修改为 10

# 通过赋值给新的索引标签来添加元素
s['e'] = 5  # 在 Series 中添加一个新的元素,索引标签为 'e'

# 使用 del 删除指定索引标签的元素。
del s['a']  # 删除索引标签 'a' 对应的元素

# 使用 drop 方法删除一个或多个索引标签,并返回一个新的 Series.
s_dropped = s.drop(['b'])  # 返回一个删除了索引标签 'b' 的新 Series
Arithmétique de base :
# 算术运算
result = series * 2  # 所有元素乘以2

# 过滤
filtered_series = series[series > 2]  # 选择大于2的元素

# 数学函数
import numpy as np
result = np.sqrt(series)  # 对每个元素取平方根
Calculez des données statistiques : utilisez les méthodes de Series pour calculer des statistiques descriptives.
print(s.sum())  # 输出 Series 的总和
print(s.mean())  # 输出 Series 的平均值
print(s.max())  # 输出 Series 的最大值
print(s.min())  # 输出 Series 的最小值
print(s.std())  # 输出 Series 的标准差
Attributs et méthodes :
# 获取索引
index = s.index

# 获取值数组
values = s.values

# 获取描述统计信息
stats = s.describe()

# 获取最大值和最小值的索引
max_index = s.idxmax()
min_index = s.idxmin()

# 其他属性和方法
print(s.dtype)   # 数据类型
print(s.shape)   # 形状
print(s.size)    # 元素个数
print(s.head())  # 前几个元素,默认是前 5 个
print(s.tail())  # 后几个元素,默认是后 5 个
print(s.sum())   # 求和
print(s.mean())  # 平均值
print(s.std())   # 标准差
print(s.min())   # 最小值
print(s.max())   # 最大值
Utilisez des expressions booléennes : filtrez une Series en fonction de conditions.
print(s > 2) # 返回一个布尔 Series,其中的元素值大于 2
Afficher les types de données : utilisez l'attribut dtype pour afficher le type de données d'une Series.
print(s.dtype) # 输出 Series 的数据类型
Convertir les types de données : utilisez la méthode astype pour convertir une Series en un autre type de données.
s = s.astype('float64') # 将 Series 中的所有元素转换为 float64 类型
Notes :
SeriesLes données qu'elle contient sont ordonnées.- Vous pouvez le considérer
Seriescomme un tableau à une dimension avec un index. - L'index peut être unique, mais ce n'est pas obligatoire.
- Les données peuvent être des scalaires, des listes, des tableaux NumPy, etc.