Pandas-Datenstrukturen - DataFrame
DataFrame ist eine weitere zentrale Datenstruktur in Pandas, ähnlich einer zweidimensionalen Tabelle oder einer Datentabelle in einer Datenbank.
DataFrame ist eine tabellarische Datenstruktur, die eine Menge geordneter Spalten enthält, von denen jede unterschiedliche Werttypen haben kann (numerische, Zeichenfolgen-, boolesche Werte).
DataFrame hat sowohl Zeilen- als auch Spaltenindizes; es kann als ein Wörterbuch aus Series (mit gemeinsamem Index) angesehen werden.
DataFrame bietet verschiedene Funktionen für Datenzugriff, Filterung, Aufteilung, Zusammenführung, Umformung, Aggregation und Transformationsoperationen.
DataFrame ist eine sehr flexible und leistungsstarke Datenstruktur, die häufig für Aufgaben wie Datenanalyse, Bereinigung, Transformation und Visualisierung verwendet wird.
DataFrame-Merkmale:
Zweidimensionale Struktur:
DataFrameEs ist eine zweidimensionale Tabelle, die als Excel-Tabelle oder SQL-Tabelle mit Zeilen und Spalten betrachtet werden kann. Sie kann als mehrereSeriesObjekte, die zu einem Wörterbuch zusammengesetzt sind, angesehen werden.Spaltendatentypen:Verschiedene Spalten können unterschiedliche Datentypen enthalten, wie Ganzzahlen, Gleitkommazahlen, Zeichenketten oder Python-Objekte.
-
Index:
DataFrameKann Zeilenindizes und Spaltenindizes haben, ähnlich wie Zeilennummern und Spaltenbeschriftungen in Excel. -
Variable Größe: Kann Spalten hinzufügen und löschen, ähnlich wie ein Wörterbuch in Python.
-
Automatische Ausrichtung: Bei der Durchführung arithmetischer Operationen oder Datenausrichtungsoperationen,
DataFrameDie Indizes werden automatisch ausgerichtet. -
Umgang mit fehlenden Daten:
DataFrameKann fehlende Daten enthalten, Pandas verwendetNaN(Keine Zahl), um sie darzustellen. -
Datenoperationen: Unterstützt Operationen wie Daten-Slicing, Indexierung und Teilmengenaufteilung.
-
Unterstützung für Zeitreihen:
DataFrameBietet spezielle Unterstützung für Zeitreihendaten, was einfaches Slicing, Indexierung und Manipulation zeitbasierter Daten ermöglicht. -
Umfangreiche Datenzugriffsfunktionalität: Durch die
.loc、.ilocund.query()Methode können Sie flexibel auf Daten zugreifen und sie filtern. -
Flexible Datenverarbeitungsfunktionalität: Einschließlich Datenzusammenführung, Umformung, Pivotierung, Gruppierung und Aggregation.
-
Datenvisualisierung: Obwohl
DataFrameselbst kein Visualisierungswerkzeug ist, kann es mit Visualisierungsbibliotheken wie Matplotlib oder Seaborn kombiniert werden, um Datenvisualisierung durchzuführen. -
Effiziente Dateneingabe/-ausgabe: Kann Daten bequem lesen und schreiben und unterstützt mehrere Formate wie CSV, Excel, SQL-Datenbanken und HDF5.
-
Deskriptive Statistik: Bietet eine Reihe von Methoden zur Berechnung deskriptiver Statistiken, wie etwa
.describe()、.mean()、.sum()usw. -
Flexible Datenausrichtung und Integration: Kann leicht mit anderen
DataFrameoderSeriesObjekten kombiniert werden, um Zusammenführungs-, Verknüpfungs- oder Aktualisierungsvorgänge durchzuführen. -
Transformationsfunktionalität: Kann Werte im Datensatz transformieren, beispielsweise mithilfe der
.apply()Methode, um benutzerdefinierte Funktionen anzuwenden. -
Rolling-Window- und Zeitreihenanalyse: Unterstützt Rolling-Window-Statistiken und Zeitreihenanalyse für Datensätze.
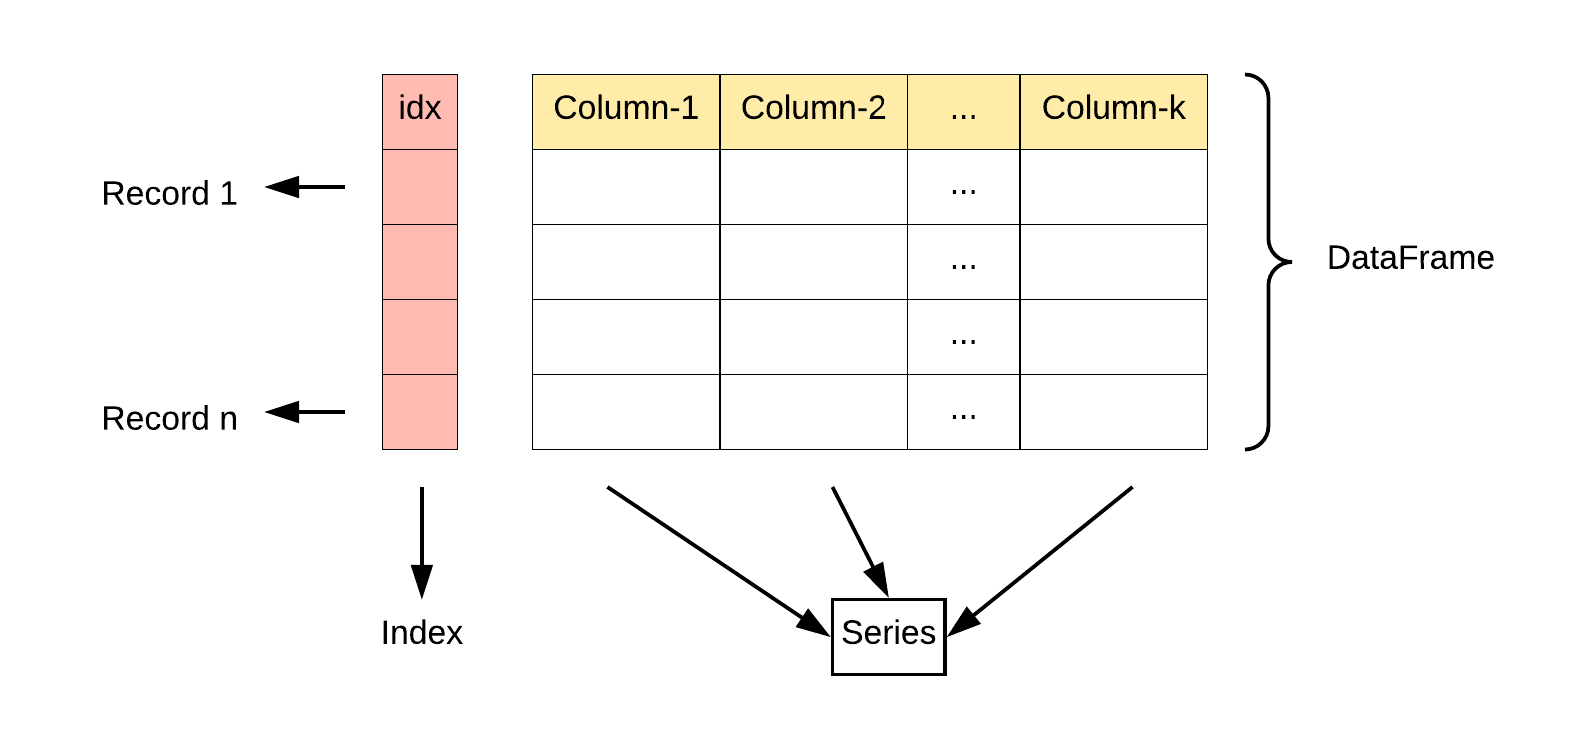
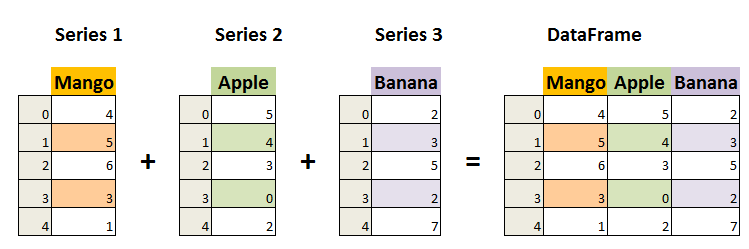
Der DataFrame-Konstruktor lautet wie folgt:
pandas.DataFrame(data=None, index=None, columns=None, dtype=None, copy=False)
Parameter description:
data: Der Datenteil des DataFrame, der ein Wörterbuch, ein zweidimensionales Array, Series, DataFrame oder ein anderes Objekt sein kann, das in einen DataFrame konvertiert werden kann. Wenn dieser Parameter nicht angegeben wird, wird ein leerer DataFrame erstellt.index: Der Zeilenindex des DataFrame, der zum Identifizieren jeder Datenzeile verwendet wird. Er kann eine Liste, ein Array, ein Indexobjekt usw. sein. Wenn dieser Parameter nicht angegeben wird, wird ein standardmäßiger ganzzahliger Index erstellt.columns: Der Spaltenindex des DataFrame, der zum Identifizieren jeder Datenspalte verwendet wird. Er kann eine Liste, ein Array, ein Indexobjekt usw. sein. Wenn dieser Parameter nicht angegeben wird, wird ein standardmäßiger ganzzahliger Index erstellt.dtype: Gibt den Datentyp des DataFrame an. Er kann ein NumPy-Datentyp sein, wie z. B.np.int64、np.float64usw. Wenn dieser Parameter nicht angegeben wird, wird der Datentyp automatisch basierend auf den Daten abgeleitet.copy: Ob Daten kopiert werden sollen. Der Standardwert ist False, was bedeutet, dass Daten nicht kopiert werden. Wenn auf True gesetzt, werden die Eingabedaten kopiert.
Pandas DataFrame ist eine zweidimensionale Array-Struktur, ähnlich einem zweidimensionalen Array.
Beispiel - Erstellen mit einer Liste
data = [['Google', 10], ['Example', 12], ['Wiki', 13]]
# DataFrame erstellen
df = pd.DataFrame(data, columns=['Site', 'Age'])
# Verwenden Sie die astype-Methode, um den Datentyp jeder Spalte festzulegen
df['Site'] = df['Site'].astype(str)
df['Age'] = df['Age'].astype(float)
print(df)
Sie können auch ein Dictionary verwenden, um eines zu erstellen:
Beispiel - Erstellen mit einem Dictionary
data = {'Site':['Google', 'Example', 'Wiki'], 'Age':[10, 12, 13]}
df = pd.DataFrame(data)
print (df)
Das Ausgabeergebnis ist wie folgt:
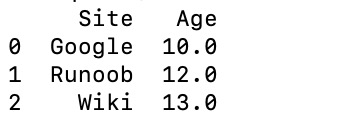
Das folgende Beispiel verwendet ndarrays zum Erstellen. Die Längen der ndarrays müssen gleich sein. Wenn ein Index übergeben wird, sollte die Länge des Index der Länge der Arrays entsprechen. Wenn kein Index übergeben wird, ist der Index standardmäßig range(n), wobei n die Länge der Arrays ist.
Für ndarrays können Sie auf Folgendes verweisen:NumPy Ndarray-Objekt
Beispiel - Erstellen mit ndarrays
import pandas as pd
# Erstellen Sie ein zweidimensionales ndarray, das Website und Alter enthält
ndarray_data = np.array([
['Google', 10],
['Example', 12],
['Wiki', 13]
])
# Verwenden Sie den DataFrame-Konstruktor, um ein DataFrame zu erstellen
df = pd.DataFrame(ndarray_data, columns=['Site', 'Age'])
# DataFrame ausgeben
print(df)
Das Ausgabeergebnis ist wie folgt:
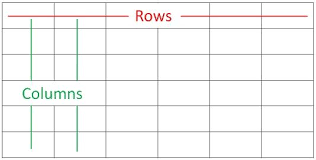
An der obigen Ausgabe können wir erkennen, dass der DataFrame-Datentyp eine Tabelle ist, die Zeilen und Spalten enthält:
Sie können auch ein Wörterbuch (Schlüssel/Wert) verwenden, wobei die Schlüssel des Wörterbuchs die Spaltennamen sind:
Beispiel - Erstellen mit einem Dictionary
data = [{'a': 1, 'b': 2},{'a': 5, 'b': 10, 'c': 20}]
df = pd.DataFrame(data)
print (df)
Das Ausgabeergebnis ist:
   a   b     c
0  1   2   NaN
1  5  10  20.0
Der Teil ohne entsprechende Daten istNaN。
Pandas kann dasloc-Attribut verwenden, um die Daten einer angegebenen Zeile zurückzugeben. Wenn kein Index festgelegt ist, ist der Index der ersten Zeile0, der Index der zweiten Zeile ist1, und so weiter:
Beispiel
data = {
"calories": [420, 380, 390],
"duration": [50, 40, 45]
}
# Daten in ein DataFrame-Objekt laden
df = pd.DataFrame(data)
# Die erste Zeile zurückgeben
print(df.loc[0])
# Die zweite Zeile zurückgeben
print(df.loc[1])
Das Ausgabeergebnis ist wie folgt:
calories    420
duration     50
Name: 0, dtype: int64
calories    380
duration     40
Name: 1, dtype: int64
Hinweis:Das zurückgegebene Ergebnis ist tatsächlich ein Pandas-Series-Datenobjekt.
Sie können auch mehrere Datenzeilen zurückgeben, und zwar mit dem[[ ... ]]Format, wobei...die Indizes jeder Zeile sind, durch Kommas getrennt:
Beispiel
data = {
"calories": [420, 380, 390],
"duration": [50, 40, 45]
}
# Daten in ein DataFrame-Objekt laden
df = pd.DataFrame(data)
# Die erste und zweite Zeile zurückgeben
print(df.loc[[0, 1]])
Das Ausgabeergebnis ist:
   calories  duration
0       420        50
1       380        40
Hinweis:Das zurückgegebene Ergebnis ist tatsächlich ein Pandas-DataFrame-Datenobjekt.
Wir können die Indexwerte angeben, wie im folgenden Beispiel:
Beispiel
data = {
"calories": [420, 380, 390],
"duration": [50, 40, 45]
}
df = pd.DataFrame(data, index = ["day1", "day2", "day3"])
print(df)
Das Ausgabeergebnis ist:
      calories  duration
day1       420        50
day2       380        40
day3       390        45
Pandas kann dasloc-Attribut verwenden, um die Zeile zurückzugeben, die dem angegebenen Index entspricht:
Beispiel
data = {
"calories": [420, 380, 390],
"duration": [50, 40, 45]
}
df = pd.DataFrame(data, index = ["day1", "day2", "day3"])
# Index angeben
print(df.loc["day2"])
Das Ausgabeergebnis ist:
calories    380
duration     40
Name: day2, dtype: int64
DataFrame-Methoden
Die gängigen Operationen und Methoden von DataFrame sind in der folgenden Tabelle aufgeführt:
| Methodenname | Funktionsbeschreibung |
|---|---|
head(n) | Gibt die ersten n Zeilen des DataFrame zurück (standardmäßig die ersten 5 Zeilen) |
tail(n) | Gibt die letzten n Zeilen des DataFrame zurück (standardmäßig die letzten 5 Zeilen) |
info() | Zeigt kurze Informationen über das DataFrame an, einschließlich Spaltennamen, Datentypen, Anzahl der Nicht-Null-Werte usw. |
describe() | Gibt statistische Informationen für numerische Spalten des DataFrame zurück, wie Mittelwert, Standardabweichung, Minimum usw. |
shape | Gibt die Anzahl der Zeilen und Spalten des DataFrame zurück (Zeilen, Spalten) |
columns | Gibt alle Spaltennamen des DataFrame zurück |
index | Gibt den Zeilenindex des DataFrame zurück |
dtypes | Den Datentyp jeder Spalte zurückgeben |
sort_values(by) | Nach einer angegebenen Spalte sortieren |
sort_index() | Nach Zeilenindex sortieren |
dropna() | Zeilen oder Spalten mit fehlenden Werten (NaN) verwerfen |
fillna(value) | Fehlende Werte mit einem angegebenen Wert füllen |
isnull() | Auf fehlende Werte prüfen, gibt ein boolesches DataFrame zurück |
notnull() | Auf nicht fehlende Werte prüfen, gibt ein boolesches DataFrame zurück |
loc[] | Daten nach Label-Index auswählen |
iloc[] | Daten nach Positionsindex auswählen |
at[] | Auf ein einzelnes Element in einem DataFrame zugreifen (mehrloc[]effizient) |
iat[] | Auf ein einzelnes Element in einem DataFrame zugreifen (mehriloc[]effizient) |
apply(func) | Eine Funktion auf ein DataFrame oder eine Series anwenden |
applymap(func) | Eine Funktion auf jedes Element eines DataFrame anwenden (nur für DataFrame) |
groupby(by) | Gruppierungsoperation, verwendet, um nach einer Spalte für zusammenfassende Statistiken zu gruppieren |
pivot_table() | Eine Pivot-Tabelle erstellen |
merge() | Mehrere DataFrames zusammenführen (ähnlich der SQL-JOIN-Operation) |
concat() | Mehrere DataFrames nach Zeilen oder Spalten verketten |
to_csv() | DataFrame in eine CSV-Datei exportieren |
to_excel() | DataFrame in eine Excel-Datei exportieren |
to_json() | DataFrame in das JSON-Format exportieren |
to_sql() | DataFrame in eine SQL-Datenbank exportieren |
query() | DataFrame mit SQL-ähnlicher Syntax abfragen |
duplicated() | Ein boolesches DataFrame zurückgeben, das angibt, ob jede Zeile ein Duplikat ist |
drop_duplicates() | Doppelte Zeilen entfernen |
set_index() | Den Index des DataFrame festlegen |
reset_index() | Den Index des DataFrame zurücksetzen |
transpose() | Das DataFrame transponieren (Zeilen und Spalten vertauschen) |
Beispiel
# DataFrame erstellen
data = {
'Name': ['Alice', 'Bob', 'Charlie', 'David'],
'Age': [25, 30, 35, 40],
'City': ['New York', 'Los Angeles', 'Chicago', 'Houston']
}
df = pd.DataFrame(data)
# Die ersten beiden Datenzeilen anzeigen
print(df.head(2))
# Grundlegende Informationen zum DataFrame anzeigen
print(df.info())
# Deskriptive Statistiken abrufen
print(df.describe())
# Nach Alter sortieren
df_sorted = df.sort_values(by='Age', ascending=False)
print(df_sorted)
# Angegebene Spalten auswählen
print(df[['Name', 'Age']])
# Zeilen nach Index auswählen
print(df.iloc[1:3]) # Zeilen 2 bis 3 auswählen (nach Position)
# Zeilen nach Label auswählen
print(df.loc[1:2]) # Zeilen 2 bis 3 auswählen (nach Label)
# Gruppenstatistiken berechnen (nach Stadt gruppieren, Durchschnittsalter berechnen)
print(df.groupby('City')['Age'].mean())
# Fehlende Werte behandeln (fehlende Werte auffüllen)
df['Age'] = df['Age'].fillna(30)
# In CSV-Datei exportieren
df.to_csv('output.csv', index=False)
Die Ausgabe ist:
# 查看前两行数据
     Name  Age         City
0   Alice   25     New York
1     Bob   30  Los Angeles

# 查看 DataFrame 的基本信息
<class 'pandas.core.frame.DataFrame'>
RangeIndex: 4 entries, 0 to 3
Data columns (total 3 columns):
 #   Column  Non-Null Count  Dtype
---  ------  --------------  -----
 0   Name    4 non-null      object
 1   Age     4 non-null      int64
 2   City    4 non-null      object
dtypes: int64(1), object(2)
memory usage: 148.0+ bytes

# 获取描述统计信息
             Age
count   4.000000
mean   32.500000
std     6.454972
min    25.000000
25%    27.500000
50%    32.500000
75%    37.500000
max    40.000000

# 按年龄排序
      Name  Age         City
3    David   40     Houston
2  Charlie   35      Chicago
1      Bob   30  Los Angeles
0    Alice   25     New York

# 按标签选择行
      Name  Age         City
1     Bob   30  Los Angeles
2  Charlie   35      Chicago

# 计算分组统计(按城市分组,计算平均年龄)
City
Chicago        35.0
Houston        40.0
Los Angeles    30.0
New York       25.0
Name: Age, dtype: float64
Weitere DataFrame-Details
Ein DataFrame erstellen
Aus Dictionary erstellen:Die Schlüssel des Dictionary werden zu Spaltennamen, und die Werte werden zu Spaltendaten.
Beispiel
# DataFrame aus einem Dictionary erstellen
df = pd.DataFrame({'Column1': [1, 2, 3], 'Column2': [4, 5, 6]})
Aus einer Liste von Listen erstellen:Die äußere Liste repräsentiert Zeilen, und die inneren Listen repräsentieren Spalten.
# DataFrame aus einer Liste von Listen erstellenBeispiel
columns=['Column1', 'Column2', 'Column3'])
Aus einem NumPy-Array erstellen:Stellen Sie ein zweidimensionales NumPy-Array bereit.
Beispiel
# DataFrame aus einem NumPy-Array erstellen
df = pd.DataFrame(np.array([[1, 2, 3], [4, 5, 6], [7, 8, 9]]))
DataFrame aus Series erstellen:Durchpd.Series()erstellen.
Beispiel
s1 = pd.Series(['Alice', 'Bob', 'Charlie'])
s2 = pd.Series([25, 30, 35])
s3 = pd.Series(['New York', 'Los Angeles', 'Chicago'])
df = pd.DataFrame({'Name': s1, 'Age': s2, 'City': s3})
DataFrame-Eigenschaften und -Methoden
DataFrame-Objekte besitzen viele Attribute und Methoden für Datenmanipulation, Indexierung und Verarbeitung, wie z. B.: shape, columns, index, head(), tail(), info(), describe(), mean(), sum(), usw.
Beispiel
print(df.shape) # Form
print(df.columns) # Spaltennamen
print(df.index) # Index
print(df.head()) # Erste paar Datenzeilen, Standard sind die ersten 5 Zeilen
print(df.tail()) # Letzte paar Datenzeilen, Standard sind die letzten 5 Zeilen
print(df.info()) # Dateninformationen
print(df.describe())# Deskriptive Statistik
print(df.mean()) # Mittelwert berechnen
print(df.sum()) # Summe berechnen
Zugriff auf DataFrame-Elemente
Auf Spalten zugreifen:Verwende Spaltennamen als Attribute oder über.loc[]、.iloc[]zugreifen, und du kannst auch Label- oder Positionsindizierung verwenden.
Beispiel
print(df['Column1'])
# Zugriff über das Attribut
print(df.Name)
# Zugriff über .loc[]
print(df.loc[:, 'Column1'])
# Zugriff über .iloc[]
print(df.iloc[:, 0]) # Angenommen, 'Column1' ist die erste Spalte
# Zugriff auf ein einzelnes Element
print(df['Name'][0])
Zugriff auf Zeilen:Verwenden Sie Zeilenbeschriftungen und den.loc[]Zugriff.
Beispiel
print(df.loc[0, 'Column1'])
Ändern eines DataFrame
Spaltendaten ändern:Weisen Sie den Spalten direkt Werte zu.
df['Column1'] = [10, 11, 12]
Neue Spalte hinzufügen:Weisen Sie der neuen Spalte Werte zu.
df['NewColumn'] = [100, 200, 300]
Neue Zeile hinzufügen:Verwenden Sie die Methoden loc, append oder concat.
Beispiel
df.loc[3] = [13, 14, 15, 16]
# Neue Zeile am Ende mit append hinzufügen
new_row = {'Column1': 13, 'Column2': 14, 'NewColumn': 16}
df = df.append(new_row, ignore_index=True)
Hinweis:append()Die Methode wurde in pandas Version 1.4.0 als veraltet markiert und wird in zukünftigen Versionen entfernt. Die offizielle Empfehlung ist,concat()als alternative Methode zur Datenverkettung zu verwenden.
Die Methode concat() wird verwendet, um zwei oder mehr DataFrames zusammenzuführen. Wenn Sie einem anderen DataFrame eine Zeile hinzufügen möchten, können Sie die neue Zeile als neuen DataFrame behandeln und dann concat() verwenden:
Beispiel
new_row = pd.DataFrame([[4, 7]], columns=['A', 'B']) # Erstellen eines DataFrame, der nur die neue Zeile enthält
df = pd.concat([df, new_row], ignore_index=True) # Die neue Zeile zum ursprünglichen DataFrame hinzufügen
print(df)
Löschen von DataFrame-Elementen
Spalten löschen:Verwenden Sie die Methode drop.
df_dropped = df.drop('Column1', axis=1)
Zeilen löschen:Verwenden Sie ebenfalls die Methode drop.
df_dropped = df.drop(0) # 删除索引为 0 的行
Statistische Analyse von DataFrames
Deskriptive Statistik:Verwenden Sie.describe(), um die statistische Zusammenfassung numerischer Spalten anzuzeigen.
df.describe()
Statistiken berechnen:Verwenden Sie Aggregatfunktionen wie.sum()、.mean()、.max()usw.
df['Column1'].sum()
df.mean()
DataFrame-Indizierungsoperationen
Index zurücksetzen:Verwenden Sie.reset_index()。
df_reset = df.reset_index(drop=True)
Index festlegen:Verwenden Sie.set_index()。
df_set = df.set_index('Column1')
Boolesche Indizierung von DataFrames
Boolesche Ausdrücke verwenden: Den DataFrame anhand von Bedingungen filtern.
df[df['Column1'] > 2]
DataFrame-Datentypen
Datentypen anzeigen: Verwenden Sie das Attributdtypes.
df.dtypes
Datentypen konvertieren:Verwenden Sie die Methodeastype.
df['Column1'] = df['Column1'].astype('float64')
Zusammenführen und Aufteilen von DataFrames
Zusammenführen:Verwenden Sie die Methodeconcatodermerge.
# 纵向合并
pd.concat([df1, df2], ignore_index=True)

# 横向合并
pd.merge(df1, df2, on='Column1')
Aufteilen:Verwenden Siepivot, meltoder benutzerdefinierte Funktionen.
# 长格式转宽格式
df_pivot = df.pivot(index='Column1', columns='Column2', values='Column3')

# 宽格式转长格式
df_melt = df.melt(id_vars='Column1', value_vars=['Column2', 'Column3'])
Indizierung und Slicing
DataFrame unterstützt Indizierungs- und Slicing-Operationen für Zeilen und Spalten.
Beispiel
print(df[['Name', 'Age']]) # Mehrere Spalten extrahieren
print(df[1:3]) # Zeilen slicen
print(df.loc[:, 'Name']) # Eine einzelne Spalte extrahieren
print(df.loc[1:2, ['Name', 'Age']]) # Angegebene Zeilen und Spalten durch Label-Indizierung extrahieren
print(df.iloc[:, 1:]) # Angegebene Spalten durch Positionsindizierung extrahieren
Hinweise
DataFrameEs ist eine flexible Datenstruktur, die Spalten unterschiedlicher Datentypen enthalten kann.- Spaltennamen und Zeilenindizes können Zeichenketten, Ganzzahlen usw. sein.
DataFrameDatenauswahl, Filterung, Modifikation und Analyse können auf viele Arten durchgeführt werden.- Durch
DataFrameMit Operationen können Sie Datenbereinigung, Transformation, Analyse, Visualisierung und mehr durchführen.