Pandas Datenbereinigung
Datenbereinigung ist der Prozess der Behandlung nutzloser Daten.
Viele Datensätze enthalten fehlende Daten, falsche Datenformate, fehlerhafte Daten oder doppelte Daten. Um die Datenanalyse genauer zu machen, müssen Sie diese nutzlosen Daten verarbeiten.
Häufige Schritte bei der Datenbereinigung und Vorverarbeitung:
-
Umgang mit fehlenden Werten: Fehlende Werte identifizieren und füllen oder Zeilen/Spalten mit fehlenden Werten löschen.
-
Umgang mit doppelten Daten: Doppelte Daten prüfen und entfernen, um sicherzustellen, dass jeder Datensatz eindeutig ist.
-
Umgang mit Ausreißern: Ausreißer identifizieren und behandeln, wie z. B. Extremwerte und fehlerhafte Werte.
-
Datenformatkonvertierung: Datentypen konvertieren oder Einheitenumrechnungen durchführen, wie z. B. die Konvertierung von Datumsformaten.
-
Standardisierung und Normalisierung: Numerische Daten standardisieren (z. B. Z-Score) oder normalisieren (z. B. Min-Max).
-
Kodierung kategorischer Daten: Kategorische Variablen in numerische Form umwandeln. Häufige Methoden sind One-Hot-Encoding und Label-Encoding.
-
Textverarbeitung: Textdaten bereinigen, wie z. B. das Entfernen von Stoppwörtern, Stemming, Tokenisierung usw.
-
Daten-Sampling: Stichproben aus dem Datensatz ziehen oder Klassenungleichgewicht durch Oversampling/Undersampling behandeln.
-
Feature-Engineering: Neue Merkmale erstellen, irrelevante Merkmale entfernen, wichtige Merkmale auswählen usw.
In dieser Anleitung verwenden wir das Pandas-Paket zur Datenbereinigung.
Die in diesem Artikel verwendeten Testdatenproperty-data.csvsind wie folgt:
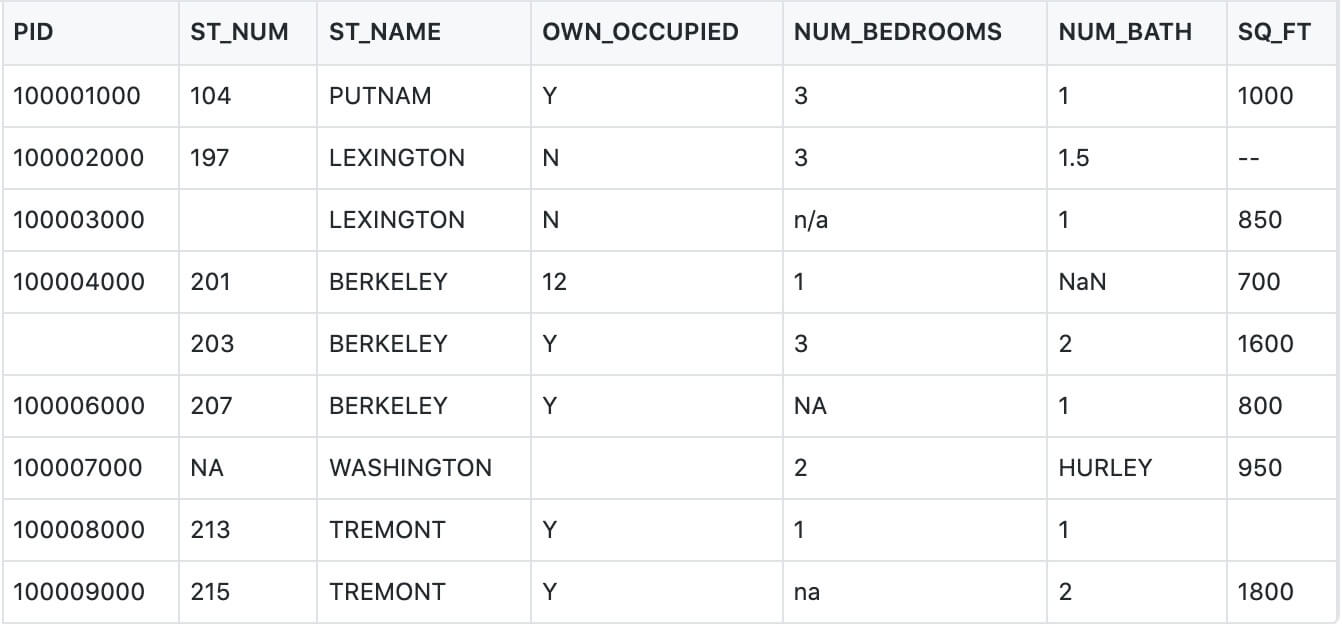
Die obige Tabelle enthält vier Arten von Null-Daten:
- n/a
- N/V
- —
- na
Pandas: Nullwerte bereinigen
Wenn wir Zeilen mit leeren Feldern löschen möchten, können wir diedropna()-Methode verwenden; das Syntaxformat ist wie folgt:
DataFrame.dropna(axis=0, how='any', thresh=None, subset=None, inplace=False)
Parameter description:
- axis: standardmäßig,0bedeutet dies das Entfernen der gesamten Zeile, wenn ein Nullwert angetroffen wird; wenn der Parameter aufaxis=1gesetzt wird, bedeutet dies das Entfernen der gesamten Spalte, wenn ein Nullwert angetroffen wird.
- how: standardmäßig,'any'wenn irgendein Datenwert in einer Zeile (oder Spalte) NA enthält, wird die gesamte Zeile entfernt; wenn aufhow='all'gesetzt, wird die gesamte Zeile nur dann entfernt, wenn alle Werte in einer Zeile (oder Spalte) NA sind.
- thresh: Legt fest, wie viele Nicht-Null-Werte erforderlich sind, damit die Daten beibehalten werden.
- subset: Legt die Spalten fest, die überprüft werden sollen. Wenn es mehrere Spalten gibt, können Sie eine Liste von Spaltennamen als Parameter verwenden.
- inplace: Wenn auf True gesetzt, überschreibt es direkt den vorherigen Wert mit dem berechneten Wert und gibt None zurück, wodurch die Quelldaten geändert werden.
Wir können dieisnull()-Methode verwenden, um festzustellen, ob jede Zelle leer ist.
Beispiel
df = pd.read_csv('property-data.csv')
print (df['NUM_BEDROOMS'])
print (df['NUM_BEDROOMS'].isnull())
Das Ausgabeergebnis des obigen Beispiels ist wie folgt:
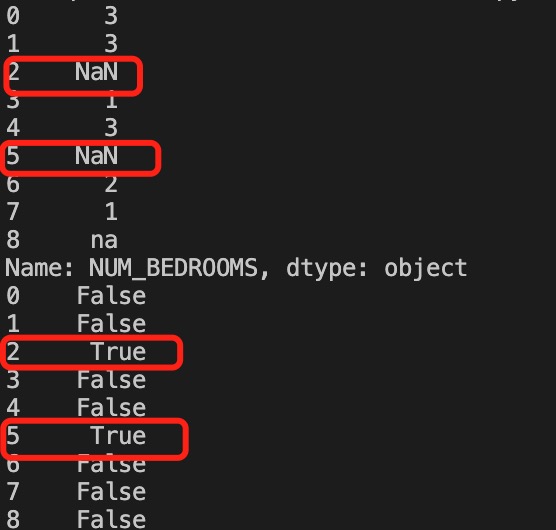
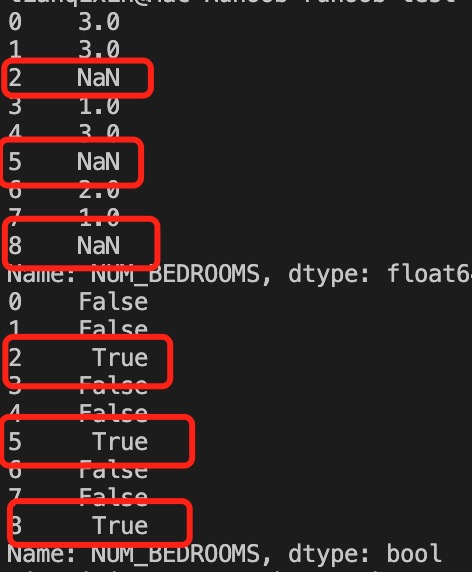
Im obigen Beispiel sehen wir, dass Pandas n/a und NA als Null-Daten behandelt, während na keine Null-Daten sind und unsere Anforderung nicht erfüllen. Wir können den Null-Datentyp angeben:
Beispiel
missing_values = ["n/a", "na", "--"]
df = pd.read_csv('property-data.csv', na_values = missing_values)
print (df['NUM_BEDROOMS'])
print (df['NUM_BEDROOMS'].isnull())
Das Ausgabeergebnis des obigen Beispiels ist wie folgt:
Das nächste Beispiel zeigt das Löschen von Zeilen, die Null-Daten enthalten.
Beispiel
df = pd.read_csv('property-data.csv')
new_df = df.dropna()
print(new_df.to_string())
Das Ausgabeergebnis des obigen Beispiels ist wie folgt:
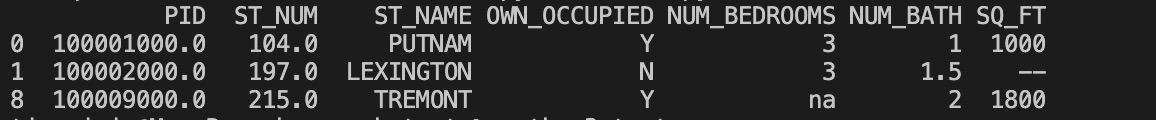
Hinweis:Standardmäßig gibt die Methode dropna() ein neues DataFrame zurück und verändert die Quelldaten nicht.
Wenn Sie das Quell-DataFrame ändern möchten, können Sie den Parameterinplace = Trueverwenden:
Beispiel
df = pd.read_csv('property-data.csv')
df.dropna(inplace = True)
print(df.to_string())
Das Ausgabeergebnis des obigen Beispiels ist wie folgt:
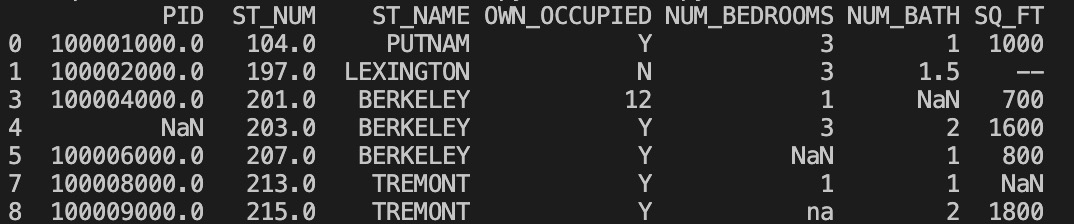
Wir können auch Zeilen entfernen, in denen eine angegebene Spalte Nullwerte enthält:
Beispiel
Entfernen Sie Zeilen, in denen der Feldwert in der Spalte ST_NUM leer ist:
df = pd.read_csv('property-data.csv')
df.dropna(subset=['ST_NUM'], inplace = True)
print(df.to_string())
Das Ausgabeergebnis des obigen Beispiels ist wie folgt:
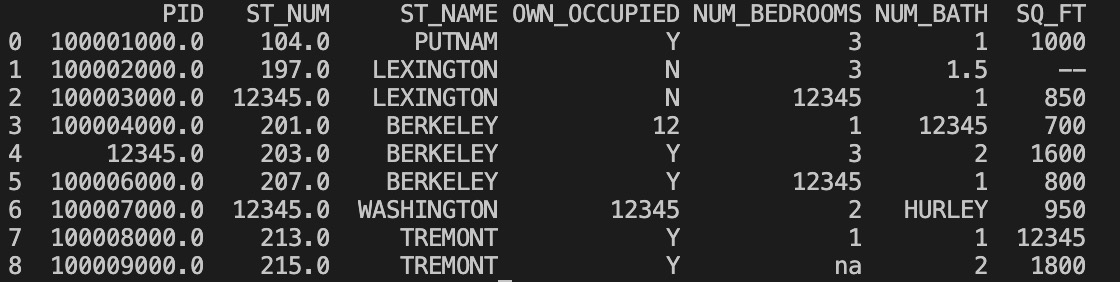
Wir können auch diefillna()Methode verwenden, um einige leere Felder zu ersetzen:
Beispiel
Verwenden Sie 12345, um leere Felder zu ersetzen:
df = pd.read_csv('property-data.csv')
df.fillna(12345, inplace = True)
print(df.to_string())
Das Ausgabeergebnis des obigen Beispiels ist wie folgt:
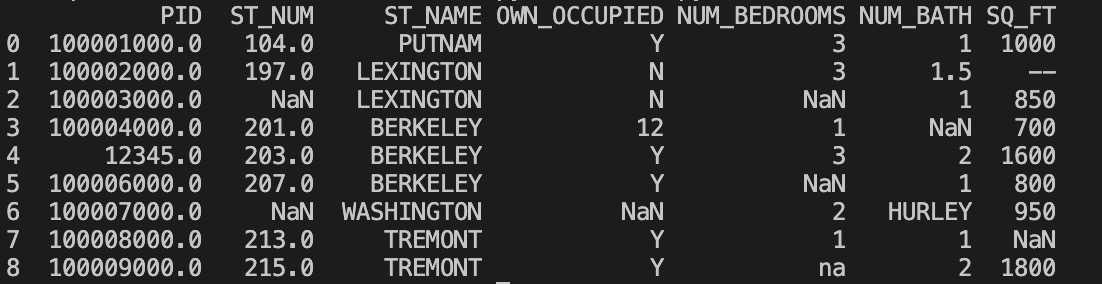
Wir können auch eine bestimmte Spalte angeben, um Daten zu ersetzen:
Beispiel
Verwenden Sie 12345, um Null-Daten in PID zu ersetzen:
df = pd.read_csv('property-data.csv')
df['PID'].fillna(12345, inplace = True)
print(df.to_string())
Das Ausgabeergebnis des obigen Beispiels ist wie folgt:
Eine gängige Methode zum Ersetzen leerer Zellen besteht darin, den Mittelwert, den Median oder den Modus der Spalte zu berechnen.
Pandas verwendet diemean()、median()undmode()Methode, um den Mittelwert (den Durchschnitt aller Werte), den Median (den mittleren Wert nach dem Sortieren) und den Modus (den am häufigsten vorkommenden Wert) einer Spalte zu berechnen.
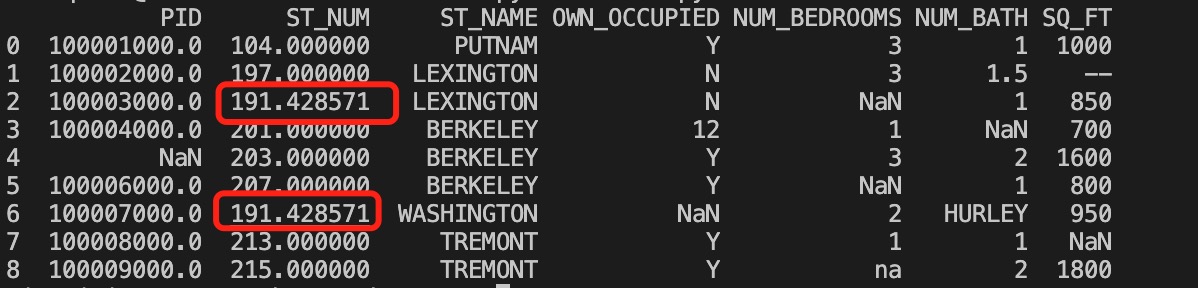
Beispiel
Verwenden Sie die mean()-Methode, um den Mittelwert der Spalte zu berechnen und leere Zellen zu ersetzen:
df = pd.read_csv('property-data.csv')
x = df["ST_NUM"].mean()
df["ST_NUM"].fillna(x, inplace = True)
print(df.to_string())
Das Ausgabeergebnis des obigen Beispiels ist wie folgt, das rote Feld ist der berechnete Mittelwert, der die leeren Zellen ersetzt hat:
Beispiel
Verwenden Sie die median()-Methode, um den Median der Spalte zu berechnen und leere Zellen zu ersetzen:
df = pd.read_csv('property-data.csv')
x = df["ST_NUM"].median()
df["ST_NUM"].fillna(x, inplace = True)
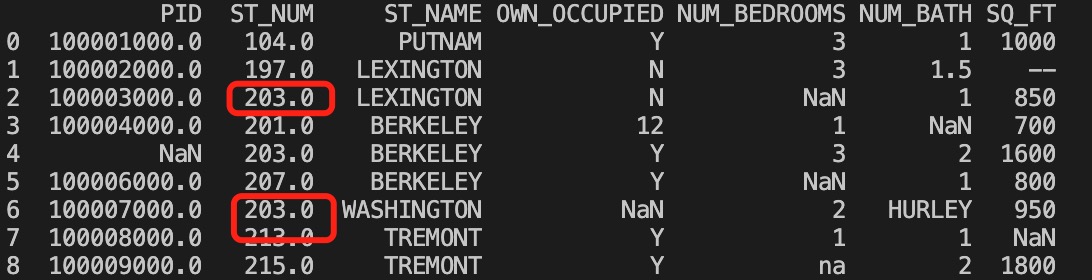
print(df.to_string())
Das Ausgabeergebnis des obigen Beispiels ist wie folgt, das rote Feld ist der berechnete Median, der die leeren Zellen ersetzt hat:
Beispiel
Verwenden Sie die mode()-Methode, um den Modus der Spalte zu berechnen und leere Zellen zu ersetzen:
df = pd.read_csv('property-data.csv')
x = df["ST_NUM"].mode()
df["ST_NUM"].fillna(x, inplace = True)
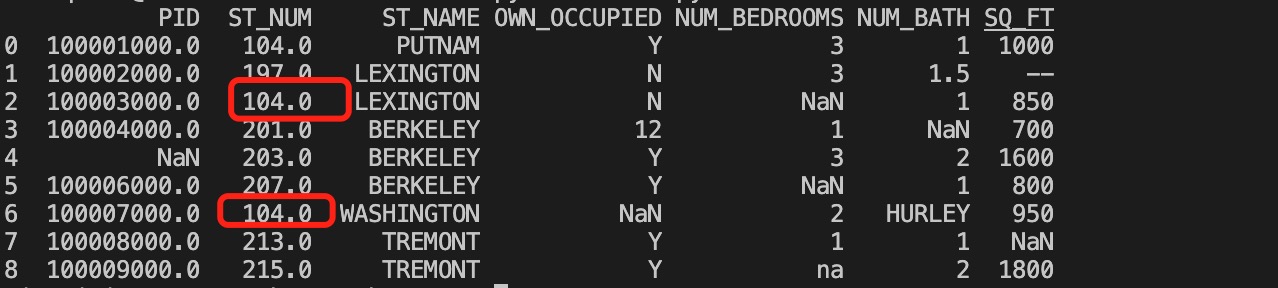
print(df.to_string())
Das Ausgabeergebnis des obigen Beispiels ist wie folgt, das rote Feld ist der berechnete Modus, der die leeren Zellen ersetzt hat:
Pandas: Bereinigung falsch formatierter Daten
Zellen mit falschen Datenformaten machen die Datenanalyse schwierig oder sogar unmöglich.
Wir können mit Zeilen umgehen, die leere Zellen enthalten, oder alle Zellen in einer Spalte in Daten im gleichen Format umwandeln.
Das folgende Beispiel formatiert das Datum:
Beispiel
# Das dritte Datum hat ein falsches Format
data = {
"Date": ['2020/12/01', '2020/12/02' , '20201226'],
"duration": [50, 40, 45]
}
df = pd.DataFrame(data, index = ["day1", "day2", "day3"])
df['Date'] = pd.to_datetime(df['Date'], format='mixed')
print(df.to_string())
Das Ausgabeergebnis des obigen Beispiels ist wie folgt:
           Date  duration
day1 2020-12-01        50
day2 2020-12-02        40
day3 2020-12-26        45
Pandas Bereinigen fehlerhafter Daten
Datenfehler sind ebenfalls eine sehr häufige Situation. Wir können fehlerhafte Daten ersetzen oder entfernen.
Das folgende Beispiel ersetzt Daten durch falsche Altersangaben:
Beispiel
person = {
"name": ['Google', 'Example' , 'Taobao'],
"age": [50, 40, 12345] # Die Altersdaten 12345 sind falsch
}
df = pd.DataFrame(person)
df.loc[2, 'age'] = 30 # Daten ändern
print(df.to_string())
Das Ausgabeergebnis des obigen Beispiels ist wie folgt:
     name  age
0  Google   50
1  Example   40
2  Taobao   30
Sie können auch bedingte Anweisungen festlegen:
Beispiel
Setzen Sie Alter, die größer als 120 sind, auf 120:
person = {
"name": ['Google', 'Example' , 'Taobao'],
"age": [50, 200, 12345]
}
df = pd.DataFrame(person)
for x in df.index:
if df.loc[x, "age"] > 120:
df.loc[x, "age"] = 120
print(df.to_string())
Das Ausgabeergebnis des obigen Beispiels ist wie folgt:
     name  age
0  Google   50
1  Example  120
2  Taobao  120
Sie können auch Zeilen mit fehlerhaften Daten löschen:
Beispiel
Löschen Sie Zeilen, bei denen das Alter größer als 120 ist:
person = {
"name": ['Google', 'Example' , 'Taobao'],
"age": [50, 40, 12345] # Die Altersdaten 12345 sind falsch
}
df = pd.DataFrame(person)
for x in df.index:
if df.loc[x, "age"] > 120:
df.drop(x, inplace = True)
print(df.to_string())
Das Ausgabeergebnis des obigen Beispiels ist wie folgt:
     name  age
0  Google   50
1  Example   40
Pandas: Doppelte Daten bereinigen
Wenn wir doppelte Daten bereinigen möchten, können wir dieduplicated()unddrop_duplicates()Methode verwenden.
Wenn die entsprechenden Daten dupliziert sind, gibtduplicated()True zurück, andernfalls gibt sie False zurück.
Beispiel
person = {
"name": ['Google', 'Example', 'Example', 'Taobao'],
"age": [50, 40, 40, 23]
}
df = pd.DataFrame(person)
print(df.duplicated())
Das Ausgabeergebnis des obigen Beispiels ist wie folgt:
0    False
1    False
2     True
3    False
dtype: bool
Um doppelte Daten zu entfernen, können Sie direkt diedrop_duplicates()Methode verwenden.
Beispiel
persons = {
"name": ['Google', 'Example', 'Example', 'Taobao'],
"age": [50, 40, 40, 23]
}
df = pd.DataFrame(persons)
df.drop_duplicates(inplace = True)
print(df)
Das Ausgabeergebnis des obigen Beispiels ist wie folgt:
     name  age
0  Google   50
1  Example   40
3  Taobao   23
Gängige Methoden und Beschreibungen
Gängige Methoden zur Datenbereinigung und Vorverarbeitung:
| Aktion | Methode/Schritt | Beschreibung | Gängige Funktionen/Methoden |
|---|---|---|---|
| Umgang mit fehlenden Werten | Fehlende Werte füllen | Fehlende Werte mit einem angegebenen Wert füllen (z. B. Mittelwert, Median, Modus usw.). | df.fillna(value) |
| Fehlende Werte löschen | Zeilen oder Spalten mit fehlenden Werten löschen. | df.dropna() | |
| Umgang mit doppelten Daten | Doppelte Daten löschen | Doppelte Zeilen im DataFrame löschen. | df.drop_duplicates() |
| Umgang mit Ausreißern | Ausreißererkennung (basierend auf statistischen Methoden) | Ausreißer mithilfe der Z-Score- oder IQR-Methode identifizieren und behandeln. | Benutzerdefinierte Funktion (z. B. basierend auf Z-Score oder IQR) |
| Ausreißer ersetzen | Ausreißer durch geeignete Werte ersetzen (wie Mittelwert oder Median). | Benutzerdefinierte Funktion (z. B. zum Ersetzen von Ausreißern) | |
| Datenformatkonvertierung | Datentypen konvertieren | Einen Datentyp von einem Typ in einen anderen konvertieren, z. B. eine Zeichenkette in ein Datum. | df.astype() |
| Datums-/Zeitformatkonvertierung | Zeichenketten oder Zahlen in den datetime-Typ konvertieren. | pd.to_datetime() | |
| Standardisierung und Normalisierung | Standardisierung | Daten in eine Verteilung mit Mittelwert 0 und Standardabweichung 1 transformieren. | StandardScaler() |
| Normalisierung | Daten auf einen angegebenen Bereich skalieren (z. B. [0, 1]). | MinMaxScaler() | |
| Kodierung kategorialer Daten | Label-Kodierung | Kategoriale Variablen in ganzzahlige Form umwandeln. | LabelEncoder() |
| One-Hot-Encoding | Jede Kategorie in ein neues binäres Merkmal umwandeln. | pd.get_dummies() | |
| Verarbeitung von Textdaten | Stoppwörter entfernen | Unbedeutende Wörter aus Text entfernen, wie z. B. "the", "is" usw. | Benutzerdefinierte Funktion (basierend aufnltkoderspaCy) |
| Stemming und Lemmatisierung | Stämme extrahieren oder die Grundform von Wörtern wiederherstellen. | nltk.stem.PorterStemmer() | |
| Tokenisierung | Text in Wörter oder Subwörter aufteilen. | nltk.word_tokenize() | |
| Datenstichprobenentnahme | Zufällige Stichprobenentnahme | Zufällige Stichprobenentnahme eines bestimmten Anteils der Daten. | df.sample() |
| Über- und Unterabtastung | Balancieren Sie die Klassenverteilung im Datensatz durch Überabtastung (Duplizieren von Stichproben der Minderheitsklasse) oder Unterabtastung (Reduzieren von Stichproben der Mehrheitsklasse). | SMOTE()(Überabtastung);RandomUnderSampler()(Unterabtastung) | |
| Merkmalskonstruktion | Merkmalsauswahl | Merkmale auswählen, die die Zielvariable beeinflussen, und redundante oder irrelevante Merkmale entfernen. | SelectKBest() |
| Merkmalsextraktion | Neue Merkmale aus Rohdaten erstellen, um die Vorhersagekraft des Modells zu verbessern. | PolynomialFeatures() | |
| Merkmalskalierung | Numerische Merkmale so skalieren, dass sie dieselbe Größenordnung haben. | MinMaxScaler() 、 StandardScaler() | |
| Kategorische Merkmalszuordnung | Feature-Mapping | Kategorische Variablen entsprechenden numerischen Codes zuordnen. | Benutzerdefinierte Zuordnungsfunktion |
| Datenzusammenführung und -verkettung | Daten zusammenführen | Mehrere DataFrames basierend auf bestimmten Spalten zusammenführen, mit Unterstützung für Inner-, Outer-, Left-, Right-Joins usw. | pd.merge() |
| Daten verketten | Mehrere DataFrames zeilen- oder spaltenweise verketten. | pd.concat() | |
| Datenumformung | Pivot-Tabelle | Daten nach bestimmten Dimensionen gruppieren und aggregierte Ergebnisse berechnen. | pd.pivot_table() |
| Datentransformation | Die Form der Daten ändern, z. B. vom Long-Format ins Wide-Format oder vom Wide-Format ins Long-Format. | df.melt() 、 df.pivot() | |
| Konvertierung und Verarbeitung von Datentypen | Zeichenkettenverarbeitung | Zeichenkettendaten verarbeiten, z. B. Leerzeichen entfernen, Groß-/Kleinschreibung ändern usw. | str.replace() 、 str.upper()warten |
| Gruppierte Berechnung | Aggregation nach Gruppierung nach einem bestimmten Merkmal durchführen. | df.groupby() | |
| Prädiktives Auffüllen fehlender Werte | Modelle zum Vorhersagen und Auffüllen fehlender Werte verwenden | Machine-Learning-Modelle (z. B. Regressionsmodelle) verwenden, um fehlende Werte vorherzusagen und fehlende Daten aufzufüllen. | Benutzerdefiniertes Modell (z. B.sklearn.linear_model.LinearRegression) |
| Zeitreihenverarbeitung | Füllen fehlender Werte in Zeitreihen | Verwenden Sie Zeitreihenmethoden (wie Vorwärtsfüllen, Rückwärtsfüllen), um fehlende Werte zu füllen. | df.fillna(method='ffill') |
| Berechnung mit gleitendem Fenster | Verwenden Sie ein gleitendes Fenster, um statistische Berechnungen auf Zeitreihendaten durchzuführen (z. B. Mittelwert, Standardabweichung usw.). | df.rolling(window=5).mean() | |
| Datenkonvertierung und Mapping | Daten-Mapping und -Ersetzung | Ersetzen Sie bestimmte Werte in Daten durch andere Werte. | df.replace() |
Fehlende Werte füllen:
Beispiel
# Beispieldaten
data = {'Name': ['Alice', 'Bob', 'Charlie', None],
'Age': [25, 30, None, 35],
'City': ['New York', 'Los Angeles', 'Chicago', 'Houston']}
df = pd.DataFrame(data)
# Fehlende "Age"-Werte mit Mittelwert füllen
df['Age'].fillna(df['Age'].mean(), inplace=True)
print(df)
Ausgabe:
      Name  Age           City
0    Alice   25.0       New York
1      Bob   30.0    Los Angeles
2  Charlie   30.0        Chicago
3     None   35.0        Houston
One-Hot-Kodierung:
Beispiel
# Beispieldaten
data = {'City': ['New York', 'Los Angeles', 'Chicago', 'Houston']}
df = pd.DataFrame(data)
# One-Hot-Kodierung für die Spalte "City" durchführen
df_encoded = pd.get_dummies(df, columns=['City'])
print(df_encoded)
Ausgabe:
   City_Chicago  City_Houston  City_Los Angeles  City_New York
0             0             0                 0              1
1             0             0                 1              0
2             1             0                 0              0
3             0             1                 0              0
Standardisierung:
Beispiel
import pandas as pd
# Beispieldaten
data = {'Age': [25, 30, 35, 40, 45],
'Salary': [50000, 60000, 70000, 80000, 90000]}
df = pd.DataFrame(data)
⟦⟧# Daten standardisieren
scaler = StandardScaler()
df_scaled = .fit_transform(df)
print(df_scaled)
Ausgabe:
[[-1.41421356 -1.41421356]
 [-0.70710678 -0.70710678]
 [ 0.          0.        ]
 [ 0.70710678  0.70710678]
 [ 1.41421356  1.41421356]]
Weitere Erweiterungen