Pandas: корреляционный анализ
Корреляционный анализ — распространённый и важный этап анализа данных; он помогает нам понять взаимосвязи между различными переменными в данных.
В Pandas корреляционный анализ данных выполняется путём вычисления коэффициентов корреляции между различными переменными, чтобы понять их взаимосвязи.
В Pandas корреляция данных — важная задача анализа, которая помогает понять взаимосвязи между различными переменными в данных.
Pandas предоставляет несколько методов для расчёта и анализа корреляции данных. Распространённые методы корреляции включают коэффициент корреляции Пирсона (Pearson), ранговый коэффициент корреляции Спирмена (Spearman) и ранговый коэффициент корреляции Кендалла (Kendall).
Следующие методы корреляции помогают выявить линейные, нелинейные или монотонные связи между переменными:
- Коэффициент корреляции Пирсона: измеряет линейную связь между переменными, подходит для числовых переменных.
- Ранговый коэффициент корреляции Спирмена: измеряет монотонную связь между переменными, подходит для числовых и порядковых переменных.
- Ранговый коэффициент корреляции Кендалла: измеряет ранговую связь между переменными, подходит для малых выборок данных.
- Корреляционная матрица: используется для просмотра корреляций между переменными.
- Тепловая карта: эффективный метод визуализации, который помогает нам интуитивно просматривать корреляции между переменными.
Что такое корреляция?
Корреляция отражает силу и направление связи между двумя или более переменными. По значению корреляции можно определить характер связи между переменными.
- Положительная корреляция: Когда одна переменная увеличивается, другая переменная также увеличивается. Например, рост и вес могут иметь положительную корреляцию.
- Отрицательная корреляция: Когда одна переменная увеличивается, другая переменная уменьшается. Например, температура и использование отопления могут иметь отрицательную корреляцию.
- Отсутствие корреляции: Между двумя переменными нет явной связи.
Значение корреляции обычно находится в диапазоне от -1 до 1:
- 1: Идеальная положительная корреляция
- -1: Идеальная отрицательная корреляция
- 0: Линейная корреляция отсутствует
- Близко к 1 или -1: Указывает на сильную корреляцию
- Близко к 0: Указывает на слабую корреляцию
Методы вычисления корреляции в Pandas
Pandas предоставляетDataFrame.corr()иDataFrame.cov()метод для расчета корреляции и ковариации.
Pandas использует методcorr()для расчета связей между каждым столбцом в наборе данных.
df.corr(method='pearson', min_periods=1)
Описание параметра:
- method(Необязательно): Строковый тип, используется для указания метода расчета коэффициента корреляции. По умолчанию — 'pearson'; также можно выбрать 'kendall' (коэффициент корреляции тау Кендалла) или 'spearman' (ранговый коэффициент корреляции Спирмена).
- min_periods(Необязательно): Указывает минимальное количество наблюдений, необходимое при вычислении коэффициента корреляции. По умолчанию — 1, что означает, что вычисление будет выполняться при наличии хотя бы одного непустого значения. Если указано
min_periods, и количество непустых значений в некоторых столбцах меньше этого значения, коэффициент корреляции для этих столбцов будет установлен в NaN.
df.corr()Метод возвращает матрицу коэффициентов корреляции. Строки и столбцы матрицы соответствуют названиям столбцов DataFrame, а элементы матрицы — это коэффициенты корреляции между соответствующими столбцами.
К распространенным коэффициентам корреляции относятся коэффициент корреляции Пирсона и ранговый коэффициент корреляции Спирмена:
Коэффициент корреляции Пирсона
Пирсон, а именно коэффициент корреляции Пирсона, используется для измерения силы и направления линейной связи между двумя переменными. Его значение находится в диапазоне от -1 до 1, где -1 указывает на идеальную отрицательную корреляцию, 1 указывает на идеальную положительную корреляцию, а 0 указывает на отсутствие линейной корреляции.
Коэффициент корреляции Пирсона используется для измерения линейной связи между двумя переменными. Формула расчета:
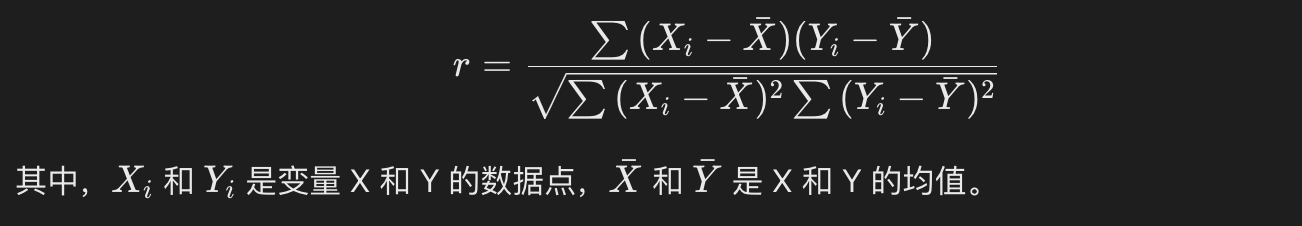
Pandas может использовать методcorr()для вычисления коэффициента корреляции Пирсона между столбцами в DataFrame.
Коэффициент корреляции Пирсона
Пример
# Пример данных
data = {
'Height': [150, 160, 170, 180, 190],
'Weight': [45, 55, 65, 75, 85],
'Age': [20, 25, 30, 35, 40]
}
df = pd.DataFrame(data)
# Вычислить коэффициент корреляции Пирсона
correlation = df.corr(method='pearson')
print(correlation)
Вывод:
        Height  Weight  Age
Height     1.0     1.0  1.0
Weight     1.0     1.0  1.0
Age        1.0     1.0  1.0
Объяснение:
corr()Метод рассчитал коэффициент корреляции Пирсона между каждой парой переменных.method='pearson'является методом по умолчанию, что указывает на вычисление коэффициента корреляции Пирсона.- Видно, что
HeightиWeightиAgeвсе имеют сильную положительную корреляцию.
Ранговый коэффициент корреляции Спирмена (Корреляция Спирмена)
Коэффициент корреляции Спирмена измеряет монотонную связь между двумя переменными (будь то линейную или нелинейную) и вычисляется на основе рангов переменных. Коэффициент корреляции Спирмена имеет тот же диапазон значений, что и коэффициент корреляции Пирсона: от -1 до 1.
Пример
# Пример данных
data = {
'Height': [150, 160, 170, 180, 190],
'Weight': [45, 55, 65, 75, 85],
'Age': [20, 25, 30, 35, 40]
}
df = pd.DataFrame(data)
# Вычислить ранговый коэффициент корреляции Спирмена
spearman_correlation = df.corr(method='spearman')
print(spearman_correlation)
Вывод:
        Height  Weight  Age
Height     1.0     1.0  1.0
Weight     1.0     1.0  1.0
Age        1.0     1.0  1.0
Объяснение:method='spearman' вычисляет коэффициент ранговой корреляции Спирмена. В этом примере, поскольку данные растут линейно, коэффициент корреляции Спирмена совпадает с коэффициентом корреляции Пирсона.
Коэффициент ранговой корреляции Кендалла (корреляция Кендалла)
Коэффициент ранговой корреляции Кендалла также используется для измерения монотонной связи между переменными. Он получается путем вычисления согласованности между ранжированиями двух переменных.
Коэффициент корреляции Кендалла сложнее вычислять, и он подходит для меньших наборов данных.
Пример
# Пример данных
data = {
'Height': [150, 160, 170, 180, 190],
'Weight': [45, 55, 65, 75, 85],
'Age': [20, 25, 30, 35, 40]
}
df = pd.DataFrame(data)
# Вычислить коэффициент ранговой корреляции Кендалла
kendall_correlation = df.corr(method='kendall')
print(kendall_correlation)
Вывод:
        Height  Weight  Age
Height     1.0     1.0  1.0
Weight     1.0     1.0  1.0
Age        1.0     1.0  1.0
Объяснение:method='kendall' вычисляет коэффициент ранговой корреляции Кендалла. В этом случае данные изменяются монотонно, поэтому результат вычисления совпадает с результатами Пирсона и Спирмена.
Корреляционная матрица
Корреляционная матрица — это симметричная матрица, где каждое значение представляет коэффициент корреляции между двумя переменными.
Вы можете использовать метод corr() для непосредственного вычисления корреляционной матрицы всех переменных в DataFrame.
Пример
# Пример данных
data = {
'Height': [150, 160, 170, 180, 190],
'Weight': [45, 55, 65, 75, 85],
'Age': [20, 25, 30, 35, 40]
}
df = pd.DataFrame(data)
# Вычислить корреляционную матрицу
correlation_matrix = df.corr()
print(correlation_matrix)
Вывод:
        Height  Weight  Age
Height     1.0     1.0  1.0
Weight     1.0     1.0  1.0
Age 1.0 1.0 1.0Пояснение:Корреляционная матрица помогает быстро определить, какие переменные имеют сильные линейные или монотонные связи. В практическом анализе корреляционная матрица очень полезна для выбора признаков и снижения размерности.
Тепловая карта корреляции (Correlation Heatmap)
Чтобы представить корреляционную матрицу более наглядно, можно использовать тепловую карту для визуализации корреляций между переменными.
Использование библиотеки seaborn для построения тепловой карты корреляции — распространённая практика.
Пример
import matplotlib.pyplot as plt
import pandas as pd
# Пример данных
data = {
'Height': [150, 160, 170, 180, 190],
'Weight': [45, 55, 65, 75, 85],
'Age': [20, 25, 30, 35, 40]
}
df = pd.DataFrame(data)
# Построение тепловой карты корреляции
plt.figure(figsize=(8, 6))
sns.heatmap(df.corr(), annot=True, cmap='coolwarm', fmt='.2f', vmin=-1, vmax=1)
plt.title('Correlation Heatmap')
plt.show()
Отображается следующим образом:
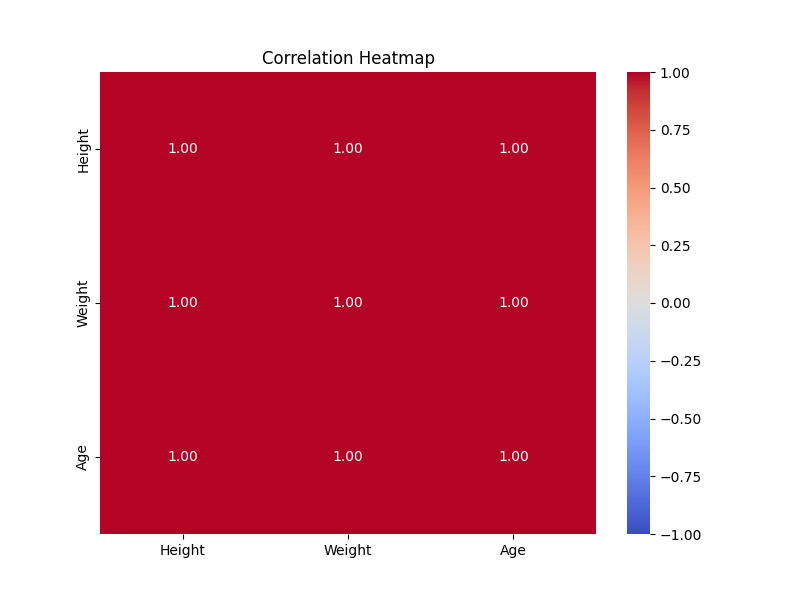
Пояснение:sns.heatmap() рисует тепловую карту корреляции. annot=True отображает значения на тепловой карте, cmap='coolwarm' задаёт цветовой диапазон, а vmin=-1, vmax=1 ограничивают цветовой диапазон значениями от -1 до 1.
Визуализация корреляции
Здесь мы будем использовать библиотеку Seaborn для Python. Seaborn — это библиотека визуализации данных, основанная на Matplotlib, ориентированная на статистическую графику и созданная, чтобы упростить процесс визуализации данных.
Seaborn предоставляет несколько простых высокоуровневых интерфейсов, которые упрощают построение различных статистических графиков, включая диаграммы рассеяния, линейные графики, столбчатые диаграммы, тепловые карты и т. д., а также имеет хорошее визуальное оформление.
Установка Seaborn:
pip install seaborn
Пример
import matplotlib.pyplot as plt
import pandas as pd
# Создать пример DataFrame
data = {'A': [1, 2, 3, 4, 5], 'B': [5, 4, 3, 2, 1]}
df = pd.DataFrame(data)
# Вычислить коэффициент корреляции Пирсона
correlation_matrix = df.corr()
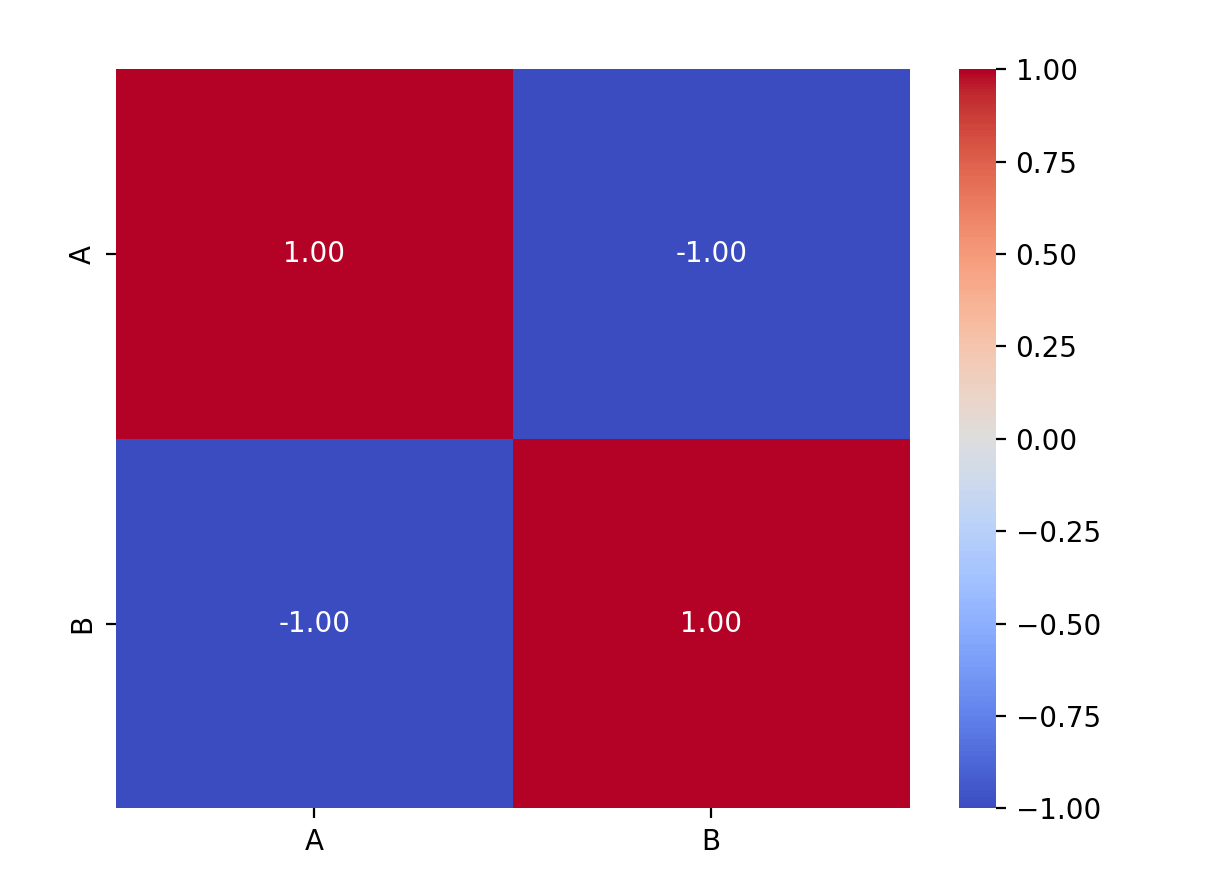
# Визуализация коэффициента корреляции Пирсона с помощью тепловой карты
sns.heatmap(correlation_matrix, annot=True, cmap='coolwarm', fmt=".2f")
plt.show()
Пояснение:Этот код создаст тепловую карту, которая использует цвета для представления силы коэффициентов корреляции, где положительные корреляции показаны в теплых тонах, а отрицательные — в холодных тонах.annot=TrueПараметр отображает конкретные значения на тепловой карте.
Применение корреляционного анализа
1. Отбор признаков
При моделировании в машинном обучении корреляционный анализ часто используется для отбора признаков. Анализируя корреляцию между различными признаками, он помогает выбрать признаки, наиболее связанные с целевой переменной, и удалить избыточные признаки, сильно коррелирующие с другими признаками, тем самым повышая производительность и эффективность модели.
2. Обработка мультиколлинеарности
Если корреляция между двумя или более признаками очень высока (близка к 1 или -1), то среди этих признаков существует проблема мультиколлинеарности. В регрессионном анализе мультиколлинеарность может привести к нестабильности модели и неточным прогнозам. Эту проблему можно решить путем удаления или объединения признаков с высокой корреляцией.
Другие расширения