Pandas Análisis de correlación
El análisis de correlación es un paso común e importante en el análisis de datos, ya que nos ayuda a comprender las relaciones entre diferentes variables en los datos.
En Pandas, el análisis de correlación de datos se realiza calculando coeficientes de correlación entre diferentes variables para comprender sus relaciones.
En Pandas, la correlación de datos es una tarea de análisis importante que nos ayuda a comprender las relaciones entre las distintas variables en los datos.
Pandas proporciona múltiples métodos para calcular y analizar la correlación de datos. Los métodos de correlación comunes incluyen el coeficiente de correlación de Pearson, el coeficiente de correlación de rangos de Spearman y el coeficiente de correlación de Kendall.
Los siguientes métodos de correlación pueden ayudarnos a revelar relaciones lineales, no lineales o monótonas entre variables:
- Coeficiente de correlación de Pearson: mide la relación lineal entre variables, adecuado para variables numéricas.
- Coeficiente de correlación de rangos de Spearman: mide la relación monótona entre variables, adecuado para variables numéricas y ordinales.
- Coeficiente de correlación de rangos de Kendall: mide la relación de rangos entre variables, adecuado para muestras de tamaño pequeño.
- Matriz de correlación: se utiliza para ver la correlación entre cada variable.
- Mapa de calor: una forma eficaz de visualización que nos ayuda a ver intuitivamente la correlación entre variables.
¿Qué es la correlación?
La correlación indica la fuerza y la dirección de la relación entre dos o más variables. Según el valor de la correlación, se puede determinar la relación entre las variables.
- Correlación positiva: cuando una variable aumenta, la otra también aumenta. Por ejemplo, puede existir una correlación positiva entre la altura y el peso.
- Correlación negativa: cuando una variable aumenta, la otra disminuye. Por ejemplo, puede existir una correlación negativa entre la temperatura y el uso de calefacción.
- Sin correlación: no hay una relación clara entre las dos variables.
El rango de valores de la correlación suele estar entre -1 y 1:
- 1: correlación positiva perfecta
- -1: correlación negativa perfecta
- 0: sin correlación lineal
- Cerca de 1 o -1: indica una correlación fuerte
- Cerca de 0: indica una correlación débil
Métodos para calcular la correlación en Pandas
Pandas proporcionaDataFrame.corr()yDataFrame.cov()el método para calcular la correlación y la covarianza.
Pandas utilizacorr()el método para calcular la relación entre cada columna en el conjunto de datos.
df.corr(method='pearson', min_periods=1)
Parámetros:
- method(Opcional): tipo de cadena, se utiliza para especificar el método de cálculo del coeficiente de correlación. El valor predeterminado es 'pearson', también se puede elegir 'kendall' (coeficiente de correlación de Kendall Tau) o 'spearman' (coeficiente de correlación de rangos de Spearman).
- min_periods(Opcional): representa el número mínimo de observaciones necesarias para calcular el coeficiente de correlación. El valor predeterminado es 1, es decir, siempre que haya al menos un valor no nulo, se realizará el cálculo. Si se especifica
min_periods, y en algunas columnas el número de valores no nulos es menor que ese valor, el coeficiente de correlación de la columna correspondiente se establecerá como NaN.
df.corr()El método devuelve una matriz de coeficientes de correlación. Las filas y columnas de la matriz corresponden a los nombres de las columnas del DataFrame, y los elementos de la matriz son los coeficientes de correlación entre las columnas correspondientes.
Los coeficientes de correlación comunes incluyen el coeficiente de correlación de Pearson y el coeficiente de correlación de rangos de Spearman:
Coeficiente de correlación de Pearson
Pearson, es decir, el coeficiente de correlación de Pearson, se utiliza para medir la fuerza y la dirección de la relación lineal entre dos variables. Su rango de valores está entre -1 y 1, donde -1 indica una correlación negativa perfecta, 1 indica una correlación positiva perfecta y 0 indica que no hay correlación lineal.
El coeficiente de correlación de Pearson se utiliza para medir la relación lineal entre dos variables, y su fórmula de cálculo es:
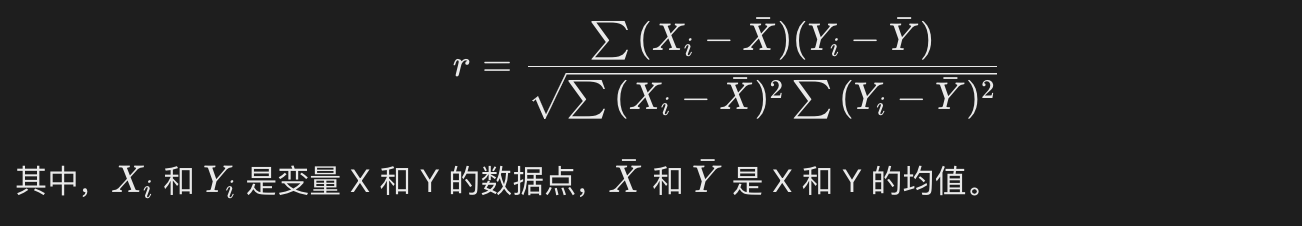
Pandas puede usarcorr()el método para calcular el coeficiente de correlación de Pearson entre las columnas del DataFrame.
Coeficiente de correlación de Pearson
Ejemplo
# Datos de ejemplo
data = {
'Height': [150, 160, 170, 180, 190],
'Weight': [45, 55, 65, 75, 85],
'Age': [20, 25, 30, 35, 40]
}
df = pd.DataFrame(data)
# Calcular el coeficiente de correlación de Pearson
correlation = df.corr(method='pearson')
print(correlation)
Resultado de salida:
        Height  Weight  Age
Height     1.0     1.0  1.0
Weight     1.0     1.0  1.0
Age        1.0     1.0  1.0
Explicación:
corr()El método calcula el coeficiente de correlación de Pearson entre cada par de variables.method='pearson'es el método predeterminado, lo que significa que calcula el coeficiente de correlación de Pearson.- Se puede ver que
HeightyWeightyAgetodos tienen una correlación positiva muy fuerte.
Coeficiente de correlación de rangos de Spearman (Spearman Correlation)
El coeficiente de correlación de Spearman se utiliza para medir la relación monótona entre dos variables (ya sea lineal o no lineal), y se calcula basándose en los rangos de las variables. El rango de valores del coeficiente de correlación de Spearman es el mismo que el del coeficiente de correlación de Pearson: -1 a 1.
Ejemplo
# Datos de ejemplo
data = {
'Height': [150, 160, 170, 180, 190],
'Weight': [45, 55, 65, 75, 85],
'Age': [20, 25, 30, 35, 40]
}
df = pd.DataFrame(data)
# Calcular el coeficiente de correlación de rangos de Spearman
spearman_correlation = df.corr(method='spearman')
print(spearman_correlation)
Resultado de salida:
        Height  Weight  Age
Height     1.0     1.0  1.0
Weight     1.0     1.0  1.0
Age        1.0     1.0  1.0
Explicación:method='spearman' calculará el coeficiente de correlación de rangos de Spearman. En este ejemplo, como los datos crecen linealmente, el coeficiente de correlación de Spearman es el mismo que el de Pearson.
Coeficiente de correlación de Kendall (Kendall Correlation)
El coeficiente de correlación de Kendall también se utiliza para medir la relación monótona entre variables, y se obtiene calculando la concordancia entre los rangos de dos variables.
El cálculo del coeficiente de correlación de Kendall es relativamente complejo y es adecuado para conjuntos de datos más pequeños.
Ejemplo
# Datos de ejemplo
data = {
'Height': [150, 160, 170, 180, 190],
'Weight': [45, 55, 65, 75, 85],
'Age': [20, 25, 30, 35, 40]
}
df = pd.DataFrame(data)
# Calcular el coeficiente de correlación de rangos de Kendall
kendall_correlation = df.corr(method='kendall')
print(kendall_correlation)
Resultado de salida:
        Height  Weight  Age
Height     1.0     1.0  1.0
Weight     1.0     1.0  1.0
Age        1.0     1.0  1.0
Explicación:method='kendall' calculará el coeficiente de correlación de rangos de Kendall. En este caso, los cambios en los datos son monótonos, por lo que los resultados del cálculo son los mismos que los de Pearson y Spearman.
Matriz de correlación
La matriz de correlación es una matriz simétrica, y cada valor en la matriz representa el coeficiente de correlación entre dos variables.
El método corr() se puede utilizar directamente para calcular la matriz de correlación de todas las variables en un DataFrame.
Ejemplo
# Datos de ejemplo
data = {
'Height': [150, 160, 170, 180, 190],
'Weight': [45, 55, 65, 75, 85],
'Age': [20, 25, 30, 35, 40]
}
df = pd.DataFrame(data)
# Calcular la matriz de correlación
correlation_matrix = df.corr()
print(correlation_matrix)
Resultado de salida:
        Height  Weight  Age
Height     1.0     1.0  1.0
Weight     1.0     1.0  1.0
Age 1.0 1.0 1.0Explicación:La matriz de correlación nos ayuda a identificar rápidamente qué variables tienen relaciones lineales o monótonas más fuertes. En el análisis práctico, la matriz de correlación es muy útil para la selección de características y la reducción de dimensionalidad.
Mapa de calor de correlación (Correlation Heatmap)
Para presentar la matriz de correlación de forma más intuitiva, se puede utilizar un mapa de calor (Heatmap) para visualizar la correlación entre distintas variables.
Usar la librería seaborn para dibujar un mapa de calor de correlación es una práctica común.
Ejemplo
import matplotlib.pyplot as plt
import pandas as pd
# Datos de ejemplo
data = {
'Height': [150, 160, 170, 180, 190],
'Weight': [45, 55, 65, 75, 85],
'Age': [20, 25, 30, 35, 40]
}
df = pd.DataFrame(data)
# Dibujar el mapa de calor de correlación
plt.figure(figsize=(8, 6))
sns.heatmap(df.corr(), annot=True, cmap='coolwarm', fmt='.2f', vmin=-1, vmax=1)
plt.title('Correlation Heatmap')
plt.show()
Se muestra a continuación:
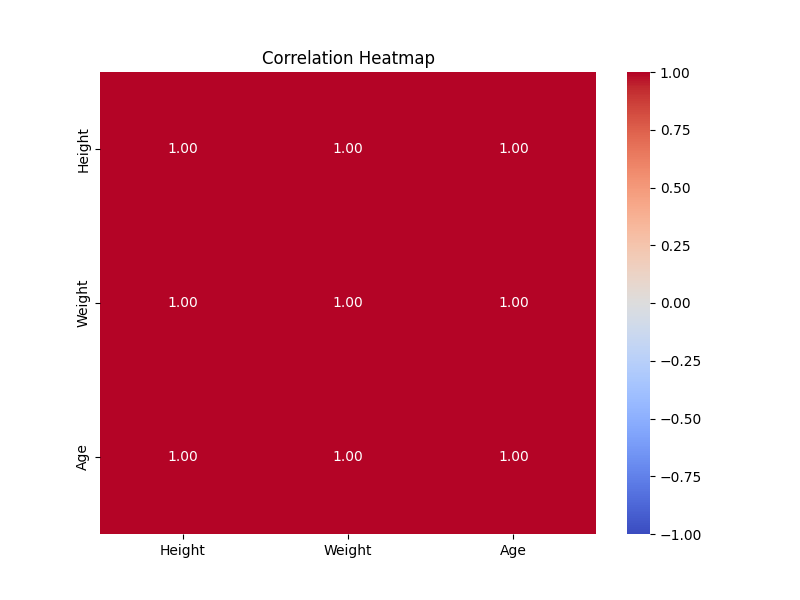
Explicación:sns.heatmap() dibuja el mapa de calor de correlación; annot=True indica mostrar los valores en el mapa de calor, cmap='coolwarm' establece el rango de colores, vmin=-1, vmax=1 limita el rango de colores a -1 a 1.
Visualizar la correlación
Aquí vamos a utilizar la librería Seaborn de Python. Seaborn es una librería de visualización de datos basada en Matplotlib, centrada en la creación de gráficos estadísticos y diseñada para simplificar el proceso de visualización de datos.
Seaborn proporciona algunas interfaces simples de alto nivel que permiten dibujar fácilmente varios gráficos estadísticos, incluyendo diagramas de dispersión, diagramas de líneas, diagramas de barras, mapas de calor, etc., y además tiene un buen efecto estético.
Instalar Seaborn:
pip install seaborn
Ejemplo
import matplotlib.pyplot as plt
import pandas as pd
# Crear un DataFrame de ejemplo
data = {'A': [1, 2, 3, 4, 5], 'B': [5, 4, 3, 2, 1]}
df = pd.DataFrame(data)
# Calcular el coeficiente de correlación de Pearson
correlation_matrix = df.corr()
# Usar un mapa de calor para visualizar el coeficiente de correlación de Pearson
sns.heatmap(correlation_matrix, annot=True, cmap='coolwarm', fmt=".2f")
plt.show()
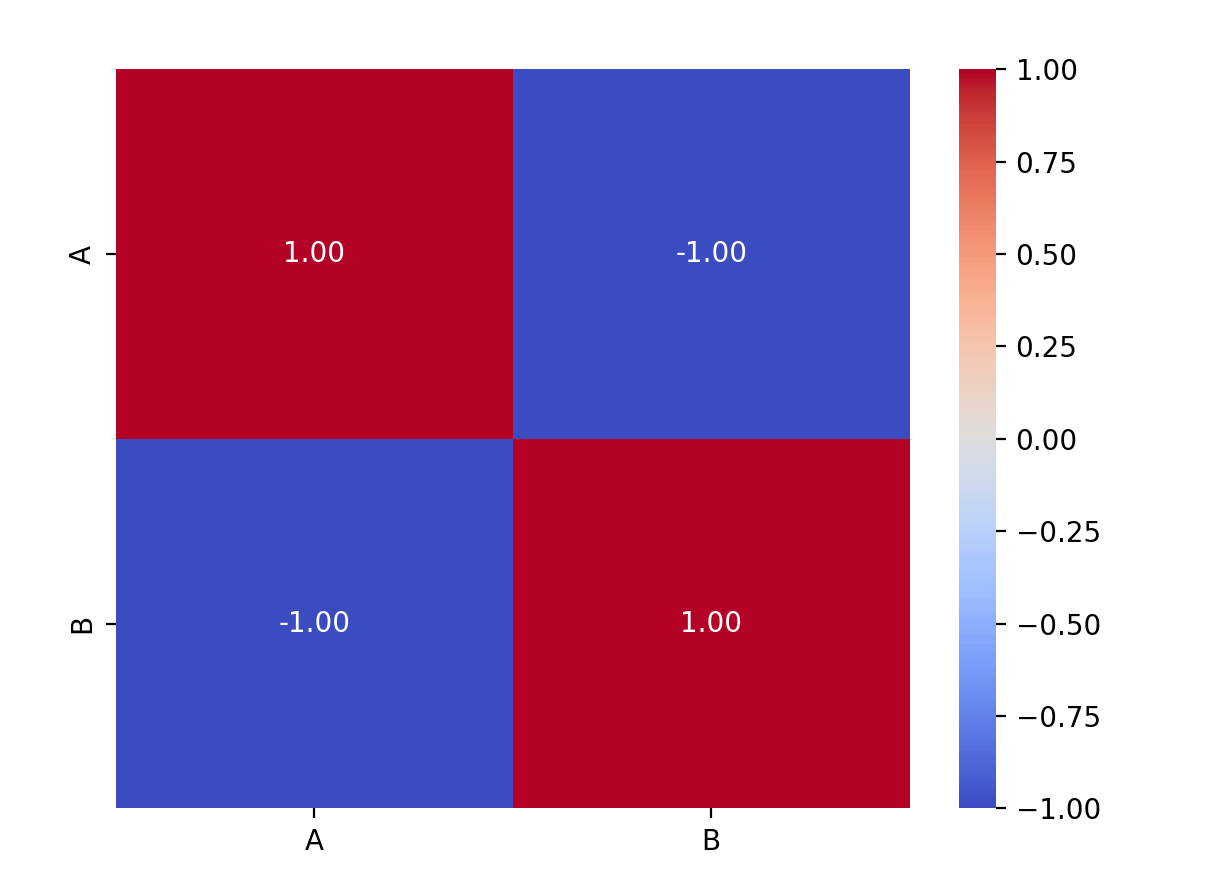
Explicación:Este código generará un mapa de calor que usa colores para representar la intensidad del coeficiente de correlación, donde la correlación positiva se representa con tonos cálidos y la correlación negativa con tonos fríos.annot=TrueEl parámetro muestra los valores numéricos específicos en el mapa de calor.
Aplicaciones del análisis de correlación
1. Selección de características
En el modelado de aprendizaje automático, el análisis de correlación se utiliza a menudo para la selección de características. Al analizar la correlación entre diferentes características, podemos seleccionar las características más relevantes para la variable objetivo y eliminar las características redundantes altamente correlacionadas con otras, mejorando así el rendimiento y la eficiencia del modelo.
2. Manejo de la multicolinealidad
Si la correlación entre dos o más características es muy alta (cerca de 1 o -1), entonces existe un problema de multicolinealidad entre estas características. En el análisis de regresión, la multicolinealidad puede causar inestabilidad del modelo e inexactitud en las predicciones. El problema de la multicolinealidad se puede resolver eliminando o combinando características altamente correlacionadas.
Otras extensiones