Analyse de corrélation avec Pandas
L'analyse de corrélation est une étape courante et importante de l'analyse de données ; elle nous aide à comprendre les relations entre les différentes variables des données.
Dans Pandas, l'analyse de corrélation des données est réalisée en calculant les coefficients de corrélation entre différentes variables afin de comprendre leurs relations.
Dans Pandas, la corrélation des données est une tâche d'analyse importante qui nous aide à comprendre les relations entre les diverses variables des données.
Pandas fournit plusieurs méthodes pour calculer et analyser la corrélation des données. Les méthodes de corrélation courantes incluent le coefficient de corrélation de Pearson (Pearson), le coefficient de corrélation des rangs de Spearman (Spearman) et le coefficient de corrélation des rangs de Kendall (Kendall).
Les méthodes de corrélation suivantes peuvent nous aider à révéler des relations linéaires, non linéaires ou monotones entre les variables :
- Coefficient de corrélation de Pearson: mesure la relation linéaire entre les variables, adapté aux variables numériques.
- Coefficient de corrélation des rangs de Spearman: mesure la relation monotone entre les variables, adapté aux variables numériques et ordinales.
- Coefficient de corrélation des rangs de Kendall: mesure la relation de rang entre les variables, adapté aux données de petits échantillons.
- Matrice de corrélation: utilisée pour visualiser les corrélations entre les variables.
- Carte thermique: une méthode de visualisation efficace qui nous aide à visualiser intuitivement les corrélations entre les variables.
Qu'est-ce que la corrélation ?
La corrélation représente la force et le sens de la relation entre deux ou plusieurs variables. En fonction de la valeur de corrélation, la relation entre les variables peut être déterminée.
- Corrélation positive: Lorsqu'une variable augmente, l'autre variable augmente également. Par exemple, la taille et le poids peuvent avoir une corrélation positive.
- Corrélation négative: Lorsqu'une variable augmente, l'autre variable diminue. Par exemple, la température et l'utilisation du chauffage peuvent avoir une corrélation négative.
- Aucune corrélation: Il n'existe pas de relation claire entre les deux variables.
La valeur de la corrélation varie généralement de -1 à 1 :
- 1: Corrélation positive parfaite
- -1: Corrélation négative parfaite
- 0: Aucune corrélation linéaire
- Proche de 1 ou -1: Indique une corrélation forte
- Proche de 0: Indique une corrélation faible
Méthodes de calcul de la corrélation dans Pandas
Pandas fournit laDataFrame.corr()etDataFrame.cov()méthode pour calculer la corrélation et la covariance.
Pandas utilise la méthodecorr()pour calculer les relations entre chaque colonne d’un jeu de données.
df.corr(method='pearson', min_periods=1)
Description du paramètre :
- method(Facultatif) : Type chaîne de caractères, utilisé pour spécifier la méthode de calcul du coefficient de corrélation. La valeur par défaut est 'pearson' ; vous pouvez également choisir 'kendall' (coefficient de corrélation tau de Kendall) ou 'spearman' (coefficient de corrélation de rang de Spearman).
- min_periods(Facultatif) : Indique le nombre minimum d’observations requises lors du calcul du coefficient de corrélation. La valeur par défaut est 1, ce qui signifie que le calcul sera effectué tant qu’il y a au moins une valeur non nulle. Si spécifié
min_periods, et que le nombre de valeurs non nulles dans certaines colonnes est inférieur à cette valeur, le coefficient de corrélation pour ces colonnes sera défini sur NaN.
df.corr()La méthode renvoie une matrice de coefficients de corrélation. Les lignes et colonnes de la matrice correspondent aux noms de colonnes du DataFrame, et les éléments de la matrice sont les coefficients de corrélation entre les colonnes correspondantes.
Les coefficients de corrélation courants incluent le coefficient de corrélation de Pearson et le coefficient de corrélation de rang de Spearman :
Coefficient de corrélation de Pearson
Pearson, à savoir le coefficient de corrélation de Pearson, est utilisé pour mesurer la force et la direction de la relation linéaire entre deux variables. Sa valeur varie de -1 à 1, où -1 indique une corrélation négative parfaite, 1 indique une corrélation positive parfaite, et 0 indique aucune corrélation linéaire.
Le coefficient de corrélation de Pearson est utilisé pour mesurer la relation linéaire entre deux variables. La formule de calcul est :
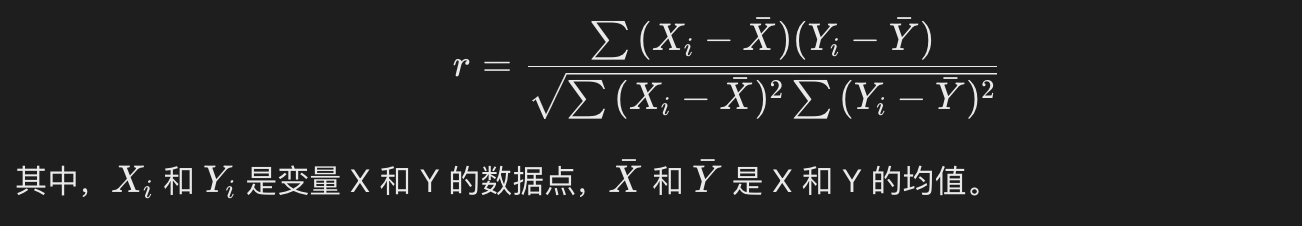
Pandas peut utiliser la méthodecorr()pour calculer le coefficient de corrélation de Pearson entre les colonnes d’un DataFrame.
Coefficient de corrélation de Pearson
Exemple
# Données d'exemple
data = {
'Height': [150, 160, 170, 180, 190],
'Weight': [45, 55, 65, 75, 85],
'Age': [20, 25, 30, 35, 40]
}
df = pd.DataFrame(data)
# Calculer le coefficient de corrélation de Pearson
correlation = df.corr(method='pearson')
print(correlation)
Sortie :
        Height  Weight  Age
Height     1.0     1.0  1.0
Weight     1.0     1.0  1.0
Age        1.0     1.0  1.0
Explication:
corr()La méthode a calculé le coefficient de corrélation de Pearson entre chaque paire de variables.method='pearson'est la méthode par défaut, indiquant le calcul du coefficient de corrélation de Pearson.- On peut voir que
HeightetWeightetAgetoutes ont une forte corrélation positive.
Coefficient de corrélation des rangs de Spearman (corrélation de Spearman)
Le coefficient de corrélation de Spearman mesure la relation monotone entre deux variables (qu'elle soit linéaire ou non linéaire) et est calculé en fonction des rangs des variables. Le coefficient de corrélation de Spearman a la même plage de valeurs que le coefficient de corrélation de Pearson : -1 à 1.
Exemple
# Données d'exemple
data = {
'Height': [150, 160, 170, 180, 190],
'Weight': [45, 55, 65, 75, 85],
'Age': [20, 25, 30, 35, 40]
}
df = pd.DataFrame(data)
# Calculer le coefficient de corrélation des rangs de Spearman
spearman_correlation = df.corr(method='spearman')
print(spearman_correlation)
Sortie :
        Height  Weight  Age
Height     1.0     1.0  1.0
Weight     1.0     1.0  1.0
Age        1.0     1.0  1.0
Explication :method='spearman' calcule le coefficient de corrélation des rangs de Spearman. Dans cet exemple, comme les données croissent linéairement, le coefficient de corrélation de Spearman est identique au coefficient de corrélation de Pearson.
Coefficient de corrélation des rangs de Kendall (corrélation de Kendall)
Le coefficient de corrélation des rangs de Kendall est également utilisé pour mesurer la relation monotone entre les variables. Il est obtenu en calculant la concordance entre les rangs de deux variables.
Le coefficient de corrélation de Kendall est plus complexe à calculer et convient aux jeux de données plus petits.
Exemple
# Données d'exemple
data = {
'Height': [150, 160, 170, 180, 190],
'Weight': [45, 55, 65, 75, 85],
'Age': [20, 25, 30, 35, 40]
}
df = pd.DataFrame(data)
# Calculer le coefficient de corrélation des rangs de Kendall
kendall_correlation = df.corr(method='kendall')
print(kendall_correlation)
Sortie :
        Height  Weight  Age
Height     1.0     1.0  1.0
Weight     1.0     1.0  1.0
Age        1.0     1.0  1.0
Explication :method='kendall' calcule le coefficient de corrélation des rangs de Kendall. Dans ce cas, les données évoluent de façon monotone, donc le résultat du calcul est le même que pour Pearson et Spearman.
Matrice de corrélation
Une matrice de corrélation est une matrice symétrique, où chaque valeur de la matrice représente le coefficient de corrélation entre deux variables.
Vous pouvez utiliser la méthode corr() pour calculer directement la matrice de corrélation de toutes les variables d'un DataFrame.
Exemple
# Données d'exemple
data = {
'Height': [150, 160, 170, 180, 190],
'Weight': [45, 55, 65, 75, 85],
'Age': [20, 25, 30, 35, 40]
}
df = pd.DataFrame(data)
# Calculer la matrice de corrélation
correlation_matrix = df.corr()
print(correlation_matrix)
Sortie :
        Height  Weight  Age
Height     1.0     1.0  1.0
Weight     1.0     1.0  1.0
Age        1.0     1.0  1.0
Explication :La matrice de corrélation nous aide à identifier rapidement quelles variables ont des relations linéaires ou monotones fortes. En analyse pratique, la matrice de corrélation est très utile pour la sélection de variables et la réduction de dimensionnalité.
Carte thermique de corrélation (Correlation Heatmap)
Pour présenter la matrice de corrélation de manière plus intuitive, une carte thermique peut être utilisée pour visualiser les corrélations entre les variables.
Utiliser la bibliothèque seaborn pour tracer une carte thermique de corrélation est une pratique courante.
Exemple
import matplotlib.pyplot as plt
import pandas as pd
# Données d'exemple
data = {
'Height': [150, 160, 170, 180, 190],
'Weight': [45, 55, 65, 75, 85],
'Age': [20, 25, 30, 35, 40]
}
df = pd.DataFrame(data)
# Tracer une carte thermique de corrélation
plt.figure(figsize=(8, 6))
sns.heatmap(df.corr(), annot=True, cmap='coolwarm', fmt='.2f', vmin=-1, vmax=1)
plt.title('Correlation Heatmap')
plt.show()
Affiché comme suit :
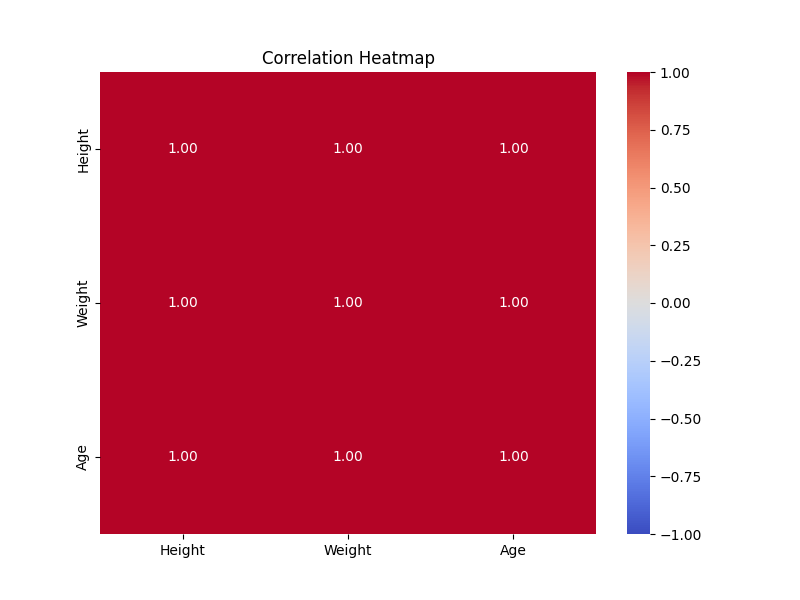
Explication :sns.heatmap() dessine la carte thermique de corrélation. annot=True affiche les valeurs sur la carte thermique, cmap='coolwarm' définit la plage de couleurs, et vmin=-1, vmax=1 limite la plage de couleurs de -1 à 1.
Visualisation de la corrélation
Ici, nous utiliserons la bibliothèque Seaborn de Python. Seaborn est une bibliothèque de visualisation de données basée sur Matplotlib, axée sur les graphiques statistiques, conçue pour simplifier le processus de visualisation de données.
Seaborn fournit quelques interfaces simples de haut niveau qui facilitent le tracé de divers graphiques statistiques, notamment des diagrammes de dispersion, des graphiques en courbes, des diagrammes en barres, des cartes thermiques, etc., et il possède de bons effets esthétiques.
Installer Seaborn :
pip install seaborn
Exemple
import matplotlib.pyplot as plt
import pandas as pd
# Créer un DataFrame d'exemple
data = {'A': [1, 2, 3, 4, 5], 'B': [5, 4, 3, 2, 1]}
df = pd.DataFrame(data)
# Calculer le coefficient de corrélation de Pearson
correlation_matrix = df.corr()
# Visualiser le coefficient de corrélation de Pearson avec une carte thermique
sns.heatmap(correlation_matrix, annot=True, cmap='coolwarm', fmt=".2f")
plt.show()
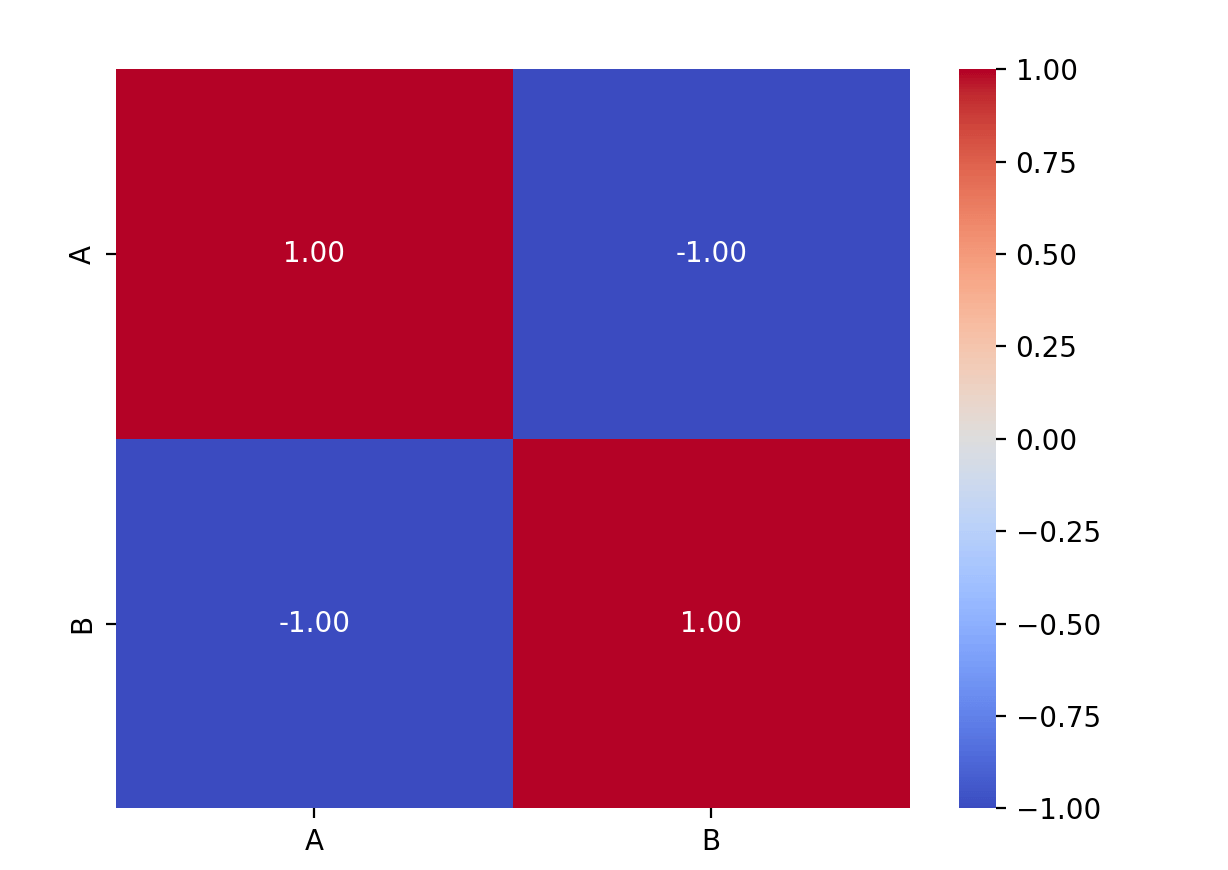
Explication :Ce code générera une carte thermique qui utilise des couleurs pour représenter la force des coefficients de corrélation, où les corrélations positives sont affichées dans des tons chauds et les corrélations négatives dans des tons froids.annot=TrueLe paramètre affiche les valeurs spécifiques sur la carte thermique.
Applications de l'analyse de corrélation
1. Sélection de caractéristiques
Dans la modélisation en apprentissage automatique, l'analyse de corrélation est souvent utilisée pour la sélection de caractéristiques. En analysant la corrélation entre différentes caractéristiques, elle nous aide à sélectionner les caractéristiques les plus pertinentes pour la variable cible et à supprimer les caractéristiques redondantes qui sont fortement corrélées avec d'autres caractéristiques, ce qui améliore ainsi les performances et l'efficacité du modèle.
2. Gestion de la multicolinéarité
Si la corrélation entre deux caractéristiques ou plus est très élevée (proche de 1 ou -1), alors il existe un problème de multicolinéarité entre ces caractéristiques. Dans l'analyse de régression, la multicolinéarité peut entraîner une instabilité du modèle et des prédictions inexactes. Ce problème peut être résolu en supprimant ou en fusionnant les caractéristiques ayant une corrélation élevée.
Autres extensions