Pandas: очистка данных
Очистка данных — это процесс обработки бесполезных данных.
Многие наборы данных содержат пропущенные данные, неправильные форматы данных, ошибочные данные или дублирующиеся данные. Чтобы сделать анализ данных более точным, нужно обработать эти бесполезные данные.
Общие этапы очистки и предварительной обработки данных:
-
Обработка пропущенных значений: выявление и заполнение пропущенных значений или удаление строк/столбцов, содержащих пропущенные значения.
-
Обработка дублирующихся данных: проверка и удаление дублирующихся данных, чтобы каждая запись была уникальной.
-
Обработка выбросов: выявление и обработка выбросов, таких как экстремальные значения и ошибочные значения.
-
Преобразование формата данных: преобразование типов данных или выполнение преобразований единиц измерения, например преобразование формата даты.
-
Стандартизация и нормализация: стандартизация (например, Z-score) или нормализация (например, Min-Max) числовых данных.
-
Кодирование категориальных данных: преобразование категориальных переменных в числовую форму. Распространённые методы включают One-Hot encoding и label encoding.
-
Обработка текста: очистка текстовых данных, например удаление стоп-слов, стемминг, токенизация и т. д.
-
Выборка данных: извлечение выборок из набора данных или обработка дисбаланса классов с помощью oversampling/undersampling.
-
Разработка признаков: создание новых признаков, удаление нерелевантных признаков, выбор важных признаков и т. д.
В этом руководстве мы будем использовать пакет Pandas для очистки данных.
Тестовые данные, используемые в этой статьеproperty-data.csv, выглядят следующим образом:
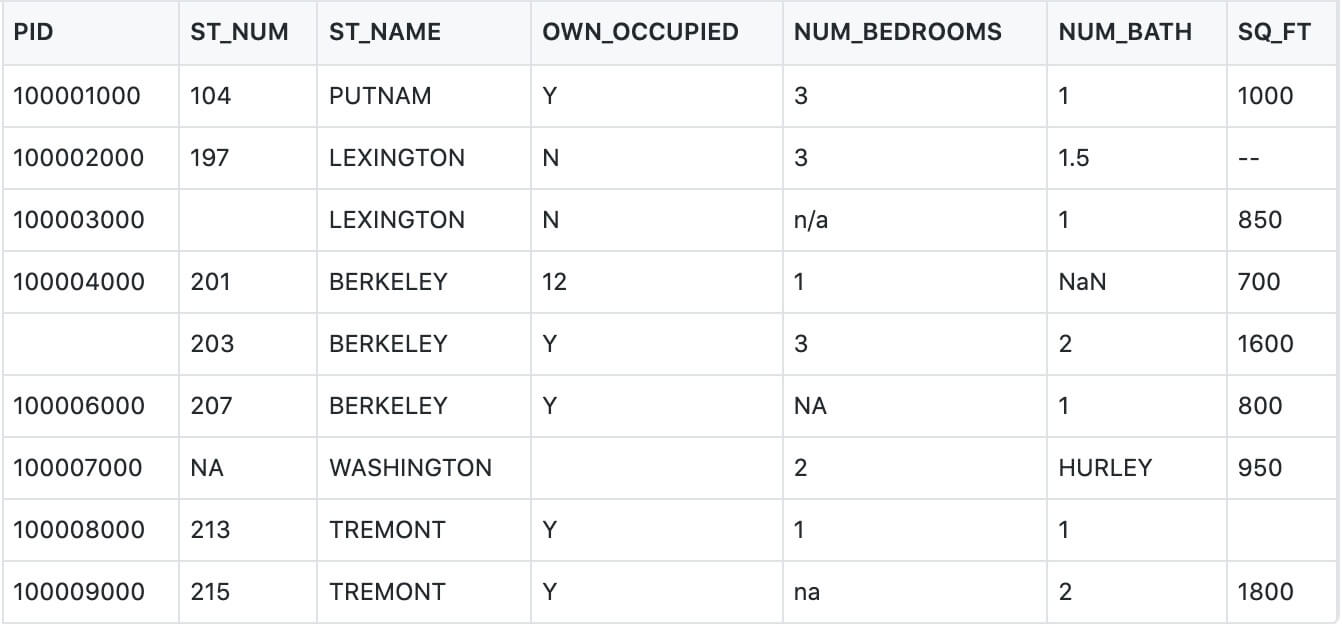
Приведённая выше таблица содержит четыре типа нулевых данных:
- n/a
- Н/Д
- —
- na
Очистка нулевых значений в Pandas
Если мы хотим удалить строки, содержащие пустые поля, мы можем использовать методdropna(), синтаксис следующий:
DataFrame.dropna(axis=0, how='any', thresh=None, subset=None, inplace=False)
Описание параметра:
- axis: по умолчанию0означает удаление всей строки при обнаружении нулевого значения; если параметр установлен вaxis=1это означает удаление всего столбца при обнаружении нулевого значения.
- how: по умолчанию'any'если какие-либо данные в строке (или столбце) содержат NA, вся строка удаляется; если установлено значениеhow='all'только когда все значения в строке (или столбце) являются NA, вся строка удаляется.
- thresh: задаёт, сколько непустых значений требуется, чтобы данные были сохранены.
- subset: задаёт столбцы, которые нужно проверить. Если столбцов несколько, можно использовать список имён столбцов в качестве параметра.
- inplace: если установлено в True, напрямую перезаписывает предыдущее значение вычисленным значением и возвращает None, изменяя исходные данные.
Мы можем использовать методisnull(), чтобы определить, пуста ли каждая ячейка.
Пример
df = pd.read_csv('property-data.csv')
print (df['NUM_BEDROOMS'])
print (df['NUM_BEDROOMS'].isnull())
Результат вывода приведённого выше примера выглядит следующим образом:
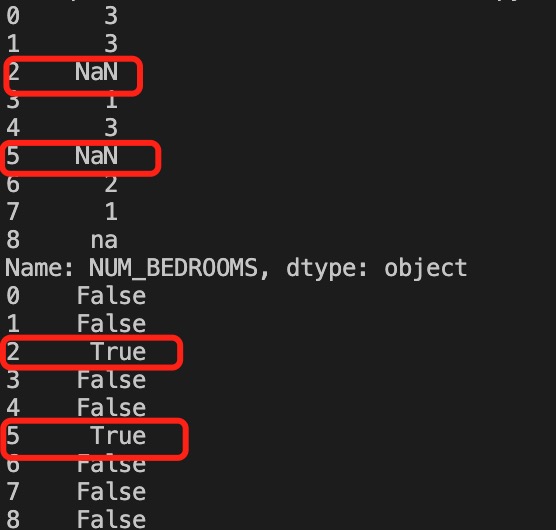
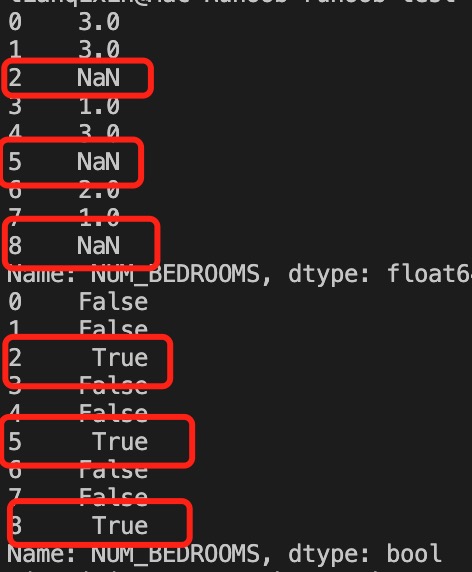
В приведённом выше примере мы видим, что Pandas обрабатывает n/a и NA как null-данные, тогда как na не является null-данными и не соответствует нашему требованию. Мы можем указать тип null-данных:
Пример
missing_values = ["n/a", "na", "--"]
df = pd.read_csv('property-data.csv', na_values = missing_values)
print (df['NUM_BEDROOMS'])
print (df['NUM_BEDROOMS'].isnull())
Результат вывода приведённого выше примера выглядит следующим образом:
Следующий пример демонстрирует удаление строк, содержащих null-данные.
Пример
df = pd.read_csv('property-data.csv')
new_df = df.dropna()
print(new_df.to_string())
Результат вывода приведённого выше примера выглядит следующим образом:
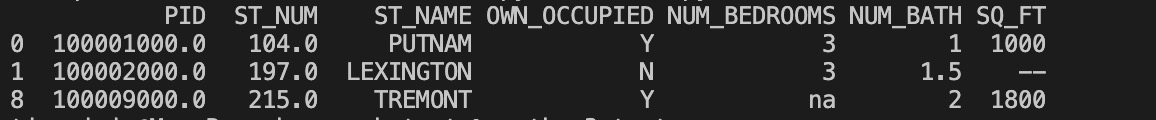
Примечание:По умолчанию метод dropna() возвращает новый DataFrame и не изменяет исходные данные.
Если вы хотите изменить исходный DataFrame, вы можете использоватьinplace = Trueпараметр:
Пример
df = pd.read_csv('property-data.csv')
df.dropna(inplace = True)
print(df.to_string())
Результат вывода приведённого выше примера выглядит следующим образом:
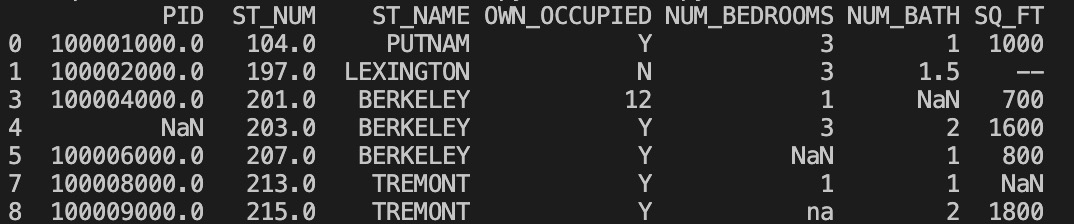
Мы также можем удалить строки, в которых указанный столбец содержит нулевые значения:
Пример
Удалить строки, в которых значение поля в столбце ST_NUM пустое:
df = pd.read_csv('property-data.csv')
df.dropna(subset=['ST_NUM'], inplace = True)
print(df.to_string())
Результат вывода приведённого выше примера выглядит следующим образом:
Мы также можем использовать методfillna()для замены некоторых пустых полей:
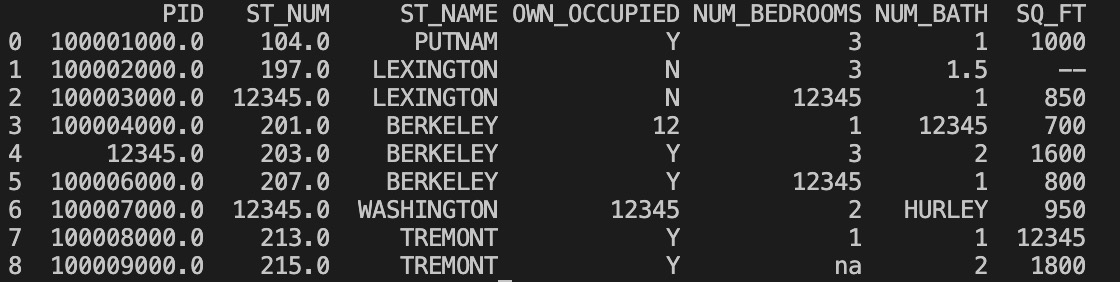
Пример
Используйте 12345 для замены пустых полей:
df = pd.read_csv('property-data.csv')
df.fillna(12345, inplace = True)
print(df.to_string())
Результат вывода приведённого выше примера выглядит следующим образом:
Мы также можем указать конкретный столбец для замены данных:
Пример
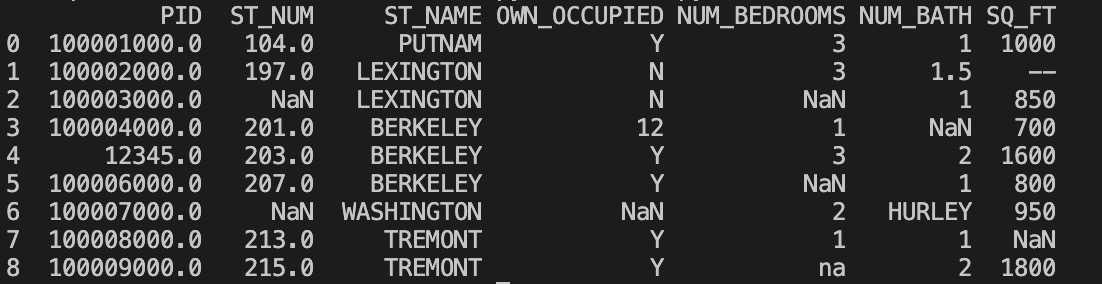
Используйте 12345 для замены нулевых данных в PID:
df = pd.read_csv('property-data.csv')
df['PID'].fillna(12345, inplace = True)
print(df.to_string())
Результат вывода приведённого выше примера выглядит следующим образом:
Распространённый метод замены пустых ячеек — вычислить среднее, медиану или моду столбца.
Pandas используетmean()、median()иmode()метод для вычисления среднего (среднего значения всех значений), медианы (среднего значения после сортировки) и моды (наиболее часто встречающегося значения) столбца.
Пример
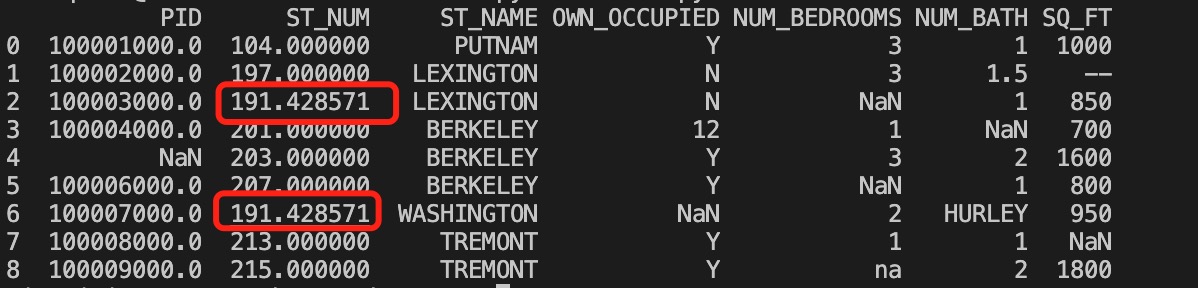
Используйте метод mean() для вычисления среднего значения столбца и замены пустых ячеек:
df = pd.read_csv('property-data.csv')
x = df["ST_NUM"].mean()
df["ST_NUM"].fillna(x, inplace = True)
print(df.to_string())
Результат вышеприведённого примера выглядит следующим образом: красная рамка — это вычисленное среднее значение, которым заменены пустые ячейки:
Пример
Используйте метод median() для вычисления медианы столбца и замены пустых ячеек:
df = pd.read_csv('property-data.csv')
x = df["ST_NUM"].median()
df["ST_NUM"].fillna(x, inplace = True)
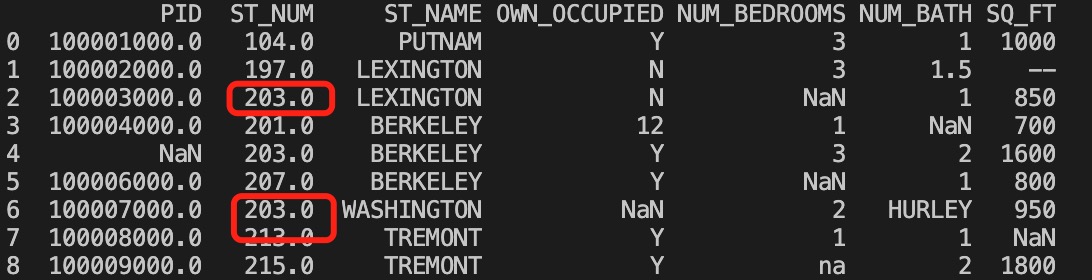
print(df.to_string())
Результат вышеприведённого примера выглядит следующим образом: красная рамка — это вычисленная медиана, которой заменены пустые ячейки:
Пример
Используйте метод mode() для вычисления моды столбца и замены пустых ячеек:
df = pd.read_csv('property-data.csv')
x = df["ST_NUM"].mode()
df["ST_NUM"].fillna(x, inplace = True)
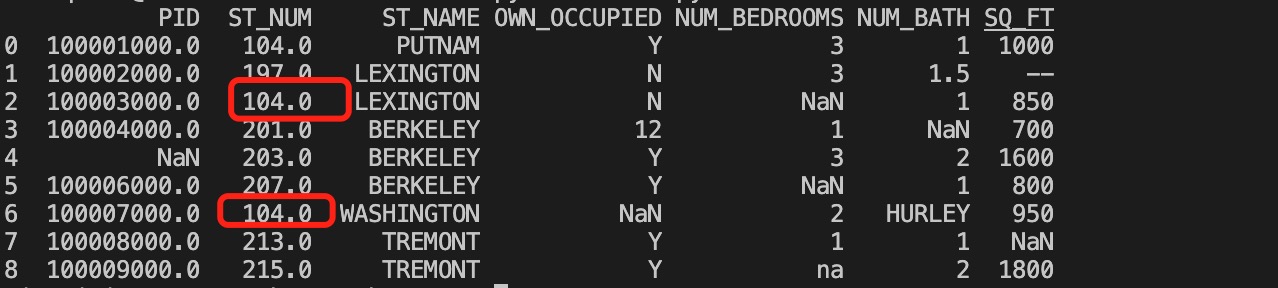
print(df.to_string())
Результат вышеприведённого примера выглядит следующим образом: красная рамка — это вычисленная мода, которой заменены пустые ячейки:
Pandas: очистка неправильно форматированных данных
Ячейки с неправильными форматами данных затрудняют анализ данных или даже делают его невозможным.
Мы можем обрабатывать строки, содержащие пустые ячейки, или преобразовывать все ячейки в столбце к данным в одном формате.
В следующем примере форматируется дата:
Пример
# У третьей даты неправильный формат
data = {
"Date": ['2020/12/01', '2020/12/02' , '20201226'],
"duration": [50, 40, 45]
}
df = pd.DataFrame(data, index = ["day1", "day2", "day3"])
df['Date'] = pd.to_datetime(df['Date'], format='mixed')
print(df.to_string())
Результат вывода приведённого выше примера выглядит следующим образом:
           Date  duration
day1 2020-12-01        50
day2 2020-12-02        40
day3 2020-12-26        45
Очистка неправильных данных в Pandas
Ошибки в данных — тоже очень распространённая ситуация. Мы можем заменить или удалить неправильные данные.
В следующем примере данные заменяются на некорректный возраст:
Пример
person = {
"name": ['Google', 'Example' , 'Taobao'],
"age": [50, 40, 12345] # Данные возраста 12345 неверны
}
df = pd.DataFrame(person)
df.loc[2, 'age'] = 30 # Изменить данные
print(df.to_string())
Результат вывода приведённого выше примера выглядит следующим образом:
     name  age
0  Google   50
1  Example   40
2  Taobao   30
Вы также можете задавать условные операторы:
Пример
Установите значение 120 для возраста больше 120:
person = {
"name": ['Google', 'Example' , 'Taobao'],
"age": [50, 200, 12345]
}
df = pd.DataFrame(person)
for x in df.index:
if df.loc[x, "age"] > 120:
df.loc[x, "age"] = 120
print(df.to_string())
Результат вывода приведённого выше примера выглядит следующим образом:
     name  age
0  Google   50
1  Example  120
2  Taobao  120
Вы также можете удалять строки с некорректными данными:
Пример
Удалите строки, в которых возраст больше 120:
person = {
"name": ['Google', 'Example' , 'Taobao'],
"age": [50, 40, 12345] # Данные возраста 12345 неверны
}
df = pd.DataFrame(person)
for x in df.index:
if df.loc[x, "age"] > 120:
df.drop(x, inplace = True)
print(df.to_string())
Результат вывода приведённого выше примера выглядит следующим образом:
     name  age
0  Google   50
1  Example   40
Очистка дублирующихся данных в Pandas
Если мы хотим очистить дублирующиеся данные, можно использоватьduplicated()иdrop_duplicates()методы.
Если соответствующие данные дублируются,duplicated()вернёт True, иначе вернёт False.
Пример
person = {
"name": ['Google', 'Example', 'Example', 'Taobao'],
"age": [50, 40, 40, 23]
}
df = pd.DataFrame(person)
print(df.duplicated())
Результат вывода приведённого выше примера выглядит следующим образом:
0    False
1    False
2     True
3    False
dtype: bool
Чтобы удалить дублирующиеся данные, можно напрямую использоватьdrop_duplicates()метод.
Пример
persons = {
"name": ['Google', 'Example', 'Example', 'Taobao'],
"age": [50, 40, 40, 23]
}
df = pd.DataFrame(persons)
df.drop_duplicates(inplace = True)
print(df)
Результат вывода приведённого выше примера выглядит следующим образом:
     name  age
0  Google   50
1  Example   40
3  Taobao   23
Общие методы и описания
Общие методы очистки и предварительной обработки данных:
| Действие | Метод/шаг | Описание | Общие функции/методы |
|---|---|---|---|
| Обработка пропущенных значений | Заполнение пропущенных значений | Заполнить пропущенные значения указанным значением (например, средним, медианой, модой и т. д.). | df.fillna(value) |
| Удаление пропущенных значений | Удалить строки или столбцы, содержащие пропущенные значения. | df.dropna() | |
| Обработка дублирующихся данных | Удаление дублирующихся данных | Удалить дублирующиеся строки в DataFrame. | df.drop_duplicates() |
| Обработка выбросов | Обнаружение выбросов (на основе статистических методов) | Выявление и обработка выбросов с использованием метода Z-score или IQR. | Пользовательская функция (например, на основе Z-score или IQR) |
| Замена выбросов | Замена выбросов подходящими значениями (например, средним или медианой). | Пользовательская функция (например, замена выбросов) | |
| Преобразование формата данных | Преобразование типов данных | Преобразование типа данных из одного типа в другой, например преобразование строки в дату. | df.astype() |
| Преобразование формата даты/времени | Преобразование строк или чисел в тип datetime. | pd.to_datetime() | |
| Стандартизация и нормализация | Стандартизация | Преобразовать данные в распределение со средним 0 и стандартным отклонением 1. | StandardScaler() |
| Нормализация | Масштабировать данные к заданному диапазону (например, [0, 1]). | MinMaxScaler() | |
| Кодирование категориальных данных | Кодирование меток | Преобразовать категориальные переменные в целочисленную форму. | LabelEncoder() |
| One-Hot Encoding | Преобразовать каждую категорию в новый бинарный признак. | pd.get_dummies() | |
| Обработка текстовых данных | Удаление стоп-слов | Удалить незначимые слова из текста, такие как "the", "is" и т. д. | Пользовательская функция (на основеnltkилиspaCy) |
| Стемминг и лемматизация | Извлечь основы или восстановить базовую форму слов. | nltk.stem.PorterStemmer() | |
| Токенизация | Разделите текст на слова или подслова. | nltk.word_tokenize() | |
| Сэмплирование данных | Случайная выборка | Случайным образом выберите определённую долю данных. | df.sample() |
| Передискретизация и субдискретизация | Сбалансируйте распределение классов в наборе данных с помощью передискретизации (дублирования образцов класса меньшинства) или субдискретизации (сокращения образцов класса большинства). | SMOTE()(Передискретизация);RandomUnderSampler()(Субдискретизация) | |
| Проектирование признаков | Отбор признаков | Выберите признаки, влияющие на целевую переменную, и удалите избыточные или нерелевантные признаки. | SelectKBest() |
| Извлечение признаков | Создавайте новые признаки из исходных данных, чтобы повысить предсказательную способность модели. | PolynomialFeatures() | |
| Масштабирование признаков | Масштабируйте числовые признаки так, чтобы они имели одинаковый масштаб. | MinMaxScaler() 、 StandardScaler() | |
| Сопоставление категориальных признаков | Сопоставление признаков | Сопоставьте категориальные переменные с соответствующими числовыми кодами. | Пользовательская функция сопоставления |
| Объединение и конкатенация данных | Объединение данных | Объединяйте несколько DataFrame по определённым столбцам с поддержкой внутреннего, внешнего, левого, правого соединения и т. д. | pd.merge() |
| Конкатенация данных | Конкатенируйте несколько DataFrame по строкам или столбцам. | pd.concat() | |
| Изменение формы данных | Сводная таблица | Группировать данные по определённым измерениям и вычислять агрегированные результаты. | pd.pivot_table() |
| Преобразование данных | Изменение формы данных, например, из длинного формата в широкий или из широкого формата в длинный. | df.melt() 、 df.pivot() | |
| Преобразование и обработка типов данных | Обработка строк | Обработка строковых данных, например удаление пробелов, преобразование регистра и т. д. | str.replace() 、 str.upper()ожидание |
| Групповые вычисления | Выполнять агрегирование после группировки по определённому признаку. | df.groupby() | |
| Прогнозное заполнение пропущенных значений | Использовать модели для прогнозирования и заполнения пропущенных значений | Использовать модели машинного обучения (например, регрессионные модели) для прогнозирования пропущенных значений и заполнения пропущенных данных. | Пользовательская модель (например,sklearn.linear_model.LinearRegression) |
| Обработка временных рядов | Заполнение пропущенных значений во временных рядах | Используйте методы временных рядов (такие как прямое заполнение, обратное заполнение) для заполнения пропущенных значений. | df.fillna(method='ffill') |
| Расчёт скользящего окна | Используйте скользящее окно для выполнения статистических расчётов по данным временного ряда (например, среднее, стандартное отклонение и т. д.). | df.rolling(window=5).mean() | |
| Преобразование данных и сопоставление | Сопоставление и замена данных | Заменяйте определённые значения в данных на другие значения. | df.replace() |
Заполнение пропущенных значений:
Пример
# Пример данных
data = {'Name': ['Alice', 'Bob', 'Charlie', None],
'Age': [25, 30, None, 35],
'City': ['Нью-Йорк', 'Лос-Анджелес', 'Чикаго', 'Хьюстон']}
df = pd.DataFrame(data)
# Заполнить пропущенные значения "Age" средним значением
df['Age'].fillna(df['Age'].mean(), inplace=True)
print(df)
Вывод:
      Name  Age           City
0    Alice   25.0       New York
1      Bob   30.0    Los Angeles
2  Charlie   30.0        Chicago
3     None   35.0        Houston
Унитарное кодирование:
Пример
# Пример данных
data = {'City': ['Нью-Йорк', 'Лос-Анджелес', 'Чикаго', 'Хьюстон']}
df = pd.DataFrame(data)
# Выполнить унитарное кодирование для столбца "City"
df_encoded = pd.get_dummies(df, columns=['City'])
print(df_encoded)
Вывод:
   City_Chicago  City_Houston  City_Los Angeles  City_New York
0             0             0                 0              1
1             0             0                 1              0
2             1             0                 0              0
3             0             1                 0              0
Стандартизация:
Пример
import pandas as pd
# Пример данных
data = {'Age': [25, 30, 35, 40, 45],
'Зарплата': [50000, 60000, 70000, 80000, 90000]}
df = pd.DataFrame(data)
# Стандартизация данных
scaler = StandardScaler()
df_scaled = scaler.fit_transform(df)
print(df_scaled)
Вывод:
[[-1.41421356 -1.41421356]
 [-0.70710678 -0.70710678]
 [ 0.          0.        ]
 [ 0.70710678  0.70710678]
 [ 1.41421356  1.41421356]]
Другие расширения