Limpieza de datos con Pandas
La limpieza de datos es el proceso de tratar los datos que no son útiles.
Muchos conjuntos de datos contienen valores faltantes, formatos incorrectos, datos erróneos o datos duplicados. Para que el análisis de datos sea más preciso, es necesario tratar estos datos no útiles.
Pasos comunes de limpieza y preprocesamiento de datos:
-
Tratamiento de valores faltantes: identificar y completar los valores faltantes, o eliminar filas/columnas con valores faltantes.
-
Tratamiento de datos duplicados: revisar y eliminar datos duplicados, asegurando que cada dato sea único.
-
Tratamiento de valores atípicos: identificar y tratar valores atípicos, como valores extremos o erróneos.
-
Conversión de formato de datos: convertir el tipo de dato o realizar conversiones de unidades, como la conversión de formatos de fecha.
-
Estandarización y normalización: estandarizar (p. ej., puntuación Z) o normalizar (p. ej., Min-Max) los datos numéricos.
-
Codificación de datos categóricos: convertir variables categóricas a forma numérica; los métodos comunes incluyen codificación One-Hot y codificación de etiquetas.
-
Procesamiento de texto: limpiar datos de texto, como eliminar palabras vacías, derivación/flexión, tokenización, etc.
-
Muestreo de datos: extraer muestras del conjunto de datos, o tratar el desequilibrio de clases mediante sobremuestreo/submuestreo.
-
Ingeniería de características: crear nuevas características, eliminar características irrelevantes, seleccionar características importantes, etc.
En este tutorial, utilizaremos el paquete Pandas para la limpieza de datos.
Los datos de prueba utilizados en este artículoproperty-data.csvson los siguientes:
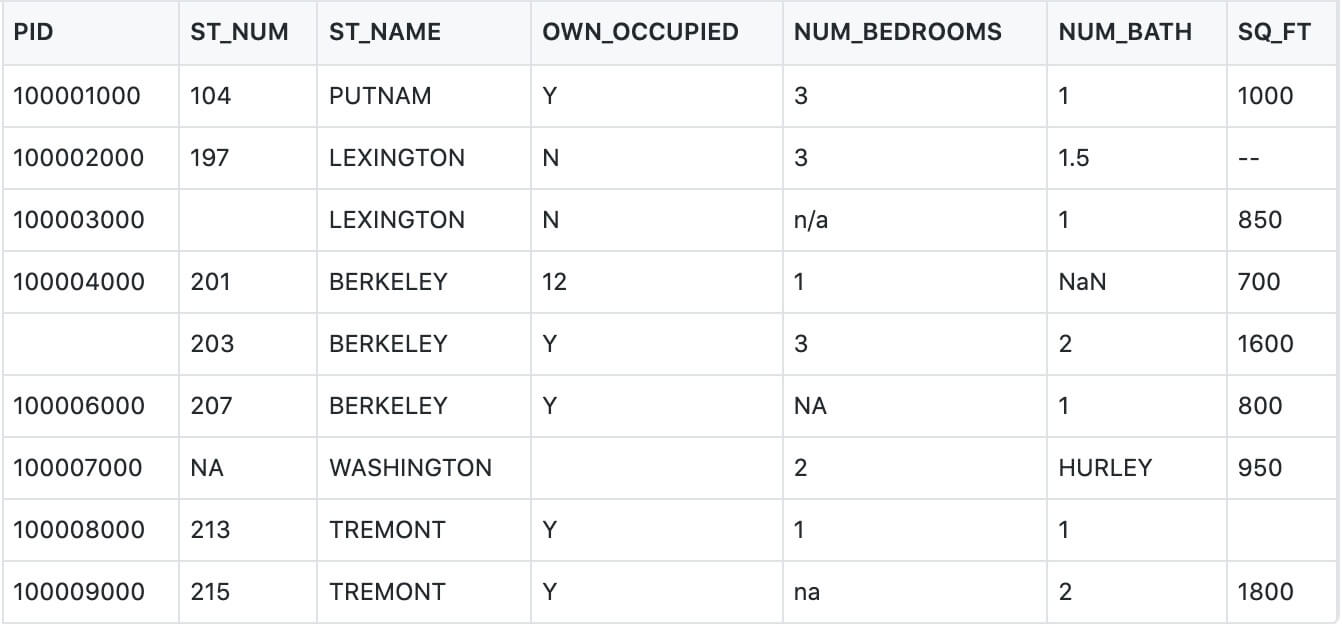
La tabla anterior contiene cuatro tipos de datos vacíos:
- n/a
- NA
- —
- na
Pandas: limpieza de valores nulos
Si queremos eliminar las filas que contienen campos vacíos, podemos usardropna()el método, cuya sintaxis es la siguiente:
DataFrame.dropna(axis=0, how='any', thresh=None, subset=None, inplace=False)
Descripción de parámetros:
- axis: el valor predeterminado es0, lo que significa que si hay un valor nulo se elimina toda la fila. Si se establece el parámetroaxis=1significa que si hay un valor nulo se elimina toda la columna.
- how: el valor predeterminado es'any'si cualquier dato en una fila (o columna) tiene NA, se elimina toda la fila. Si se establecehow='all'solo si toda la fila (o columna) tiene NA se elimina esa fila.
- thresh: establece cuántos valores no nulos se necesitan para conservar los datos.
- subset: establece las columnas que se desean revisar. Si son varias columnas, se puede usar una lista de nombres de columnas como parámetro.
- inplace: si se establece en True, sobrescribe directamente el valor original con el valor calculado y devuelve None, modificando los datos de origen.
Podemos usarisnull()para comprobar si cada celda está vacía.
Ejemplo
df = pd.read_csv('property-data.csv')
print (df['NUM_BEDROOMS'])
print (df['NUM_BEDROOMS'].isnull())
El resultado del ejemplo anterior es el siguiente:
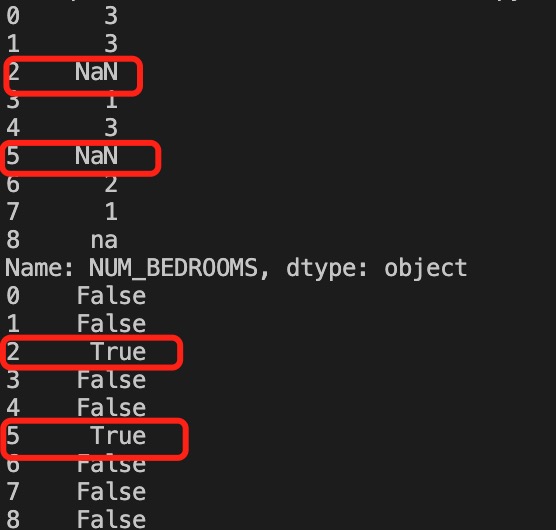
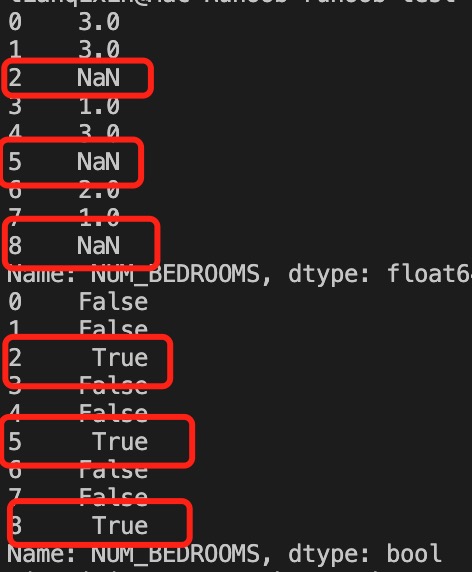
En el ejemplo anterior, vemos que Pandas trata "n/a" y "NA" como datos vacíos; "na" no se considera dato vacío y no cumple con nuestro requisito. Podemos especificar los tipos de datos vacíos:
Ejemplo
missing_values = ["n/a", "na", "--"]
df = pd.read_csv('property-data.csv', na_values = missing_values)
print (df['NUM_BEDROOMS'])
print (df['NUM_BEDROOMS'].isnull())
El resultado del ejemplo anterior es el siguiente:
El siguiente ejemplo demuestra cómo eliminar filas que contienen datos vacíos.
Ejemplo
df = pd.read_csv('property-data.csv')
new_df = df.dropna()
print(new_df.to_string())
El resultado del ejemplo anterior es el siguiente:
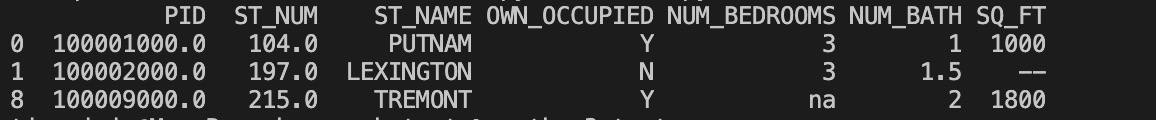
Nota:De forma predeterminada, el método dropna() devuelve un nuevo DataFrame y no modifica los datos de origen.
Si desea modificar el DataFrame de origen, puede usarinplace = Trueel parámetro:
Ejemplo
df = pd.read_csv('property-data.csv')
df.dropna(inplace = True)
print(df.to_string())
El resultado del ejemplo anterior es el siguiente:
También podemos eliminar las filas que tienen valores nulos en una columna específica:
Ejemplo
Eliminar las filas donde el valor del campo en la columna ST_NUM esté vacío:
df = pd.read_csv('property-data.csv')
df.dropna(subset=['ST_NUM'], inplace = True)
print(df.to_string())
El resultado del ejemplo anterior es el siguiente:
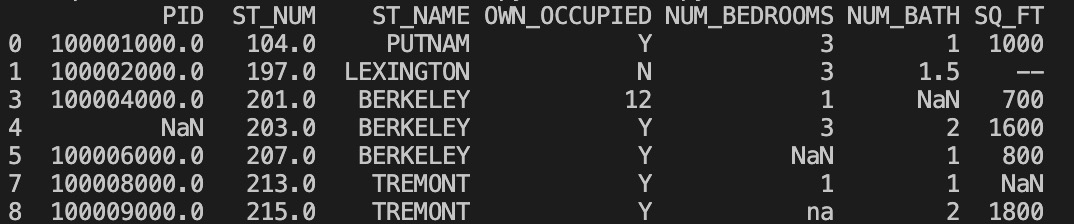
También podemos usar elfillna()método para reemplazar algunos campos vacíos:
Ejemplo
Usar 12345 para reemplazar los campos vacíos:
df = pd.read_csv('property-data.csv')
df.fillna(12345, inplace = True)
print(df.to_string())
El resultado del ejemplo anterior es el siguiente:
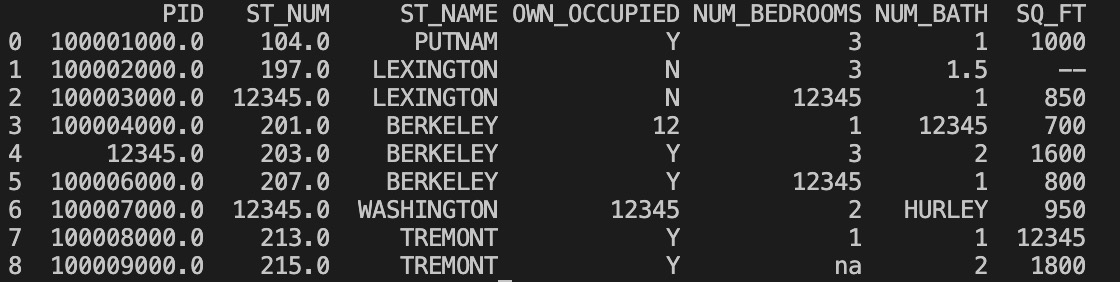
También podemos especificar una columna concreta para reemplazar datos:
Ejemplo
Usar 12345 para reemplazar los datos vacíos en PID:
df = pd.read_csv('property-data.csv')
df['PID'].fillna(12345, inplace = True)
print(df.to_string())
El resultado del ejemplo anterior es el siguiente:
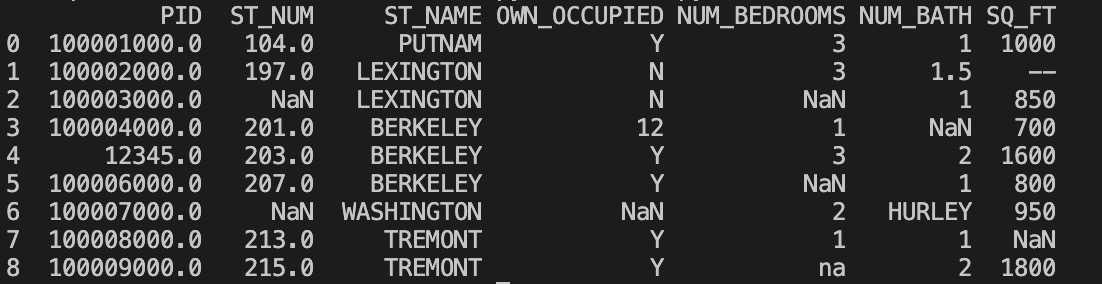
Un método común para reemplazar celdas vacías es calcular la media, la mediana o la moda de la columna.
Pandas usa losmean()、median()ymode()métodos para calcular la media (el promedio de todos los valores), la mediana (el valor que queda en el medio después de ordenar) y la moda (el valor que aparece con mayor frecuencia) de la columna.
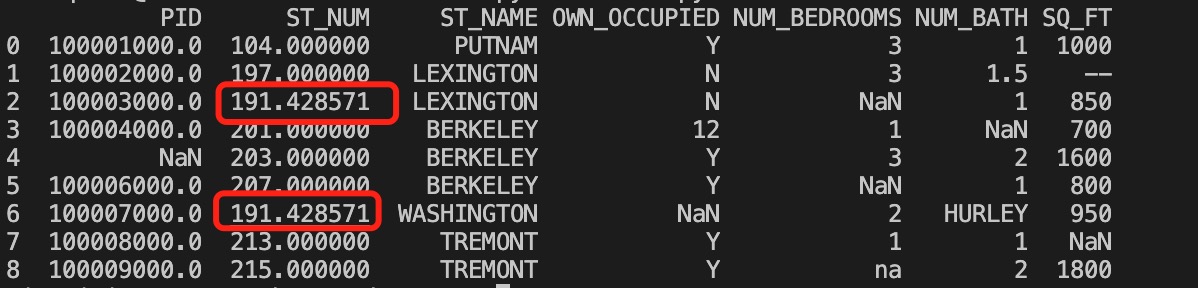
Ejemplo
Usar el método mean() para calcular la media de la columna y reemplazar las celdas vacías:
df = pd.read_csv('property-data.csv')
x = df["ST_NUM"].mean()
df["ST_NUM"].fillna(x, inplace = True)
print(df.to_string())
El resultado del ejemplo anterior es el siguiente; el recuadro rojo muestra las celdas vacías reemplazadas por la media calculada.
Ejemplo
Usar el método median() para calcular la mediana de la columna y reemplazar las celdas vacías:
df = pd.read_csv('property-data.csv')
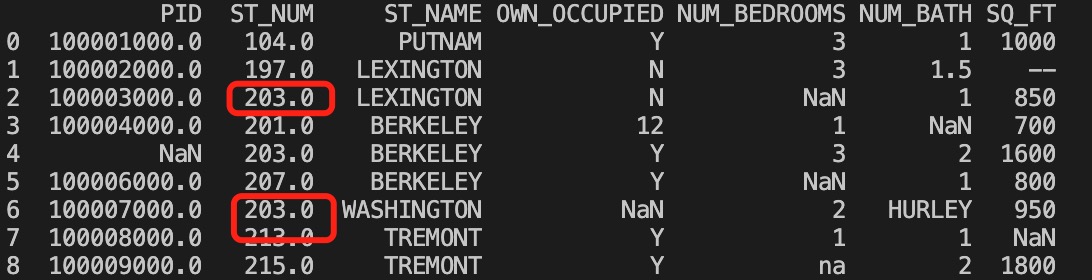
x = df["ST_NUM"].median()
df["ST_NUM"].fillna(x, inplace = True)
print(df.to_string())
El resultado del ejemplo anterior es el siguiente; el recuadro rojo muestra las celdas vacías reemplazadas por la mediana calculada.
Ejemplo
Usar el método mode() para calcular la moda de la columna y reemplazar las celdas vacías:
df = pd.read_csv('property-data.csv')
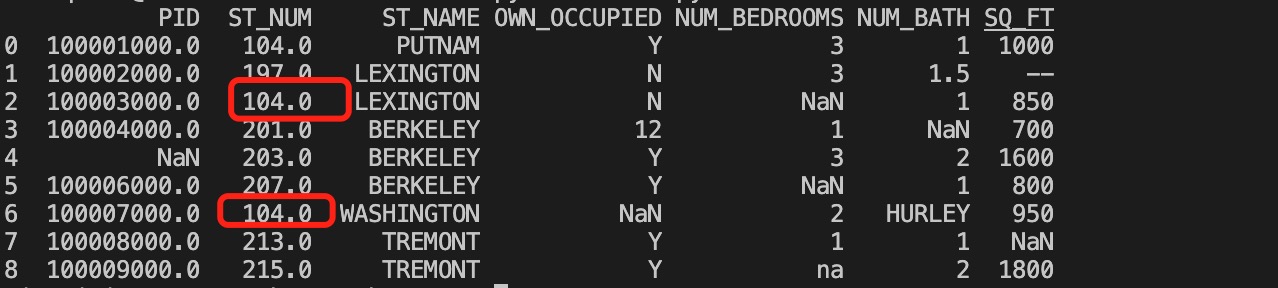
x = df["ST_NUM"].mode()
df["ST_NUM"].fillna(x, inplace = True)
print(df.to_string())
El resultado del ejemplo anterior es el siguiente; el recuadro rojo muestra las celdas vacías reemplazadas por la moda calculada.
Pandas: limpieza de datos con formato incorrecto
Las celdas con formato de datos incorrecto dificultan el análisis de datos, e incluso pueden hacerlo imposible.
Podemos eliminar las filas que contienen celdas vacías, o convertir todas las celdas de una columna al mismo formato de datos.
El siguiente ejemplo formateará las fechas:
Ejemplo
# El formato de la tercera fecha es incorrecto
data = {
"Date": ['2020/12/01', '2020/12/02' , '20201226'],
"duration": [50, 40, 45]
}
df = pd.DataFrame(data, index = ["day1", "day2", "day3"])
df['Date'] = pd.to_datetime(df['Date'], format='mixed')
print(df.to_string())
El resultado del ejemplo anterior es el siguiente:
           Date  duration
day1 2020-12-01        50
day2 2020-12-02        40
day3 2020-12-26        45
Pandas: limpieza de datos erróneos
Los datos erróneos también son muy comunes; podemos reemplazarlos o eliminarlos.
El siguiente ejemplo reemplazará los datos de edad erróneos:
Ejemplo
person = {
"name": ['Google', 'Ejemplo' , 'Taobao'],
"age": [50, 40, 12345] # El dato de edad 12345 es incorrecto
}
df = pd.DataFrame(person)
df.loc[2, 'age'] = 30 # Modificar los datos
print(df.to_string())
El resultado del ejemplo anterior es el siguiente:
     name  age
0  Google   50
1  Ejemplo   40
2  Taobao   30
También se pueden establecer declaraciones condicionales:
Ejemplo
Establecer en 120 los valores de age mayores que 120:
person = {
"name": ['Google', 'Ejemplo' , 'Taobao'],
"age": [50, 200, 12345]
}
df = pd.DataFrame(person)
for x in df.index:
if df.loc[x, "age"] > 120:
df.loc[x, "age"] = 120
print(df.to_string())
El resultado del ejemplo anterior es el siguiente:
     name  age
0  Google   50
1  Ejemplo  120
2  Taobao  120
También se pueden eliminar las filas con datos erróneos:
Ejemplo
Eliminar los valores de age mayores que 120:
person = {
"name": ['Google', 'Ejemplo' , 'Taobao'],
"age": [50, 40, 12345] # El dato de edad 12345 es incorrecto
}
df = pd.DataFrame(person)
for x in df.index:
if df.loc[x, "age"] > 120:
df.drop(x, inplace = True)
print(df.to_string())
El resultado del ejemplo anterior es el siguiente:
     name  age
0  Google   50
1  Ejemplo   40
Pandas: limpieza de datos duplicados
Si queremos limpiar datos duplicados, podemos usarduplicated()ydrop_duplicates()el método.
Si el dato correspondiente está duplicado,duplicated()devolverá True; de lo contrario, devolverá False.
Ejemplo
person = {
"name": ['Google', 'Ejemplo', 'Ejemplo', 'Taobao'],
"age": [50, 40, 40, 23]
}
df = pd.DataFrame(person)
print(df.duplicated())
El resultado del ejemplo anterior es el siguiente:
0    False
1    False
2     True
3    False
dtype: bool
Para eliminar datos duplicados, se puede usar directamente eldrop_duplicates()método.
Ejemplo
persons = {
"name": ['Google', 'Ejemplo', 'Ejemplo', 'Taobao'],
"age": [50, 40, 40, 23]
}
df = pd.DataFrame(persons)
df.drop_duplicates(inplace = True)
print(df)
El resultado del ejemplo anterior es el siguiente:
     name  age
0  Google   50
1  Ejemplo   40
3  Taobao   23
Métodos comunes y su descripción
Métodos comunes de limpieza y preprocesamiento de datos:
| Operación | Método/Paso | Descripción | Funciones/métodos comunes |
|---|---|---|---|
| Tratamiento de valores faltantes | Rellenar valores faltantes | Rellenar los valores faltantes con el valor especificado (como la media, la mediana, la moda, etc.). | df.fillna(value) |
| Eliminar valores faltantes | Eliminar filas o columnas que contienen valores faltantes. | df.dropna() | |
| Tratamiento de datos duplicados | Eliminar datos duplicados | Eliminar las filas duplicadas en el DataFrame. | df.drop_duplicates() |
| Tratamiento de valores atípicos | Detección de valores atípicos (basada en métodos estadísticos) | Identificar y tratar valores atípicos mediante el método Z-score o IQR. | Función personalizada (como basada en Z-score o IQR) |
| Reemplazar valores atípicos | Reemplazar los valores atípicos con un valor adecuado (como la media o la mediana). | Función personalizada (como reemplazo de valores atípicos) | |
| Conversión de formato de datos | Convertir el tipo de datos | Convertir un tipo de dato a otro, como convertir cadenas a fechas. | df.astype() |
| Conversión de formato de fecha y hora | Convertir cadenas o números a tipo de fecha y hora. | pd.to_datetime() | |
| Estandarización y normalización | Estandarización | Convertir los datos a una distribución con media 0 y desviación estándar 1. | StandardScaler() |
| Normalización | Escalar los datos a un rango especificado (por ejemplo, [0, 1]). | MinMaxScaler() | |
| Codificación de datos categóricos | Codificación de etiquetas | Convertir variables categóricas a forma entera. | LabelEncoder() |
| Codificación one-hot (One-Hot Encoding) | Convertir cada categoría en una nueva característica binaria. | pd.get_dummies() | |
| Procesamiento de datos de texto | Eliminación de palabras vacías | Eliminar del texto palabras irrelevantes como "the", "is", etc. | Función personalizada (basada ennltkospaCy) |
| Stemming y lematización | Extraer la raíz o recuperar la forma base de las palabras. | nltk.stem.PorterStemmer() | |
| Tokenización | Dividir el texto en palabras o subpalabras. | nltk.word_tokenize() | |
| Muestreo de datos | Muestreo aleatorio | Extraer aleatoriamente una proporción de muestras de los datos. | df.sample() |
| Sobremuestreo y submuestreo | Equilibrar la distribución de clases en el conjunto de datos mediante sobremuestreo (duplicar muestras de la clase minoritaria) o submuestreo (reducir muestras de la clase mayoritaria). | SMOTE()(sobremuestreo);RandomUnderSampler()(submuestreo) | |
| Ingeniería de características | Selección de características | Seleccionar características que influyen en la variable objetivo y eliminar características redundantes o irrelevantes. | SelectKBest() |
| Extracción de características | Crear nuevas características a partir de los datos originales para mejorar la capacidad predictiva del modelo. | PolynomialFeatures() | |
| Escalado de características | Escalar las características numéricas para que tengan la misma magnitud. | MinMaxScaler() 、 StandardScaler() | |
| Mapeo de características categóricas | Mapeo de características | Mapear variables categóricas a códigos numéricos correspondientes. | Función de mapeo personalizada |
| Combinación y unión de datos | Combinar datos | Combinar varios DataFrames según ciertas columnas, admitiendo uniones internas, externas, izquierdas, derechas, etc. | pd.merge() |
| Unir datos | Concatenar varios DataFrames por filas o columnas. | pd.concat() | |
| Remodelación de datos | Tabla dinámica | Agrupar los datos según ciertas dimensiones y calcular resultados agregados. | pd.pivot_table() |
| Transformación de forma de datos | Cambiar la forma de los datos, por ejemplo, de formato largo a ancho o de ancho a largo. | df.melt() 、 df.pivot() | |
| Conversión y procesamiento de tipos de datos | Procesamiento de cadenas | Procesar datos de cadena, como eliminar espacios, cambiar mayúsculas/minúsculas, etc. | str.replace() 、 str.upper()esperar |
| Cálculo por grupos | Agrupar según una característica y realizar cálculos agregados. | df.groupby() | |
| Relleno de valores faltantes mediante predicción | Usar un modelo para predecir y completar valores faltantes | Usar modelos de aprendizaje automático (como modelos de regresión) para predecir valores faltantes y completar los datos faltantes. | Modelo personalizado (comosklearn.linear_model.LinearRegression) |
| Procesamiento de series temporales | Relleno de valores faltantes en series temporales | Utilizar métodos de series temporales (como relleno hacia adelante, relleno hacia atrás) para completar valores faltantes. | df.fillna(method='ffill') |
| Cálculo de ventana móvil | Utilizar una ventana deslizante para realizar cálculos estadísticos en datos de series temporales (como media, desviación estándar, etc.). | df.rolling(window=5).mean() | |
| Conversión y mapeo de datos | Mapeo y reemplazo de datos | Reemplazar ciertos valores en los datos por otros valores. | df.replace() |
Rellenar valores faltantes:
Ejemplo
# Datos de ejemplo
data = {'Name': ['Alice', 'Bob', 'Charlie', None],
'Age': [25, 30, None, 35],
'City': ['New York', 'Los Angeles', 'Chicago', 'Houston']}
df = pd.DataFrame(data)
# Rellenar la "Age" faltante con la media
df['Age'].fillna(df['Age'].mean(), inplace=True)
print(df)
Salida:
      Name  Age           City
0    Alice   25.0       New York
1      Bob   30.0    Los Angeles
2  Charlie   30.0        Chicago
3     None   35.0        Houston
Codificación one-hot:
Ejemplo
# Datos de ejemplo
data = {'City': ['New York', 'Los Angeles', 'Chicago', 'Houston']}
df = pd.DataFrame(data)
# Aplicar codificación One-Hot a la columna "City"
df_encoded = pd.get_dummies(df, columns=['City'])
print(df_encoded)
Salida:
   City_Chicago  City_Houston  City_Los Angeles  City_New York
0             0             0                 0              1
1             0             0                 1              0
2             1             0                 0              0
3             0             1                 0              0
Estandarización:
Ejemplo
import pandas as pd
# Datos de ejemplo
data = {'Age': [25, 30, 35, 40, 45],
'Salary': [50000, 60000, 70000, 80000, 90000]}
df = pd.DataFrame(data)
# Estandarizar datos
scaler = StandardScaler()
df_scaled = scaler.fit_transform(df)
print(df_scaled)
Salida:
[[-1.41421356 -1.41421356]
 [-0.70710678 -0.70710678]
 [ 0.          0.        ]
 [ 0.70710678  0.70710678]
 [ 1.41421356  1.41421356]]
Otras extensiones