Nettoyage de données avec Pandas
Le nettoyage des données est le processus de traitement des données inutiles.
De nombreux jeux de données contiennent des données manquantes, des formats de données incorrects, des données erronées ou des données en double. Pour rendre l'analyse des données plus précise, vous devez traiter ces données inutiles.
Étapes courantes du nettoyage et du prétraitement des données :
-
Traitement des valeurs manquantes: Identifier et remplir les valeurs manquantes, ou supprimer les lignes/colonnes contenant des valeurs manquantes.
-
Traitement des données en double: Vérifier et supprimer les données en double pour garantir que chaque enregistrement est unique.
-
Traitement des valeurs aberrantes: Identifier et traiter les valeurs aberrantes, telles que les valeurs extrêmes et les valeurs erronées.
-
Conversion de format de données: Convertir les types de données ou effectuer des conversions d'unités, telles que la conversion de format de date.
-
Standardisation et normalisation: Standardiser (par exemple, Z-score) ou normaliser (par exemple, Min-Max) les données numériques.
-
Encodage des données catégorielles: Convertir les variables catégorielles en forme numérique. Les méthodes courantes incluent l'encodage One-Hot et l'encodage par étiquette.
-
Traitement de texte: Nettoyer les données textuelles, telles que la suppression des mots vides, la racinisation, la tokenisation, etc.
-
Échantillonnage des données: Tirer des échantillons de l'ensemble de données, ou gérer le déséquilibre des classes par suréchantillonnage/sous-échantillonnage.
-
Ingénierie des caractéristiques: Créer de nouvelles caractéristiques, supprimer les caractéristiques non pertinentes, sélectionner les caractéristiques importantes, etc.
Dans ce tutoriel, nous utiliserons le package Pandas pour le nettoyage des données.
Les données de test utilisées dans cet articleproperty-data.csvsont les suivantes :
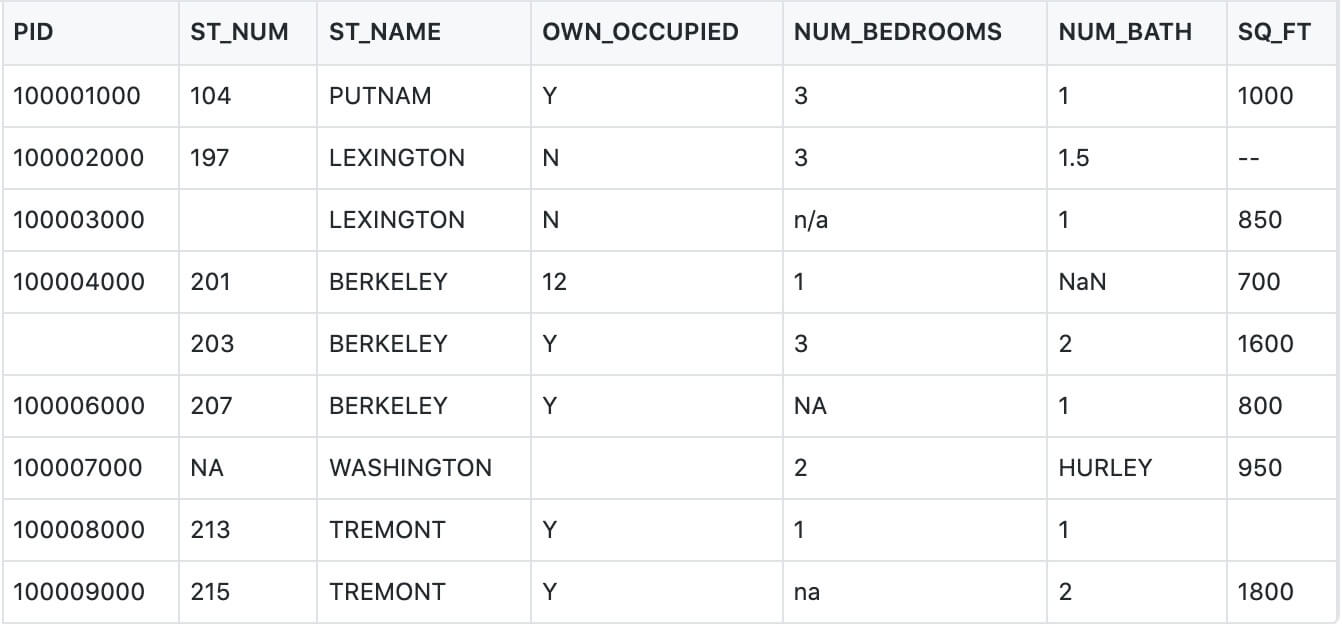
Le tableau ci-dessus contient quatre types de données nulles :
- n/a
- N/D
- —
- na
Nettoyage des valeurs nulles avec Pandas
Si nous voulons supprimer les lignes contenant des champs vides, nous pouvons utiliser la méthodedropna(), la syntaxe est la suivante :
DataFrame.dropna(axis=0, how='any', thresh=None, subset=None, inplace=False)
Description du paramètre :
- axis : par défaut,0signifie supprimer la ligne entière lorsqu'une valeur nulle est rencontrée ; si le paramètre est défini suraxis=1cela signifie supprimer la colonne entière lorsqu'une valeur nulle est rencontrée.
- how : par défaut,'any'si une donnée dans une ligne (ou colonne) contient NA, la ligne entière est supprimée ; s'il est défini surhow='all', la ligne entière n'est supprimée que lorsque toutes les valeurs d'une ligne (ou colonne) sont NA.
- thresh : définir combien de valeurs non nulles sont nécessaires pour conserver les données.
- subset : définir les colonnes que vous souhaitez vérifier. S'il y a plusieurs colonnes, vous pouvez utiliser une liste de noms de colonnes comme paramètre.
- inplace : s'il est défini sur True, écrase directement la valeur précédente avec la valeur calculée et renvoie None, ce qui modifie les données source.
Nous pouvons utiliser la méthodeisnull()pour déterminer si chaque cellule est vide.
Exemple
df = pd.read_csv('property-data.csv')
print (df['NUM_BEDROOMS'])
print (df['NUM_BEDROOMS'].isnull())
Le résultat de sortie de l'exemple ci-dessus est le suivant :
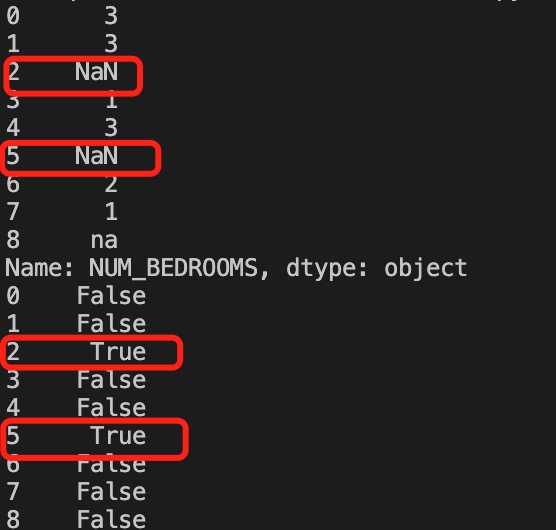
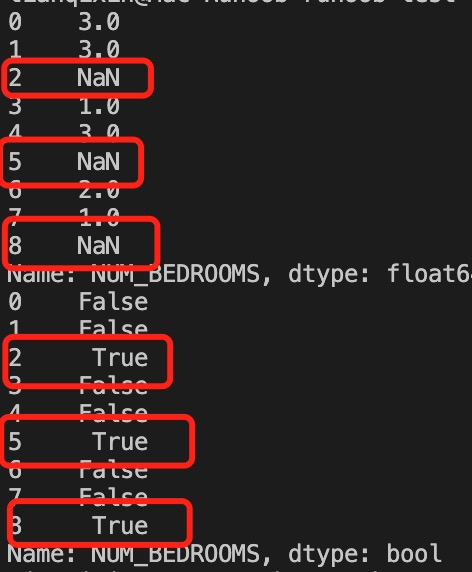
Dans l'exemple ci-dessus, nous voyons que Pandas traite n/a et NA comme des données nulles, tandis que na n'est pas une donnée nulle et ne répond pas à notre exigence. Nous pouvons spécifier le type de données nulles :
Exemple
missing_values = ["n/a", "na", "--"]
df = pd.read_csv('property-data.csv', na_values = missing_values)
print (df['NUM_BEDROOMS'])
print (df['NUM_BEDROOMS'].isnull())
Le résultat de sortie de l'exemple ci-dessus est le suivant :
L'exemple suivant montre comment supprimer des lignes contenant des données nulles.
Exemple
df = pd.read_csv('property-data.csv')
new_df = df.dropna()
print(new_df.to_string())
Le résultat de sortie de l'exemple ci-dessus est le suivant :
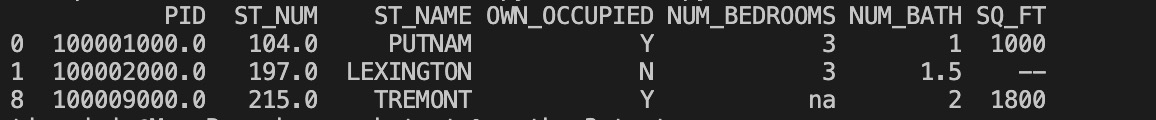
Remarque :Par défaut, la méthode dropna() renvoie un nouveau DataFrame et ne modifie pas les données source.
Si vous souhaitez modifier le DataFrame source, vous pouvez utiliser leinplace = Trueparamètre :
Exemple
df = pd.read_csv('property-data.csv')
df.dropna(inplace = True)
print(df.to_string())
Le résultat de sortie de l'exemple ci-dessus est le suivant :
Nous pouvons également supprimer les lignes où une colonne spécifiée contient des valeurs nulles :
Exemple
Supprimer les lignes où la valeur du champ dans la colonne ST_NUM est vide :
df = pd.read_csv('property-data.csv')
df.dropna(subset=['ST_NUM'], inplace = True)
print(df.to_string())
Le résultat de sortie de l'exemple ci-dessus est le suivant :
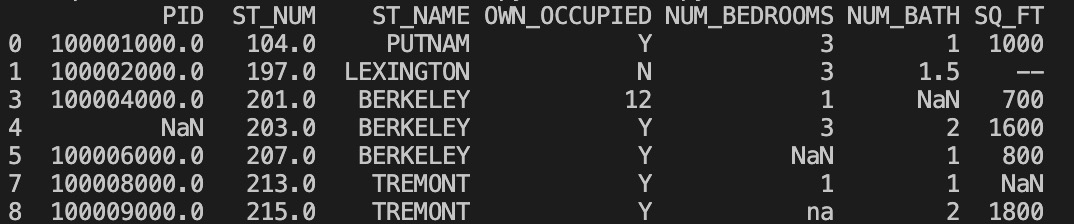
Nous pouvons également utiliser la méthodefillna()pour remplacer certains champs vides :
Exemple
Utilisez 12345 pour remplacer les champs vides :
df = pd.read_csv('property-data.csv')
df.fillna(12345, inplace = True)
print(df.to_string())
Le résultat de sortie de l'exemple ci-dessus est le suivant :
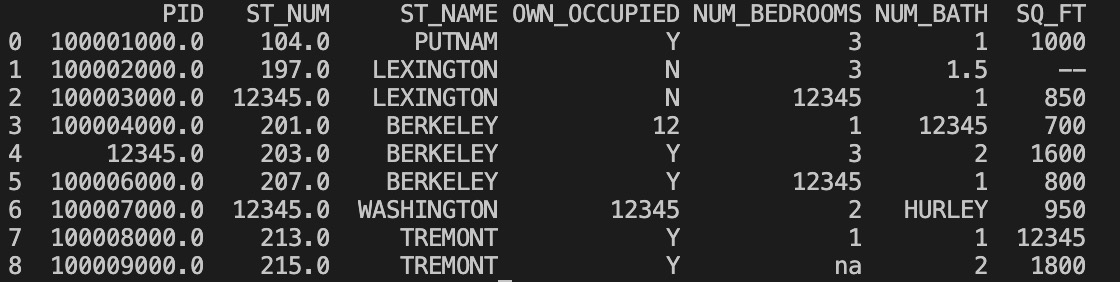
Nous pouvons également spécifier une colonne particulière pour remplacer les données :
Exemple
Utilisez 12345 pour remplacer les données nulles dans PID :
df = pd.read_csv('property-data.csv')
df['PID'].fillna(12345, inplace = True)
print(df.to_string())
Le résultat de sortie de l'exemple ci-dessus est le suivant :
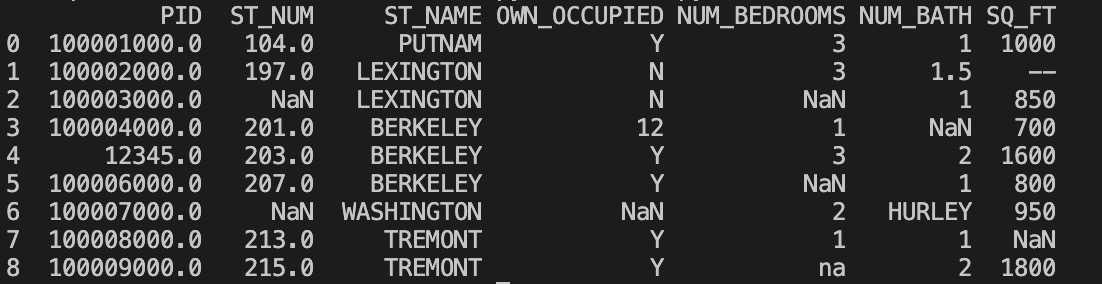
Une méthode courante pour remplacer les cellules vides consiste à calculer la moyenne, la médiane ou le mode de la colonne.
Pandas utilise les méthodesmean(),、median()etmode()pour calculer la moyenne (la moyenne de toutes les valeurs), la médiane (la valeur centrale après tri) et le mode (la valeur la plus fréquente) d'une colonne.
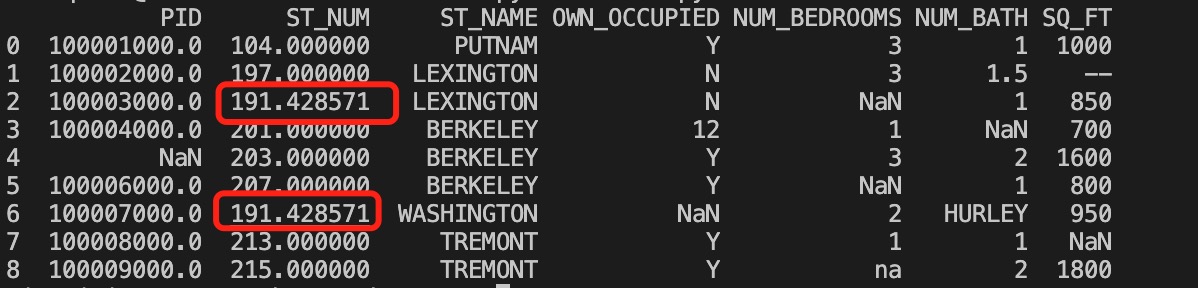
Exemple
Utilisez la méthode mean() pour calculer la moyenne de la colonne et remplacer les cellules vides :
df = pd.read_csv('property-data.csv')
x = df["ST_NUM"].mean()
df["ST_NUM"].fillna(x, inplace = True)
print(df.to_string())
Le résultat de sortie de l'exemple ci-dessus est le suivant ; l'encadré rouge correspond à la moyenne calculée qui a remplacé les cellules vides :
Exemple
Utilisez la méthode median() pour calculer la médiane de la colonne et remplacer les cellules vides :
df = pd.read_csv('property-data.csv')
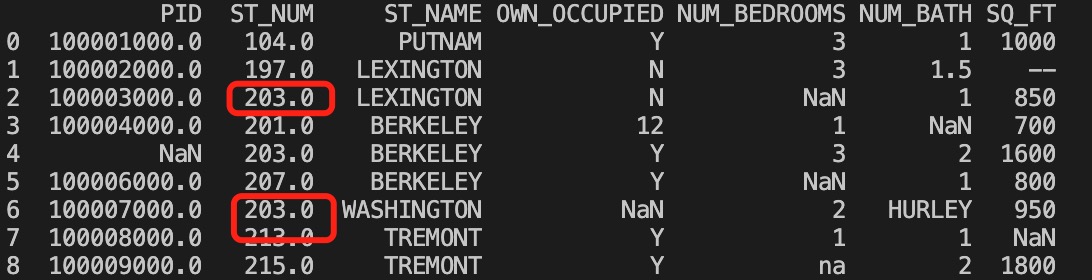
x = df["ST_NUM"].median()
df["ST_NUM"].fillna(x, inplace = True)
print(df.to_string())
Le résultat de sortie de l'exemple ci-dessus est le suivant ; l'encadré rouge correspond à la médiane calculée qui a remplacé les cellules vides :
Exemple
Utilisez la méthode mode() pour calculer le mode de la colonne et remplacer les cellules vides :
df = pd.read_csv('property-data.csv')
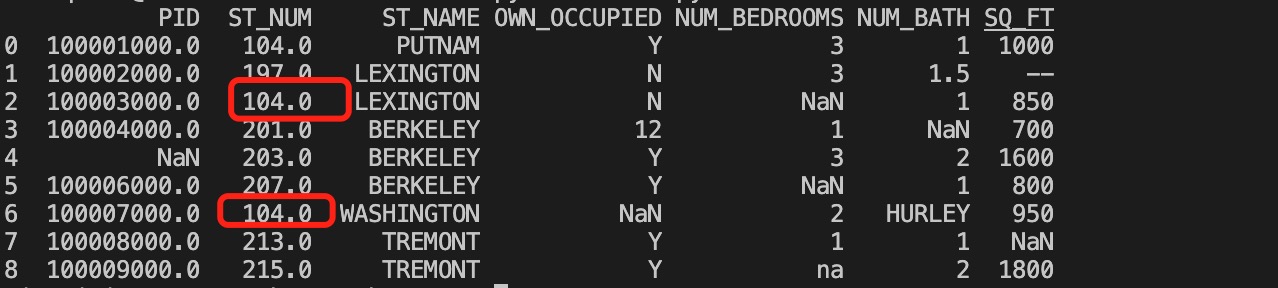
x = df["ST_NUM"].mode()
df["ST_NUM"].fillna(x, inplace = True)
print(df.to_string())
Le résultat de sortie de l'exemple ci-dessus est le suivant ; l'encadré rouge correspond au mode calculé qui a remplacé les cellules vides :
Nettoyage avec Pandas des données mal formatées
Les cellules avec des formats de données incorrects rendent l'analyse des données difficile, voire impossible.
Nous pouvons traiter les lignes contenant des cellules vides, ou convertir toutes les cellules d'une colonne en données au même format.
L'exemple suivant formate la date :
Exemple
# La troisième date a un format incorrect
data = {
"Date": ['2020/12/01', '2020/12/02' , '20201226'],
"duration": [50, 40, 45]
}
df = pd.DataFrame(data, index = ["day1", "day2", "day3"])
df['Date'] = pd.to_datetime(df['Date'], format='mixed')
print(df.to_string())
Le résultat de sortie de l'exemple ci-dessus est le suivant :
           Date  duration
day1 2020-12-01        50
day2 2020-12-02        40
day3 2020-12-26        45
Nettoyage des données incorrectes avec Pandas
Les erreurs de données sont aussi une situation très courante. Nous pouvons remplacer ou supprimer les données incorrectes.
L'exemple suivant remplace les données par des âges incorrects :
Exemple
person = {
"name": ['Google', 'Example' , 'Taobao'],
"age": [50, 40, 12345] # Les données d'âge 12345 sont incorrectes
}
df = pd.DataFrame(person)
df.loc[2, 'age'] = 30 # Modifier les données
print(df.to_string())
Le résultat de sortie de l'exemple ci-dessus est le suivant :
     name  age
0  Google   50
1  Example   40
2  Taobao   30
Vous pouvez également définir des instructions conditionnelles :
Exemple
Définir à 120 les âges supérieurs à 120 :
person = {
"name": ['Google', 'Example' , 'Taobao'],
"age": [50, 200, 12345]
}
df = pd.DataFrame(person)
for x in df.index:
if df.loc[x, "age"] > 120:
df.loc[x, "age"] = 120
print(df.to_string())
Le résultat de sortie de l'exemple ci-dessus est le suivant :
     name  age
0  Google   50
1  Example  120
2  Taobao  120
Vous pouvez également supprimer les lignes contenant des données incorrectes :
Exemple
Supprimer les lignes où l'âge est supérieur à 120 :
person = {
"name": ['Google', 'Example' , 'Taobao'],
"age": [50, 40, 12345] # Les données d'âge 12345 sont incorrectes
}
df = pd.DataFrame(person)
for x in df.index:
if df.loc[x, "age"] > 120:
df.drop(x, inplace = True)
print(df.to_string())
Le résultat de sortie de l'exemple ci-dessus est le suivant :
     name  age
0  Google   50
1  Example   40
Nettoyage des données en double avec Pandas
Si nous voulons nettoyer les données en double, nous pouvons utiliser la méthodeduplicated()etdrop_duplicates().
Si les données correspondantes sont en double,duplicated()renverra True, sinon il renverra False.
Exemple
person = {
"name": ['Google', 'Example', 'Example', 'Taobao'],
"age": [50, 40, 40, 23]
}
df = pd.DataFrame(person)
print(df.duplicated())
Le résultat de sortie de l'exemple ci-dessus est le suivant :
0    False
1    False
2     True
3    False
dtype: bool
Pour supprimer les données en double, vous pouvez directement utiliser la méthodedrop_duplicates().
Exemple
persons = {
"name": ['Google', 'Example', 'Example', 'Taobao'],
"age": [50, 40, 40, 23]
}
df = pd.DataFrame(persons)
df.drop_duplicates(inplace = True)
print(df)
Le résultat de sortie de l'exemple ci-dessus est le suivant :
     name  age
0  Google   50
1  Example   40
3  Taobao   23
Méthodes et descriptions courantes
Méthodes courantes de nettoyage et de prétraitement des données :
| Opération | Méthode/Étape | Description | Fonctions/Méthodes courantes |
|---|---|---|---|
| Gestion des valeurs manquantes | Remplir les valeurs manquantes | Remplir les valeurs manquantes avec une valeur spécifiée (telle que la moyenne, la médiane, le mode, etc.). | df.fillna(value) |
| Supprimer les valeurs manquantes | Supprimer les lignes ou colonnes contenant des valeurs manquantes. | df.dropna() | |
| Gestion des données dupliquées | Supprimer les données dupliquées | Supprimer les lignes dupliquées dans le DataFrame. | df.drop_duplicates() |
| Gestion des valeurs aberrantes | Détection des valeurs aberrantes (basée sur des méthodes statistiques) | Identifier et traiter les valeurs aberrantes à l'aide de la méthode du score Z ou de l'IQR. | Fonction personnalisée (par exemple basée sur le score Z ou l'IQR) |
| Remplacer les valeurs aberrantes | Remplacer les valeurs aberrantes par des valeurs appropriées (telles que la moyenne ou la médiane). | Fonction personnalisée (par exemple le remplacement des valeurs aberrantes) | |
| Conversion de format de données | Convertir les types de données | Convertir un type de données d'un type à un autre, par exemple convertir une chaîne en date. | df.astype() |
| Conversion de format de date/heure | Convertir des chaînes ou des nombres en type datetime. | pd.to_datetime() | |
| Standardisation et normalisation | Normalisation | Transformer les données en une distribution avec une moyenne de 0 et un écart-type de 1. | StandardScaler() |
| Normalisation | Mettre les données à l'échelle sur un intervalle spécifié (p. ex., [0, 1]). | MinMaxScaler() | |
| Encodage des données catégorielles | Encodage des étiquettes | Convertir les variables catégorielles en forme entière. | LabelEncoder() |
| Encodage one-hot | Convertir chaque catégorie en une nouvelle caractéristique binaire. | pd.get_dummies() | |
| Traitement des données textuelles | Supprimer les mots vides | Supprimer les mots non significatifs du texte, tels que « the », « is », etc. | Fonction personnalisée (basée surnltkouspaCy) |
| Racinisation et lemmatisation | Extraire les racines ou restaurer la forme de base des mots. | nltk.stem.PorterStemmer() | |
| Tokenisation | Diviser le texte en mots ou sous-mots. | nltk.word_tokenize() | |
| Échantillonnage des données | Échantillonnage aléatoire | Échantillonner aléatoirement une certaine proportion des données. | df.sample() |
| Sur-échantillonnage et sous-échantillonnage | Équilibrer la distribution des classes dans le jeu de données par sur-échantillonnage (duplication des échantillons de la classe minoritaire) ou sous-échantillonnage (réduction des échantillons de la classe majoritaire). | SMOTE()(Sur-échantillonnage);RandomUnderSampler()(Sous-échantillonnage) | |
| Ingénierie des caractéristiques | Sélection de caractéristiques | Sélectionner les caractéristiques qui influencent la variable cible et supprimer les caractéristiques redondantes ou non pertinentes. | SelectKBest() |
| Extraction de caractéristiques | Créer de nouvelles caractéristiques à partir des données brutes pour améliorer le pouvoir prédictif du modèle. | PolynomialFeatures() | |
| Mise à l'échelle des caractéristiques | Mettre à l'échelle les caractéristiques numériques afin qu'elles aient la même magnitude. | MinMaxScaler() 、 StandardScaler() | |
| Mappage des caractéristiques catégorielles | Mappage des caractéristiques | Associer les variables catégorielles aux codes numériques correspondants. | Fonction de mappage personnalisée |
| Fusion et concaténation de données | Fusionner des données | Fusionner plusieurs DataFrames en fonction de certaines colonnes, en prenant en charge les jointures inner, outer, left, right, etc. | pd.merge() |
| Concaténer des données | Concaténer plusieurs DataFrames par lignes ou par colonnes. | pd.concat() | |
| Remodelage des données | Tableau croisé dynamique | Regrouper les données selon certaines dimensions et calculer des résultats agrégés. | pd.pivot_table() |
| Transformation des données | Modifier la forme des données, par exemple du format long au format large ou du format large au format long. | df.melt() 、 df.pivot() | |
| Conversion et traitement des types de données | Traitement des chaînes de caractères | Traiter les données de type chaîne de caractères, comme supprimer les espaces, convertir la casse, etc. | str.replace() 、 str.upper()wait |
| Calcul groupé | Effectuer une agrégation après regroupement selon une caractéristique donnée. | df.groupby() | |
| Remplissage prédictif des valeurs manquantes | Utiliser des modèles pour prédire et remplir les valeurs manquantes | Utiliser des modèles d'apprentissage automatique (par exemple, des modèles de régression) pour prédire les valeurs manquantes et remplir les données manquantes. | Modèle personnalisé (par exemple,sklearn.linear_model.LinearRegression) |
| Traitement des séries temporelles | Remplissage des valeurs manquantes dans les séries temporelles | Utiliser des méthodes de séries temporelles (telles que le remplissage avant, le remplissage arrière) pour remplir les valeurs manquantes. | df.fillna(method='ffill') |
| Calcul de fenêtre glissante | Utiliser une fenêtre glissante pour effectuer des calculs statistiques sur les données de séries temporelles (par exemple, moyenne, écart-type, etc.). | df.rolling(window=5).mean() | |
| Conversion et mappage de données | Mappage et remplacement de données | Remplacer certaines valeurs dans les données par d'autres valeurs. | df.replace() |
Remplir les valeurs manquantes :
Exemple
# Données d'exemple
données = {'Name': ['Alice', 'Bob', 'Charlie', None],
'Age': [25, 30, None, 35],
'City': ['New York', 'Los Angeles', 'Chicago', 'Houston']}
df = pd.DataFrame(data)
# Remplir les valeurs manquantes de "Age" par la moyenne
df['Age'].fillna(df['Age'].mean(), inplace=True)
print(df)
Sortie :
      Name  Age           City
0    Alice   25.0       New York
1      Bob   30.0    Los Angeles
2  Charlie   30.0        Chicago
3     None   35.0        Houston
Encodage one-hot:
Exemple
# Données d'exemple
data = {'City': ['New York', 'Los Angeles', 'Chicago', 'Houston']}
df = pd.DataFrame(data)
# Effectuer un encodage one-hot sur la colonne "City"
df_encoded = pd.get_dummies(df, columns=['City'])
print(df_encoded)
Sortie :
   City_Chicago  City_Houston  City_Los Angeles  City_New York
0             0             0                 0              1
1             0             0                 1              0
2             1             0                 0              0
3             0             1                 0              0
Standardisation:
Exemple
import pandas as pd
# Données d'exemple
data = {'Age': [25, 30, 35, 40, 45],
'Salary': [50000, 60000, 70000, 80000, 90000]}
df = pd.DataFrame(data)
# Standardiser les données
scaler = StandardScaler()
df_scaled = scaler.fit_transform(df)
print(df_scaled)
Sortie :
[[-1.41421356 -1.41421356]
 [-0.70710678 -0.70710678]
 [ 0.          0.        ]
 [ 0.70710678  0.70710678]
 [ 1.41421356  1.41421356]]
Autres extensions