NoSQL Einführung
NoSQL (NoSQL = Not Only SQL) bedeutet „nicht nur SQL“.
In modernen Computersystemen wird täglich eine riesige Datenmenge im Netzwerk erzeugt.
Ein großer Teil dieser Daten wird von relationalen Datenbankmanagementsystemen (RDBMS) verarbeitet. Im Jahr 1970 machte E.F. Codd mit seiner Arbeit über das relationale Modell, „A relational model of data for large shared data banks“, die Datenmodellierung und Anwendungsprogrammierung einfacher.
Wie die Praxis zeigt, ist das relationale Modell sehr gut für die Client-Server-Programmierung geeignet und hat die erwarteten Vorteile bei Weitem übertroffen. Heute ist es die dominierende Technologie für die Speicherung strukturierter Daten in Netzwerk- und Geschäftsanwendungen.
NoSQL ist eine revolutionäre neue Datenbankbewegung. Sie wurde früh vorgeschlagen und gewann bis 2009 zunehmend an Dynamik. Befürworter von NoSQL befürworten die Verwendung nicht-relationaler Datenspeicherung. Verglichen mit der überwältigenden Verwendung relationaler Datenbanken ist dieses Konzept zweifellos eine Injektion völlig neuen Denkens.
. Eric Evans von Rackspace schlug erneut das Konzept von NoSQL vor. Zu dieser Zeit bezeichnete NoSQL hauptsächlich nicht-relationale, verteilte Datenbank-Entwurfsmuster, die kein ACID bieten.
Eine Transaktion heißt im Englischen „transaction“, ähnlich wie Transaktionen in der realen Welt. Sie hat die folgenden vier Eigenschaften:
1. A (Atomarität)
Atomarität ist leicht zu verstehen: Alle Operationen in einer Transaktion werden entweder vollständig abgeschlossen oder gar nicht ausgeführt. Die Bedingung für den Erfolg einer Transaktion ist, dass alle Operationen erfolgreich sind. Wenn eine einzelne Operation fehlschlägt, schlägt die gesamte Transaktion fehl und muss zurückgerollt werden.
Zum Beispiel gibt es bei einer Banküberweisung von 100 yuan von Konto A auf Konto B zwei Schritte: 1) 100 yuan von Konto A abheben; 2) 100 yuan auf Konto B einzahlen. Diese beiden Schritte müssen gemeinsam abgeschlossen werden oder gar nicht. Wenn nur der erste Schritt abgeschlossen wird und der zweite fehlschlägt, fehlen unerklärlicherweise 100 yuan.
2. C (Konsistenz)
Konsistenz ist ebenfalls leicht zu verstehen: Die Datenbank muss sich immer in einem konsistenten Zustand befinden, und die Ausführung einer Transaktion ändert nicht die ursprünglichen Konsistenzbeschränkungen der Datenbank.
Zum Beispiel: Gegeben sei eine Integritätsbedingung a+b=10. Wenn eine Transaktion a ändert, muss b ebenfalls geändert werden, sodass a+b=10 nach der Transaktion weiterhin gilt; andernfalls schlägt die Transaktion fehl.
3. I (Isolation)
Sogenannte Unabhängigkeit bedeutet, dass gleichzeitige Transaktionen sich nicht gegenseitig beeinflussen. Wenn eine Transaktion auf Daten zugreifen möchte, die gerade von einer anderen Transaktion geändert werden, bleiben die von ihr zugegriffenen Daten von der nicht committeten Transaktion unberührt, solange die andere Transaktion noch nicht committet hat.
Beispielsweise, wenn eine Transaktion 100 Yuan von Konto A auf Konto B überweist und bevor diese Transaktion abgeschlossen ist, wenn B zu diesem Zeitpunkt sein Konto abfragt, sieht es die neu hinzugefügten 100 Yuan nicht.
4. D (Dauerhaftigkeit)
Dauerhaftigkeit bedeutet, dass die Änderungen einer Transaktion, sobald sie festgeschrieben wurde, dauerhaft in der Datenbank gespeichert werden und selbst bei einem Absturz nicht verloren gehen.
Verteilte Systeme
Ein verteiltes System besteht aus mehreren Computern und Softwarekomponenten zur Kommunikation, die über ein Computernetzwerk (lokales Netzwerk oder Weitverkehrsnetz) verbunden sind.
Ein verteiltes System ist ein Softwaresystem, das auf einem Netzwerk aufbaut. Aufgrund der Eigenschaften von Software weisen verteilte Systeme ein hohes Maß an Kohäsion und Transparenz auf.
Daher liegt der Unterschied zwischen einem Netzwerk und einem verteilten System eher in der höheren Software (insbesondere dem Betriebssystem) als in der Hardware.
Verteilte Systeme können auf verschiedenen Plattformen wie PCs, Workstations, lokalen Netzwerken und Weitverkehrsnetzen eingesetzt werden.
Vorteile des verteilten Rechnens
Zuverlässigkeit (Fehlertoleranz):
Ein wichtiger Vorteil verteilter Rechensysteme ist die Zuverlässigkeit. Ein Systemabsturz auf einem Server beeinträchtigt die anderen Server nicht.
Skalierbarkeit:
In einem verteilten Computersystem können bei Bedarf weitere Maschinen hinzugefügt werden.
Ressourcenteilung:
Die gemeinsame Nutzung von Daten ist eine wesentliche Anwendung, beispielsweise in Bank- und Reservierungssystemen.
Flexibilität:
Da das System sehr flexibel ist, lassen sich neue Dienste einfach installieren, implementieren und debuggen.
Schnellere Geschwindigkeit:
Ein verteiltes Computersystem kann über die Rechenleistung mehrerer Computer verfügen, wodurch es eine schnellere Verarbeitungsgeschwindigkeit als andere Systeme bietet.
Offenes System:
Da es ein offenes System ist, kann auf den Dienst lokal oder remote zugegriffen werden.
Höhere Leistung:
Im Vergleich zu zentralisierten Computernetzwerken können Cluster eine höhere Leistung (und ein besseres Preis-Leistungs-Verhältnis) bieten.
Nachteile des verteilten Rechnens
Fehlerbehebung:
故障排除和诊断问题。
软件:
软件支持较少是分布式计算系统的一个主要缺点。
网络:
网络基础设施问题,包括传输问题、高负载、信息丢失等。
安全性:
开放系统的特性导致分布式计算系统存在数据安全和共享风险等问题。
什么是 NoSQL?
NoSQL 指的是非关系型数据库。NoSQL 有时也被称为 Not Only SQL 的缩写。它是不同于传统关系型数据库的数据库管理系统的统称。
NoSQL 用于存储极大规模的数据(例如,Google oder Facebook 每天为其用户收集数万亿位数据)。这些类型的数据存储不需要固定的模式,并且无需额外操作即可横向扩展。
为什么要使用 NoSQL?
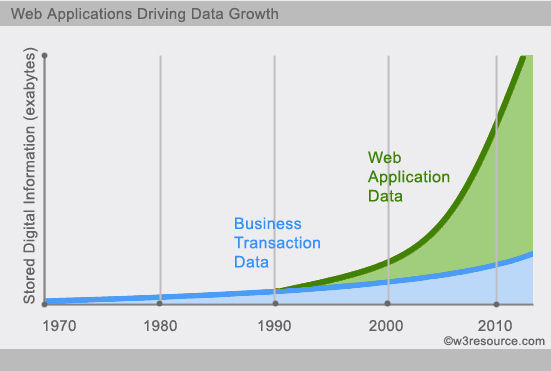
如今,我们可以通过第三方平台(如 Google、Facebook 等)轻松访问和抓取数据。用户的个人信息、社交网络、地理位置、用户生成数据以及用户操作日志都已成倍增加。如果我们想要挖掘这些用户数据,SQL 数据库已不再适合这些应用,但 NoSQL 数据库的发展可以很好地处理这些大数据。
Beispiele
Soziale Netzwerke:
Getrennte Datensätze: UserID, first_name,last_name, age, gender,...
Aufgabe: Finde alle Freunde von Freunden von Freunden von ... Freunden eines gegebenen Benutzers.
Wikipedia-Seiten:
Kombination aus strukturierten und unstrukturierten Daten
Aufgabe: Rufe alle Seiten zur Leichtathletik der Olympischen Sommerspiele vor 1950 ab.
RDBMS vs NoSQL
RDBMS
- Hochgradig organisierte strukturierte Daten
- Strukturierte Abfragesprache (SQL)
- Daten und Beziehungen werden in getrennten Tabellen gespeichert.
- Datenmanipulationssprache, Datendefinitionssprache
- Strikte Konsistenz
- Grundlegende Transaktionen
NoSQL
- Steht für "Not Only SQL"
- Keine deklarative Abfragesprache
- Kein vordefiniertes Schema
- Schlüssel-Wert-Paar-Speicherung, Spaltenspeicherung, Dokumentspeicherung, Graphdatenbanken
- Eventual-Konsistenz, keine ACID-Eigenschaften
- Unstrukturierte und unvorhersehbare Daten
- CAP-Theorem
- Hohe Leistung, hohe Verfügbarkeit und Skalierbarkeit

Eine kurze Geschichte von NoSQL
Der Begriff NoSQL erschien erstmals 1998. Es handelte sich um eine leichtgewichtige, quelloffene relationale Datenbank, die von Carlo Strozzi entwickelt wurde und keine SQL-Funktionalität bereitstellte.
Im Jahr 2009 initiierte Johan Oskarsson von Last.fm eine Diskussion über verteilte Open-Source-Datenbanken
Die 2009 in Atlanta abgehaltene Konferenz "no:sql(east)" war ein Meilenstein, mit dem Slogan "select fun, profit from real_world where relational=false;". Daher ist die gebräuchlichste Interpretation von NoSQL "nicht-relational", wobei die Vorteile von Key-Value-Speichern und Dokumentdatenbanken betont werden, anstatt sich einfach gegen RDBMS zu stellen.
CAP-Theorem
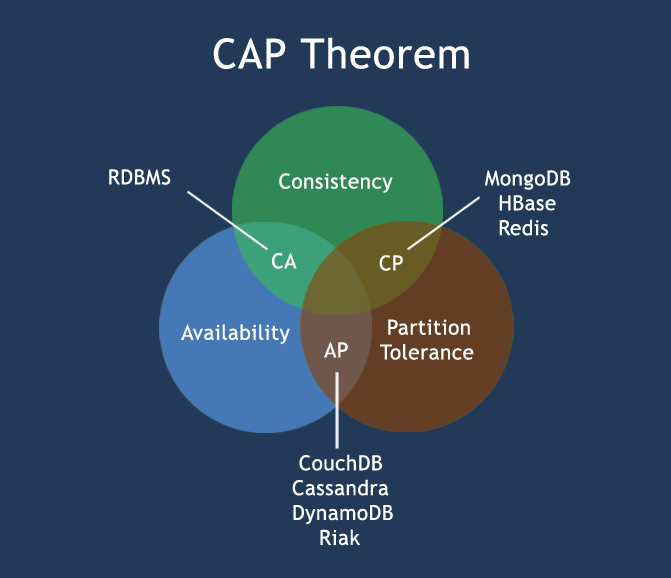
In der Informatik besagt das CAP-Theorem, auch bekannt als Brewers Theorem, dass es für ein verteiltes Computersystem unmöglich ist, die folgenden drei Punkte gleichzeitig zu erfüllen:
- Konsistenz(Alle Knoten haben zur gleichen Zeit dieselben Daten)
- Verfügbarkeit(Garantiert, dass jede Anfrage eine Antwort erhält, ob erfolgreich oder fehlgeschlagen)
- Partitionstoleranz(Der Verlust oder Ausfall jeglicher Information im System beeinträchtigt nicht den weiteren Betrieb des Systems)
Der Kern des CAP-Theorems ist, dass ein verteiltes System nicht gleichzeitig die drei Anforderungen Konsistenz, Verfügbarkeit und Partitionstoleranz gut erfüllen kann; gleichzeitig kann es höchstens zwei davon gut erfüllen.
Daher werden NoSQL-Datenbanken gemäß dem CAP-Theorem in drei Kategorien eingeteilt: Systeme, die das CA-Prinzip erfüllen, Systeme, die das CP-Prinzip erfüllen, und Systeme, die das AP-Prinzip erfüllen:
- CA - Single-Point-Cluster, Systeme, die Konsistenz und Verfügbarkeit erfüllen, sind hinsichtlich der Skalierbarkeit meist nicht sehr leistungsfähig.
- CP - Systeme, die Konsistenz und Partitionstoleranz erfüllen, weisen normalerweise keine besonders hohe Performance auf.
- AP - Systeme, die Verfügbarkeit und Partitionstoleranz erfüllen, haben normalerweise geringere Anforderungen an die Konsistenz.
Vorteile/Nachteile von NoSQL
Vorteile:
- - Hohe Skalierbarkeit
- - Verteiltes Rechnen
- - Geringe Kosten
- - Flexible Architektur, semistrukturierte Daten
- - Keine komplexen Beziehungen
Nachteile:
- - Keine Standardisierung
- - Eingeschränkte Abfragefunktionalität (bisher)
- - Eventual Consistency ist unintuitive Programmierung
BASE
BASE: Basically Available, Soft-state, Eventually Consistent. Definiert von Eric Brewer.
Der Kern des CAP-Theorems ist, dass ein verteiltes System nicht gleichzeitig Konsistenz, Verfügbarkeit und Partitionstoleranz gut erfüllen kann; höchstens kann es zwei davon gleichzeitig gut erfüllen.
BASE ist das Prinzip der schwachen Anforderungen, das NoSQL-Datenbanken üblicherweise an Verfügbarkeit und Konsistenz stellen:
- Grundsätzlich verfügbar -- grundsätzlich verfügbar
- Soft-State -- Soft State/flexible Transaktion. "Soft State" kann als "verbindungslos" verstanden werden, während "Hard State" "verbindungsorientiert" ist
- Eventual Consistency -- Eventuelle Konsistenz, die auch das Endziel von ACID ist.
ACID vs. BASE
| ACID | BASE |
|---|---|
| Atomarität (Atomarität) | Grundsätzlich verfügbar (Brundsätzlich Aerfügbar) |
| Konsistenz (Consistenz) | Soft State/flexible Transaktion (Soft State) |
| Isolation (Isolation) | Eventuelle Konsistenz (Eeventuelle Konsistenz) |
| Dauerhaftigkeit (Ddauerhaft) |
NoSQL-Datenbankklassifikation
| Type | Einige Vertreter |
Hbase
Cassandra
Hypertable
Wie der Name schon sagt, werden Daten spaltenweise gespeichert. Das größte Merkmal ist, dass es praktisch für die Speicherung strukturierter und halbstrukturierter Daten ist, praktisch für die Datenkomprimierung, und einen großen IO-Vorteil bei Abfragen auf eine bestimmte Spalte oder einige wenige Spalten bietet.
Dokumentenspeicher
MongoDB
CouchDB
Die Dokumentenspeicherung verwendet im Allgemeinen ein JSON-ähnliches Format zum Speichern von Inhalten, und der gespeicherte Inhalt ist dokumentbasiert. Dies ermöglicht es, Indizes für bestimmte Felder zu erstellen und einige Funktionen relationaler Datenbanken zu implementieren.
Schlüssel-Wert-Speicher
Tokyo Cabinet / Tyrant
Berkeley DB
MemcacheDB
Redis
Der Wert kann schnell über den Schlüssel abgefragt werden. Im Allgemeinen kümmert sich der Speicher nicht um das Format des Werts und akzeptiert ihn so, wie er ist. (Redis enthält weitere Funktionen)
Graph-Speicher
Neo4J
FlockDB
Der beste Speicher für Graphbeziehungen. Dies mit traditionellen relationalen Datenbanken zu lösen, würde zu geringer Leistung und umständlichem Design und umständlicher Nutzung führen.
Objektspeicher
db4o
Versant
Betreiben Sie die Datenbank über eine Syntax, die objektorientierten Sprachen ähnelt, und greifen Sie über Objekte auf Daten zu.
XML-Datenbank
Berkeley DB XML
BaseX
XML-Daten effizient speichern und interne XML-Abfragesyntax wie XQuery, XPath unterstützen.
Wer verwendet es
Viele Unternehmen verwenden bereits NoSQL:- Mozilla
- Adobe
- Foursquare
- Digg
- McGraw-Hill Education
- Vermont Public Radio