NoSQL Introduction
NoSQL (NoSQL = Not Only SQL) signifie « pas seulement SQL ».
Dans les systèmes informatiques modernes, une énorme quantité de données est générée sur le réseau chaque jour.
Une grande partie de ces données est traitée par des systèmes de gestion de bases de données relationnelles (RDBMS). En 1970, l'article d'E.F. Codd sur le modèle relationnel, « A relational model of data for large shared data banks », a rendu la modélisation des données et la programmation d'applications plus simples.
Comme l'a prouvé la pratique, le modèle relationnel est très adapté à la programmation client-serveur et a largement dépassé les bénéfices escomptés. Aujourd'hui, il constitue la technologie dominante pour le stockage de données structurées dans les applications réseau et métier.
NoSQL est un mouvement de base de données révolutionnaire et nouveau. Il a été proposé très tôt et a pris de l'ampleur croissante jusqu'en 2009. Les partisans de NoSQL préconisent l'utilisation du stockage de données non relationnel. Comparé à l'utilisation écrasante des bases de données relationnelles, ce concept est sans aucun doute une injection de pensée entièrement nouvelle.
. Eric Evans de Rackspace a de nouveau proposé le concept de NoSQL. À cette époque, NoSQL désignait principalement des modèles de conception de bases de données distribuées non relationnelles qui ne fournissent pas ACID.
Une transaction est appelée « transaction » en anglais, semblable aux transactions du monde réel. Elle présente les quatre caractéristiques suivantes :
1. A (Atomicité)
L'atomicité est facile à comprendre : toutes les opérations d'une transaction sont soit complètement exécutées, soit pas du tout. La condition pour qu'une transaction réussisse est que toutes les opérations réussissent. Si une seule opération échoue, la transaction entière échoue et doit être annulée.
Par exemple, dans un virement bancaire de 100 yuan du compte A vers le compte B, il y a deux étapes : 1) retirer 100 yuan du compte A ; 2) déposer 100 yuan sur le compte B. Ces deux étapes doivent être accomplies ensemble ou pas du tout. Si seule la première étape est accomplie et que la seconde échoue, il manquera inexplicablement 100 yuan.
2. C (Cohérence)
La cohérence est également facile à comprendre : la base de données doit toujours être dans un état cohérent, et l'exécution d'une transaction ne modifiera pas les contraintes de cohérence d'origine de la base de données.
Par exemple, étant donné une contrainte d'intégrité a+b=10, si une transaction modifie a, alors b doit être modifié afin que a+b=10 soit toujours vérifié après la transaction, sinon la transaction échoue.
3. I (Isolation)
Ce que l'on appelle l'indépendance signifie que les transactions concurrentes ne s'affectent pas mutuellement. Si une transaction veut accéder à des données qui sont en cours de modification par une autre transaction, tant que l'autre transaction n'a pas été validée, les données auxquelles elle accède ne seront pas affectées par la transaction non validée.
Par exemple, si une transaction transfère 100 yuan du compte A au compte B, et qu'avant que cette transaction soit terminée, si B interroge son compte à ce moment-là, il ne verra pas les 100 yuan nouvellement ajoutés.
4. D (Durabilité)
La durabilité signifie qu'une fois qu'une transaction est validée, ses modifications sont définitivement enregistrées dans la base de données et ne seront pas perdues même en cas de plantage.
Systèmes distribués
Un système distribué est constitué de plusieurs ordinateurs et composants logiciels de communication, connectés via un réseau informatique (réseau local ou réseau étendu).
Un système distribué est un système logiciel construit au-dessus d'un réseau. En raison des caractéristiques du logiciel, les systèmes distribués ont un haut degré de cohésion et de transparence.
Par conséquent, la différence entre un réseau et un système distribué réside davantage dans le logiciel de haut niveau (en particulier le système d'exploitation) que dans le matériel.
Les systèmes distribués peuvent être appliqués sur différentes plateformes telles que les PC, les stations de travail, les réseaux locaux et les réseaux étendus.
Avantages du calcul distribué
Fiabilité (tolérance aux pannes) :
Un avantage important des systèmes de calcul distribué est la fiabilité. Un plantage système sur un serveur n'affecte pas les autres serveurs.
Scalabilité :
Dans un système informatique distribué, davantage de machines peuvent être ajoutées selon les besoins.
Partage des ressources :
Le partage de données est une application essentielle, comme les systèmes bancaires et de réservation.
Flexibilité :
Comme le système est très flexible, il est facile d'installer, de mettre en œuvre et de déboguer de nouveaux services.
Vitesse plus rapide :
Un système informatique distribué peut disposer de la puissance de calcul de plusieurs ordinateurs, ce qui lui confère une vitesse de traitement plus rapide que celle d'autres systèmes.
Système ouvert :
Parce qu'il s'agit d'un système ouvert, le service est accessible localement ou à distance.
Performances supérieures :
Comparés aux réseaux informatiques centralisés, les clusters peuvent offrir des performances supérieures (et un meilleur rapport coût-performance).
Inconvénients de l'informatique distribuée
Dépannage :
Dépannage et diagnostic des problèmes.
Logiciel :
Un moindre support logiciel est un inconvénient majeur des systèmes informatiques distribués.
Réseau :
Problèmes d'infrastructure réseau, notamment des problèmes de transmission, une charge élevée, une perte d'informations, etc.
Sécurité :
Les caractéristiques des systèmes ouverts font que les systèmes informatiques distribués présentent des problèmes tels que la sécurité des données et les risques de partage.
Qu'est-ce que NoSQL ?
NoSQL désigne les bases de données non relationnelles. NoSQL est parfois aussi appelé l'abréviation de Not Only SQL. C'est un terme générique pour les systèmes de gestion de bases de données qui sont différents des bases de données relationnelles traditionnelles.
NoSQL est utilisé pour le stockage de données à très grande échelle (par exemple, Google ou Facebook collectent des billions de bits de données sur leurs utilisateurs chaque jour). Ces types de stockage de données ne nécessitent pas de schéma fixe et peuvent être mis à l'échelle horizontalement sans opérations supplémentaires.
Pourquoi utiliser NoSQL ?
De nos jours, nous pouvons facilement accéder aux données et les extraire via des plateformes tierces (telles que Google, Facebook, etc.). Les informations personnelles des utilisateurs, les réseaux sociaux, les localisations géographiques, les données générées par les utilisateurs et les journaux d'opérations des utilisateurs se sont multipliés. Si nous voulons exploiter ces données utilisateur, les bases de données SQL ne sont plus adaptées à ces applications, mais le développement des bases de données NoSQL peut bien gérer ces données massives.

Exemples
Réseaux sociaux :
Enregistrements séparés : UserID, first_name,last_name, age, gender,...
Tâche : Trouver tous les amis des amis des amis de ... amis d’un utilisateur donné.
Pages Wikipédia :
Combinaison de données structurées et non structurées
Tâche : Récupérer toutes les pages concernant l’athlétisme des Jeux olympiques d’été avant 1950.
SGBDR vs NoSQL
SGBDR
- Données structurées hautement organisées
- Langage de requête structuré (SQL)
- Les données et les relations sont stockées dans des tables séparées.
- Langage de manipulation de données, langage de définition de données
- Cohérence stricte
- Transactions de base
NoSQL
- Représente « Not Only SQL »
- Pas de langage de requête déclaratif
- Pas de schéma prédéfini
- Stockage clé-valeur, stockage en colonnes, stockage de documents, bases de données graphes
- Cohérence à terme, pas de propriétés ACID
- Données non structurées et imprévisibles
- Théorème CAP
- Haute performance, haute disponibilité et scalabilité

Brève histoire de NoSQL
Le terme NoSQL est apparu pour la première fois en 1998. Il s'agissait d'une base de données relationnelle légère et open source développée par Carlo Strozzi qui ne fournissait pas de fonctionnalité SQL.
En 2009, Johan Oskarsson de Last.fm a lancé une discussion sur les bases de données open source distribuées
La conférence « no:sql(east) » tenue à Atlanta en 2009 a été un jalon, avec le slogan « select fun, profit from real_world where relational=false; ». Par conséquent, l'interprétation la plus courante de NoSQL est « non relationnelle », mettant l'accent sur les avantages des magasins clé-valeur et des bases de données documentaires, plutôt que de simplement s'opposer aux RDBMS.
Théorème CAP
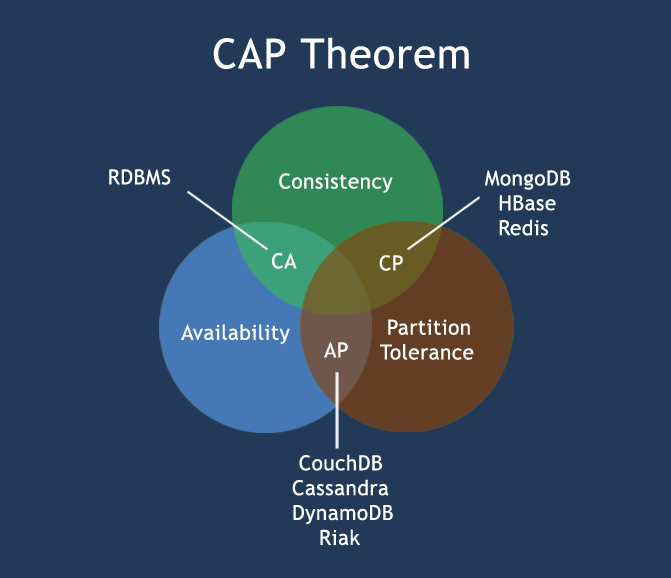
En informatique, le théorème CAP, également appelé théorème de Brewer, stipule que pour un système informatique distribué, il est impossible de satisfaire simultanément les trois points suivants :
- Cohérence(Tous les nœuds ont les mêmes données au même moment)
- Disponibilité(Garantit que chaque requête reçoit une réponse, qu'elle soit réussie ou en échec)
- Tolérance au partitionnement(La perte ou la défaillance de toute information dans le système n'affectera pas la poursuite du fonctionnement du système)
Le cœur du théorème CAP est qu'un système distribué ne peut pas satisfaire simultanément et correctement les trois exigences de cohérence, de disponibilité et de tolérance au partitionnement ; au mieux, il ne peut en satisfaire que deux en même temps.
Par conséquent, selon le théorème CAP, les bases de données NoSQL sont divisées en trois catégories : les systèmes qui satisfont le principe CA, les systèmes qui satisfont le principe CP et les systèmes qui satisfont le principe AP :
- CA - cluster à point unique, systèmes qui satisfont la cohérence et la disponibilité, généralement pas très puissants en matière d'extensibilité.
- CP - systèmes qui satisfont la cohérence et la tolérance au partitionnement, généralement pas particulièrement performants.
- AP - systèmes qui satisfont la disponibilité et la tolérance au partitionnement, avec généralement des exigences de cohérence plus faibles.
Avantages/Inconvénients de NoSQL
Avantages :
- - Haute scalabilité
- - Informatique distribuée
- - Coût faible
- - Architecture flexible, données semi-structurées
- - Pas de relations complexes
Inconvénients :
- - Pas de standardisation
- - Fonctionnalités de requête limitées (jusqu'à présent)
- - La cohérence à terme est une programmation contre-intuitive
BASE
BASE : Basically Available, Soft-state, Eventually Consistent. Défini par Eric Brewer.
Le cœur du théorème CAP est qu'un système distribué ne peut pas satisfaire simultanément de manière optimale la cohérence, la disponibilité et la tolérance aux partitions ; au mieux, il ne peut en satisfaire que deux de manière optimale en même temps.
BASE est le principe d'exigence faible que les bases de données NoSQL ont généralement en matière de disponibilité et de cohérence :
- Fondamentalement disponible -- Fondamentalement disponible
- État souple -- État souple/transaction flexible. « État souple » peut être compris comme « sans connexion », tandis que « État dur » est « orienté connexion »
- Cohérence à terme -- Cohérence à terme, qui est aussi l'objectif ultime d'ACID.
ACID vs BASE
| ACID | BASE |
|---|---|
| Atomicité (Atomicité) | Fondamentalement disponible (Bondamentalement Aisponible) |
| Cohérence (Cohérence) | État souple/transaction flexible (Stat souple) |
| Isolation (Isolation) | Cohérence à terme (Eohérence à terme) |
| Durabilité (Durable) |
Classification des bases de données NoSQL
| Type | Quelques représentants |
Hbase
Cassandra
Hypertable
Comme son nom l'indique, les données sont stockées par colonne. Sa principale caractéristique est de faciliter le stockage de données structurées et semi-structurées, de faciliter la compression des données, et d'offrir un grand avantage d'E/S pour les requêtes sur une certaine colonne ou quelques colonnes.
Base de données documentaire
MongoDB
CouchDB
Le stockage de documents utilise généralement un format de type JSON pour stocker le contenu, et le contenu stocké est basé sur des documents. Cela permet de créer des index sur certains champs et d'implémenter certaines fonctions des bases de données relationnelles.
Base de données clé-valeur
Tokyo Cabinet / Tyrant
Berkeley DB
MemcacheDB
Redis
La valeur peut être rapidement interrogée par sa clé. De manière générale, le stockage ne se soucie pas du format de la valeur et l'accepte telle quelle. (Redis inclut d'autres fonctions)
Base de données de graphes
Neo4J
FlockDB
La meilleure base de données pour les relations de graphes. L'utilisation de bases de données relationnelles traditionnelles pour résoudre ce problème entraînerait de faibles performances et une conception et une utilisation peu pratiques.
Base de données objet
db4o
Versant
Exploiter la base de données au moyen d'une syntaxe similaire aux langages orientés objet, et accéder aux données via des objets.
Base de données XML
Berkeley DB XML
BaseX
Stocker efficacement des données XML et prendre en charge la syntaxe de requête interne XML telle que XQuery, XPath.
Qui l'utilise
De nombreuses entreprises utilisent déjà NoSQL :- Mozilla
- Adobe
- Foursquare
- Digg
- McGraw-Hill Education
- Vermont Public Radio