NoSQL Introducción
NoSQL (NoSQL = Not Only SQL) significa "no solo SQL".
En los sistemas informáticos modernos, la red genera una enorme cantidad de datos cada día.
Una gran parte de estos datos es procesada por los sistemas de gestión de bases de datos relacionales (RDBMS). En 1970, el artículo de E.F. Codd sobre el modelo relacional "A relational model of data for large shared data banks" hizo que el modelado de datos y la programación de aplicaciones fueran más simples.
La práctica ha demostrado que el modelo relacional es muy adecuado para la programación cliente-servidor, superando con creces las expectativas. Hoy en día es la tecnología dominante para el almacenamiento de datos estructurados en redes y aplicaciones comerciales.
NoSQL es un movimiento revolucionario completamente nuevo en el ámbito de las bases de datos. Algunas personas ya lo propusieron en sus inicios, y su tendencia fue creciendo cada vez más hasta 2009. Los defensores de NoSQL abogan por el uso de almacenamiento de datos no relacional. En comparación con la abrumadora aplicación de las bases de datos relacionales, este concepto es sin duda una inyección de una nueva forma de pensar.
. Eric Evans de Rackspace volvió a proponer el concepto de NoSQL. En ese momento, NoSQL se refería principalmente a patrones de diseño de bases de datos no relacionales, distribuidas y que no proporcionaban ACID.
Transacción en inglés es "transaction", muy similar a las transacciones del mundo real. Tiene las siguientes cuatro características:
1. A (Atomicity) Atomicidad
La atomicidad es fácil de entender: todas las operaciones dentro de una transacción deben completarse o no realizarse ninguna. La condición para que una transacción tenga éxito es que todas las operaciones sean exitosas. Si una sola operación falla, toda la transacción falla y debe revertirse (rollback).
Por ejemplo, en una transferencia bancaria, transferir 100 yuanes de la cuenta A a la cuenta B se divide en dos pasos: 1) retirar 100 yuanes de la cuenta A; 2) depositar 100 yuanes en la cuenta B. Estos dos pasos deben completarse juntos o no completarse. Si solo se completa el primer paso y el segundo falla, el dinero desaparecerá misteriosamente en 100 yuanes.
2. C (Consistency) Consistencia
La consistencia también es relativamente fácil de entender: la base de datos debe mantenerse siempre en un estado consistente, y la ejecución de transacciones no debe cambiar las restricciones de consistencia originales de la base de datos.
Por ejemplo, si existe la restricción de integridad a+b=10, si una transacción cambia a, entonces debe cambiar b, de modo que después de que finalice la transacción se siga cumpliendo a+b=10; de lo contrario, la transacción falla.
3. I (Isolation) Aislamiento
El llamado aislamiento significa que las transacciones concurrentes no se afectan entre sí. Si una transacción va a acceder a datos que están siendo modificados por otra transacción, mientras la otra transacción no haya sido confirmada (commit), los datos a los que accede no se verán afectados por la transacción no confirmada.
Por ejemplo, si hay una transacción que transfiere 100 yuanes de la cuenta A a la cuenta B, mientras esta transacción aún no se haya completado, si B consulta su propia cuenta, no podrá ver los 100 yuanes recién añadidos.
4. D (Durability) Persistencia
La persistencia significa que una vez que una transacción se confirma (commit), las modificaciones realizadas se guardarán permanentemente en la base de datos, y no se perderán incluso si ocurre una caída del sistema.
Sistemas distribuidos
Un sistema distribuido (distributed system) está compuesto por múltiples computadoras y componentes de software de comunicación conectados a través de una red informática (red local o red de área amplia).
Un sistema distribuido es un sistema de software construido sobre una red. Es precisamente debido a las características del software que los sistemas distribuidos tienen un alto grado de cohesión y transparencia.
Por lo tanto, la diferencia entre redes y sistemas distribuidos reside más en el software de alto nivel (especialmente los sistemas operativos) que en el hardware.
Los sistemas distribuidos pueden aplicarse en diferentes plataformas, como PC, estaciones de trabajo, redes locales y redes de área amplia, etc.
Ventajas de la computación distribuida
Fiabilidad (tolerancia a fallos):
Una ventaja importante en un sistema de computación distribuida es la fiabilidad. La caída de un servidor no afecta al resto de los servidores.
Escalabilidad:
En un sistema de computación distribuida se pueden añadir más máquinas según sea necesario.
Compartición de recursos:
Compartir datos es esencial para aplicaciones como la banca y los sistemas de reservas.
Flexibilidad:
Como el sistema es muy flexible, es fácil instalar, implementar y depurar nuevos servicios.
Mayor velocidad:
Un sistema de computación distribuida puede tener la capacidad de cómputo de múltiples computadoras, lo que le permite tener una velocidad de procesamiento más rápida que otros sistemas.
Sistemas abiertos:
Al ser un sistema abierto, el servicio puede ser accesible tanto local como remotamente.
Mayor rendimiento:
En comparación con los sistemas informáticos centralizados, los clústeres de redes pueden ofrecer un mayor rendimiento (y una mejor relación calidad-precio).
Desventajas de la computación distribuida
Resolución de problemas:
Solución de problemas y diagnóstico de fallos.
Software:
El menor soporte de software es la principal desventaja de los sistemas de computación distribuida.
Red:
Problemas de infraestructura de red, incluyendo: problemas de transmisión, alta carga, pérdida de información, etc.
Seguridad:
Las características de los sistemas abiertos hacen que los sistemas de computación distribuida presenten riesgos como la seguridad de los datos y la compartición de los mismos.
¿Qué es NoSQL?
NoSQL se refiere a las bases de datos no relacionales. NoSQL a veces también se considera el acrónimo de Not Only SQL, y es un término general para los sistemas de gestión de bases de datos que difieren de las bases de datos relacionales tradicionales.
NoSQL se utiliza para el almacenamiento de datos a muy gran escala. (Por ejemplo, Google o Facebook recopilan billones de bits de datos para sus usuarios cada día). Este tipo de almacenamiento de datos no requiere un esquema fijo y puede escalarse horizontalmente sin operaciones adicionales.
¿Por qué usar NoSQL?
Hoy en día podemos acceder y extraer datos fácilmente a través de plataformas de terceros (como Google, Facebook, etc.). La información personal de los usuarios, las redes sociales, la ubicación geográfica, los datos generados por los usuarios y los registros de operaciones de los usuarios se han multiplicado exponencialmente. Si queremos extraer estos datos de usuario, las bases de datos SQL ya no son adecuadas para estas aplicaciones. El desarrollo de las bases de datos NoSQL puede manejar muy bien estos grandes volúmenes de datos.

Ejemplos
Redes sociales:
Separate records: UserID, first_name,last_name, age, gender,...
Task: Find all friends of friends of friends of ... friends of a given user.
Páginas de Wikipedia:
Combination of structured and unstructured data
Task: Retrieve all pages regarding athletics of Summer Olympic before 1950.
RDBMS vs NoSQL
RDBMS
- Datos estructurados altamente organizados
- Lenguaje de consulta estructurado (SQL)
- Los datos y las relaciones se almacenan en tablas separadas.
- Lenguaje de manipulación de datos, lenguaje de definición de datos
- Consistencia estricta
- Transacciones básicas
NoSQL
- Representa "no solo SQL"
- Sin lenguaje de consulta declarativo
- Sin esquema predefinido
- Almacenamiento clave-valor, almacenamiento por columnas, almacenamiento de documentos, bases de datos de grafos
- Consistencia eventual, no propiedades ACID
- Datos no estructurados e impredecibles
- Teorema CAP
- Alto rendimiento, alta disponibilidad y escalabilidad

Breve historia de NoSQL
El término NoSQL apareció por primera vez en 1998, y fue una base de datos relacional ligera, de código abierto y sin funcionalidad SQL, desarrollada por Carlo Strozzi.
En 2009, Johan Oskarsson de Last.fm inició una discusión sobre bases de datos distribuidas de código abierto
El coloquio "no:sql(east)" celebrado en Atlanta en 2009 fue un hito, con el lema "select fun, profit from real_world where relational=false;". Por lo tanto, la interpretación más común de NoSQL es "no relacional", destacando las ventajas de los almacenes clave-valor y las bases de datos de documentos, en lugar de simplemente oponerse a los RDBMS.
Teorema CAP (CAP theorem)
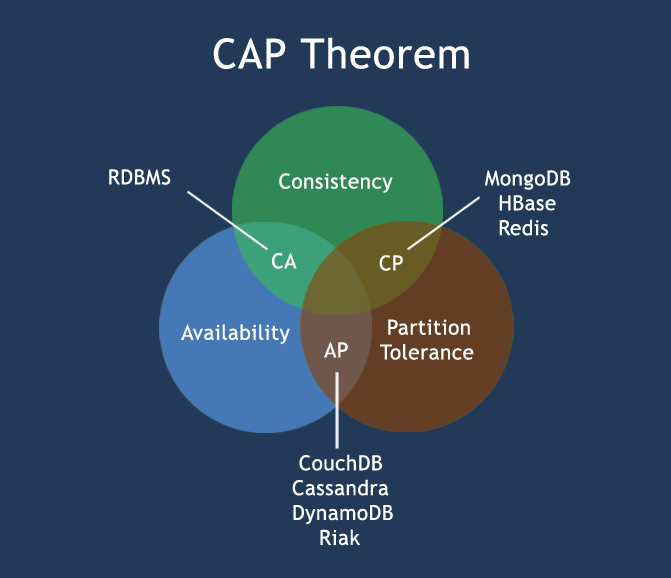
En ciencias de la computación, el teorema CAP (CAP theorem), también conocido como teorema de Brewer (Brewer's theorem), señala que para un sistema de computación distribuida es imposible satisfacer simultáneamente los siguientes tres puntos:
- Consistencia (Consistency)(Todos los nodos tienen los mismos datos al mismo tiempo)
- Disponibilidad (Availability)(Se garantiza que cada solicitud, ya sea exitosa o fallida, tenga una respuesta)
- Tolerancia a la partición (Partition tolerance)(La pérdida o fallo de cualquier información en el sistema no afecta la operación continua del sistema)
El núcleo de la teoría CAP es: un sistema distribuido no puede satisfacer simultáneamente y de manera óptima los tres requisitos de consistencia, disponibilidad y tolerancia a la partición; como máximo puede satisfacer bien dos de ellos al mismo tiempo.
Por lo tanto, según el principio CAP, las bases de datos NoSQL se dividen en tres grandes categorías: las que cumplen el principio CA, las que cumplen el principio CP y las que cumplen el principio AP:
- CA - Sistemas de clúster de punto único que satisfacen consistencia y disponibilidad, generalmente no muy potentes en escalabilidad.
- CP - Sistemas que satisfacen consistencia y tolerancia a particiones, generalmente con un rendimiento no particularmente alto.
- AP - Sistemas que satisfacen disponibilidad y tolerancia a particiones, generalmente pueden tener requisitos más bajos de consistencia.
Ventajas/desventajas de NoSQL
Ventajas:
- - Alta escalabilidad
- - Computación distribuida
- - Bajo costo
- - Flexibilidad de arquitectura, datos semiestructurados
- - Sin relaciones complejas
Desventajas:
- - Sin estandarización
- - Funciones de consulta limitadas (hasta ahora)
- - La consistencia final es un programa poco intuitivo
BASE
BASE: Basically Available, Soft-state, Eventually Consistent. Definido por Eric Brewer.
El núcleo de la teoría CAP es: un sistema distribuido no puede satisfacer bien al mismo tiempo los tres requisitos de consistencia, disponibilidad y tolerancia a particiones; como máximo puede satisfacer bien dos de ellos simultáneamente.
BASE es el principio de requisitos débiles de disponibilidad y consistencia que suelen tener las bases de datos NoSQL:
- Basically Available -- Básicamente disponible
- Soft-state -- Estado blando/transacción flexible. "Soft state" puede entenderse como "sin conexión", mientras que "Hard state" es "orientado a conexión".
- Eventually Consistency -- Consistencia final, también es el objetivo final de ACID.
ACID vs BASE
| ACID | BASE |
|---|---|
| Atomicidad(Atomicity) | Disponibilidad básica(Basically Available) |
| Consistencia(Consistency) | Estado blando/transacción flexible(Soft state) |
| Aislamiento(Isolation) | Consistencia final (Eventual consistency) |
| Persistencia (Durable) |
Clasificación de las bases de datos NoSQL
| Tipo | Algunos representantes |
Hbase
Cassandra
Hypertable
Como su nombre indica, almacena datos por columnas. Su mayor característica es que facilita el almacenamiento de datos estructurados y semiestructurados, facilita la compresión de datos, y tiene una gran ventaja de E/S para consultas dirigidas a una o varias columnas.
Almacenamiento de documentos
MongoDB
CouchDB
El almacenamiento de documentos generalmente utiliza un formato similar a json para almacenar, y el contenido almacenado es de tipo documental. Así también hay oportunidad de crear índices sobre ciertos campos, implementando algunas funciones de las bases de datos relacionales.
Almacenamiento clave-valor
Tokyo Cabinet / Tyrant
Berkeley DB
MemcacheDB
Redis
Se puede consultar rápidamente su valor mediante la clave. En general, el almacenamiento no se preocupa por el formato del valor, lo acepta todo tal como viene. (Redis incluye otras funciones).
Almacenamiento de grafos
Neo4J
FlockDB
El mejor almacenamiento para relaciones gráficas. Si se resuelve con bases de datos relacionales tradicionales, el rendimiento es bajo y el diseño y uso son inconvenientes.
Almacenamiento de objetos
db4o
Versant
Opera la base de datos mediante una sintaxis similar a los lenguajes orientados a objetos, y accede a los datos mediante objetos.
Base de datos XML
Berkeley DB XML
BaseX
Almacena datos XML de manera eficiente y admite la sintaxis de consulta interna de XML, como XQuery, XPath.
Quién lo usa
Ya hay muchas empresas que utilizan NoSQL:- Mozilla
- Adobe
- Foursquare
- Digg
- McGraw-Hill Education
- Vermont Public Radio