Основы нейронных сетей в PyTorch
Нейронная сеть — это вычислительная модель, имитирующая способ обработки информации человеческим мозгом. Она состоит из множества взаимосвязанных узлов (нейронов), организованных в слои.
Сила нейронных сетей заключается в их способности автоматически изучать сложные закономерности и признаки из больших объёмов данных без необходимости вручную разрабатывать средства извлечения признаков.
С развитием глубокого обучения нейронные сети стали ключевой технологией для решения многих сложных задач.
Нейрон
Нейрон — это базовая единица нейронной сети. Он получает входные сигналы, вычисляет взвешенную сумму, добавляет смещение и затем пропускает результат через функцию активации, чтобы получить выход.
Веса и смещения нейрона — это параметры, которые необходимо настраивать в процессе обучения сети.
Вход и выход:
- Вход: Вход — это начальная точка сети и может представлять собой признаковые данные, например значения пикселей изображения или векторы слов текста.
- Выход: Выход — это конечная точка сети, представляющая результат предсказания модели, например метку класса в задаче классификации.
Нейрон получает несколько входов (например, x1, x2, ..., xn). Если взвешенная сумма входов больше порога активации (потенциала активации), он выдаёт бинарный выход.
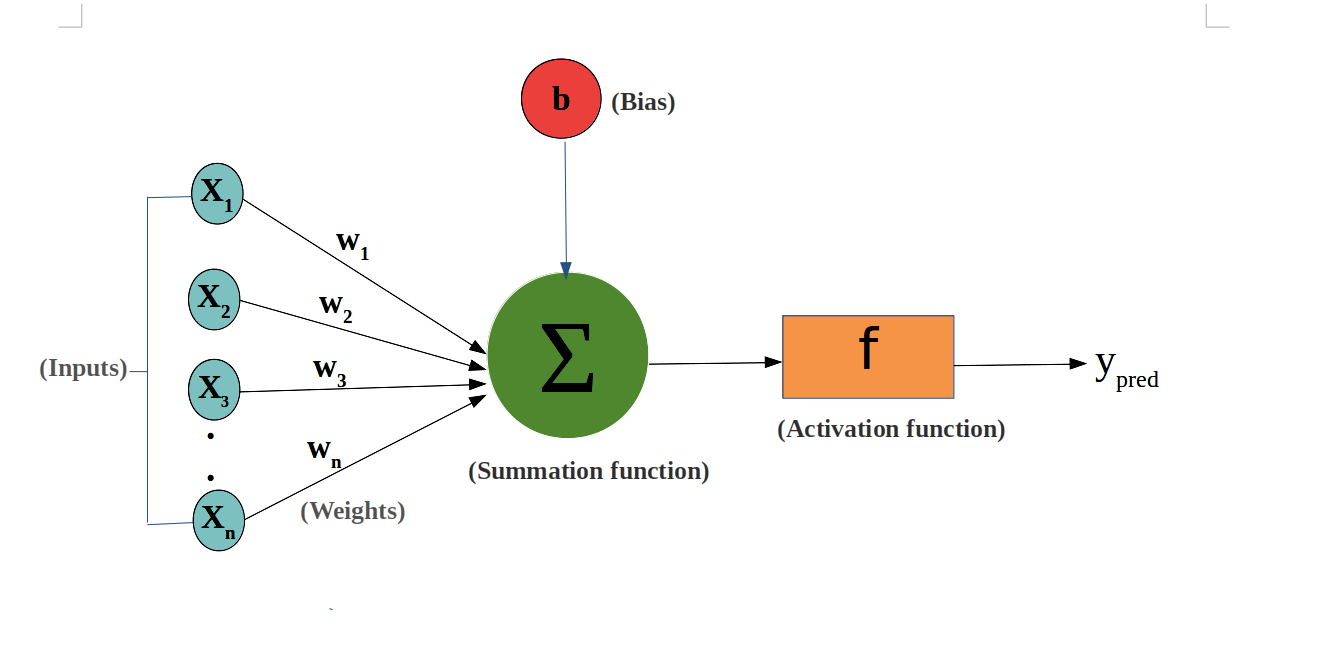
Выход нейрона можно рассматривать как взвешенную сумму его входов плюс смещение. Математическое представление нейрона:
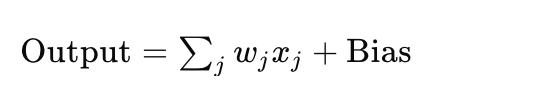
Здесь,wj— это вес,xj— это вход, аСмещение— это член смещения.
Слой
Слои между входным слоем и выходным слоем называются скрытыми слоями. Плотность и тип связей между слоями составляют конфигурацию сети.
Нейронная сеть состоит из нескольких слоёв, включая:
- Входной слой: Получает исходные входные данные.
- Скрытый слой: Обрабатывает входные данные; скрытых слоёв может быть несколько.
- Выходной слой: Выдаёт окончательный выходной результат.
Типичная архитектура нейронной сети:
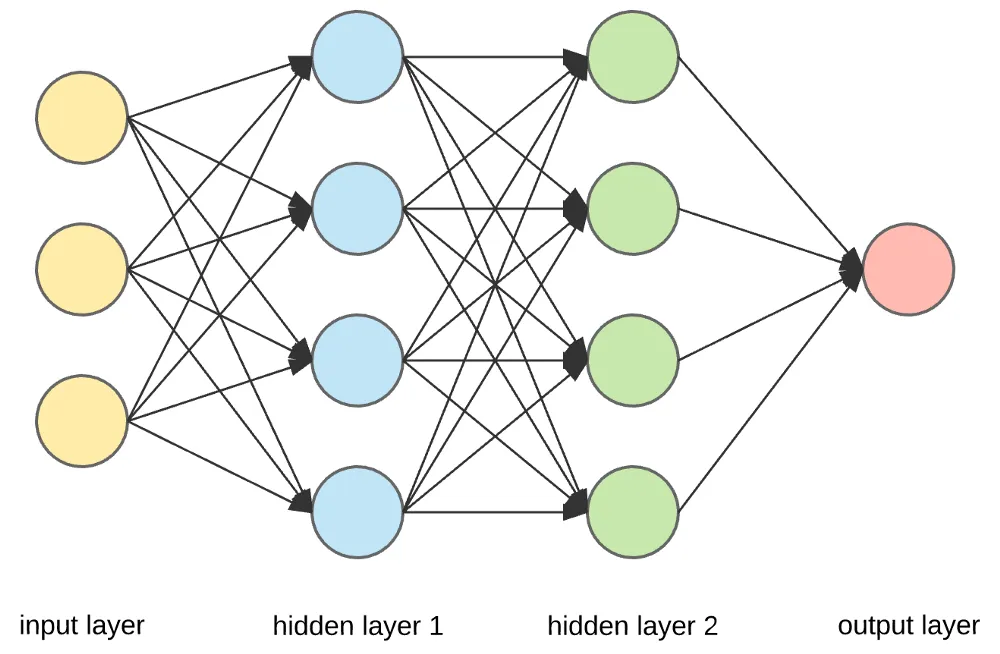
Демонстрационная схема:
Нейронная сеть прямого распространения (FNN)
Нейронная сеть прямого распространения (FNN) — базовая единица в семействе нейронных сетей.
Особенность нейронной сети прямого распространения состоит в том, что данные проходят от входного слоя через один или несколько скрытых слоёв и в конечном итоге достигают выходного слоя, без каких-либо циклов или обратных связей на протяжении всего процесса.

Базовая структура нейронной сети прямого распространения:
-
Входной слой:Точка входа, через которую данные поступают в сеть. Каждый узел входного слоя представляет входной признак.
Скрытый слой:Один или несколько слоёв, используемых для улавливания нелинейных особенностей данных. Каждый скрытый слой состоит из множества нейронов, и каждый нейрон увеличивает нелинейность с помощью функции активации.
Выходной слой:Выдаёт результат предсказания сети. Количество узлов зависит от типа задачи; например, количество выходных узлов в задаче классификации равно количеству классов.
Веса связей и смещения:Входы каждого нейрона взвешиваются и суммируются, затем добавляется смещение, и результат пропускается через функцию активации.
Рекуррентная нейронная сеть (RNN)
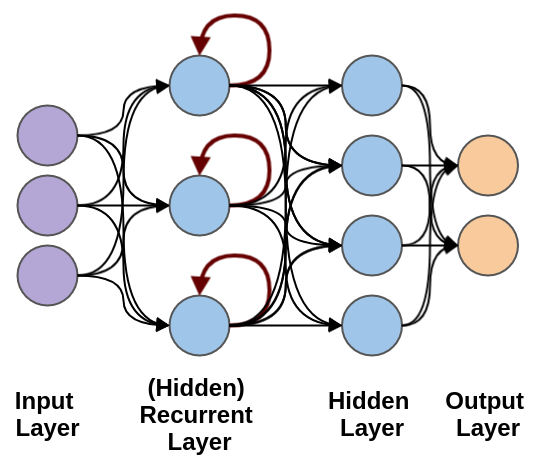
Рекуррентная нейронная сеть (RNN) — это тип нейронной сети, специально предназначенный для обработки последовательных данных, способный улавливать зависимости во временной или последовательной информации во входных данных.
Особенностью RNN является их «способность к запоминанию» — они могут хранить информацию с предыдущих временных шагов в скрытом состоянии сети.
Рекуррентные нейронные сети используются для обработки шаблонов данных, которые меняются со временем.
В RNN один и тот же слой используется для приёма входных параметров и вывода выходных параметров в заданной нейронной сети.
PyTorch предоставляет мощные инструменты для построения и обучения нейронных сетей.
Нейронные сети в PyTorch реализуются через модульtorch.nn.
torch.nnМодуль предоставляет различные сетевые слои (такие как полносвязные слои, свёрточные слои и т. д.), функции потерь и оптимизаторы, что делает более удобным построение и обучение нейронных сетей.
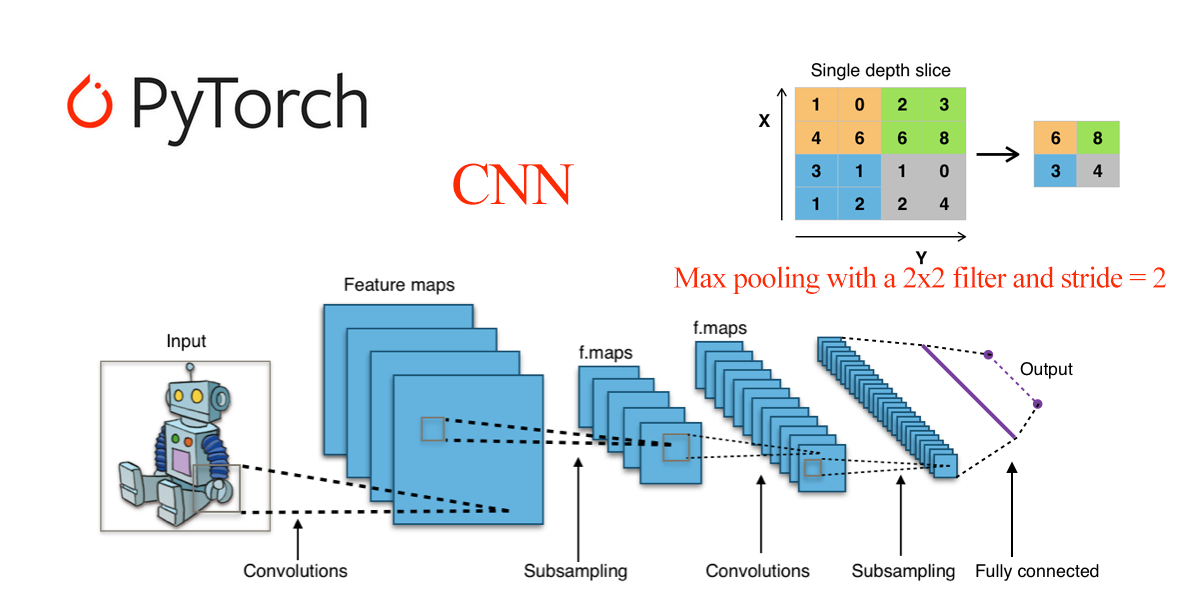
В PyTorch для построения нейронной сети обычно требуется наследование от класса nn.Module.
nn.Module — это базовый класс для всех модулей нейронных сетей. Вам нужно определить следующие две части:
__init__(): Определите сетевые слои.forward(): Определите процесс прямого распространения данных.
Простая полносвязная нейронная сеть:
Пример
import torch.nn as nn
# Определяем простую модель нейронной сети
class SimpleNN(nn.Module):
def __init__(self):
super(SimpleNN, self).__init__()
# Определяем полносвязный слой от входного слоя к скрытому слою
self.fc1 = nn.Linear(2, 2) # Вход: 2 признака, выход: 2 признака
# Определяем полносвязный слой от скрытого слоя к выходному слою
self.fc2 = nn.Linear(2, 1) # Вход: 2 признака, выход: 1 предсказанное значение
def forward(self, x):
# Процесс прямого распространения
x = torch.relu(self.fc1(x)) # Используйте функцию активации ReLU
x = self.fc2(x) # Выходной слой
return x
# Создание экземпляра модели
model = SimpleNN()
# Вывод модели
print(model)
Результат вывода следующий:
SimpleNN(
  (fc1): Linear(in_features=2, out_features=2, bias=True)
  (fc2): Linear(in_features=2, out_features=1, bias=True)
)
PyTorch предоставляет множество распространённых слоёв нейронных сетей. Вот несколько распространённых из них:
nn.Linear(in_features, out_features): Полносвязный слой, входin_featuresпризнаки, выходout_featuresпризнаки.nn.Conv2d(in_channels, out_channels, kernel_size): 2D сверточный слой, используется для обработки изображений.nn.MaxPool2d(kernel_size): 2D слой максимального пулинга, используется для снижения размерности.nn.ReLU(): функция активации ReLU, обычно используется в скрытых слоях.nn.Softmax(dim): функция активации Softmax, обычно используется в выходном слое, подходит для задач многоклассовой классификации.
Функция активации
Функции активации определяют, должен ли нейрон активироваться. Это нелинейные функции, которые позволяют нейронным сетям обучаться и выполнять более сложные задачи. Распространенные функции активации включают:
- Sigmoid: используется для задач бинарной классификации, выходные значения находятся между 0 и 1.
- Tanh: выходные значения находятся между -1 и 1, часто используется перед выходным слоем.
- ReLU (Rectified Linear Unit): одна из самых популярных функций активации в настоящее время, определяемая как
f(x) = max(0, x), что помогает решить проблему исчезающего градиента. - Softmax: часто используется в выходном слое для задач многоклассовой классификации; преобразует выходные данные в распределение вероятностей.
Пример
# активация ReLU
output = F.relu(input_tensor)
# Активация Sigmoid
output = torch.sigmoid(input_tensor)
# Активация Tanh
output = torch.tanh(input_tensor)
Функция потерь
Функция потерь используется для измерения разницы между предсказанными значениями модели и истинными значениями.
Распространённые функции потерь включают:
- Среднеквадратичная ошибка (MSELoss): Обычно используется для задач регрессии; вычисляет квадратичную разницу между выходом и целевым значением.
- Кросс-энтропийная потеря (CrossEntropyLoss): Обычно используется для задач классификации; вычисляет кросс-энтропию между выходом и истинными метками.
- BCEWithLogitsLoss: Для задач бинарной классификации; объединяет Sigmoid-активацию и бинарную кросс-энтропийную потерю.
Пример
criterion = nn.MSELoss()
# Кросс-энтропийная потеря
criterion = nn.CrossEntropyLoss()
# Бинарная кросс-энтропийная потеря
criterion = nn.BCEWithLogitsLoss()
Оптимизатор
Оптимизатор отвечает за обновление весов и смещений сети в процессе обучения.
Распространённые оптимизаторы включают:
- SGD (стохастический градиентный спуск)
- Adam (адаптивная оценка моментов)
- RMSprop (распространение среднеквадратичного значения)
Пример
# Использовать оптимизатор SGD
optimizer = optim.SGD(model.parameters(), lr=0.01)
# Использовать оптимизатор Adam
optimizer = optim.Adam(model.parameters(), lr=0.001)
Процесс обучения
Обучение нейронной сети включает следующие шаги:
- Подготовка данных: путём
DataLoaderзагрузки данных. - Определите функцию потерь и оптимизатор。
- Прямое распространение: вычислить выход модели.
- Вычислить потери: сравнить с целевым значением, чтобы получить значение потерь.
- Обратное распространение: путем
loss.backward()вычисления градиентов. - Обновить параметры: путем
optimizer.step()обновления параметров модели. - Повторяйте вышеуказанные шагипока не будет достигнуто заданное количество эпох обучения.
Пример
# Пример обучающих данных
X = torch.randn(10, 2) # 10 примеров, каждый с 2 признаками
Y = torch.randn(10, 1) # 10 целевых меток
# Процесс обучения
for epoch in range(100): # Обучение в течение 100 эпох
model.train() # Установить модель в режим обучения
optimizer.zero_grad() # Очистить градиенты
output = model(X) # Прямое распространение
loss = criterion(output, Y) # Вычислить потерю
loss.backward() # Обратное распространение
optimizer.step() # Обновить веса
if (epoch + 1) % 10 == 0: # Выводить потерю каждые 10 эпох
print(f'Эпоха [{epoch + 1}/100], Потери: {loss.item():.4f}')
Тестирование и оценка
После завершения обучения модель необходимо протестировать и оценить.
Типичные шаги включают:
- Вычислите потерю на тестовом наборе: оцените качество работы модели на ранее не встречавшихся данных.
- Вычислите точность: для задач классификации вычислите долю правильных предсказаний.
Пример
model.eval() # Перевести модель в режим оценки
with torch.no_grad(): # Отключить вычисление градиентов во время оценки
output = model(X_test)
loss = criterion(output, Y_test)
print(f'Test Loss: {loss.item():.4f}')
Типы нейронных сетей
- Нейронные сети прямого распространения: данные распространяются в одном направлении, от входного слоя к выходному слою, без обратных связей.
- Свёрточные нейронные сети (CNN): подходят для обработки изображений, используя свёрточные слои для извлечения пространственных признаков.
- Рекуррентные нейронные сети (RNN): подходят для последовательных данных, таких как анализ временных рядов и обработка естественного языка, позволяя создавать циклы обратной связи для информации.
- Долгая краткосрочная память (LSTM): особый тип RNN, который может изучать долгосрочные зависимости.
Справочник по torch.nn
Ниже приведены наиболее часто используемые в PyTorchtorch.nnфункции и классы:
Основы определения модели
| Функция | Описание | Пример |
|---|---|---|
| nn.Module | Базовый класс для всех модулей нейронных сетей | class Net(nn.Module): ... |
| nn.Sequential | Контейнер Sequential, выполняющий слои по порядку | nn.Sequential(conv, relu, pool) |
| nn.ModuleList | Хранит подмодули в списке | self.layers = nn.ModuleList([...]) |
| nn.Parameter | Создаёт обучаемый тензор параметров | self.w = nn.Parameter(torch.randn(n)) |
Свёрточные слои
| Функция | Описание | Пример |
|---|---|---|
| nn.Conv1d | 1D-свёртка (текст, аудио) | nn.Conv1d(3, 64, 3) |
| nn.Conv2d | 2D-свёртка (изображение) | nn.Conv2d(3, 64, 3, padding=1) |
| nn.Conv3d | 3D-свёртка (видео) | nn.Conv3d(3, 64, 3) |
| nn.ConvTranspose2d | Транспонированная свёртка (декодер, апсемплинг) | nn.ConvTranspose2d(64, 3, 2, stride=2) |
Слои пулинга
| Функция | Описание | Пример |
|---|---|---|
| nn.MaxPool2d | 2D max-пулинг | nn.MaxPool2d(2, 2) |
| nn.AvgPool2d | 2D усредняющий пулинг | nn.AvgPool2d(2, 2) |
| nn.AdaptiveAvgPool2d | Адаптивный усредняющий пулинг (фиксированный размер выхода) | nn.AdaptiveAvgPool2d((1, 1)) |
| nn.AdaptiveMaxPool2d | Адаптивный макс-пулинг (фиксированный размер выхода) | nn.AdaptiveMaxPool2d((1, 1)) |
Линейные слои
| Функция | Описание | Пример |
|---|---|---|
| nn.Linear | Полносвязный слой (линейное преобразование) | nn.Linear(128, 64) |
| nn.Bilinear | Билинейный слой | nn.Bilinear(128, 64, 32) |
| Функция | Описание | Пример |
| nn.ReLU | Функция активации ReLU, f(x) = max(0, x) | nn.ReLU() |
| nn.GELU | Гауссовская линейная единица ошибки (по умолчанию в Transformer) | nn.GELU() |
| nn.SiLU | Функция активации Swish | nn.SiLU() |
| nn.Tanh | Гиперболический тангенс | nn.Tanh() |
| nn.Sigmoid | Сигмоидная функция активации | nn.Sigmoid() |
| nn.Softmax | Функция активации Softmax | nn.Softmax(dim=1) |
| nn.LogSoftmax | Log Softmax (численно устойчивый) | nn.LogSoftmax(dim=1) |
| nn.LeakyReLU | LeakyReLU, позволяет небольшие градиенты для отрицательных значений | nn.LeakyReLU(0.01) |
| nn.ELU | Экспоненциальная линейная единица | nn.ELU() |
Слои нормализации
| Функция | Описание | Пример |
|---|---|---|
| nn.BatchNorm2d | 2D пакетная нормализация (обычно используется в сверточных сетях) | nn.BatchNorm2d(64) |
| nn.LayerNorm | Нормализация слоя (обычно используется в Transformers) | nn.LayerNorm(512) |
| nn.GroupNorm | Групповая нормализация (обычно используется в ResNet и т. п.) | nn.GroupNorm(4, 64) |
| nn.InstanceNorm2d | Нормализация экземпляра (обычно используется при переносе стиля) | nn.InstanceNorm2d(64) |
Рекуррентные слои
| Функция | Описание | Пример |
|---|---|---|
| nn.LSTM | Слой LSTM (долгая краткосрочная память) | nn.LSTM(256, 512, 2) |
| nn.GRU | Слой GRU (управляемый рекуррентный блок) | nn.GRU(256, 512, 2) |
| nn.RNN | Простой слой RNN | nn.RNN(256, 512, 2) |
Слои Transformer
| Функция | Описание | Пример |
|---|---|---|
| nn.Transformer | Полная модель Transformer | nn.Transformer(d_model=512, nhead=8) |
| nn.TransformerEncoder | Энкодер Transformer | nn.TransformerEncoder(layer, num_layers=6) |
| nn.TransformerDecoder | Декодер Transformer | nn.TransformerDecoder(layer, num_layers=6) |
| nn.TransformerEncoderLayer | Слой энкодера Transformer | nn.TransformerEncoderLayer(512, 8) |
| nn.MultiheadAttention | Механизм многоголового внимания | nn.MultiheadAttention(512, 8) |
Слои эмбеддингов
| Функция | Описание | Пример |
|---|---|---|
| nn.Embedding | Слой эмбеддингов (отображает словарь в векторы) | nn.Embedding(10000, 256) |
| nn.EmbeddingBag | Эмбеддинг-сумка (агрегирует несколько эмбеддингов) | nn.EmbeddingBag(10000, 256) |
Слои Dropout
| Функция | Описание | Пример |
|---|---|---|
| nn.Dropout | Случайный dropout (предотвращает переобучение) | nn.Dropout(0.5) |
| nn.Dropout2d | 2D-дропаут (отбрасывает целые карты признаков) | nn.Dropout2d(0.5) |
Функции потерь
| Функция | Описание | Пример |
|---|---|---|
| nn.CrossEntropyLoss | Потеря кросс-энтропии (многоклассовая классификация) | nn.CrossEntropyLoss() |
| nn.MSELoss | Потеря среднеквадратичной ошибки (регрессия) | nn.MSELoss() |
| nn.L1Loss | Потеря L1 (MAE) | nn.L1Loss() |
| nn.BCEWithLogitsLoss | Бинарная кросс-энтропия с сигмоидой | nn.BCEWithLogitsLoss() |
| nn.HuberLoss | Потеря Хубера (робастная регрессия) | nn.HuberLoss() |
| nn.NLLLoss | Потеря отрицательного логарифмического правдоподобия | nn.NLLLoss() |
Функциональные функции (nn.functional)
| Функция | Описание | Пример |
|---|---|---|
F.relu |
Активация ReLU | F.relu(x) |
F.gelu |
Активация GELU | F.gelu(x) |
F.sigmoid |
Активация Sigmoid | F.sigmoid(x) |
F.softmax |
Активация Softmax | F.softmax(x, dim=1) |
F.dropout |
Операция Dropout | F.dropout(x, 0.5, training) |
F.conv2d |
2D-свёртка | F.conv2d(x, weight, bias) |
F.linear |
Линейное преобразование | F.linear(x, weight, bias) |
F.cross_entropy |
Кросс-энтропийная потеря | F.cross_entropy(logits, targets) |
F.mse_loss |
Потеря среднеквадратичной ошибки | F.mse_loss(pred, target) |
F.interpolate |
Интерполяция (апсемплинг/даунсемплинг) | F.interpolate(x, scale_factor=2) |
F.embedding |
Операция встраивания | F.embedding(indices, weight) |
Вспомогательные функции (nn.init)
| Функция | Описание | Пример |
|---|---|---|
nn.init.xavier_uniform_ |
Равномерная инициализация Xavier | nn.init.xavier_uniform_(module.weight) |
nn.init.xavier_normal_ |
Нормальная инициализация Xavier | nn.init.xavier_normal_(module.weight) |
nn.init.kaiming_uniform_ |
Равномерная инициализация Kaiming (подходит для ReLU) | nn.init.kaiming_uniform_(module.weight) |
nn.init.kaiming_normal_ |
Нормальная инициализация Kaiming (подходит для ReLU) | nn.init.kaiming_normal_(module.weight) |
nn.init.zeros_ |
Инициализация нулями | nn.init.zeros_(module.bias) |
nn.init.normal_ |
Нормальная инициализация | nn.init.normal_(module.weight, 0, 0.01) |
Вспомогательные функции (nn.utils)
| Функция | Описание | Пример |
|---|---|---|
nn.utils.clip_grad_norm_ |
Обрезка нормы градиента (предотвращает взрыв градиента) | nn.utils.clip_grad_norm_(model.parameters(), 1.0) |
nn.utils.weight_norm |
Нормализация весов | nn.utils.weight_norm(module, 'weight') |
nn.utils.spectral_norm |
Спектральная нормализация (часто используется в GANs) | nn.utils.spectral_norm(module, 'weight') |
nn.utils.rnn.pack_padded_sequence |
Упаковка последовательностей переменной длины | pack_padded_sequence(x, lengths) |
nn.utils.rnn.pad_packed_sequence |
Распаковка последовательностей | pad_packed_sequence(packed) |