Свёрточная нейронная сеть в PyTorch
Свёрточная нейронная сеть (CNN) PyTorch — это класс моделей глубокого обучения, специально предназначенных для обработки данных с сетчатой топологией (например, изображений).
CNN — ключевая технология для задач компьютерного зрения (таких как классификация изображений, обнаружение объектов и сегментация).
На следующей диаграмме показана структура и рабочий процесс типичной свёрточной нейронной сети (CNN), используемой для задач распознавания изображений.
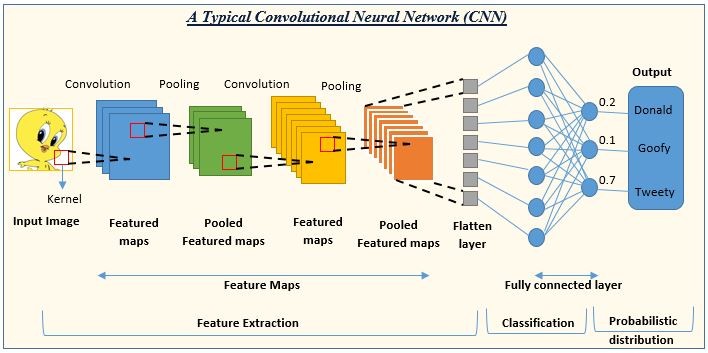
На рисунке выходной слой CNN выдаёт вероятности для трёх классов: Donald (0.2), Goofy (0.1) и Tweety (0.7), что указывает на то, что сеть считает, что входное изображение, скорее всего, Tweety.
Ниже приведено краткое описание каждой части:
-
Входное изображение: необработанные данные изображения, получаемые сетью.
-
Свёртка: ядро скользит по входному изображению, чтобы извлечь признаки и сгенерировать карты признаков.
-
Пулинг: Обычно применяется после свёрточного слоя; max pooling или average pooling уменьшают размер карт признаков, сохраняя важные признаки, и создают объединённые карты признаков.
-
Извлечение признаков: Комбинация нескольких свёрточных и пулинг-слоёв постепенно извлекает высокоуровневые признаки из изображения.
-
Слой выравнивания: Преобразует многомерные карты признаков в одномерный вектор для подачи на полносвязный слой.
-
Полносвязный слой: Подобно традиционным слоям нейронной сети, он отображает извлечённые признаки на выходные классы.
-
Классификация: Выходной слой сети выполняет классификацию на основе выхода полносвязного слоя.
-
Вероятностное распределение: Выходной слой выдаёт вероятность для каждого класса, отражая вероятность того, что входное изображение принадлежит каждому классу.
Базовая структура свёрточных нейронных сетей
1. Входной слой
Он получает исходные данные изображения. Изображение обычно представляется в виде трёхмерного массива, где два измерения представляют ширину и высоту изображения, а третье измерение представляет цветовые каналы (например, RGB-изображение имеет три канала).
2. Свёрточный слой
Он использует ядра свёртки для извлечения локальных признаков, таких как края и текстуры.
Формула:

- x: входное изображение.
- k: ядро свёртки (весовая матрица).
- b: смещение.
Группа обучаемых фильтров (или ядер свёртки) применяется к входному изображению с помощью операций свёртки для извлечения локальных признаков.
Каждый фильтр скользит по входному изображению и генерирует карту признаков, представляющую активацию фильтра в разных позициях.
Свёрточный слой может иметь несколько фильтров; каждый фильтр генерирует карту признаков, и все карты признаков образуют набор карт признаков.
3. Функция активации
Нелинейная функция активации, такая как ReLU (Rectified Linear Unit), обычно применяется после свёрточного слоя для внесения нелинейности, позволяя сети изучать более сложные закономерности.
Функция ReLU определяется как:f(x)=max(0,x), то есть, если вход меньше 0, выход 0; иначе выводится входное значение.
4. Слой пулинга
- Он используется для уменьшения пространственных размеров карт признаков, снижая вычислительные затраты и количество параметров, при этом сохраняя наиболее важную информацию о признаках.
- Наиболее распространённые операции пулинга — max pooling и average pooling.
- Максимальный пулинг выбирает максимальное значение в области, тогда как усредняющий пулинг вычисляет среднее значение в области.
5. Слой нормализации (опционально)
- Например, Local Response Normalization (LRN) или Batch Normalization.
- Эти слои помогают ускорить процесс обучения и повысить стабильность модели.
6. Полносвязный слой
- В конце CNN карты признаков, извлечённые предыдущими слоями, разворачиваются в одномерный вектор, а затем подаются на полносвязный слой.
- Каждый нейрон в полносвязном слое соединён со всеми нейронами предыдущего слоя, объединяя признаки для окончательной классификации или регрессии.
7. Выходной слой
В зависимости от задачи выходной слой может иметь разные формы.
Для задач классификации обычно используется функция Softmax, чтобы преобразовать выход в распределение вероятностей, представляющее вероятность принадлежности входных данных к каждому классу.
8. Функция потерь
Она используется для измерения различия между предсказаниями модели и истинными метками.
К распространённым функциям потерь относятся кросс-энтропийная потеря для задач многоклассовой классификации и среднеквадратичная ошибка (MSE) для задач регрессии.
9. Оптимизатор
Он используется для обновления весов сети на основе градиента функции потерь. К распространённым оптимизаторам относятся стохастический градиентный спуск (SGD), Adam, RMSprop и т. д.
10. Регуляризация (опционально)
Она включает такие методы, как Dropout и регуляризация L1/L2, чтобы предотвратить переобучение модели.
Эти слои можно складывать в стек, чтобы формировать более глубокие сетевые структуры и улучшить способность модели к обучению.
Глубину и сложность CNN можно регулировать в соответствии с требованиями задачи.
Реализация примера CNN на PyTorch
Следующий пример показывает, как построить простую модель CNN с помощью PyTorch для классификации цифр на наборе данных MNIST.
Основные шаги:
- Загрузка и предварительная обработка данных: Используйте
torchvisionзагрузите и предварительно обработайте данные MNIST. - Построение модели: Определите сверточные, пулинговые и полносвязные слои.
- Обучение: Обучите модель с помощью функции потерь и оптимизатора.
- Оценка: Вычислите точность модели на тестовом наборе.
- Визуализация: Показать несколько тестовых примеров и результаты их предсказания.
1. Импорт необходимых библиотек
import torch
import torch.nn as nn
import torch.nn.functional as F
import torch.optim as optim
2. Загрузка данных
Используйте набор данных MNIST, предоставляемый torchvision, для загрузки и предварительной обработки данных.
Пример
transforms.ToTensor(), # Преобразовать в тензор
transforms.Normalize((0.5,), (0.5,)) # Нормализовать до [-1, 1]
])
# Загрузить набор данных MNIST
train_dataset = datasets.MNIST(root='./data', train=True, transform=transform, download=True)
test_dataset = datasets.MNIST(root='./data', train=False, transform=transform, download=True)
train_loader = torch.utils.data.DataLoader(dataset=train_dataset, batch_size=64, shuffle=True)
test_loader = torch.utils.data.DataLoader(dataset=test_dataset, batch_size=64, shuffle=False)
3. Определите модель CNN
Используйтеnn.Moduleдля создания CNN.Пример
def __init__(self):
super(SimpleCNN, self).__init__()
# Определить сверточный слой: 1 входной канал, 32 выходных канала, размер ядра 3x3
self.conv1 = nn.Conv2d(1, 32, kernel_size=3, stride=1, padding=1)
# Определить сверточный слой: 32 входных канала, 64 выходных канала
self.conv2 = nn.Conv2d(32, 64, kernel_size=3, stride=1, padding=1)
# Определить полносвязный слой
self.fc1 = nn.Linear(64 * 7 * 7, 128) # Размер входа = размер карты признаков * количество каналов
self.fc2 = nn.Linear(128, 10) # 10 классов
def forward(self, x):
x = F.relu(self.conv1(x)) # Первый сверточный слой + ReLU
x = F.max_pool2d(x, 2) # Максимальный пулинг
x = F.relu(self.conv2(x)) # Второй сверточный слой + ReLU
x = F.max_pool2d(x, 2) # Максимальный пулинг
x = x.view(-1, 64 * 7 * 7) # Операция выравнивания
x = F.relu(self.fc1(x)) # Полносвязный слой + ReLU
x = self.fc2(x) # Выход полносвязного слоя
return x
# Создание экземпляра модели
model = SimpleCNN()
4. Определение функции потерь и оптимизатора
Используйте кросс-энтропийную функцию потерь и оптимизатор стохастического градиентного спуска.
criterion = nn.CrossEntropyLoss()  # 多分类交叉熵损失
optimizer = optim.SGD(model.parameters(), lr=0.01, momentum=0.9)  # 学习率和动量
5. Обучение модели
Обучите модель в течение 5 эпох и выводите потери при обучении после каждой эпохи.
Пример
model.train() # Установить режим обучения
for epoch in range(num_epochs):
total_loss = 0
for images, labels in train_loader:
# Прямой проход
outputs = model(images)
loss = criterion(outputs, labels)
# Обратный проход
optimizer.zero_grad()
loss.backward()
optimizer.step()
total_loss += loss.item()
print(f"Эпоха [{epoch+1}/{num_epochs}], Потери: {total_loss / len(train_loader):.4f}")
6. Тестирование модели
Оцените точность модели на тестовом наборе.
Пример
correct = 0
total = 0
with torch.no_grad(): # Во время оценки вычисление градиентов не требуется
for images, labels in test_loader:
outputs = model(images)
_, predicted = torch.max(outputs, 1) # Предсказать классы
total += labels.size(0)
correct += (predicted == labels).sum().item()
accuracy = 100 * correct / total
print(f"Точность на тесте: {accuracy:.2f}%")
7. Полный код
Полный код приведён ниже:
Пример
import torch.nn as nn
import torch.nn.functional as F
import torch.optim as optim
from torchvision import datasets, transforms
# 1. Загрузка и предобработка данных
transform = transforms.Compose([
transforms.ToTensor(), # Преобразовать в тензор
transforms.Normalize((0.5,), (0.5,)) # Нормализовать до [-1, 1]
])
# Загрузить набор данных MNIST
train_dataset = datasets.MNIST(root='./data', train=True, transform=transform, download=True)
test_dataset = datasets.MNIST(root='./data', train=False, transform=transform, download=True)
train_loader = torch.utils.data.DataLoader(dataset=train_dataset, batch_size=64, shuffle=True)
test_loader = torch.utils.data.DataLoader(dataset=test_dataset, batch_size=64, shuffle=False)
# 2. Определение модели CNN
class SimpleCNN(nn.Module):
def __init__(self):
super(SimpleCNN, self).__init__()
# Определение сверточных слоев
self.conv1 = nn.Conv2d(1, 32, kernel_size=3, stride=1, padding=1) # Вход 1 канал, выход 32 канала
self.conv2 = nn.Conv2d(32, 64, kernel_size=3, stride=1, padding=1) # Вход 32 канала, выход 64 канала
# Определение полносвязных слоев
self.fc1 = nn.Linear(64 * 7 * 7, 128) # Развернуть и подать в полносвязный слой
self.fc2 = nn.Linear(128, 10) # 10 классов
def forward(self, x):
x = F.relu(self.conv1(x)) # Первая свертка + ReLU
x = F.max_pool2d(x, 2) # Максимальный пулинг
x = F.relu(self.conv2(x)) # Вторая свертка + ReLU
x = F.max_pool2d(x, 2) # Максимальный пулинг
x = x.view(-1, 64 * 7 * 7) # Развернуть
x = F.relu(self.fc1(x)) # Полносвязный слой + ReLU
x = self.fc2(x) # Финальный выходной слой
return x
# Создание экземпляра модели
model = SimpleCNN()
# 3. Определить функцию потерь и оптимизатор
criterion = nn.CrossEntropyLoss() # Многоклассовая кросс-энтропийная потеря
optimizer = optim.SGD(model.parameters(), lr=0.01, momentum=0.9)
# 4. Обучение модели
num_epochs = 5
model.train() # Перевести модель в режим обучения
for epoch in range(num_epochs):
total_loss = 0
for images, labels in train_loader:
outputs = model(images) # Прямой проход
loss = criterion(outputs, labels) # Вычислить потерю
optimizer.zero_grad() # Очистить градиенты
loss.backward() # Обратный проход
optimizer.step() # Обновить параметры
total_loss += loss.item()
print(f"Эпоха [{epoch+1}/{num_epochs}], Потери: {total_loss / len(train_loader):.4f}")
# 5. Тестирование модели
model.eval() # Перевести модель в режим оценки
correct = 0
total = 0
with torch.no_grad(): # Отключить вычисление градиентов
for images, labels in test_loader:
outputs = model(images)
_, predicted = torch.max(outputs, 1)
total += labels.size(0)
correct += (predicted == labels).sum().item()
accuracy = 100 * correct / total
print(f"Точность на тесте: {accuracy:.2f}%")
Объяснение результатов выполнения
1. Вывод потерь при обучении
Код выводит среднее значение потерь после каждой эпохи, например,
Epoch [1/5], Loss: 0.2325
Epoch [2/5], Loss: 0.0526
Epoch [3/5], Loss: 0.0366
Epoch [4/5], Loss: 0.0273
Epoch [5/5], Loss: 0.0221
Пояснение:Постепенное уменьшение потерь указывает на то, что модель сходится шаг за шагом.
2. Точность на тестовом наборе
Код выводит итоговую точность классификации на тестовом наборе, например,
Test Accuracy: 98.96%
Пояснение:Модель достигает точности классификации 98.96% на тестовом наборе MNIST, что является хорошим результатом для простой модели CNN.
7. Визуализация результатов
Мы можем визуализировать несколько примеров и результаты их предсказаний на тестовых данных.
Пример
import torch.nn as nn
import torch.nn.functional as F
import torch.optim as optim
from torchvision import datasets, transforms
import matplotlib.pyplot as plt
# 1. Загрузка и предобработка данных
transform = transforms.Compose([
transforms.ToTensor(), # Преобразовать в тензор
transforms.Normalize((0.5,), (0.5,)) # Нормализовать до [-1, 1]
])
# Загрузить набор данных MNIST
train_dataset = datasets.MNIST(root='./data', train=True, transform=transform, download=True)
test_dataset = datasets.MNIST(root='./data', train=False, transform=transform, download=True)
train_loader = torch.utils.data.DataLoader(dataset=train_dataset, batch_size=64, shuffle=True)
test_loader = torch.utils.data.DataLoader(dataset=test_dataset, batch_size=64, shuffle=False)
# 2. Определение модели CNN
class SimpleCNN(nn.Module):
def __init__(self):
super(SimpleCNN, self).__init__()
# Определение сверточных слоев
self.conv1 = nn.Conv2d(1, 32, kernel_size=3, stride=1, padding=1) # Вход 1 канал, выход 32 канала
self.conv2 = nn.Conv2d(32, 64, kernel_size=3, stride=1, padding=1) # Вход 32 канала, выход 64 канала
# Определение полносвязных слоев
self.fc1 = nn.Linear(64 * 7 * 7, 128) # Развернуть и подать в полносвязный слой
self.fc2 = nn.Linear(128, 10) # 10 классов
def forward(self, x):
x = F.relu(self.conv1(x)) # Первая свертка + ReLU
x = F.max_pool2d(x, 2) # Максимальный пулинг
x = F.relu(self.conv2(x)) # Вторая свертка + ReLU
x = F.max_pool2d(x, 2) # Максимальный пулинг
x = x.view(-1, 64 * 7 * 7) # Развернуть
x = F.relu(self.fc1(x)) # Полносвязный слой + ReLU
x = self.fc2(x) # Финальный выходной слой
return x
# Создание экземпляра модели
model = SimpleCNN()
# 3. Определить функцию потерь и оптимизатор
criterion = nn.CrossEntropyLoss() # Многоклассовая кросс-энтропийная потеря
optimizer = optim.SGD(model.parameters(), lr=0.01, momentum=0.9)
# 4. Обучение модели
num_epochs = 5
model.train() # Перевести модель в режим обучения
for epoch in range(num_epochs):
total_loss = 0
for images, labels in train_loader:
outputs = model(images) # Прямой проход
loss = criterion(outputs, labels) # Вычислить потерю
optimizer.zero_grad() # Очистить градиенты
loss.backward() # Обратный проход
optimizer.step() # Обновить параметры
total_loss += loss.item()
print(f"Эпоха [{epoch+1}/{num_epochs}], Потери: {total_loss / len(train_loader):.4f}")
# 5. Тестирование модели
model.eval() # Перевести модель в режим оценки
correct = 0
total = 0
with torch.no_grad(): # Отключить вычисление градиентов
for images, labels in test_loader:
outputs = model(images)
_, predicted = torch.max(outputs, 1)
total += labels.size(0)
correct += (predicted == labels).sum().item()
accuracy = 100 * correct / total
print(f"Точность на тесте: {accuracy:.2f}%")
# 6. Визуализация результатов тестирования
dataiter = iter(test_loader)
images, labels = next(data)
outputs = model(images)
_, predictions = torch.max(outputs, 1)
fig, axes = plt.subplots(1, 6, figsize=(12, 4))
for i in range(6):
axes[i].imshow(images[i][0], cmap='gray')
axes[i].set_title(f"Label: {labels[i]}\nPred: {predictions[i]}")
axes[i].axis('off')
plt.show()
Результаты визуализации показывают фактические метки и предсказанные значения для 6 тестовых образцов, например:

В левом верхнем углу изображения находится рукописная цифра.
В заголовке показаны предсказанное значение модели и истинная метка.
Примечание: несколько распространённых ошибок
При загрузке набора данных MNIST загрузка не удаётся из-за ошибки проверки SSL-сертификата.
Downloading http://yann.lecun.com/exdb/mnist/train-images-idx3-ubyte.gz
Failed to download (trying next):
<urlopen error [SSL: CERTIFICATE_VERIFY_FAILED] certificate verify failed: unable to get local issuer certificate (_ssl.c:1129)>
...
Решения
Откройте терминал и выполните следующую команду для установки/обновления SSL-сертификата:
/Applications/Python\ 3.x/Install\ Certificates.command
Замените 3.x на фактически установленную у вас версию Python.
После выполнения этой команды перезапустите ваш код Python, и он должен успешно загрузить набор данных MNIST.
Другие расширения