Линейная регрессия в PyTorch
Линейная регрессия — один из самых фундаментальных алгоритмов машинного обучения, используемый для предсказания непрерывного значения. Это простой и распространённый метод регрессионного анализа, целью которого является предсказание выходного значения путём подгонки линейной функции.
Для задачи простой линейной регрессии модель можно выразить так:

- y — предсказанное значение (целевое значение).
- \(x_1\), \(x_2\), \(x_n\) — входные признаки.
- \(w_1\), \(w_2\), \(w_n\) — это обучаемые веса (параметры модели).
- b — это член смещения.
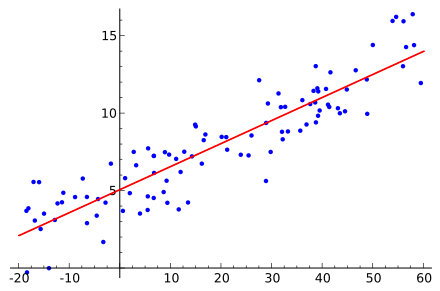
В PyTorch модель линейной регрессии можно реализовать путём наследования отnn.Moduleкласса. Мы воспользуемся простым примером, чтобы подробно объяснить, как реализовать модель линейной регрессии с помощью PyTorch.
Подготовка данных
Сначала мы подготовим немного искусственных данных для обучения нашей модели линейной регрессии. Здесь мы можем сгенерировать набор данных с простой линейной зависимостью, где каждый пример имеет два признака \(x_1\), \(x_2\).
Пример
import numpy as np
import matplotlib.pyplot as plt
# Случайное зерно для обеспечения одинаковых результатов при повторных запусках
torch.manual_seed(42)
# Сгенерировать обучающие данные
X = torch.randn(100, 2) # 100 образцов, каждый с 2 признаками
true_w = torch.tensor([2.0, 3.0]) # Предположим истинные веса
true_b = 4.0 # Член смещения
Y = X @ true_w + true_b + torch.randn(100) * 0.1 # Добавим немного шума
# Выведем некоторые данные
print(X[:5])
print(Y[:5])
Вывод следующий:
tensor([[ 1.9269,  1.4873],
        [ 0.9007, -2.1055],
        [ 0.6784, -1.2345],
        [-0.0431, -1.6047],
        [-0.7521,  1.6487]])
tensor([12.4460, -0.4663,  1.7666, -0.9357,  7.4781])
Этот код создаёт линейный набор данных с шумом.
- Вход X — это матрица 100x2, каждый образец имеет два признака.
- Выход Y генерируется из истинных весов и смещения с добавлением случайного шума.
- Использование
torch.manual_seed(42)обеспечивает согласованные результаты между запусками, упрощая отладку и воспроизведение.
Определение модели линейной регрессии
Мы можем определить простую модель линейной регрессии путём наследованияnn.ModuleВ PyTorch ядром линейной регрессии являетсяnn.Linear()слой, который автоматически выполняет инициализацию весов и смещений.
Пример
# Определение модели линейной регрессии
class LinearRegressionModel(nn.Module):
def __init__(self):
super(LinearRegressionModel, self).__init__()
# Определение линейного слоя: вход — 2 признака, выход — 1 прогноз
self.linear = nn.Linear(2, 1) # Размер входа 2, размер выхода 1
def forward(self, x):
return self.linear(x) # Прямое распространение, вернуть результат предсказания
# Создание экземпляра модели
model = LinearRegressionModel()
Здесьnn.Linear(2, 1)представляет линейный слой, который имеет 2 входных признака и 1 выход.forwardМетод определяет, как выполнять прямое распространение через этот слой.
Примечание:
nn.Linearавтоматически создаёт матрицу весов и вектор смещения, не нужно определять их вручную.
Определение функции потерь и оптимизатора
Распространённая функция потерь для линейной регрессии — этопотеря среднеквадратичной ошибки (MSELoss), используемая для измерения различия между предсказанными и истинными значениями. PyTorch предоставляет готовую функцию MSELoss.
Мы будем использоватьSGD (стохастический градиентный спуск)илиAdam-оптимизатор для минимизации функции потерь.
Пример
criterion = nn.MSELoss()
# Оптимизатор (с использованием SGD или Adam)
optimizer = torch.optim.SGD(model.parameters(), lr=0.01) # Скорость обучения установлена на 0.01
# Вы также можете использовать оптимизатор Adam
# optimizer = torch.optim.Adam(model.parameters(), lr=0.01)
| Компонент | Описание |
|---|---|
MSELoss |
Вычислите среднеквадратичную ошибку между предсказанными и истинными значениями, формула: \(\frac{1}{n}\sum(y_{pred} - y_{true})^2\) |
SGD |
Используйте стохастический градиентный спуск для обновления параметров, скорость обучения управляет размером шага каждого обновления |
Adam |
Оптимизатор с адаптивной скоростью обучения, обычно сходится быстрее |
Обучение модели
Во время обучения мы выполним следующие шаги:
- Используйте входные данные X для прямого распространения, чтобы получить предсказания.
- Вычислите потери (разницу между предсказанными и фактическими значениями).
- Используйте обратное распространение для вычисления градиентов.
- Обновите параметры модели (веса и смещение).
Мы будем обучать модель 1000 эпох и выводить значение потерь каждые 100 эпох.
Пример
num_epochs = 1000 # Обучение в течение 1000 эпох
for epoch in range(num_epochs):
model.train() # Перевести модель в режим обучения
# Прямое распространение
predictions = model(X) # Модель выдает предсказания
loss = criterion(predictions.squeeze(), Y) # Вычислите потери (обратите внимание, что предсказания нужно сжать до 1D)
# Обратное распространение
optimizer.zero_grad() # Очистить предыдущие градиенты
loss.backward() # Вычислите градиенты
optimizer.step() # Обновить параметры модели
# Вывести потери
if (epoch + 1) % 100 == 0:
print(f'Эпоха [{epoch + 1}/1000], Потери: {loss.item():.4f}')
predictions.squeeze(): Сожмите выход модели из 2D-тензора в 1D, потому что целевое значениеYявляется одномерным массивом.optimizer.zero_grad(): Перед каждым обратным распространением необходимо обнулять предыдущие градиенты, иначе градиенты будут накапливаться.loss.backward(): Автоматически вычисляет градиенты всех обучаемых параметров.optimizer.step(): Обновляет веса и смещение на основе вычисленных градиентов.
Режим обучения и режим оценки:Вызов в цикле обучения
model.train()необходимо. Хотя в этом примере не используются Dropout или BatchNorm, вырабатывать эту привычку важно для сложных моделей.
Оценка модели
После обучения мы можем оценить качество модели, проверив её веса и смещение. Мы также можем делать предсказания на новых данных и сравнивать их с фактическими значениями.
Пример
print(f'Предсказанный вес: {model.linear.weight.data.numpy()}')
print(f'Предсказанное смещение: {model.linear.bias.data.numpy()}')
# Сделать предсказания на новых данных
with torch.no_grad(): # Нет необходимости вычислять градиенты во время оценки
predictions = model(X)
# Визуализация предсказаний и фактических значений
plt.scatter(X[:, 0], Y, color='blue', label='Истинные значения')
plt.scatter(X[:, 0], predictions, color='red', label='Предсказания')
plt.legend()
plt.show()
model.linear.weight.dataиmodel.linear.bias.data: Эти атрибуты хранят веса и смещение модели.torch.no_grad(): В режиме оценки не нужно вычислять градиенты, что экономит память и ускоряет вывод.
Полный пример кода
Ниже приведён полный код для всех вышеописанных шагов, собранный вместе и готовый к запуску:
Пример
import torch.nn as nn
import matplotlib.pyplot as plt
# 1. Подготовка данных
torch.manual_seed(42)
X = torch.randn(100, 2) # 100 образцов, 2 признака
true_w = torch.tensor([2.0, 3.0])
true_b = 4.0
Y = X @ true_w + true_b + torch.randn(100) * 0.1
# 2. Определение модели
class LinearRegressionModel(nn.Module):
def __init__(self):
super().__init__()
self.linear = nn.Linear(2, 1)
def forward(self, x):
return self.linear(x)
model = LinearRegressionModel()
# 3. Определить функцию потерь и оптимизатор
criterion = nn.MSELoss()
optimizer = torch.optim.SGD(model.parameters(), lr=0.01)
# 4. Обучение модели
num_epochs = 1000
for epoch in range(num_epochs):
model.train()
predictions = model(X)
loss = criterion(predictions.squeeze(), Y)
optimizer.zero_grad()
loss.backward()
optimizer.step()
if (epoch + 1) % 100 == 0:
print(f'Эпоха [{epoch + 1}/{num_epochs}], Потери: {loss.item():.4f}')
# 5. Оценка модели
print(f'\nОбученные веса: {model.linear.weight.data.numpy()}')
print(f'Обученное смещение: {model.linear.bias.data.numpy()}')
print(f'Истинные веса: {true_w.numpy()}')
print(f'Истинное смещение: {true_b}')
Анализ результатов выполнения
После запуска приведённого выше кода вы увидите вывод, похожий на следующий:
Epoch [100/1000], Loss: 0.0654
Epoch [200/1000], Loss: 0.0398
Epoch [300/1000], Loss: 0.0243
Epoch [400/1000], Loss: 0.0148
Epoch [500/1000], Loss: 0.0090
Epoch [600/1000], Loss: 0.0055
Epoch [700/1000], Loss: 0.0033
Epoch [800/1000], Loss: 0.0020
Epoch [900/1000], Loss: 0.0012
Epoch [1000/1000], Loss: 0.0008

训练后的权重: [[2.0016 2.9973]]
训练后的偏置: [4.0015]
真实权重: [2. 3.]
真实偏置: 4.0
Видно, что с увеличением числа эпох обучения значение потерь непрерывно уменьшается. В конечном итоге веса и смещение модели становятся очень близки к истинным значениям, что указывает на то, что модель успешно выучила линейную зависимость данных.
Расширение: использование более сложных оптимизаторов
Помимо SGD, PyTorch предоставляет множество других оптимизаторов. Ниже приведён пример использования оптимизатора Adam:
Пример
optimizer = torch.optim.Adam(model.parameters(), lr=0.01)
# Обучаем модель
for epoch in range(num_epochs):
model.train()
predictions = model(X)
loss = criterion(predictions.squeeze(), Y)
optimizer.zero_grad()
loss.backward()
optimizer.step()
if (epoch + 1) % 100 == 0:
print(f'Эпоха [{epoch + 1}/{num_epochs}], Потери: {loss.item():.4f}')
| Оптимизатор | Особенности | Применимые сценарии |
|---|---|---|
| SGD | Простой и понятный, требует ручной настройки скорости обучения | Большие наборы данных, классические сценарии |
| Adam | Адаптивная скорость обучения, быстрая сходимость | Большинство сценариев, рекомендуемый выбор по умолчанию |
| RMSprop | Подходит для рекуррентных нейронных сетей | Модели последовательностей, такие как RNN, LSTM |
Распространённые проблемы
Проблема 1: Значение потерь не уменьшается
Если значение потерь не уменьшается во время обучения, возможные причины включают:
- Слишком маленькая скорость обучения, из-за чего обновления параметров слишком малы.
- Слишком большая скорость обучения, из-за чего оптимальное решение пропускается.
- Проблемы с данными, например, диапазоны значений признаков слишком сильно различаются.
Решение:
- Попробуйте изменить скорость обучения (начните с 0.1, 0.01, 0.001).
- Стандартизируйте входные данные.
- Проверьте данные на выбросы или пропущенные значения.
Проблема 2: Несоответствие формы предсказания
Если при вычислении потерь возникает ошибка несоответствия формы, возможно, вам потребуется использоватьsqueeze()илиunsqueeze()Скорректируйте форму тензора.
Пример
predictions = model(X)
print(f'Форма вывода модели: {predictions.shape}') # Должно быть [100, 1]
# Сжать до 1D
predictions = predictions.squeeze()
print(f'Форма после сжатия: {predictions.shape}') # Должно быть
# Вычислить потери
loss = criterion(predictions, Y)
Задача 3: Как улучшить точность модели
- Увеличьте количество эпох обучения.
- Настройте скорость обучения.
- Используйте более сложную структуру модели (например, многослойную нейронную сеть).
- Увеличьте объем обучающих данных.