Régression linéaire PyTorch
La régression linéaire est l'un des algorithmes d'apprentissage automatique les plus fondamentaux, utilisé pour prédire une valeur continue. C'est une méthode d'analyse de régression simple et courante qui vise à prédire la sortie en ajustant une fonction linéaire.
Pour un problème de régression linéaire simple, le modèle peut être exprimé comme suit :
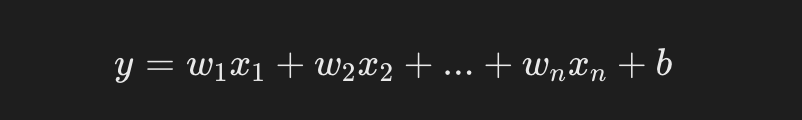
- y est la valeur prédite (valeur cible).
- \(x_1\), \(x_2\), \(x_n\) sont des caractéristiques d'entrée.
- \(w_1\), \(w_2\), \(w_n\) sont les poids à apprendre (paramètres du modèle).
- b est le terme de biais.
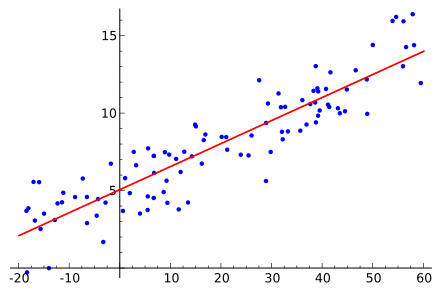
Dans PyTorch, un modèle de régression linéaire peut être implémenté en héritant denn.Modulela classe. Nous utiliserons un exemple simple pour expliquer en détail comment implémenter un modèle de régression linéaire à l'aide de PyTorch.
Préparation des données
Nous préparons d'abord quelques données factices pour entraîner notre modèle de régression linéaire. Ici, nous pouvons générer un jeu de données avec une relation linéaire simple, où chaque échantillon possède deux caractéristiques \(x_1\), \(x_2\).
Exemple
import numpy as np
import matplotlib.pyplot as plt
# Graine aléatoire pour garantir des résultats cohérents d'une exécution à l'autre
torch.manual_seed(42)
# Générer des données d'entraînement
X = torch.randn(100, 2) # 100 échantillons, chacun avec 2 caractéristiques
true_w = torch.tensor([2.0, 3.0]) # Supposons les vrais poids
true_b = 4.0 # Terme de biais
Y = X @ true_w + true_b + torch.randn(100) * 0.1 # Ajouter du bruit
# Afficher quelques données
print(X[:5])
print(Y[:5])
La sortie est la suivante :
tensor([[ 1.9269,  1.4873],
        [ 0.9007, -2.1055],
        [ 0.6784, -1.2345],
        [-0.0431, -1.6047],
        [-0.7521,  1.6487]])
tensor([12.4460, -0.4663,  1.7666, -0.9357,  7.4781])
Ce code crée un jeu de données linéaire avec du bruit.
- L'entrée X est une matrice 100x2, chaque échantillon a deux caractéristiques.
- La sortie Y est générée à partir des vrais poids et du biais, avec un peu de bruit aléatoire ajouté.
- Utilisation
torch.manual_seed(42)garantit des résultats cohérents entre les exécutions, ce qui facilite le débogage et la reproduction.
Définir le modèle de régression linéaire
Nous pouvons définir un modèle de régression linéaire simple en héritantnn.ModuleDans PyTorch, le cœur de la régression linéaire est lenn.Linear()couche, qui gère automatiquement l'initialisation des poids et des biais.
Exemple
# Définir le modèle de régression linéaire
class LinearRegressionModel(nn.Module):
def __init__(self):
super(LinearRegressionModel, self).__init__()
# Définir une couche linéaire, l'entrée comporte 2 caractéristiques, la sortie est 1 prédiction
self.linear = nn.Linear(2, 1) # Dimension d'entrée 2, dimension de sortie 1
def forward(self, x):
return self.linear(x) # Propagation avant, retourner le résultat de prédiction
# Créer une instance du modèle
model = LinearRegressionModel()
Ici,nn.Linear(2, 1)représente une couche linéaire, qui possède 2 caractéristiques d'entrée et 1 sortie.forwardLa méthode définit comment effectuer la propagation avant à travers cette couche.
Remarque :
nn.Linearcrée automatiquement la matrice de poids et le vecteur de biais, sans avoir besoin de les définir manuellement.
Définition de la fonction de perte et de l'optimiseur
La fonction de perte courante pour la régression linéaire estMean Squared Error Loss (MSELoss), utilisée pour mesurer la différence entre les valeurs prédites et les valeurs réelles. PyTorch fournit une fonction MSELoss prête à l'emploi.
Nous utiliseronsSGD (descente de gradient stochastique)ouAdamcomme optimiseur pour minimiser la fonction de perte.
Exemple
criterion = nn.MSELoss()
# Optimiseur (avec SGD ou Adam)
optimizer = torch.optim.SGD(model.parameters(), lr=0.01) # Taux d'apprentissage défini à 0.01
# Vous pouvez aussi utiliser l'optimiseur Adam
# optimizer = torch.optim.Adam(model.parameters(), lr=0.01)
| Composant | Description |
|---|---|
MSELoss |
Calculez l'erreur quadratique moyenne entre les valeurs prédites et réelles, formule : \(\frac{1}{n}\sum(y_{pred} - y_{true})^2\) |
SGD |
Utilisez la descente de gradient stochastique pour mettre à jour les paramètres, le taux d'apprentissage contrôle la taille du pas de chaque mise à jour |
Adam |
Optimiseur à taux d'apprentissage adaptatif, converge généralement plus rapidement |
Entraînement du modèle
Pendant l'entraînement, nous effectuerons les étapes suivantes :
- Utilisez les données d'entrée X pour la propagation avant afin d'obtenir des prédictions.
- Calculer la perte (différence entre les valeurs prédites et réelles).
- Utiliser la rétropropagation pour calculer les gradients.
- Mettre à jour les paramètres du modèle (poids et biais).
Nous allons entraîner le modèle pendant 1000 époques et afficher la perte toutes les 100 époques.
Exemple
num_epochs = 1000 # Entraîner pendant 1000 époques
for epoch in range(num_epochs):
model.train() # Passer le modèle en mode entraînement
# Propagation avant
predictions = model(X) # Le modèle produit des prédictions
loss = criterion(predictions.squeeze(), Y) # Calculer la perte (notez que les prédictions doivent être réduites à 1D)
# Rétropropagation
optimizer.zero_grad() # Effacer les gradients précédents
loss.backward() # Calculer les gradients
optimizer.step() # Mettre à jour les paramètres du modèle
# Afficher la perte
if (epoch + 1) % 100 == 0:
print(f'Epoch [{epoch + 1}/1000], Loss: {loss.item():.4f}')
predictions.squeeze(): Réduire la sortie du modèle d'un tenseur 2D à 1D, car la valeur cibleYest un tableau à une dimension.optimizer.zero_grad(): Avant chaque rétropropagation, vous devez effacer les gradients précédents, sinon les gradients s'accumuleront.loss.backward(): Calcule automatiquement les gradients de tous les paramètres entraînables.optimizer.step(): Met à jour les poids et le biais en fonction des gradients calculés.
Mode entraînement vs mode évaluation :Appel dans la boucle d'entraînement
model.train()est nécessaire. Bien que cet exemple n'utilise pas Dropout ou BatchNorm, développer cette habitude est important pour les modèles complexes.
Évaluation du modèle
Après l'entraînement, nous pouvons évaluer les performances du modèle en inspectant ses poids et son biais. Nous pouvons également faire des prédictions sur de nouvelles données et les comparer avec les valeurs réelles.
Exemple
print(f'Poids prédit: {model.linear.weight.data.numpy()}')
print(f'Biais prédit: {model.linear.bias.data.numpy()}')
# Faire des prédictions sur de nouvelles données
with torch.no_grad(): # Pas besoin de calculer les gradients pendant l'évaluation
predictions = model(X)
# Visualiser les prédictions et les valeurs réelles
plt.scatter(X[:, 0], Y, color='blue', label='Valeurs réelles')
plt.scatter(X[:, 0], predictions, color='red', label='Prédictions')
plt.legend()
plt.show()
model.linear.weight.dataetmodel.linear.bias.data: Ces attributs stockent les poids et le biais du modèle.torch.no_grad(): En mode évaluation, il n'est pas nécessaire de calculer les gradients, ce qui économise de la mémoire et améliore la vitesse d'inférence.
Exemple de code complet
Voici le code complet pour toutes les étapes ci-dessus, intégré et prêt à être exécuté :
Exemple
import torch.nn as nn
import matplotlib.pyplot as plt
# 1. Préparer les données
torch.manual_seed(42)
X = torch.randn(100, 2) # 100 échantillons, 2 caractéristiques
true_w = torch.tensor([2.0, 3.0])
true_b = 4.0
Y = X @ true_w + true_b + torch.randn(100) * 0.1
# 2. Définir le modèle
class LinearRegressionModel(nn.Module):
def __init__(self):
super().__init__()
self.linear = nn.Linear(2, 1)
def forward(self, x):
return self.linear(x)
model = LinearRegressionModel()
# 3. Définir la fonction de perte et l'optimiseur
criterion = nn.MSELoss()
optimizer = torch.optim.SGD(model.parameters(), lr=0.01)
# 4. Entraîner le modèle
num_epochs = 1000
for epoch in range(num_epochs):
model.train()
predictions = model(X)
loss = criterion(predictions.squeeze(), Y)
optimizer.zero_grad()
loss.backward()
optimizer.step()
if (epoch + 1) % 100 == 0:
print(f'Époque [{epoch + 1}/{num_epochs}], Perte : {loss.item():.4f}')
# 5. Évaluer le modèle
print(f'\nPoids entraînés : {model.linear.weight.data.numpy()}')
print(f'Biais entraîné : {model.linear.bias.data.numpy()}')
print(f'Poids réels : {true_w.numpy()}')
print(f'Biais réel : {true_b}')
Analyse des résultats d'exécution
Après avoir exécuté le code ci-dessus, vous verrez une sortie similaire à ce qui suit :
Epoch [100/1000], Loss: 0.0654
Epoch [200/1000], Loss: 0.0398
Epoch [300/1000], Loss: 0.0243
Epoch [400/1000], Loss: 0.0148
Epoch [500/1000], Loss: 0.0090
Epoch [600/1000], Loss: 0.0055
Epoch [700/1000], Loss: 0.0033
Epoch [800/1000], Loss: 0.0020
Epoch [900/1000], Loss: 0.0012
Epoch [1000/1000], Loss: 0.0008

训练后的权重: [[2.0016 2.9973]]
训练后的偏置: [4.0015]
真实权重: [2. 3.]
真实偏置: 4.0
On peut voir que, à mesure que le nombre d'époques d'entraînement augmente, la valeur de perte diminue continuellement. Finalement, les poids et le biais du modèle sont très proches des valeurs réelles, ce qui indique que le modèle a appris avec succès la relation linéaire des données.
Extension : utilisation d'optimiseurs plus complexes
En plus de SGD, PyTorch fournit de nombreux autres optimiseurs. Voici un exemple utilisant l'optimiseur Adam :
Exemple
optimizer = torch.optim.Adam(model.parameters(), lr=0.01)
# Entraîner le modèle
for epoch in range(num_epochs):
model.train()
predictions = model(X)
loss = criterion(predictions.squeeze(), Y)
optimizer.zero_grad()
loss.backward()
optimizer.step()
if (epoch + 1) % 100 == 0:
print(f'Époque [{epoch + 1}/{num_epochs}], Perte : {loss.item():.4f}')
| Optimiseur | Fonctionnalités | Scénarios applicables |
|---|---|---|
| SGD | Simple et direct, nécessite un réglage manuel du taux d'apprentissage | Grands ensembles de données, scénarios classiques |
| Adam | Taux d'apprentissage adaptatif, convergence rapide | La plupart des scénarios, choix par défaut recommandé |
| RMSprop | Adapté aux réseaux de neurones récurrents | Modèles de séquence tels que RNN, LSTM |
Problèmes courants
Problème 1 : La valeur de perte ne diminue pas
Si la valeur de perte ne diminue pas pendant l'entraînement, les raisons possibles incluent :
- Taux d'apprentissage trop petit, ce qui rend les mises à jour des paramètres trop petites.
- Taux d'apprentissage trop grand, ce qui fait sauter la solution optimale.
- Problèmes avec les données, comme des plages de valeurs des caractéristiques trop disparates.
Solution :
- Essayez d'ajuster le taux d'apprentissage (commencez par 0.1, 0.01, 0.001).
- Standardisez les données d'entrée.
- Vérifiez les valeurs aberrantes ou manquantes dans les données.
Problème 2 : Incompatibilité de forme des prédictions
Si une erreur d'incompatibilité de forme se produit lors du calcul de la perte, vous devrez peut-être utilisersqueeze()ouunsqueeze()Ajustez la forme du tenseur.
Exemple
predictions = model(X)
print(f'Forme de sortie du modèle : {predictions.shape}') # Devrait être [100, 1]
# Réduire à 1D
predictions = predictions.squeeze()
print(f'Forme après squeeze : {predictions.shape}') # Devrait être
# Calculer la perte
loss = criterion(predictions, Y)
Problème 3 : Comment améliorer la précision du modèle
- Augmenter le nombre d'époques d'entraînement.
- Ajuster le taux d'apprentissage.
- Utiliser une structure de modèle plus complexe (par ex., un réseau de neurones multicouche).
- Augmenter la quantité de données d'entraînement.