Bases des réseaux de neurones PyTorch
Un réseau de neurones est un modèle informatique qui imite la façon dont le cerveau humain traite l'information. Il est constitué de nombreux nœuds (neurones) interconnectés disposés en couches.
La puissance des réseaux de neurones réside dans leur capacité à apprendre automatiquement des motifs et des caractéristiques complexes à partir de grandes quantités de données, sans avoir besoin d'extracteurs de caractéristiques conçus manuellement.
Avec le développement de l'apprentissage profond, les réseaux de neurones sont devenus une technologie clé pour résoudre de nombreux problèmes complexes.
Neurone
Un neurone est l'unité de base d'un réseau de neurones. Il reçoit des signaux d'entrée, calcule une somme pondérée, ajoute un biais, puis passe le résultat par une fonction d'activation pour produire une sortie.
Les poids et les biais d'un neurone sont les paramètres qui doivent être ajustés pendant le processus d'apprentissage du réseau.
Entrée et sortie :
- Entrée: L'entrée est le point de départ du réseau et peut être constituée de données de caractéristiques, telles que des valeurs de pixels d'image ou des vecteurs de mots de texte.
- Sortie: La sortie est le point final du réseau, représentant le résultat de prédiction du modèle, tel que l'étiquette de classe dans une tâche de classification.
Un neurone reçoit plusieurs entrées (par exemple, x1, x2, ..., xn). Si la somme pondérée des entrées est supérieure au seuil d'activation (potentiel d'activation), il produit une sortie binaire.
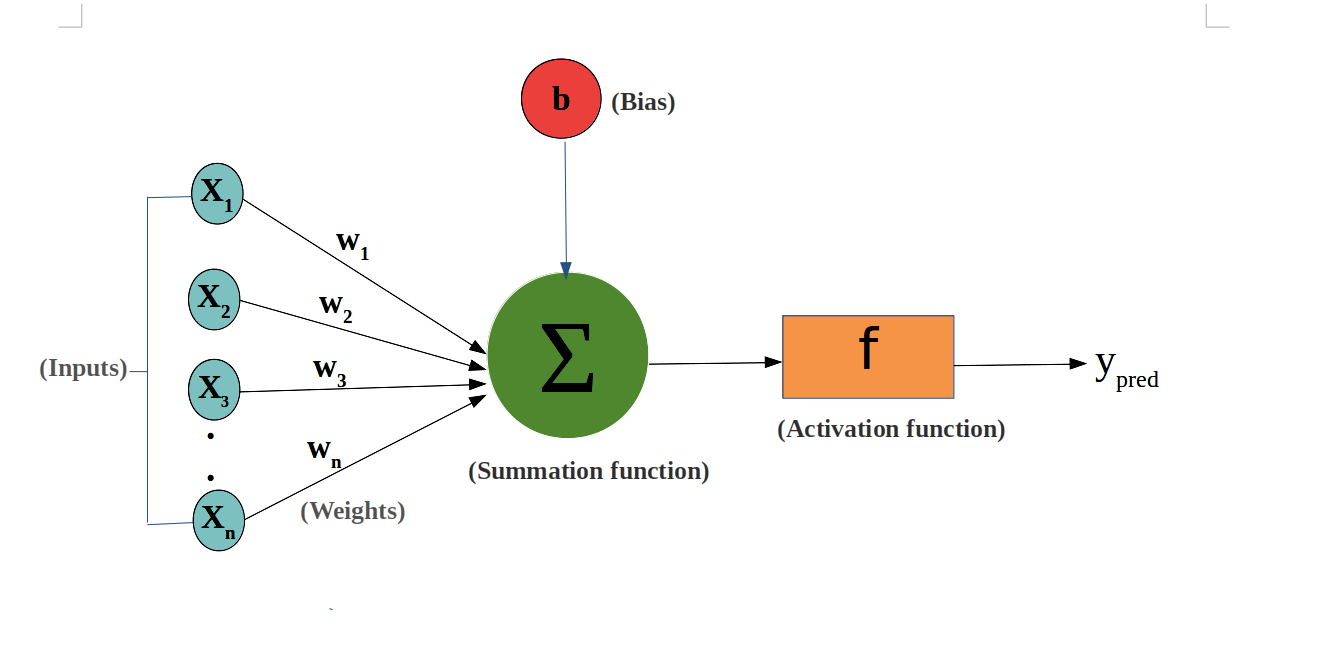
La sortie d'un neurone peut être considérée comme la somme pondérée de ses entrées plus un biais. La représentation mathématique d'un neurone est :
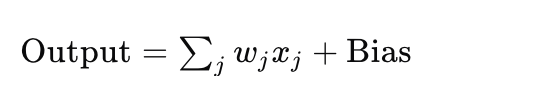
Ici,wjest le poids,xjest l'entrée, etBiaisest le terme de biais.
Couche
Les couches situées entre la couche d'entrée et la couche de sortie sont appelées couches cachées. La densité et le type de connexions entre les couches constituent la configuration du réseau.
Un réseau de neurones est composé de plusieurs couches, notamment :
- Couche d'entrée: Reçoit les données d'entrée brutes.
- Couche cachée: traite les données d'entrée ; il peut y avoir plusieurs couches cachées.
- Couche de sortie: produit le résultat de sortie final.
Architecture typique d'un réseau de neurones :
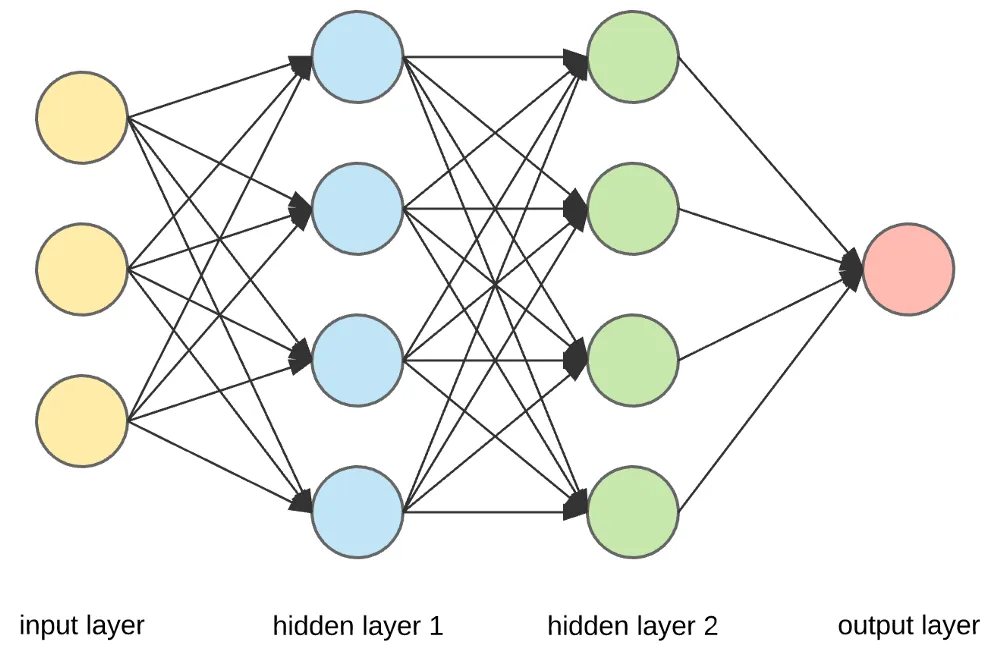
Schéma de démonstration :
Réseau de neurones à propagation avant (FNN)
Le réseau de neurones à propagation avant (FNN) est une unité de base de la famille des réseaux de neurones.
La caractéristique d'un réseau de neurones à propagation avant est que les données circulent de la couche d'entrée, à travers une ou plusieurs couches cachées, et atteignent finalement la couche de sortie, sans aucune boucle ni rétroaction tout au long du processus.
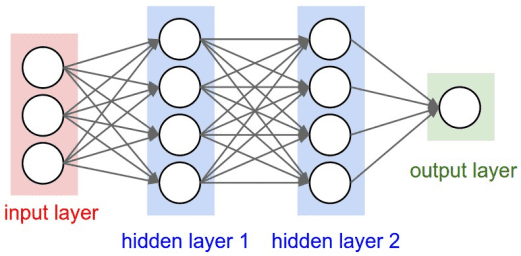
Structure de base d'un réseau de neurones à propagation avant :
-
Couche d'entrée :Le point d'entrée où les données pénètrent dans le réseau. Chaque nœud de la couche d'entrée représente une caractéristique d'entrée.
Couche cachée :Une ou plusieurs couches utilisées pour capturer les caractéristiques non linéaires des données. Chaque couche cachée est composée de plusieurs neurones, et chaque neurone augmente la non-linéarité via une fonction d'activation.
Couche de sortie :Produit le résultat de prédiction du réseau. Le nombre de nœuds dépend du type de problème ; par exemple, le nombre de nœuds de sortie dans un problème de classification est égal au nombre de classes.
Poids et biais de connexion :Les entrées de chaque neurone sont pondérées et sommées, puis un biais est ajouté, et le résultat passe par une fonction d'activation.
Réseau de neurones récurrent (RNN)
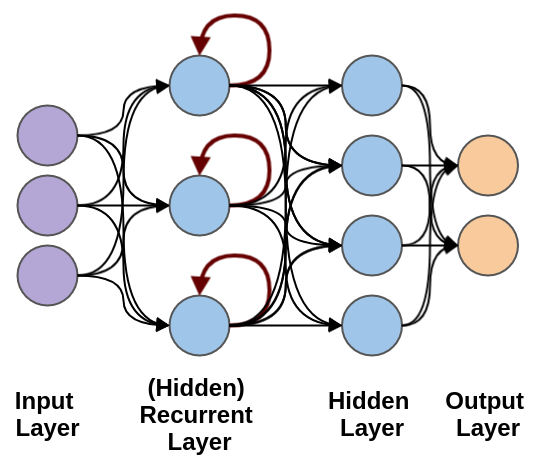
Un réseau de neurones récurrent (RNN) est un type de réseau de neurones spécialement conçu pour traiter des données séquentielles, capable de capturer les dépendances dans les informations temporelles ou séquentielles au sein des données d'entrée.
La particularité des RNN est leur « capacité de mémoire » — ils peuvent stocker des informations des pas de temps précédents dans l'état caché du réseau.
Les réseaux de neurones récurrents sont utilisés pour traiter des motifs de données qui évoluent dans le temps.
Dans un RNN, la même couche est utilisée pour recevoir les paramètres d'entrée et afficher les paramètres de sortie dans le réseau de neurones spécifié.
PyTorch fournit des outils puissants pour construire et entraîner des réseaux de neurones.
Les réseaux de neurones dans PyTorch sonttorch.nnimplémentés via le module.
torch.nnLe module fournit diverses couches de réseau (telles que des couches entièrement connectées, des couches convolutionnelles, etc.), des fonctions de perte et des optimiseurs, ce qui rend plus pratique la construction et l'entraînement de réseaux de neurones.
Dans PyTorch, la construction d'un réseau de neurones nécessite généralement d'hériter de la classe nn.Module.
nn.Module est la classe de base de tous les modules de réseau de neurones. Vous devez définir les deux parties suivantes :
__init__(): Définir les couches du réseau.forward(): Définir le processus de propagation avant des données.
Réseau de neurones simple entièrement connecté :
Exemple
import torch.nn as nn
# Définir un modèle de réseau de neurones simple
class SimpleNN(nn.Module):
def __init__(self):
super(SimpleNN, self).__init__()
# Définir une couche entièrement connectée de la couche d'entrée à la couche cachée
self.fc1 = nn.Linear(2, 2) # Entrée 2 caractéristiques, sortie 2 caractéristiques
# Définir une couche entièrement connectée de la couche cachée à la couche de sortie
self.fc2 = nn.Linear(2, 1) # Entrée 2 caractéristiques, sortie 1 valeur prédite
def forward(self, x):
# Processus de propagation avant
x = torch.relu(self.fc1(x)) # Utiliser la fonction d'activation ReLU
x = self.fc2(x) # Couche de sortie
return x
# Créer une instance du modèle
model = SimpleNN()
# Afficher le modèle
print(model)
Le résultat de sortie est le suivant :
SimpleNN(
  (fc1): Linear(in_features=2, out_features=2, bias=True)
  (fc2): Linear(in_features=2, out_features=1, bias=True)
)
PyTorch fournit de nombreuses couches de réseaux de neurones courantes. Voici quelques-unes courantes :
nn.Linear(in_features, out_features): Couche entièrement connectée, entréein_featurescaractéristiques, sortieout_featurescaractéristiques.nn.Conv2d(in_channels, out_channels, kernel_size): couche convolutionnelle 2D, utilisée pour le traitement d'images.nn.MaxPool2d(kernel_size): couche de max pooling 2D, utilisée pour la réduction de dimensionnalité.nn.ReLU(): fonction d'activation ReLU, couramment utilisée dans les couches cachées.nn.Softmax(dim): fonction d'activation Softmax, généralement utilisée dans la couche de sortie, adaptée aux problèmes de classification multiclasse.
Fonction d'activation
Les fonctions d'activation déterminent si un neurone doit être activé. Ce sont des fonctions non linéaires qui permettent aux réseaux de neurones d'apprendre et d'effectuer des tâches plus complexes. Les fonctions d'activation courantes incluent :
- Sigmoid : utilisée pour les problèmes de classification binaire, avec des valeurs de sortie comprises entre 0 et 1.
- Tanh : les valeurs de sortie sont comprises entre -1 et 1, souvent utilisée avant la couche de sortie.
- ReLU (Rectified Linear Unit) : l'une des fonctions d'activation les plus populaires actuellement, définie comme
f(x) = max(0, x), ce qui aide à résoudre le problème de disparition du gradient. - Softmax : souvent utilisée dans la couche de sortie pour les problèmes de classification multiclasse ; convertit les sorties en une distribution de probabilités.
Exemple
# activation ReLU
output = F.relu(input_tensor)
# Activation sigmoïde
output = torch.sigmoid(input_tensor)
# Activation tanh
output = torch.tanh(input_tensor)
Fonction de perte
La fonction de perte est utilisée pour mesurer la différence entre les valeurs prédites du modèle et les valeurs réelles.
Les fonctions de perte courantes incluent :
- Erreur quadratique moyenne (MSELoss): Couramment utilisée pour les problèmes de régression ; calcule la différence au carré entre la sortie et la valeur cible.
- Perte d'entropie croisée (CrossEntropyLoss): Couramment utilisée pour les problèmes de classification ; calcule l'entropie croisée entre la sortie et les vraies étiquettes.
- BCEWithLogitsLoss: Pour les problèmes de classification binaire ; combine l'activation sigmoïde et la perte d'entropie croisée binaire.
Exemple
criterion = nn.MSELoss()
# Perte d'entropie croisée
criterion = nn.CrossEntropyLoss()
# Perte d'entropie croisée binaire
criterion = nn.BCEWithLogitsLoss()
Optimiseur
L'optimiseur est responsable de la mise à jour des poids et des biais du réseau pendant le processus d'entraînement.
Les optimiseurs courants incluent :
- SGD (descente de gradient stochastique)
- Adam (estimation adaptative des moments)
- RMSprop (propagation de la moyenne quadratique)
Exemple
# Utiliser l'optimiseur SGD
optimizer = optim.SGD(model.parameters(), lr=0.01)
# Utiliser l'optimiseur Adam
optimizer = optim.Adam(model.parameters(), lr=0.001)
Processus d'entraînement
L'entraînement d'un réseau de neurones implique les étapes suivantes :
- Préparer les données: en
DataLoaderchargeant les données. - Définir la fonction de perte et l'optimiseur。
- Propagation avant: calculer la sortie du modèle.
- Calculer la perte: comparer avec la cible pour obtenir la valeur de perte.
- Rétropropagation: en
loss.backward()calculant les gradients. - Mettre à jour les paramètres: en
optimizer.step()mettant à jour les paramètres du modèle. - Répéter les étapes ci-dessusjusqu'à ce que le nombre prédéterminé d'époques d'entraînement soit atteint.
Exemple
# Exemple de données d'entraînement
X = torch.randn(10, 2) # 10 échantillons, chacun avec 2 caractéristiques
Y = torch.randn(10, 1) # 10 étiquettes cibles
# Processus d'entraînement
for epoch in range(100): # Entraîner pendant 100 époques
model.train() # Mettre le modèle en mode entraînement
optimizer.zero_grad() # Effacer les gradients
output = model(X) # Propagation avant
loss = criterion(output, Y) # Calculer la perte
loss.backward() # Rétropropagation
optimizer.step() # Mettre à jour les poids
if (epoch + 1) % 10 == 0: # Afficher la perte toutes les 10 époques
print(f'Epoch [{epoch + 1}/100], Loss: {loss.item():.4f}')
Test et évaluation
Une fois l'entraînement terminé, le modèle doit être testé et évalué.
Les étapes courantes incluent :
- Calculer la perte sur l'ensemble de test: évaluer la performance du modèle sur des données non vues.
- Calculer l'exactitude: pour les problèmes de classification, calculer la proportion de prédictions correctes.
Exemple
model.eval() # Mettre le modèle en mode évaluation
with torch.no_grad(): # Désactiver le calcul du gradient pendant l'évaluation
output = model(X_test)
loss = criterion(output, Y_test)
print(f'Perte de test : {loss.item():.4f}')
Types de réseaux de neurones
- Réseaux de neurones à propagation avant: les données circulent dans une seule direction, de la couche d'entrée à la couche de sortie, sans connexions de rétroaction.
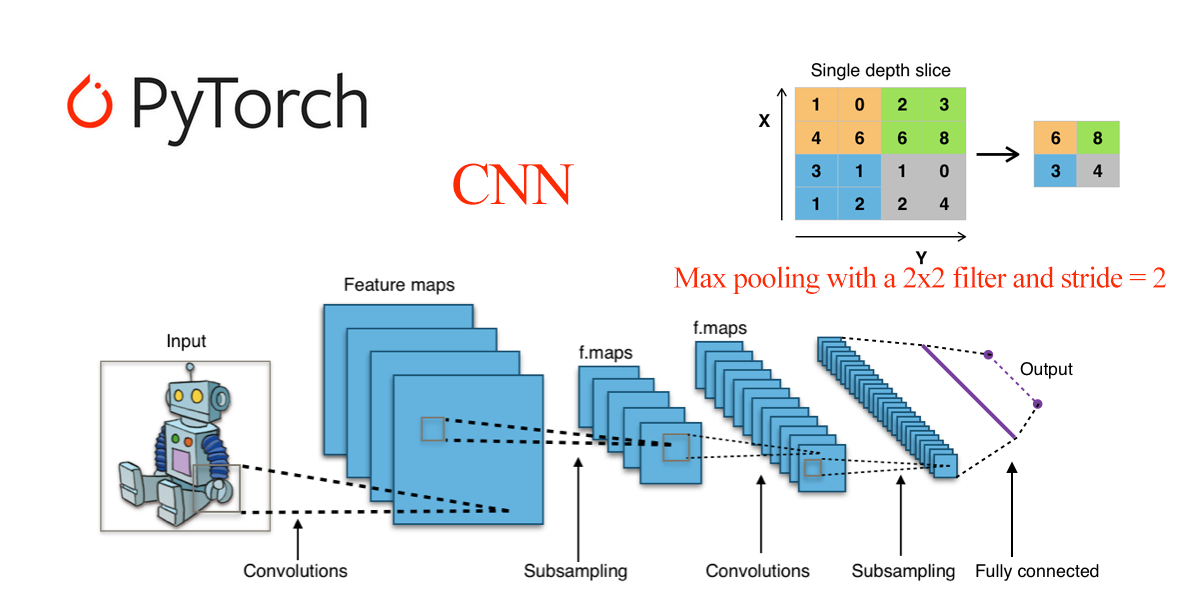
- Réseaux de neurones convolutifs (CNN): adaptés au traitement d'images, utilisant des couches de convolution pour extraire des caractéristiques spatiales.
- Réseaux de neurones récurrents (RNN): adaptés aux données séquentielles, telles que l'analyse de séries temporelles et le traitement du langage naturel, permettant des boucles de rétroaction de l'information.
- Long Short-Term Memory (LSTM): un type particulier de RNN capable d'apprendre des dépendances à long terme.
Référence torch.nn
Voici les plus couramment utilisés dans PyTorchtorch.nnfonctions et classes :
Bases de la définition de modèle
| Fonction | Description | Exemple |
|---|---|---|
| nn.Module | Classe de base pour tous les modules de réseaux de neurones | class Net(nn.Module): ... |
| nn.Sequential | Conteneur séquentiel qui exécute les couches dans l'ordre | nn.Sequential(conv, relu, pool) |
| nn.ModuleList | Stocke les sous-modules dans une liste | self.layers = nn.ModuleList([...]) |
| nn.Parameter | Crée un tenseur de paramètre apprenable | self.w = nn.Parameter(torch.randn(n)) |
Couches de convolution
| Fonction | Description | Exemple |
|---|---|---|
| nn.Conv1d | Convolution 1D (texte, audio) | nn.Conv1d(3, 64, 3) |
| nn.Conv2d | convolution 2D (image) | nn.Conv2d(3, 64, 3, padding=1) |
| nn.Conv3d | convolution 3D (vidéo) | nn.Conv3d(3, 64, 3) |
| nn.ConvTranspose2d | convolution transposée (décodeur, suréchantillonnage) | nn.ConvTranspose2d(64, 3, 2, stride=2) |
Couches de pooling
| Fonction | Description | Exemple |
|---|---|---|
| nn.MaxPool2d | pooling max 2D | nn.MaxPool2d(2, 2) |
| nn.AvgPool2d | pooling moyen 2D | nn.AvgPool2d(2, 2) |
| nn.AdaptiveAvgPool2d | pooling moyen adaptatif (taille de sortie fixe) | nn.AdaptiveAvgPool2d((1, 1)) |
| nn.AdaptiveMaxPool2d | Pooling max adaptatif (taille de sortie fixe) | nn.AdaptiveMaxPool2d((1, 1)) |
Couches linéaires
| Fonction | Description | Exemple |
|---|---|---|
| nn.Linear | Couche entièrement connectée (transformation linéaire) | nn.Linear(128, 64) |
| nn.Bilinear | Couche bilinéaire | nn.Bilinear(128, 64, 32) |
| Fonction | Description | Exemple |
| nn.ReLU | Fonction d'activation ReLU, f(x) = max(0, x) | nn.ReLU() |
| nn.GELU | Unité linéaire d'erreur gaussienne (par défaut dans les Transformers) | nn.GELU() |
| nn.SiLU | Fonction d'activation Swish | nn.SiLU() |
| nn.Tanh | Tangente hyperbolique | nn.Tanh() |
| nn.Sigmoid | Fonction d'activation sigmoïde | nn.Sigmoid() |
| nn.Softmax | Fonction d'activation Softmax | nn.Softmax(dim=1) |
| nn.LogSoftmax | Log Softmax (numériquement stable) | nn.LogSoftmax(dim=1) |
| nn.LeakyReLU | LeakyReLU, autorise de petits gradients pour les valeurs négatives | nn.LeakyReLU(0.01) |
| nn.ELU | Unité linéaire exponentielle | nn.ELU() |
Couches de normalisation
| Fonction | Description | Exemple |
|---|---|---|
| nn.BatchNorm2d | Normalisation par lots 2D (couramment utilisée dans les réseaux convolutifs) | nn.BatchNorm2d(64) |
| nn.LayerNorm | Normalisation de couche (couramment utilisée dans les Transformers) | nn.LayerNorm(512) |
| nn.GroupNorm | Normalisation de groupe (couramment utilisée dans ResNet, etc.) | nn.GroupNorm(4, 64) |
| nn.InstanceNorm2d | Normalisation d'instance (couramment utilisée dans le transfert de style) | nn.InstanceNorm2d(64) |
Couches récurrentes
| Fonction | Description | Exemple |
|---|---|---|
| nn.LSTM | Couche LSTM (mémoire à long terme et à court terme) | nn.LSTM(256, 512, 2) |
| nn.GRU | Couche GRU (unité récurrente à portes) | nn.GRU(256, 512, 2) |
| nn.RNN | Couche RNN simple | nn.RNN(256, 512, 2) |
Couches Transformer
| Fonction | Description | Exemple |
|---|---|---|
| nn.Transformer | Modèle Transformer complet | nn.Transformer(d_model=512, nhead=8) |
| nn.TransformerEncoder | Encodeur Transformer | nn.TransformerEncoder(layer, num_layers=6) |
| nn.TransformerDecoder | Décodeur Transformer | nn.TransformerDecoder(layer, num_layers=6) |
| nn.TransformerEncoderLayer | Couche d'encodeur Transformer | nn.TransformerEncoderLayer(512, 8) |
| nn.MultiheadAttention | Mécanisme d'attention multi-têtes | nn.MultiheadAttention(512, 8) |
Couches d'embedding
| Fonction | Description | Exemple |
|---|---|---|
| nn.Embedding | Couche d'embedding (associe le vocabulaire à des vecteurs) | nn.Embedding(10000, 256) |
| nn.EmbeddingBag | Embedding bag (agrège plusieurs embeddings) | nn.EmbeddingBag(10000, 256) |
Couches de dropout
| Fonction | Description | Exemple |
|---|---|---|
| nn.Dropout | Dropout aléatoire (prévient le surapprentissage) | nn.Dropout(0.5) |
| nn.Dropout2d | Dropout 2D (supprime des cartes de caractéristiques entières) | nn.Dropout2d(0.5) |
Fonctions de perte
| Fonction | Description | Exemple |
|---|---|---|
| nn.CrossEntropyLoss | Perte d'entropie croisée (classification multiclasse) | nn.CrossEntropyLoss() |
| nn.MSELoss | Perte d'erreur quadratique moyenne (régression) | nn.MSELoss() |
| nn.L1Loss | Perte L1 (MAE) | nn.L1Loss() |
| nn.BCEWithLogitsLoss | Entropie croisée binaire avec Sigmoid | nn.BCEWithLogitsLoss() |
| nn.HuberLoss | Perte de Huber (régression robuste) | nn.HuberLoss() |
| nn.NLLLoss | Perte de log-vraisemblance négative | nn.NLLLoss() |
Fonctions fonctionnelles (nn.functional)
| Fonction | Description | Exemple |
|---|---|---|
F.relu |
Activation ReLU | F.relu(x) |
F.gelu |
Activation GELU | F.gelu(x) |
F.sigmoid |
Activation sigmoïde | F.sigmoid(x) |
F.softmax |
Activation softmax | F.softmax(x, dim=1) |
F.dropout |
Opération de dropout | F.dropout(x, 0.5, training) |
F.conv2d |
Convolution 2D | F.conv2d(x, weight, bias) |
F.linear |
Transformation linéaire | F.linear(x, weight, bias) |
F.cross_entropy |
Perte d'entropie croisée | F.cross_entropy(logits, targets) |
F.mse_loss |
Perte d'erreur quadratique moyenne | F.mse_loss(pred, target) |
F.interpolate |
Interpolation (suréchantillonnage/sous-échantillonnage) | F.interpolate(x, scale_factor=2) |
F.embedding |
Opération d'embedding | F.embedding(indices, weight) |
Fonctions utilitaires (nn.init)
| Fonction | Description | Exemple |
|---|---|---|
nn.init.xavier_uniform_ |
Initialisation uniforme Xavier | nn.init.xavier_uniform_(module.weight) |
nn.init.xavier_normal_ |
Initialisation normale Xavier | nn.init.xavier_normal_(module.weight) |
nn.init.kaiming_uniform_ |
Initialisation uniforme Kaiming (adaptée à ReLU) | nn.init.kaiming_uniform_(module.weight) |
nn.init.kaiming_normal_ |
Initialisation normale Kaiming (adaptée à ReLU) | nn.init.kaiming_normal_(module.weight) |
nn.init.zeros_ |
Initialisation à zéro | nn.init.zeros_(module.bias) |
nn.init.normal_ |
Initialisation normale | nn.init.normal_(module.weight, 0, 0.01) |
Fonctions utilitaires (nn.utils)
| Fonction | Description | Exemple |
|---|---|---|
nn.utils.clip_grad_norm_ |
Écrêtage de la norme du gradient (évite l'explosion du gradient) | nn.utils.clip_grad_norm_(model.parameters(), 1.0) |
nn.utils.weight_norm |
Normalisation des poids | nn.utils.weight_norm(module, 'weight') |
nn.utils.spectral_norm |
Normalisation spectrale (couramment utilisée dans les GANs) | nn.utils.spectral_norm(module, 'weight') |
nn.utils.rnn.pack_padded_sequence |
Empaqueter des séquences de longueur variable | pack_padded_sequence(x, lengths) |
nn.utils.rnn.pad_packed_sequence |
Dépaqueter des séquences | pad_packed_sequence(packed) |