Réseau de neurones convolutif PyTorch
Le réseau de neurones convolutif PyTorch (CNN) est une classe de modèles d'apprentissage profond spécialement conçus pour traiter des données à topologie de type grille (comme les images).
CNN est une technologie essentielle pour les tâches de vision par ordinateur (telles que la classification d'images, la détection d'objets et la segmentation).
Le diagramme suivant montre la structure et le flux de travail d'un réseau de neurones convolutif (CNN) typique utilisé pour des tâches de reconnaissance d'images.
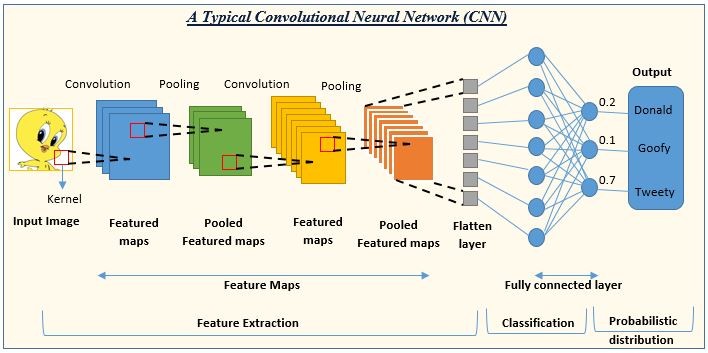
Dans la figure, la couche de sortie du CNN donne les probabilités pour trois classes : Donald (0.2), Goofy (0.1) et Tweety (0.7), ce qui indique que le réseau estime que l'image d'entrée est très probablement Tweety.
Voici une brève description de chaque partie :
-
Image d'entrée: les données d'image brutes reçues par le réseau.
-
Convolution: Un noyau glisse sur l'image d'entrée pour extraire des caractéristiques et générer des cartes de caractéristiques.
-
Pooling: Généralement appliqué après la couche convolutive, le max pooling ou l'average pooling réduit la taille des cartes de caractéristiques tout en préservant les caractéristiques importantes, produisant des cartes de caractéristiques après pooling.
-
Extraction de caractéristiques: La combinaison de plusieurs couches de convolution et de pooling extrait progressivement des caractéristiques de haut niveau à partir de l'image.
-
Couche d'aplatissement: Convertit les cartes de caractéristiques multidimensionnelles en un vecteur unidimensionnel pour l'entrée dans la couche entièrement connectée.
-
Couche entièrement connectée: Similaire aux couches traditionnelles des réseaux de neurones, elle mappe les caractéristiques extraites vers les classes de sortie.
-
Classification: La couche de sortie du réseau effectue la classification en fonction de la sortie de la couche entièrement connectée.
-
Distribution probabiliste: La couche de sortie donne la probabilité pour chaque classe, représentant la probabilité que l'image d'entrée appartienne à chaque classe.
Structure de base des réseaux de neurones convolutifs
1. Couche d'entrée
Il reçoit les données brutes de l'image. Une image est généralement représentée sous la forme d'un tableau tridimensionnel, où deux dimensions représentent la largeur et la hauteur de l'image, et la troisième dimension représente les canaux de couleur (par exemple, une image RGB a trois canaux).
2. Couche de convolution
Il utilise des noyaux de convolution pour extraire des caractéristiques locales, telles que les contours et les textures.
Formule :

- x : image d'entrée.
- k : noyau de convolution (matrice de poids).
- b : biais.
Un groupe de filtres apprenables (ou noyaux de convolution) est appliqué à l'image d'entrée via des opérations de convolution pour extraire des caractéristiques locales.
Chaque filtre glisse sur l'image d'entrée et génère une carte de caractéristiques, représentant l'activation du filtre à différentes positions.
Une couche de convolution peut avoir plusieurs filtres ; chaque filtre génère une carte de caractéristiques, et toutes les cartes de caractéristiques forment un ensemble de cartes de caractéristiques.
3. Fonction d'activation
Une fonction d'activation non linéaire, telle que ReLU (Rectified Linear Unit), est généralement appliquée après la couche de convolution pour introduire de la non-linéarité, permettant au réseau d'apprendre des motifs plus complexes.
La fonction ReLU est définie comme :f(x)=max(0,x), c'est-à-dire que si l'entrée est inférieure à 0, la sortie vaut 0 ; sinon, la sortie vaut la valeur d'entrée.
4. Couche de pooling
- Elle est utilisée pour réduire les dimensions spatiales des cartes de caractéristiques, diminuant ainsi le coût de calcul et le nombre de paramètres tout en conservant les informations sur les caractéristiques les plus importantes.
- Les opérations de pooling les plus courantes sont le pooling maximal et le pooling moyen.
- Le pooling maximal sélectionne la valeur maximale dans la région, tandis que le pooling moyen calcule la valeur moyenne dans la région.
5. Couche de normalisation (optionnelle)
- Par exemple, la normalisation de réponse locale (LRN) ou la normalisation par lots.
- Ces couches aident à accélérer le processus d'entraînement et à améliorer la stabilité du modèle.
6. Couche entièrement connectée
- À la fin d'un CNN, les cartes de caractéristiques extraites par les couches précédentes sont aplaties en un vecteur unidimensionnel, puis transmises à la couche entièrement connectée.
- Chaque neurone de la couche entièrement connectée est connecté à tous les neurones de la couche précédente, combinant les caractéristiques pour la classification ou la régression finale.
7. Couche de sortie
Selon la tâche, la couche de sortie peut prendre différentes formes.
Pour les tâches de classification, la fonction Softmax est généralement utilisée pour convertir la sortie en une distribution de probabilité, représentant la probabilité que l'entrée appartienne à chaque classe.
8. Fonction de perte
Elle sert à mesurer la différence entre les prédictions du modèle et les étiquettes réelles.
Les fonctions de perte courantes incluent la perte d'entropie croisée pour les tâches de classification multiclasse et l'erreur quadratique moyenne (MSE) pour les tâches de régression.
9. Optimiseur
Il est utilisé pour mettre à jour les poids du réseau en fonction du gradient de la fonction de perte. Les optimiseurs courants incluent la descente de gradient stochastique (SGD), Adam, RMSprop, etc.
10. Régularisation (facultative)
Il inclut des techniques telles que Dropout et la régularisation L1/L2 pour éviter le surapprentissage du modèle.
Ces couches peuvent être empilées pour former des structures de réseau plus profondes afin d'améliorer la capacité d'apprentissage du modèle.
La profondeur et la complexité d'un CNN peuvent être ajustées en fonction des exigences de la tâche.
Implémentation d'un exemple de CNN avec PyTorch
L'exemple suivant montre comment construire un modèle CNN simple avec PyTorch pour la classification de chiffres sur le jeu de données MNIST.
Étapes principales :
- Chargement et prétraitement des données: Utilisez
torchvisionchargez et prétraitez les données MNIST. - Construction du modèle: Définissez les couches convolutives, de pooling et entièrement connectées.
- Entraînement: Entraînez le modèle à l'aide d'une fonction de perte et d'un optimiseur.
- Évaluation: Calculez la précision du modèle sur l'ensemble de test.
- Visualisation: Afficher quelques échantillons de test et leurs résultats de prédiction.
1. Importer les bibliothèques requises
import torch
import torch.nn as nn
import torch.nn.functional as F
import torch.optim as optim
2. Chargement des données
Utilisez le jeu de données MNIST fourni par torchvision pour charger et prétraiter les données.
Exemple
transforms.ToTensor(), # Convertir en tenseur
transforms.Normalize((0.5,), (0.5,)) # Normaliser vers [-1, 1]
])
# Charger le jeu de données MNIST
train_dataset = datasets.MNIST(root='./data', train=True, transform=transform, download=True)
test_dataset = datasets.MNIST(root='./data', train=False, transform=transform, download=True)
train_loader = torch.utils.data.DataLoader(dataset=train_dataset, batch_size=64, shuffle=True)
test_loader = torch.utils.data.DataLoader(dataset=test_dataset, batch_size=64, shuffle=False)
3. Définir le modèle CNN
Utilisernn.Moduleconstruire un CNN.Exemple
def __init__(self):
super(SimpleCNN, self).__init__()
# Définir la couche de convolution : 1 canal d'entrée, 32 canaux de sortie, taille du noyau 3x3
self.conv1 = nn.Conv2d(1, 32, kernel_size=3, stride=1, padding=1)
# Définir la couche de convolution : 32 canaux d'entrée, 64 canaux de sortie
self.conv2 = nn.Conv2d(32, 64, kernel_size=3, stride=1, padding=1)
# Définir la couche entièrement connectée
self.fc1 = nn.Linear(64 * 7 * 7, 128) # Taille d'entrée = taille de la carte de caractéristiques * nombre de canaux
self.fc2 = nn.Linear(128, 10) # 10 classes
def forward(self, x):
x = F.relu(self.conv1(x)) # Première couche de convolution + ReLU
x = F.max_pool2d(x, 2) # Pooling maximal
x = F.relu(self.conv2(x)) # Deuxième couche de convolution + ReLU
x = F.max_pool2d(x, 2) # Pooling maximal
x = x.view(-1, 64 * 7 * 7) # Opération d'aplatissement
x = F.relu(self.fc1(x)) # Couche entièrement connectée + ReLU
x = self.fc2(x) # Sortie de la couche entièrement connectée
return x
# Créer une instance du modèle
model = SimpleCNN()
4. Définir la fonction de perte et l'optimiseur
Utiliser la perte d'entropie croisée et l'optimiseur de descente de gradient stochastique.
criterion = nn.CrossEntropyLoss()  # 多分类交叉熵损失
optimizer = optim.SGD(model.parameters(), lr=0.01, momentum=0.9)  # 学习率和动量
5. Entraîner le modèle
Entraîner le modèle pendant 5 époques et afficher la perte d'entraînement après chaque époque.
Exemple
model.train() # Passer en mode entraînement
for epoch in range(num_epochs):
total_loss = 0
for images, labels in train_loader:
# Passe avant
outputs = model(images)
loss = criterion(outputs, labels)
# Rétropropagation
optimizer.zero_grad()
loss.backward()
optimizer.step()
total_loss += loss.item()
print(f"Époque [{epoch+1}/{num_epochs}], Perte : {total_loss / len(train_loader):.4f}")
6. Tester le modèle
Évaluer la précision du modèle sur l'ensemble de test.
Exemple
correct = 0
total = 0
with torch.no_grad(): # Aucun calcul de gradient nécessaire pendant l'évaluation
for images, labels in test_loader:
outputs = model(images)
_, predicted = torch.max(outputs, 1) # Prédire les classes
total += labels.size(0)
correct += (predicted == labels).sum().item()
accuracy = 100 * correct / total
print(f"Précision du test : {accuracy:.2f}%")
7. Code complet
Le code complet est le suivant :
Exemple
import torch.nn as nn
import torch.nn.functional as F
import torch.optim as optim
from torchvision import datasets, transforms
# 1. Chargement et prétraitement des données
transform = transforms.Compose([
transforms.ToTensor(), # Convertir en tenseur
transforms.Normalize((0.5,), (0.5,)) # Normaliser vers [-1, 1]
])
# Charger le jeu de données MNIST
train_dataset = datasets.MNIST(root='./data', train=True, transform=transform, download=True)
test_dataset = datasets.MNIST(root='./data', train=False, transform=transform, download=True)
train_loader = torch.utils.data.DataLoader(dataset=train_dataset, batch_size=64, shuffle=True)
test_loader = torch.utils.data.DataLoader(dataset=test_dataset, batch_size=64, shuffle=False)
# 2. Définir le modèle CNN
class SimpleCNN(nn.Module):
def __init__(self):
super(SimpleCNN, self).__init__()
# Définir les couches convolutives
self.conv1 = nn.Conv2d(1, 32, kernel_size=3, stride=1, padding=1) # Entrée 1 canal, sortie 32 canaux
self.conv2 = nn.Conv2d(32, 64, kernel_size=3, stride=1, padding=1) # Entrée 32 canaux, sortie 64 canaux
# Définir les couches entièrement connectées
self.fc1 = nn.Linear(64 * 7 * 7, 128) # Aplatir et alimenter la couche entièrement connectée
self.fc2 = nn.Linear(128, 10) # 10 classes
def forward(self, x):
x = F.relu(self.conv1(x)) # Première convolution + ReLU
x = F.max_pool2d(x, 2) # Pooling maximal
x = F.relu(self.conv2(x)) # Deuxième convolution + ReLU
x = F.max_pool2d(x, 2) # Pooling maximal
x = x.view(-1, 64 * 7 * 7) # Aplatir
x = F.relu(self.fc1(x)) # Couche entièrement connectée + ReLU
x = self.fc2(x) # Couche de sortie finale
return x
# Créer une instance du modèle
model = SimpleCNN()
# 3. Définir la fonction de perte et l'optimiseur
criterion = nn.CrossEntropyLoss() # Perte d'entropie croisée multiclasse
optimizer = optim.SGD(model.parameters(), lr=0.01, momentum=0.9)
# 4. Entraînement du modèle
num_epochs = 5
model.train() # Passer le modèle en mode entraînement
for epoch in range(num_epochs):
total_loss = 0
for images, labels in train_loader:
outputs = model(images) # Passe avant
loss = criterion(outputs, labels) # Calculer la perte
optimizer.zero_grad() # Effacer les gradients
loss.backward() # Rétropropagation
optimizer.step() # Mettre à jour les paramètres
total_loss += loss.item()
print(f"Époque [{epoch+1}/{num_epochs}], Perte : {total_loss / len(train_loader):.4f}")
# 5. Test du modèle
model.eval() # Passer le modèle en mode évaluation
correct = 0
total = 0
with torch.no_grad(): # Désactiver le calcul des gradients
for images, labels in test_loader:
outputs = model(images)
_, predicted = torch.max(outputs, 1)
total += labels.size(0)
correct += (predicted == labels).sum().item()
accuracy = 100 * correct / total
print(f"Précision du test : {accuracy:.2f}%")
Explication des résultats d'exécution
1. Perte d'entraînement en sortie
Le code affiche une perte moyenne après chaque époque, par exemple :
Epoch [1/5], Loss: 0.2325
Epoch [2/5], Loss: 0.0526
Epoch [3/5], Loss: 0.0366
Epoch [4/5], Loss: 0.0273
Epoch [5/5], Loss: 0.0221
Explication :La diminution progressive de la perte indique que le modèle converge étape par étape.
2. Exactitude sur l'ensemble de test
Le code affiche l'exactitude de classification finale sur l'ensemble de test, par exemple :
Test Accuracy: 98.96%
Explication :Le modèle atteint une exactitude de classification de 98.96% sur l'ensemble de test MNIST, ce qui est un bon résultat pour un modèle CNN simple.
7. Visualiser les résultats
Nous pouvons visualiser quelques échantillons et leurs résultats de prédiction dans les données de test.
Exemple
import torch.nn as nn
import torch.nn.functional as F
import torch.optim as optim
from torchvision import datasets, transforms
import matplotlib.pyplot as plt
# 1. Chargement et prétraitement des données
transform = transforms.Compose([
transforms.ToTensor(), # Convertir en tenseur
transforms.Normalize((0.5,), (0.5,)) # Normaliser vers [-1, 1]
])
# Charger le jeu de données MNIST
train_dataset = datasets.MNIST(root='./data', train=True, transform=transform, download=True)
test_dataset = datasets.MNIST(root='./data', train=False, transform=transform, download=True)
train_loader = torch.utils.data.DataLoader(dataset=train_dataset, batch_size=64, shuffle=True)
test_loader = torch.utils.data.DataLoader(dataset=test_dataset, batch_size=64, shuffle=False)
# 2. Définir le modèle CNN
class SimpleCNN(nn.Module):
def __init__(self):
super(SimpleCNN, self).__init__()
# Définir les couches convolutives
self.conv1 = nn.Conv2d(1, 32, kernel_size=3, stride=1, padding=1) # Entrée 1 canal, sortie 32 canaux
self.conv2 = nn.Conv2d(32, 64, kernel_size=3, stride=1, padding=1) # Entrée 32 canaux, sortie 64 canaux
# Définir les couches entièrement connectées
self.fc1 = nn.Linear(64 * 7 * 7, 128) # Aplatir et alimenter la couche entièrement connectée
self.fc2 = nn.Linear(128, 10) # 10 classes
def forward(self, x):
x = F.relu(self.conv1(x)) # Première convolution + ReLU
x = F.max_pool2d(x, 2) # Pooling maximal
x = F.relu(self.conv2(x)) # Deuxième convolution + ReLU
x = F.max_pool2d(x, 2) # Pooling maximal
x = x.view(-1, 64 * 7 * 7) # Aplatir
x = F.relu(self.fc1(x)) # Couche entièrement connectée + ReLU
x = self.fc2(x) # Couche de sortie finale
return x
# Créer une instance du modèle
model = SimpleCNN()
# 3. Définir la fonction de perte et l'optimiseur
criterion = nn.CrossEntropyLoss() # Perte d'entropie croisée multiclasse
optimizer = optim.SGD(model.parameters(), lr=0.01, momentum=0.9)
# 4. Entraînement du modèle
num_epochs = 5
model.train() # Passer le modèle en mode entraînement
for epoch in range(num_epochs):
total_loss = 0
for images, labels in train_loader:
outputs = model(images) # Passe avant
loss = criterion(outputs, labels) # Calculer la perte
optimizer.zero_grad() # Effacer les gradients
loss.backward() # Rétropropagation
optimizer.step() # Mettre à jour les paramètres
total_loss += loss.item()
print(f"Époque [{epoch+1}/{num_epochs}], Perte : {total_loss / len(train_loader):.4f}")
# 5. Test du modèle
model.eval() # Passer le modèle en mode évaluation
correct = 0
total = 0
with torch.no_grad(): # Désactiver le calcul des gradients
for images, labels in test_loader:
outputs = model(images)
_, predicted = torch.max(outputs, 1)
total += labels.size(0)
correct += (predicted == labels).sum().item()
accuracy = 100 * correct / total
print(f"Précision du test : {accuracy:.2f}%")
# 6. Visualiser les résultats de test
dataiter = iter(test_loader)
images, labels = next(dataiter)
outputs = model(images)
_, predictions = torch.max(outputs, 1)
fig, axes = plt.subplots(1, 6, figsize=(12, 4))
for i in range(6):
axes[i].imshow(images[i][0], cmap='gray')
axes[i].set_title(f"Étiquette : {labels[i]}\nPréd : {predictions[i]}")
axes[i].axis('off')
plt.show()
Les résultats de visualisation montrent les étiquettes réelles et les valeurs prédites de 6 échantillons de test, par exemple :

Le coin supérieur gauche de l'image est le chiffre manuscrit.
La section du titre affiche la valeur prédite du modèle et l'étiquette réelle.
Remarque : quelques erreurs courantes
Lors du téléchargement du jeu de données MNIST, le téléchargement échoue en raison d'un échec de vérification du certificat SSL.
Downloading http://yann.lecun.com/exdb/mnist/train-images-idx3-ubyte.gz
Failed to download (trying next):
<urlopen error [SSL: CERTIFICATE_VERIFY_FAILED] certificate verify failed: unable to get local issuer certificate (_ssl.c:1129)>
...
Solutions
Ouvrez un terminal et exécutez la commande suivante pour installer/mettre à jour le certificat SSL :
/Applications/Python\ 3.x/Install\ Certificates.command
Remplacez 3.x par la version de Python que vous avez réellement installée.
Après avoir exécuté cette commande, relancez votre code Python et il devrait pouvoir télécharger le jeu de données MNIST avec succès.
Autres extensions