Fichiers CSV Pandas
CSV (Comma-Separated Values, parfois aussi appelé character-separated values car le caractère séparateur ne doit pas nécessairement être une virgule) stocke des données tabulaires (nombres et texte) dans des fichiers en texte brut.
CSV est un format de fichier courant, relativement simple, largement utilisé par les utilisateurs, les entreprises et le monde scientifique.
Pandas peut gérer très facilement les fichiers CSV. Les méthodes courantes incluent :
| Nom de la méthode | Description | Paramètres courants |
|---|---|---|
pd.read_csv() | Lire des données à partir d’un fichier CSV et les charger en tant que DataFrame | filepath_or_buffer(chemin ou objet fichier),sep(séparateur),header(en-tête),names(noms de colonnes personnalisés),dtype(types de données),index_col(colonne d’index) |
DataFrame.to_csv() | Écrire un DataFrame dans un fichier CSV | path_or_buffer(chemin cible ou objet fichier),sep(séparateur),index(s'il faut écrire l'index),columns(colonnes spécifiées),header(s'il faut écrire les noms de colonnes),mode(mode d'écriture) |
Cet article utilisenba.csvcomme exemple. Vous pouveztélécharger nba.csvououvrir nba.csvpour voir.
pd.read_csv() - Lire les fichiers CSV
read_csv() est la méthode principale pour lire les données d'un fichier CSV, en chargeant les données dans un DataFrame.
import pandas as pd

# 读取 CSV 文件,并自定义列名和分隔符
df = pd.read_csv('data.csv', sep=';', header=0, names=['A', 'B', 'C'], dtype={'A': int, 'B': float})
print(df)
Paramètres courants de read_csv :
| Paramètre | Description | Valeur par défaut |
|---|---|---|
filepath_or_buffer | Le chemin vers le fichier CSV ou un objet fichier (prend en charge URL, chemin de fichier, objet fichier, etc.) | Paramètre obligatoire |
sep | Définit le séparateur de champs. La valeur par défaut est une virgule (,), qui peut être remplacé par d'autres caractères, comme une tabulation (\t) | ',' |
header | Spécifiez le numéro de ligne à utiliser comme en-tête de colonne. La valeur par défaut est 0 (ce qui signifie la première ligne), ou définissez-le surNoneaucun en-tête | 0 |
names | Noms de colonnes personnalisés. Passez une liste de noms de colonnes. | None |
index_col | Le numéro ou le nom de la colonne utilisée comme index de lignes. | None |
usecols | Lisez les colonnes spécifiées. Il peut s'agir de noms de colonnes ou d'indices de colonnes. | None |
dtype | Forcez la conversion des colonnes vers les types de données spécifiés. | None |
skiprows | Ignorez un nombre spécifié de lignes au début du fichier, ou passez une liste de numéros de ligne. | None |
nrows | Lisez les N premières lignes de données. | None |
na_values | Spécifiez les valeurs qui doivent être traitées comme des valeurs manquantes (NaN). | None |
skipfooter | Ignorez un nombre spécifié de lignes à la fin du fichier. | 0 |
encoding | Le format d'encodage du fichier (tel queutf-8,latin1etc.) | None |
Lire les données du fichier nba.csv :
Exemple
df = .read_csv('nba.csv')
print(df.to_string())
to_string()Utilisé pour renvoyer des données de type DataFrame. Si cette fonction n'est pas utilisée, le résultat de sortie correspond aux 5 premières lignes et aux 5 dernières lignes du fichier, la partie intermédiaire étant remplacée par...à la place.
Exemple
df = .read_csv('nba.csv')
print(df)
              Name            Team  Number Position   Age Height  Weight            College     Salary
0    Avery Bradley  Boston Celtics     0.0       PG  25.0    6-2   180.0              Texas  7730337.0
1      Jae Crowder  Boston Celtics    99.0       SF  25.0    6-6   235.0          Marquette  6796117.0
2     John Holland  Boston Celtics    30.0       SG  27.0    6-5   205.0  Boston University        NaN
3      R.J. Hunter  Boston Celtics    28.0       SG  22.0    6-5   185.0      Georgia State  1148640.0
4    Jonas Jerebko  Boston Celtics     8.0       PF  29.0   6-10   231.0                NaN  5000000.0
..             ...             ...     ...      ...   ...    ...     ...                ...        ...
453   Shelvin Mack       Utah Jazz     8.0       PG  26.0    6-3   203.0             Butler  2433333.0
454      Raul Neto       Utah Jazz    25.0       PG  24.0    6-1   179.0                NaN   900000.0
455   Tibor Pleiss       Utah Jazz    21.0        C  26.0    7-3   256.0                NaN  2900000.0
456    Jeff Withey       Utah Jazz    24.0        C  26.0    7-0   231.0             Kansas   947276.0
457            NaN             NaN     NaN      NaN   NaN    NaN     NaN                NaN        NaN
df.to_csv() - Écrire un DataFrame dans un fichier CSV
to_csv() est une méthode pour écrire un DataFrame dans un fichier CSV. Elle prend en charge des paramètres tels que des délimiteurs personnalisés, les noms de colonnes et l'inclusion ou non de l'index.
import pandas as pd

# 假设 df 是一个已有的 DataFrame
df.to_csv('output.csv', index=False, header=True, columns=['A', 'B'])
Paramètres courants de to_csv :
| Paramètre | Description | Valeur par défaut |
|---|---|---|
path_or_buffer | Le chemin vers le fichier CSV ou un objet fichier (prend en charge les chemins de fichiers et les objets fichiers) | Paramètre obligatoire |
sep | Définit le séparateur de champs. La valeur par défaut est une virgule (,), qui peut être remplacé par d'autres caractères, comme une tabulation (\t) | ',' |
index | Indique s'il faut écrire l'index de ligne. La valeur par défaut estTruece qui signifie que l'index est écrit. | True |
columns | Spécifiez les colonnes à écrire. Peut être une liste de noms de colonnes. | None |
header | Indique s'il faut écrire les noms de colonnes. La valeur par défaut estTruesignifie que les noms de colonnes sont écrits. Défini àFalsesignifie que les noms de colonnes ne sont pas écrits. | True |
mode | Le mode d'écriture du fichier. La valeur par défaut estw(mode écriture), peut être défini àa(mode ajout) | 'w' |
encoding | Le format d'encodage du fichier, tel queutf-8,latin1wait | None |
line_terminator | Définit le terminateur de ligne. La valeur par défaut est\n | None |
quoting | Définit comment citer les données dans le fichier (0-3 ; voir la documentation pour les méthodes de citation spécifiques.) | None |
quotechar | Définit le caractère utilisé pour citer. La valeur par défaut est le guillemet double." | '"' |
date_format | Format de date personnalisé. Si une colonne contient des données de date, vous pouvez utiliser ce paramètre pour spécifier le format de date. | None |
doublequote | Si défini surTrue, puis lors de l'écriture, le texte contenant des guillemets sera entouré de guillemets doubles. | True |
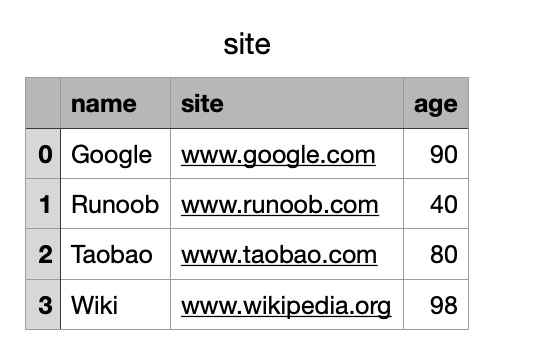
Nous pouvons également utiliser la méthodeto_csv()pour stocker le DataFrame dans un fichier CSV :
Exemple
# Trois champs : name, site, age
nme = ["Google", "Example", "Taobao", "Wiki"]
st = ["www.google.com", "www.example.com", "www.taobao.com", "www.wikipedia.org"]
ag = [90, 40, 80, 98]
# Dictionnaire
dict = {'name': nme, 'site': st, 'age': ag}
df = pd.DataFrame(dict)
# Enregistrer le dataframe
df.to_csv('site.csv')
Après une exécution réussie, nous ouvrons le fichier site.csv et le résultat s'affiche comme suit :
Traitement des données
head()
head( n )Méthode utilisée pour lire les n premières lignes. Si le paramètre n n'est pas fourni, elle renvoie 5 lignes par défaut.
Exemple - Lire les 5 premières lignes
df = .read_csv('nba.csv')
print(df.head())
Le résultat de sortie est:
            Name            Team  Number Position   Age Height  Weight            College     Salary
0  Avery Bradley  Boston Celtics     0.0       PG  25.0    6-2   180.0              Texas  7730337.0
1    Jae Crowder  Boston Celtics    99.0       SF  25.0    6-6   235.0          Marquette  6796117.0
2   John Holland  Boston Celtics    30.0       SG  27.0    6-5   205.0  Boston University        NaN
3    R.J. Hunter  Boston Celtics    28.0       SG  22.0    6-5   185.0      Georgia State  1148640.0
4  Jonas Jerebko  Boston Celtics     8.0       PF  29.0   6-10   231.0                NaN  5000000.0
Exemple - Lire les 10 premières lignes
df = .read_csv('nba.csv')
print(df.head(10))
Le résultat de sortie est:
            Name            Team  Number Position   Age Height  Weight            College      Salary
0  Avery Bradley  Boston Celtics     0.0       PG  25.0    6-2   180.0              Texas   7730337.0
1    Jae Crowder  Boston Celtics    99.0       SF  25.0    6-6   235.0          Marquette   6796117.0
2   John Holland  Boston Celtics    30.0       SG  27.0    6-5   205.0  Boston University         NaN
3    R.J. Hunter  Boston Celtics    28.0       SG  22.0    6-5   185.0      Georgia State   1148640.0
4  Jonas Jerebko  Boston Celtics     8.0       PF  29.0   6-10   231.0                NaN   5000000.0
5   Amir Johnson  Boston Celtics    90.0       PF  29.0    6-9   240.0                NaN  12000000.0
6  Jordan Mickey  Boston Celtics    55.0       PF  21.0    6-8   235.0                LSU   1170960.0
7   Kelly Olynyk  Boston Celtics    41.0        C  25.0    7-0   238.0            Gonzaga   2165160.0
8   Terry Rozier  Boston Celtics    12.0       PG  22.0    6-2   190.0         Louisville   1824360.0
9   Marcus Smart  Boston Celtics    36.0       PG  22.0    6-4   220.0     Oklahoma State   3431040.0
tail()
tail( n )Méthode utilisée pour lire les n dernières lignes. Si le paramètre n n'est pas fourni, elle renvoie 5 lignes par défaut. Pour les lignes vides, les valeurs de chaque champ renvoientNaN。
Exemple - Lire les 5 dernières lignes
df = .read_csv('nba.csv')
print(df.tail())
Le résultat de sortie est:
             Name       Team  Number Position   Age Height  Weight College     Salary
453  Shelvin Mack  Utah Jazz     8.0       PG  26.0    6-3   203.0  Butler  2433333.0
454     Raul Neto  Utah Jazz    25.0       PG  24.0    6-1   179.0     NaN   900000.0
455  Tibor Pleiss  Utah Jazz    21.0        C  26.0    7-3   256.0     NaN  2900000.0
456   Jeff Withey  Utah Jazz    24.0        C  26.0    7-0   231.0  Kansas   947276.0
457           NaN        NaN     NaN      NaN   NaN    NaN     NaN     NaN        NaN
Exemple - Lire les 10 dernières lignes
df = .read_csv('nba.csv')
print(df.tail(10))
Le résultat de sortie est:
               Name       Team  Number Position   Age Height  Weight   College      Salary
448  Gordon Hayward  Utah Jazz    20.0       SF  26.0    6-8   226.0    Butler  15409570.0
449     Rodney Hood  Utah Jazz     5.0       SG  23.0    6-8   206.0      Duke   1348440.0
450      Joe Ingles  Utah Jazz     2.0       SF  28.0    6-8   226.0       NaN   2050000.0
451   Chris Johnson  Utah Jazz    23.0       SF  26.0    6-6   206.0    Dayton    981348.0
452      Trey Lyles  Utah Jazz    41.0       PF  20.0   6-10   234.0  Kentucky   2239800.0
453    Shelvin Mack  Utah Jazz     8.0       PG  26.0    6-3   203.0    Butler   2433333.0
454       Raul Neto  Utah Jazz    25.0       PG  24.0    6-1   179.0       NaN    900000.0
455    Tibor Pleiss  Utah Jazz    21.0        C  26.0    7-3   256.0       NaN   2900000.0
456     Jeff Withey  Utah Jazz    24.0        C  26.0    7-0   231.0    Kansas    947276.0
457             NaN        NaN     NaN      NaN   NaN    NaN     NaN       NaN         NaN
info()
La méthode info() renvoie quelques informations de base sur la table :
Exemple
df = .read_csv('nba.csv')
print(df.info())
Le résultat de sortie est:
<class 'pandas.core.frame.DataFrame'>
RangeIndex: 458 entries, 0 to 457          # 行数,458 行,第一行编号为 0
Data columns (total 9 columns):            # 列数,9列
 #   Column    Non-Null Count  Dtype       # 各列的数据类型
---  ------    --------------  -----
 0   Name      457 non-null    object
 1   Team      457 non-null    object
 2   Number    457 non-null    float64
 3   Position  457 non-null    object
 4   Age       457 non-null    float64
 5   Height    457 non-null    object
 6   Weight    457 non-null    float64
 7   College   373 non-null    object         # non-null,意思为非空的数据
 8   Salary    446 non-null    float64
dtypes: float64(4), object(5)                 # 类型
non-null signifie des données non vides. Nous pouvons voir d'après les informations ci-dessus qu'il y a 458 lignes au total, et que le champ College possède le plus grand nombre de valeurs nulles.
Autres extensions