Structures de données Pandas - DataFrame
DataFrame est une autre structure de données centrale dans Pandas, semblable à une table bidimensionnelle ou à une table de données dans une base de données.
DataFrame est une structure de données tabulaire qui contient un ensemble de colonnes ordonnées, chacune pouvant avoir différents types de valeurs (numériques, chaînes de caractères, booléennes).
DataFrame possède à la fois des index de lignes et des index de colonnes ; il peut être vu comme un dictionnaire composé de Series (partageant un index commun).
DataFrame fournit diverses fonctions pour l'accès aux données, le filtrage, la division, la fusion, la restructuration, l'agrégation et les opérations de transformation.
DataFrame est une structure de données très flexible et puissante, largement utilisée pour des tâches telles que l'analyse, le nettoyage, la transformation et la visualisation des données.
Caractéristiques de DataFrame :
Structure bidimensionnelle :
DataFrameIl s'agit d'un tableau bidimensionnel qui peut être vu comme une feuille de calcul Excel ou une table SQL, avec des lignes et des colonnes. Il peut être considéré comme plusieursSeriesobjets assemblés en un dictionnaire.Types de données des colonnes :Différentes colonnes peuvent contenir différents types de données, tels que des entiers, des nombres à virgule flottante, des chaînes de caractères ou des objets Python.
-
Index:
DataFramePeut avoir des index de lignes et des index de colonnes, semblables aux numéros de ligne et aux libellés de colonne dans Excel. -
Taille variable: Il est possible d'ajouter et de supprimer des colonnes, comme dans un dictionnaire en Python.
-
Alignement automatique: Lors de l'exécution d'opérations arithmétiques ou d'opérations d'alignement de données,
DataFrameles index seront automatiquement alignés. -
Gestion des données manquantes:
DataFramePeut contenir des données manquantes, Pandas utiliseNaN(Not a Number) pour les représenter. -
Opérations sur les données: Prend en charge des opérations telles que le découpage des données, l'indexation et la division en sous-ensembles.
-
Prise en charge des séries temporelles:
DataFrameDispose d'une prise en charge spéciale des données de séries temporelles, permettant un découpage, une indexation et une manipulation faciles des données temporelles. -
Fonctionnalités riches d'accès aux données: Grâce à la
.loc、.ilocet.query()méthode, vous pouvez accéder et filtrer les données de manière flexible. -
Fonctionnalités flexibles de traitement des données: Y compris la fusion des données, la restructuration, le pivotage, le regroupement et l'agrégation.
-
Visualisation des données: Bien que
DataFramelui-même ne soit pas un outil de visualisation, il peut être combiné avec des bibliothèques de visualisation telles que Matplotlib ou Seaborn pour effectuer de la visualisation de données. -
Entrées/Sorties de données efficaces: Permet de lire et d'écrire des données de manière pratique, en prenant en charge plusieurs formats tels que CSV, Excel, les bases de données SQL et HDF5.
-
Statistiques descriptives: Fournit une série de méthodes pour calculer des statistiques descriptives, telles que
.describe()、.mean()、.sum()etc. -
Alignement et intégration flexibles des données: Peut facilement être combiné avec d'autres
DataFrameouSeriesobjets pour effectuer des opérations de fusion, de jointure ou de mise à jour. -
Fonctionnalité de transformation: Peut transformer les valeurs du jeu de données, par exemple en utilisant la
.apply()méthode pour appliquer des fonctions personnalisées. -
Fenêtre glissante et analyse de séries temporelles: Prend en charge les statistiques à fenêtre glissante et l'analyse de séries temporelles sur les jeux de données.
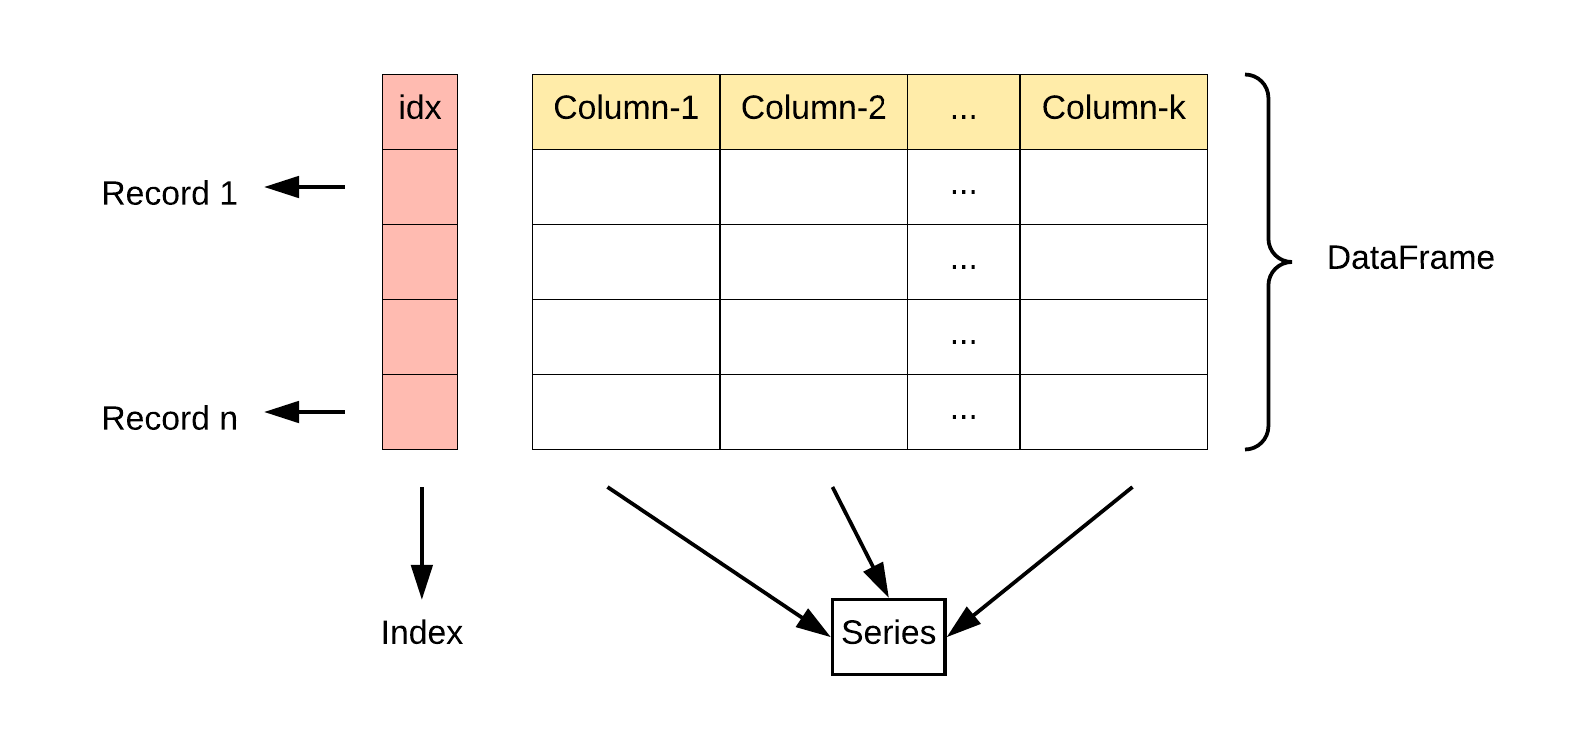

Le constructeur DataFrame est le suivant :
pandas.DataFrame(data=None, index=None, columns=None, dtype=None, copy=False)
Description du paramètre :
data: La partie données du DataFrame, qui peut être un dictionnaire, un tableau bidimensionnel, une Series, un DataFrame ou tout autre objet pouvant être converti en DataFrame. Si ce paramètre n'est pas fourni, un DataFrame vide est créé.index: L'index des lignes du DataFrame, utilisé pour identifier chaque ligne de données. Il peut être une liste, un tableau, un objet index, etc. Si ce paramètre n'est pas fourni, un index d'entiers par défaut est créé.columns: L'index des colonnes du DataFrame, utilisé pour identifier chaque colonne de données. Il peut être une liste, un tableau, un objet index, etc. Si ce paramètre n'est pas fourni, un index d'entiers par défaut est créé.dtype: Spécifie le type de données du DataFrame. Il peut s'agir d'un type de données NumPy, tel quenp.int64、np.float64etc. Si ce paramètre n'est pas fourni, le type de données est déduit automatiquement en fonction des données.copy: Indique s'il faut copier les données. La valeur par défaut est False, ce qui signifie que les données ne sont pas copiées. Si la valeur est True, les données d'entrée sont copiées.
Pandas DataFrame est une structure de tableau bidimensionnel, similaire à un tableau bidimensionnel.
Exemple - Création à l'aide d'une liste
data = [['Google', 10], ['Example', 12], ['Wiki', 13]]
# Créer un DataFrame
df = pd.DataFrame(data, columns=['Site', 'Age'])
# Utilisez la méthode astype pour définir le type de données de chaque colonne
df['Site'] = df['Site'].astype(str)
df['Age'] = df['Age'].astype(float)
print(df)
Vous pouvez également utiliser un dictionnaire pour en créer un :
Exemple - Création à l'aide d'un dictionnaire
data = {'Site':['Google', 'Example', 'Wiki'], 'Age':[10, 12, 13]}
df = pd.DataFrame(data)
print (df)
Le résultat de sortie est le suivant :

L'exemple suivant utilise des ndarrays pour créer. Les longueurs des ndarrays doivent être identiques. Si un index est passé, la longueur de l'index doit être égale à la longueur des tableaux. Si aucun index n'est passé, par défaut l'index sera range(n), où n est la longueur des tableaux.
Pour les ndarrays, vous pouvez vous référer à :Objet ndarray de NumPy
Exemple - Création à l'aide de ndarrays
import pandas as pd
# Créer un ndarray bidimensionnel contenant le site web et l'âge
ndarray_data = np.array([
['Google', 10],
['Example', 12],
['Wiki', 13]
])
# Utiliser le constructeur DataFrame pour créer un DataFrame
df = pd.DataFrame(ndarray_data, columns=['Site', 'Age'])
# Afficher le DataFrame
print(df)
Le résultat de sortie est le suivant :
À partir de la sortie ci-dessus, nous pouvons voir que le type de données DataFrame est une table, contenant des lignes et des colonnes :

Vous pouvez également utiliser un dictionnaire (clé/valeur), où les clés du dictionnaire sont les noms des colonnes :
Exemple - Création à l'aide d'un dictionnaire
data = [{'a': 1, 'b': 2},{'a': 5, 'b': 10, 'c': 20}]
df = pd.DataFrame(data)
print (df)
Le résultat de sortie est:
   a   b     c
0  1   2   NaN
1  5  10  20.0
La partie sans données correspondantes estNaN。
Pandas peut utiliser l'attributlocpour renvoyer les données d'une ligne spécifiée. Si aucun index n'est défini, l'index de la première ligne est0, l'index de la deuxième ligne est1, et ainsi de suite :
Exemple
data = {
"calories": [420, 380, 390],
"duration": [50, 40, 45]
}
# Charger les données dans un objet DataFrame
df = pd.DataFrame(data)
# Retourner la première ligne
print(df.loc[0])
# Retourner la deuxième ligne
print(df.loc[1])
Le résultat de sortie est le suivant :
calories    420
duration     50
Name: 0, dtype: int64
calories    380
duration     40
Name: 1, dtype: int64
Remarque :Le résultat retourné est en fait une donnée Pandas Series.
Vous pouvez également retourner plusieurs lignes de données, en utilisant le[[ ... ]]format, où...sont les index de chaque ligne, séparés par des virgules :
Exemple
data = {
"calories": [420, 380, 390],
"duration": [50, 40, 45]
}
# Charger les données dans un objet DataFrame
df = pd.DataFrame(data)
# Retourner les première et deuxième lignes
print(df.loc[[0, 1]])
Le résultat de sortie est:
   calories  duration
0       420        50
1       380        40
Remarque :Le résultat retourné est en fait une donnée Pandas DataFrame.
Nous pouvons spécifier les valeurs d'index, comme dans l'exemple suivant :
Exemple
data = {
"calories": [420, 380, 390],
"duration": [50, 40, 45]
}
df = pd.DataFrame(data, index = ["day1", "day2", "day3"])
print(df)
Le résultat de sortie est:
      calories  duration
day1       420        50
day2       380        40
day3       390        45
Pandas peut utiliser l'attributlocpour renvoyer la ligne correspondant à l'index spécifié :
Exemple
data = {
"calories": [420, 380, 390],
"duration": [50, 40, 45]
}
df = pd.DataFrame(data, index = ["day1", "day2", "day3"])
# Spécifier l'index
print(df.loc["day2"])
Le résultat de sortie est:
calories    380
duration     40
Name: day2, dtype: int64
Méthodes de DataFrame
Les opérations et méthodes courantes de DataFrame sont présentées dans le tableau suivant :
| Nom de la méthode | Description de la fonction |
|---|---|
head(n) | Renvoie les n premières lignes du DataFrame (par défaut, les 5 premières lignes) |
tail(n) | Renvoie les n dernières lignes du DataFrame (par défaut, les 5 dernières lignes) |
info() | Affiche des informations brèves sur le DataFrame, y compris les noms de colonnes, les types de données, le nombre de valeurs non nulles, etc. |
describe() | Renvoie des informations statistiques pour les colonnes numériques du DataFrame, telles que la moyenne, l'écart-type, le minimum, etc. |
shape | Renvoie le nombre de lignes et de colonnes du DataFrame (lignes, colonnes) |
columns | Renvoie tous les noms de colonnes du DataFrame |
index | Renvoie l'index des lignes du DataFrame |
dtypes | Renvoyer le type de données de chaque colonne |
sort_values(by) | Trier selon une colonne spécifiée |
sort_index() | Trier selon l'index de ligne |
dropna() | Supprimer les lignes ou colonnes contenant des valeurs manquantes (n) |
fillna(value) | Remplir les valeurs manquantes avec une valeur spécifiée |
isnull() | Vérifier les valeurs manquantes, renvoie un DataFrame booléen |
notnull() | Vérifier les valeurs non manquantes, renvoie un DataFrame booléen |
loc[] | Sélectionner des données par index d'étiquette |
iloc[] | Sélectionner des données par index de position |
at[] | Accéder à un seul élément dans un DataFrame (plusloc[]efficace) |
iat[] | Accéder à un seul élément dans un DataFrame (plusiloc[]efficace) |
apply(func) | Appliquer une fonction à un DataFrame ou une Series |
applymap(func) | Appliquer une fonction à chaque élément d’un DataFrame (uniquement pour DataFrame) |
groupby(by) | Opération de regroupement, utilisée pour regrouper selon une colonne afin de calculer des statistiques |
pivot_table() | Créer un tableau croisé dynamique |
merge() | Fusionner plusieurs DataFrames (similaire à l’opération JOIN de SQL) |
concat() | Concaténer plusieurs DataFrames par lignes ou colonnes |
to_csv() | Exporter un DataFrame vers un fichier CSV |
to_excel() | Exporter un DataFrame vers un fichier Excel |
to_json() | Exporter un DataFrame au format JSON |
to_sql() | Exporter un DataFrame vers une base de données SQL |
query() | Interroger un DataFrame à l’aide d’une syntaxe de type SQL |
duplicated() | Renvoie un DataFrame booléen indiquant si chaque ligne est un doublon |
drop_duplicates() | Supprimer les lignes en double |
set_index() | Définir l'index du DataFrame |
reset_index() | Réinitialiser l'index du DataFrame |
transpose() | Transposer le DataFrame (permuter les lignes et les colonnes) |
Exemple
# Créer un DataFrame
data = {
'Name': ['Alice', 'Bob', 'Charlie', 'David'],
'Age': [25, 30, 35, 40],
'City': ['New York', 'Los Angeles', 'Chicago', 'Houston']
}
df = pd.DataFrame(data)
# Afficher les deux premières lignes de données
print(df.head(2))
# Afficher les informations de base du DataFrame
print(df.info())
# Obtenir des statistiques descriptives
print(df.describe())
# Trier par âge
df_sorted = df.sort_values(by='Age', ascending=False)
print(df_sorted)
# Sélectionner les colonnes spécifiées
print(df[['Name', 'Age']])
# Sélectionner les lignes par index
print(df.iloc[1:3]) # Sélectionner les lignes 2 à 3 (par position)
# Sélectionner les lignes par étiquette
print(df.loc[1:2]) # Sélectionner les lignes 2 à 3 (par étiquette)
# Calculer des statistiques de groupe (regrouper par ville, calculer l'âge moyen)
print(df.groupby('City')['Age'].mean())
# Gérer les valeurs manquantes (remplir les valeurs manquantes)
df['Age'] = df['Age'].fillna(30)
# Exporter vers un fichier CSV
df.to_csv('output.csv', index=False)
La sortie est :
# 查看前两行数据
     Name  Age         City
0   Alice   25     New York
1     Bob   30  Los Angeles

# 查看 DataFrame 的基本信息
<class 'pandas.core.frame.DataFrame'>
RangeIndex: 4 entries, 0 to 3
Data columns (total 3 columns):
 #   Column  Non-Null Count  Dtype
---  ------  --------------  -----
 0   Name    4 non-null      object
 1   Age     4 non-null      int64
 2   City    4 non-null      object
dtypes: int64(1), object(2)
memory usage: 148.0+ bytes

# 获取描述统计信息
             Age
count   4.000000
mean   32.500000
std     6.454972
min    25.000000
25%    27.500000
50%    32.500000
75%    37.500000
max    40.000000

# 按年龄排序
      Name  Age         City
3    David   40     Houston
2  Charlie   35      Chicago
1      Bob   30  Los Angeles
0    Alice   25     New York

# 按标签选择行
      Name  Age         City
1     Bob   30  Los Angeles
2  Charlie   35      Chicago

# 计算分组统计(按城市分组,计算平均年龄)
City
Chicago        35.0
Houston        40.0
Los Angeles    30.0
New York       25.0
Name: Age, dtype: float64
Plus de détails sur DataFrame
Création d'un DataFrame
Créer à partir d'un dictionnaire :Les clés du dictionnaire deviennent des noms de colonnes, et les valeurs deviennent les données des colonnes.
Exemple
# Créer un DataFrame à partir d'un dictionnaire
df = pd.DataFrame({'Column1': [1, 2, 3], 'Column2': [4, 5, 6]})
Créer à partir d'une liste de listes :La liste externe représente les lignes, et les listes internes représentent les colonnes.
# Créer un DataFrame à partir d'une liste de listesExemple
columns=['Column1', 'Column2', 'Column3'])
Créer à partir d'un tableau NumPy :Fournissez un tableau NumPy à deux dimensions.
Exemple
# Créer un DataFrame à partir d'un tableau NumPy
df = pd.DataFrame(np.array([[1, 2, 3], [4, 5, 6], [7, 8, 9]]))
Créer un DataFrame à partir de Series :Parpd.Series()créer.
Exemple
s1 = pd.Series(['Alice', 'Bob', 'Charlie'])
s2 = pd.Series([25, 30, 35])
s3 = pd.Series(['New York', 'Los Angeles', 'Chicago'])
df = pd.DataFrame({'Name': s1, 'Age': s2, 'City': s3})
Propriétés et méthodes de DataFrame
Les objets DataFrame possèdent de nombreux attributs et méthodes pour la manipulation, l'indexation et le traitement des données, tels que : shape, columns, index, head(), tail(), info(), describe(), mean(), sum(), etc.
Exemple
print(df.shape) # Forme
print(df.columns) # Noms des colonnes
print(df.index) # Index
print(df.head()) # Premières lignes de données, par défaut les 5 premières lignes
print(df.tail()) # Dernières lignes de données, par défaut les 5 dernières lignes
print(df.info()) # Informations sur les données
print(df.describe())# Statistiques descriptives
print(df.mean()) # Calculer la moyenne
print(df.sum()) # Calculer la somme
Accès aux éléments d'un DataFrame
Accès aux colonnes :Utilisez les noms de colonnes comme attributs ou accédez-y via.loc[]、.iloc[], et vous pouvez également utiliser l'indexation par étiquette ou par position.
Exemple
print(df['Column1'])
# Accès par attribut
print(df.Name)
# Accès via .loc[]
print(df.loc[:, 'Column1'])
# Accès via .iloc[]
print(df.iloc[:, 0]) # Supposons que 'Column1' soit la première colonne
# Accéder à un seul élément
print(df['Name'][0])
Accéder aux lignes :Utilisez les étiquettes de ligne et.loc[]pour accéder.
Exemple
print(df.loc[0, 'Column1'])
Modification d’un DataFrame
Modifier les données de colonne :Attribuez des valeurs aux colonnes directement.
df['Column1'] = [10, 11, 12]
Ajouter une nouvelle colonne :Attribuez des valeurs à la nouvelle colonne.
df['NewColumn'] = [100, 200, 300]
Ajouter une nouvelle ligne :Utilisez les méthodes loc, append ou concat.
Exemple
df.loc[3] = [13, 14, 15, 16]
# Ajouter une nouvelle ligne à la fin à l’aide de append
new_row = {'Column1': 13, 'Column2': 14, 'NewColumn': 16}
df = df.append(new_row, ignore_index=True)
Remarque :append()La méthode a été marquée comme obsolète dans pandas version 1.4.0 et sera supprimée dans les versions futures. La recommandation officielle est d'utiliserconcat()comme méthode alternative pour la concaténation de données.
La méthode concat() est utilisée pour fusionner deux ou plusieurs DataFrames. Lorsque vous souhaitez ajouter une ligne à un autre DataFrame, vous pouvez traiter la nouvelle ligne comme un nouveau DataFrame, puis utiliser concat() :
Exemple
new_row = pd.DataFrame([[4, 7]], columns=['A', 'B']) # Créer un DataFrame contenant uniquement la nouvelle ligne
df = pd.concat([df, new_row], ignore_index=True) # Ajouter la nouvelle ligne au DataFrame d'origine
print(df)
Suppression des éléments d'un DataFrame
Supprimer des colonnes :Utilisez la méthode drop.
df_dropped = df.drop('Column1', axis=1)
Supprimer des lignes :Utilisez également la méthode drop.
df_dropped = df.drop(0) # 删除索引为 0 的行
Analyse statistique d'un DataFrame
Statistiques descriptives :Utilisez.describe()pour afficher le résumé statistique des colonnes numériques.
df.describe()
Calculer des statistiques :Utilisez des fonctions d'agrégation telles que.sum()、.mean()、.max()etc.
df['Column1'].sum()
df.mean()
Opérations d'indexation de DataFrame
Réinitialiser l'index :Utilisez.reset_index()。
df_reset = df.reset_index(drop=True)
Définir l'index :Utilisez.set_index()。
df_set = df.set_index('Column1')
Indexation booléenne de DataFrame
Utilisez des expressions booléennes : filtrez le DataFrame en fonction des conditions.
df[df['Column1'] > 2]
Types de données de DataFrame
Afficher les types de données : utilisez l'attributdtypes.
df.dtypes
Convertir les types de données :Utilisezastypecomme méthode.
df['Column1'] = df['Column1'].astype('float64')
Fusion et fractionnement de DataFrame
Fusion :Utilisezconcatoumergecomme méthode.
# 纵向合并
pd.concat([df1, df2], ignore_index=True)

# 横向合并
pd.merge(df1, df2, on='Column1')
Découpage :Utilisezpivot、meltou des fonctions personnalisées.
# 长格式转宽格式
df_pivot = df.pivot(index='Column1', columns='Column2', values='Column3')

# 宽格式转长格式
df_melt = df.melt(id_vars='Column1', value_vars=['Column2', 'Column3'])
Indexation et découpage
DataFrame prend en charge les opérations d'indexation et de découpage sur les lignes et les colonnes.
Exemple
print(df[['Name', 'Age']]) # Extraire plusieurs colonnes
print(df[1:3]) # Découper les lignes
print(df.loc[:, 'Name']) # Extraire une seule colonne
print(df.loc[1:2, ['Name', 'Age']]) # Extraire les lignes et colonnes spécifiées par indexation d'étiquettes
print(df.iloc[:, 1:]) # Extraire les colonnes spécifiées par indexation positionnelle
Notes
DataFrameC'est une structure de données flexible qui peut contenir des colonnes de différents types de données.- Les noms de colonnes et les index de lignes peuvent être des chaînes de caractères, des entiers, etc.
DataFrameLa sélection, le filtrage, la modification et l'analyse des données peuvent être effectués de nombreuses manières.- Via
DataFrameopérations, vous pouvez effectuer le nettoyage, la transformation, l'analyse, la visualisation des données, et bien plus encore.